

SDCM skončil, ale nezvladatelná touha psát zůstala.
Dlouhé roky náš bratr trpěl kontrolováním rutinní práce, křížil prsty před commitem a nespal kvůli nočním rollbackům.
Ale temným obdobím přichází konec.
Tento článek zahájí sérii o tom, jak mi se zdá automatizace.
Během toho se podíváme na fáze automatizace, ukládání proměnných, formalizaci designu, z RestAPI, NETCONF, YANG, YDK a budeme hodně programovat.
Pro mě znamená, že a) to není objektivní pravda, b) není to bezpodmínečně nejlepší přístup c) můj pohled se může během přechodu od prvního k poslednímu článku měnit — upřímně řečeno, od fáze konceptu do publikace jsem všechno úplně přepsal dvakrát.
Obsah
- Cíle
- Síť — jako jednotný organismus
- Testování konfigurace
- Verzování
- Monitoring a samoobnova služeb
- Nástroje
- Inventární systém
- Systém správy IP prostoru
- Systém popisu síťových služeb
- Mechanismus inicializace zařízení
- Vendorsky agnostický konfigurační model
- Vendorsky specifický ovladač
- Mechanismus dodání konfigurace do zařízení
- CI/CD
- Mechanismus zálohování a hledání odchylek
- Systém monitorování
- Závěr
ADSM se pokusím vést v trochu jiném formátu než SDCM. I nadále se budou objevovat velké obsažné číslované články, a mezi nimi budu publikovat malé poznámky z každodenní zkušenosti. Pokusím se tu bojovat s perfekcionismem a nevyhlazovat je všechny.
Jak je vtipné, že potřetí musím projít stejnou cestou.
Zpočátku jsem musel psát sám články o sítích, protože v ru-netu nebyly.
Teď jsem nenašel komplexní dokument, který by systematizoval přístupy k automatizaci a rozebíral výše uvedené technologie na jednoduchých praktických příkladech.
Možná se mýlím, proto posílejte odkazy na dobré zdroje. Nicméně to nezmění moje odhodlání psát, protože hlavním cílem je naučit se něco sám, a usnadnění života ostatním je příjemný bonus, který podporuje šíření zkušeností.
Pokúsíme se vzít středně velké datové centrum LAN DC a prozkoumat celou schéma automatizace.
Dělat některé věci budu prakticky poprvé s vámi.
V popisovaných myšlenkách a nástrojích nebudu originální. Dmitrij Figol má skvělý .
Články se v mnoha aspektech budou překrývat s nimi.
V LAN DC 4 DC, kolem 250 přepínačů, půl tuctu směrovačů a pár firewallů.
Není to Facebook, ale dost na to, abychom se hlouběji zamysleli o automatizaci.
Existuje názor, že pokud máte více než 1 zařízení, již potřebujete automatizaci.
Opravdu je těžké si představit, že by někdo dnes mohl žít bez alespoň dávky skriptů na koleně.
I když jsem slyšel, že existují firmy, kde se evidence IP adres vede v Excelu, a každé z tisíců síťových zařízení se nastavuje manuálně a má svou unikátní konfiguraci. To lze samozřejmě prezentovat jako moderní umění, ale pocity inženýra budou určitě uražené.
Cíle
Teď si stanovíme maximálně abstraktní cíle:
- Síť — jako jednotný organismus
- Testování konfigurace
- Verzování stavu sítě.
- Monitoring a samoobnova služeb
Později v tomto článku probereme, jaké nástroje budeme používat, a v následujících článcích také cíle a prostředky podrobně.
Síť — jako jednotný organismus
Určující fráze cyklu, přestože se na první pohled může zdát nevýznamná: budeme nastavovat síť, ne jednotlivá zařízení..
Všechny poslední roky sledujeme posun k tomu, aby se na síť pohlíželo jako na jednotnou entitu, odtud i přicházející Software Defined Networking, Intent Driven Networks a Autonomous Networks.
Neboť co globálně aplikacím od sítě potřebují: propojení mezi body A a B (no občas +B-Y) a izolaci od ostatních aplikací a uživatelů.
A tak je naším úkolem v této sérii — vybudovat systém, který podporuje aktuální konfiguraci celé sítě, která se již dekomponuje na aktuální konfiguraci na každém zařízení podle jeho role a umístění.
Systém správa sítě předpokládá, že pro provádění změn se obracíme na ni, a ona na oplátku vypočítá potřebný stav pro každé zařízení a nastaví ho.
Tímto minimalizujeme téměř na nulu ruční použití CLI — jakékoli změny v nastaveních zařízení nebo designu sítě by měly být formalizovány a zdokumentovány — a teprve potom zaváděny na potřebné prvky sítě.
To je, například, pokud jsme se rozhodli, že od tohoto okamžiku by měly přepínače ve Kazani oznamovat dvě sítě místo jedné, my
- Nejprve zdokumentujeme změny v systémech
- Generujeme cílovou konfiguraci všech zařízení sítě
- Spouštíme program pro aktualizaci konfigurace sítě, který vypočítá, co je třeba odstranit na každém uzlu, co přidat, a přivede uzly do požadovaného stavu.
Přitom změny provádíme manuálně pouze v prvním kroku.
Testování konfigurace
, že 80 % problémů nastává během změny konfigurace — nepřímým důkazem toho je, že v období vánočních prázdnin obvykle všechno probíhá hladce.
Osobně jsem byl svědkem desítek globálních výpadků kvůli lidské chybě: nesprávný příkaz, provedení na špatné větvi konfigurace, zapomněli na komunitu, globálně smazali MPLS na směrovači, nastavili pět zařízení, a na šestém chybu nepostřehli, zavadili o staré změny, které provedl někdo jiný. Scénářů je spousta.
Automatika nám umožní udělat méně chyb, ale ve větším měřítku. Tak lze zablokovat nejen jedno zařízení, ale celou síť najednou.
Odjakživa naši předkové kontrolovali správnost prováděných změn ostrým okem, odolnými koulemi a funkčností sítě po jejich nasazení.
Ti předkové, jejichž práce vedly k prostojům a katastrofálním ztrátám, zanechávali méně potomstva a měli by se časem vyhubit, ale evoluce je pomalý proces, a proto dosud ne všichni předem kontrolují změny v laboratoři.
Na špici pokroku jsou ti, kdo automatizovali proces testování konfigurace a její následné aplikace na síť. Jinými slovy — převzali postup CI/CD () od vývojářů.
V jedné části se podíváme, jak to realizovat pomocí systému správy verzí, pravděpodobně GitHubu.
Jakmile si zvykněte na myšlenku síťového CI/CD, v jednu chvíli se vám metoda kontroly konfigurace aplikováním na pracovní síť bude jevit jako raně středověká nevědomost. Přibližně jako bouchání kladivem po hlavici hlavice.
Organickým pokračováním myšlenek o systému správy sítě a CI/CD se stává plnohodnotné verzionování konfigurace.
Verzování
Budeme předpokládat, že při jakýchkoli změnách, i těch nejmenších, dokonce na jednom nenápadném zařízení, celá síť přechází z jednoho stavu do druhého.
A my nikdy nespouštíme příkaz na zařízení, ale měníme stav sítě.
Takže bychom mohli tato stavy nazývat verzemi?
Předpokládejme, že aktuální verze je 1.0.0.
Změnil se IP adresa loopback rozhraní na jednom z ToR? Je to minoritní verze - dostane číslo 1.0.1.
Překontrolovali jsme politiky importu tras v BGP - to je už o něco vážnější - už 1.1.0.
Rozhodli jsme se zbavit se IGP a přejít jen na BGP - to už je radikální změna designu - 2.0.0.
Přitom různé datové centra mohou mít různé verze - síť se vyvíjí, instalují se nová zařízení, někde se přidávají nové úrovně spinalů, jinde ne, atd.
O o tom budeme mluvit v samostatném článku.
Opakuji - jakákoli změna (kromě ladicích příkazů) je aktualizace verze. O všech odchylkách od aktuální verze by měli být informováni administrátoři.
Totéž platí pro vrácení změn - to není zrušení posledních příkazů, není to rollback pomocí operačního systému zařízení - to je uvedení celé sítě do nové (staré) verze.
Monitoring a samoobnova služeb
Toto zjevné zadání v moderních sítích přechází na novou úroveň.
Často u velkých poskytovatelů služeb panuje přístup, že spadlý servis je třeba velmi rychle opravit a vztyčit nový, místo abychom se snažili pochopit, co se stalo.
"Velmi" znamená, že ze všech stran je třeba se hojně namazat monitorovacími nástroji, které během sekund odhalí sebemenší odchylky od normy.
A nestačí zde obvyklé metriky, jako je zatížení rozhraní nebo dostupnost uzlu. Není dostatečné ani ruční sledování pohotovostního pracovníka.
Pro mnohé věci by mělo být vůbec — monitorování se rozsvítilo na červenou a šlo samo přiložit jitrocel, kde to bolí.
A také monitorujeme nejen jednotlivá zařízení, ale i zdraví sítě jako celku, přičemž jak v whiteboxu, což je relativně pochopitelné, tak v blackboxu, což už je složitější.
Co budeme potřebovat pro realizaci tak ambiciózních plánů?
- Mít seznam všech zařízení v síti, jejich lokalizaci, role, modely, verze softwaru.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Mít systém pro popis síťových služeb.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Umět inicializovat zařízení.
Hostname, Mgmt IP, Mgmt Route, Uživatelé, RSA-Klíče, LLDP, NETCONF - Nakonfigurovat zařízení a vrátit konfiguraci na požadovanou (včetně starší) verzi.
- Testovat konfiguraci
- Pravidelně kontrolovat stav všech zařízení z hlediska odchylek od aktuálního a informovat příslušné osoby.
V noci někdo tiše přidal pravidlo do ACL. - Sledovat funkčnost.
Nástroje
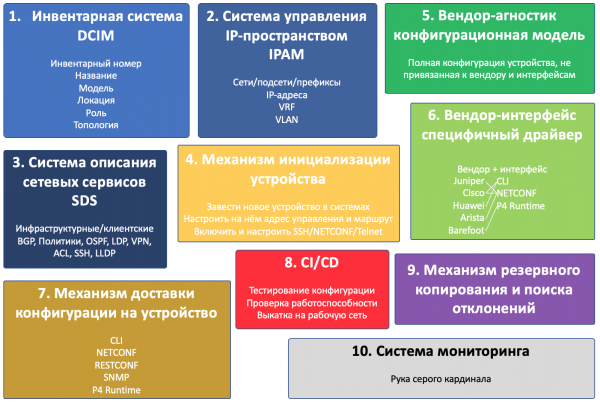
Zní to dost složitě, abychom mohli začít dekomponovat projekt na komponenty.
A bude jich deset:
- Inventární systém
- Systém správy IP prostoru
- Systém popisu síťových služeb
- Mechanismus inicializace zařízení
- Vendorsky agnostický konfigurační model
- Vendorsky specifický ovladač
- Mechanismus dodání konfigurace do zařízení
- CI/CD
- Mechanismus zálohování a hledání odchylek
- Systém monitorování
To je ostatně příklad toho, jak se měnil pohled na cíle cyklu — v návrhu komponent bylo 4.
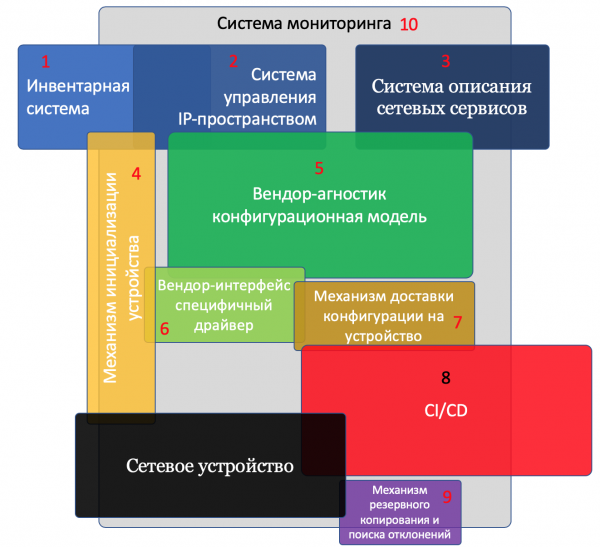
Na ilustraci jsem zobrazil všechny komponenty a samotné zařízení.
Prolínající se komponenty spolu vzájemně interagují.
Čím větší blok, tím více pozornosti je třeba věnovat této komponentě.
Komponenta 1. Inventární systém
Zřejmě chceme vědět, jaké zařízení, kde stojí, k čemu je připojeno.
Inventární systém je nedílnou součástí každého podniku.
Nejčastěji má podnik pro síťová zařízení zvláštní inventární systém, který řeší specifičtější úkoly.
V rámci cyklu článků budeme tento systém nazývat DCIM — Data Center Infrastructure Management. Ačkoli samotný termín DCIM zahrnuje daleko více.
Pro naše účely v něm budeme uchovávat následující informace o zařízení:
- Inventární číslo
- Název/Popis
- Model (Huawei CE12800, Juniper QFX5120 atd.)
- Charakteristické parametry (desky, rozhraní atd.)
- Role (Leaf, Spine, Border Router atd.)
- Umístění (region, město, datové centrum, skříň, jednotka)
- Interkonekce mezi zařízeními
- Topologie sítě
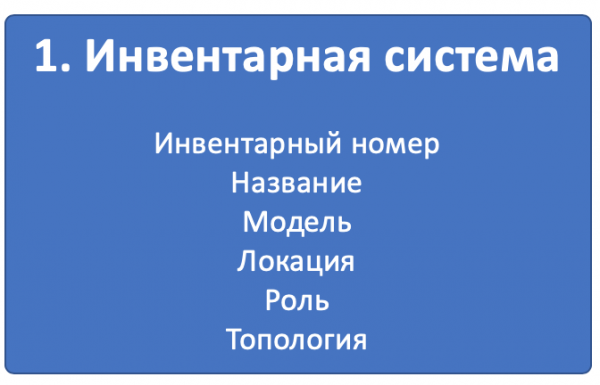
Je jasné, že chceme vědět všechno toto.
Pomůže to však k automatizaci?
Bezpochyby.
Například víme, že v tomto datovém centru na Leaf switchích, pokud jde o Huawei, by se ACL pro filtrování určitého provozu měly aplikovat na VLAN, a pokud se jedná o Juniper, tak na unit 0 fyzického rozhraní.
Nebo je potřeba nasadit nový Syslog server na všechny hranice regionu.
V něm také budeme uchovávat virtuální síťová zařízení, například virtuální směrovače nebo routovací reflektory. Můžeme přidat DNS servery, NTP, Syslog a vlastně cokoliv, co se nějakým způsobem vztahuje k síti.
Komponenta 2. Systém správy IP prostoru
Ano, v dnešní době existují skupiny lidí, které vedou záznamy o předponách a IP adresách v souborech Excel. Moderní přístup je však databázový s frontendem na nginx/apache, API a širokými funkcemi pro správu IP adres a sítí s rozdělením do VRF.
IPAM — Správa IP adres.
Pro naše účely v ní budeme uchovávat následující informace:
- VLAN
- VRF
- Sítě/Podsítě
- IP adres
- Přiřazení adres k zařízením, sítím k lokalitám a číslům VLAN
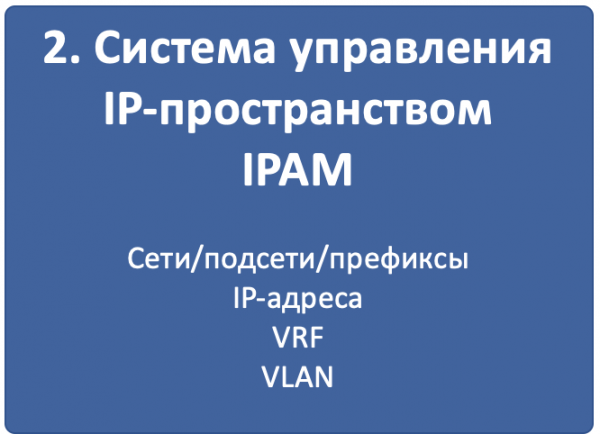
Opět je jasné, že chceme mít jistotu, že při přiřazování nové IP adresy pro loopback ToR se nenarazíme na problém, že již byla někomu přidělena. Nebo že stejnou předponu použijeme dvakrát na různých místech v síti.
Ale jak to pomůže v automatizaci?
Snadno.
Žádáme systém o předponu s rolí Loopbacks, ve které jsou k dispozici IP adresy k přiřazení — pokud je nalezena, přiřazujeme adresu, pokud ne, žádáme o vytvoření nové předpony.
Nebo při vytváření konfigurace zařízení se z této stejné soustavy můžeme dozvědět, v jakém VRF by měl být rozhraní.
A při spuštění nového serveru skript zjistí v systému, v jakém serverovém switche, v jakém portu a jaká podsíť je přiřazena k rozhraní — z ní se bude přiřazovat adresa serveru.
Nabízí se myšlenka sloučit DCIM a IPAM do jedné soustavy, abychom se vyhnuli duplicitním funkcím a neudržovali dvě podobné entit.
A to uděláme.
Komponenta 3. Systém popisu síťových služeb
Pokud první dvě soustavy uchovávají proměnné, které je ještě třeba nějak použít, třetí popisuje pro každou roli zařízení, jak by mělo být nastaveno.
Je dobré vyčlenit dva různé typy síťových služeb:
- Infrastrukturní
- Klientské.
První mají zajistit základní konektivitu a správu zařízení. Patří sem VTY, SNMP, NTP, Syslog, AAA, směrovací protokoly, CoPP atd.
Druhé organizují službu pro klienta: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP atd.
Samozřejmě existují i mezistupně — jak zařadit MPLS LDP, BGP? A směrovací protokoly mohou být také použity pro klienty. Ale to není zásadní.
Oba typy služeb se rozkládají na konfigurační primitiva:
- fyzická a logická rozhraní (tag/untag, mtu)
- IP adresy a VRF (IP, IPv6, VRF)
- ACL a politiky zpracování provozu
- Protokoly (IGP, BGP, MPLS)
- Směrovací politiky (předponové seznamy, komunity, ASN filtry).
- Služební servery (SSH, NTP, LLDP, Syslog…)
- Atd.
Jak přesně to uděláme, zatím nevím. Probereme to v samostatném článku.
Pokud bychom byli blíže k realitě, mohli bychom popsat, co
Leafový přepínač by měl mít BGP relace se všemi připojenými Spine přepínači, importovat do procesu připojené sítě, přijímat od Spine přepínačů pouze sítě z určitého prefixu. Omezit CoPP IPv6 ND na 10 pps atd.
Spiny, na druhé straně, udržují relace se všemi připojenými leafy a fungují jako root-reflektor, přijímají od nich pouze trasy určité délky a s určitou komunitou.
Komponent 4. Mechanismus inicializace zařízení
Pod tímto nadpisem spojuji řadu činností, které musí proběhnout, aby se zařízení objevilo na radarových systémech a bylo možné na něj přistupovat vzdáleně.
- Zaregistrovat zařízení v inventářním systému.
- Vyhradit IP adresu pro správu.
- Nastavit základní přístup k zařízení:
Hostname, IP adresa správy, trasa do správcovské sítě, uživatelé, SSH klíče, protokoly — telnet/SSH/NETCONF
Existují tři přístupy:
- Úplně ručně. Zařízení je přivezeno na stand, kde běžný organický člověk ho zaregistruje v systémech, připojí se přes konzoli a nastaví. Může fungovat na malých statických sítích.
- ZTP — Zero Touch Provisioning. Hardware dorazil, nastavil se, prostřednictvím DHCP získal adresu, navštívil speciální server, automaticky se nastavil.
- Infrastruktura konzolových serverů, kde počáteční nastavení probíhá automaticky přes konzolový port.
O všech třech se pobavíme v samostatném článku.
Komponent 5. Model konfigurace nezávislý na dodavateli
Doposud byly všechny systémy roztroušené kusy, poskytující proměnné a deklarativní popis toho, co bychom chtěli vidět v síti. Ale dříve či později se budeme muset vypořádat s konkrétností.
V této fázi se pro každé konkrétní zařízení primitivy, služby a proměnné kombinují do konfiguračního modelu, který fakticky popisuje úplnou konfiguraci daného zařízení nezávislým způsobem na dodavateli.
Jaký přínos má tento krok? Proč hned nesestavit konfiguraci zařízení, kterou lze jednoduše nahrát?
Ve skutečnosti to umožňuje vyřešit tři úkoly:
- Nepřizpůsobovat se konkrétnímu rozhraní interakce se zařízením. Ať už jde o CLI, NETCONF, RESTCONF, SNMP — model bude stejný.
- Nedržet počet šablon/skriptů podle počtu dodavatelů v síti a v případě změny návrhu měnit stejné věci na více místech.
- Načíst konfiguraci z zařízení (zálohy), rozložit ji do přesně stejného modelu a přímo porovnat mezi sebou cílovou konfiguraci a stávající pro výpočet rozdílu a přípravu konfiguračního patch, který změní pouze ty části, které je třeba, nebo pro odhalení odchylek.
Důsledkem tohoto kroku získáme konfigurační model nezávislý na dodavateli.
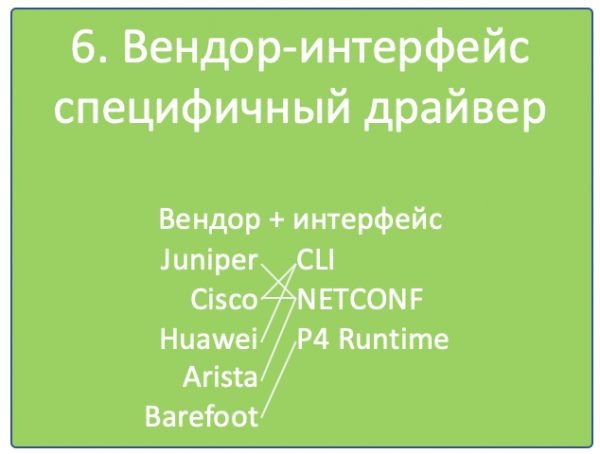
Komponenta 6. Specifický ovladač pro dodavatele.
Není dobré se mýlit v očekávání, že je možné konfiguraci Cisco nastavit stejně jako Juniper, jednoduše odesláním naprosto stejných volání. I přes rostoucí popularitu whiteboxů a vznik podpory NETCONF, RESTCONF, OpenConfig se konkrétní obsah dodávaný těmito protokoly liší od dodavatele k dodavateli a to je jeden z jejich konkurenčních rysů, který se tak snadno nevzdají.
Je to podobné jako u OpenContrail a OpenStack, které mají jako své NorthBound rozhraní RestAPI, očekávají naprosto různá volání.
Takže v pátém kroku musí nezávislý na dodavateli model přijmout takovou podobu, ve které se dostane na hardware.
A zde platí, že všechny prostředky jsou povoleny (ne): CLI, NETCONF, RESTCONF, SNMP se jednou použijí.
Proto budeme potřebovat ovladač, který převede výsledek předchozího kroku do potřebného formátu konkrétního dodavatele: sadu CLI příkazů, strukturu XML.
Komponenta 7. Mechanismus doručení konfigurace na zařízení.
Konfiguraci jsme totiž vygenerovali, ale musíme ji ještě doručit na zařízení — a očividně ne ručně.
Za prvé, před námi se tedy objevuje otázka, jaký transport budeme používat? Výběr je dnes již docela široký:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (i když v seznamu vyčnívá, protože je to způsob, jak dodat FIB, nikoliv nastavení)
Dáme si zde jasně na pravou míru. CLI — to je legacy. SNMP… ehm, ehm.
RESTCONF — zatím neznámá bytost, REST API nepodporuje téměř nikdo. Proto se v cyklu zaměříme na NETCONF.
Jak už čtenář pochopil, s rozhraním jsme se v tuto chvíli již shodli — výsledek předchozího kroku je již představen v podobě zvoleného rozhraní.
Za druhé, a jakými nástroji to uděláme?
I zde je výběr obrovský:
- Vlastní skript nebo platforma. Vybavíme se ncclient a asyncIO a uděláme to sami. Co nás stojí postavit systém nasazení od nuly?
- Ansible se svou bohatou knihovnou síťových modulů.
- Salt s jeho slabou podporou pro síť a vazbou na Napalm.
- Samotný Napalm, který zná pár dodavatelů a to je vše, sbohem.
- Nornir — další stvoření, které rozebíráme v budoucnosti.
Zde favorit ještě není vybrán — budeme zkoumat.
Co je tu ještě důležité? Důsledky aplikace konfigurace.
Úspěšně nebo ne. Zůstal přístup k zařízení nebo ne.
Zdá se, že zde pomůže commit s potvrzením a validací toho, co bylo do zařízení nahráno.
To v kombinaci se správnou implementací NETCONF značně zužuje okruh vhodných zařízení — normální commity podporuje jen malý počet výrobců. Ale to je jen jeden z požadavků v . Nakonec se nikdo nezabývá tím, že žádný ruský dodavatel nevyhoví podmínkám 32*100GE rozhraní. Nebo se tím někdo zabývá?
Komponenta 8. CI/CD
V tuto chvíli máme již připravenou konfiguraci pro všechna zařízení sítě.
Píšu "pro všechna", protože mluvíme o verzionování stavu sítě. A i když je potřeba změnit nastavení pouze jednoho switche, změny se počítají pro celou síť. Je jasné, že mohou být v tomto případě nulové pro většinu uzlů.
Ale jak už bylo řečeno, nejsme přece nějací barbaři, abychom to všechno hned hodili do produkce.
Vygenerovaná konfigurace musí nejprve projít Pipeline CI/CD.
CI/CD znamená Continuous Integration, Continuous Deployment. Je to přístup, při kterém tým nezveřejňuje nový major release jednou za půl roku, kdy zcela nahradí starý, ale pravidelně inkrimentálně zavádí (Deployment) novou funkcionalitu po malých krocích, z nichž každý je důkladně testován na kompatibilitu, bezpečnost a funkčnost (Integration).
K tomu máme systém kontroly verzí, který sleduje změny konfigurace, laboratoř, kde se testuje, zda klientský servis nepadá, monitorovací systém, který tento fakt ověřuje, a poslední krok - nasazení změn do produkční sítě.
S výjimkou ladicích příkazů musí všechny změny v síti projít CI/CD pipeline - to je naše záruka klidného života a dlouhé šťastné kariéry.
Komponent 9. Systém zálohování a vyhledávání odchylek
O zálohách je zbytečné mluvit podruhé.
Prostě je budeme ukládat na základě cron úloh nebo při změně konfigurace v gitu.
Ale druhá část je zajímavější - někdo by měl sledovat tyto zálohy. A v některých případech by tento někdo měl jít a vrátit vše, jak bylo, a v jiných, upozornit někoho na to, že je něco špatně.
Například, pokud se objevil nějaký nový uživatel, který není uveden v proměnných, je potřeba ho odpojit daleko od hacku. A pokud je nové pravidlo firewallu - raději se do toho nepouštět, možná někdo jen zapnul ladění, a nebo nový servis, nešika, to nezapsal podle předpisů, ale už do něj lidé šli.
Z žádného malého delta v měřítku celé sítě se stejně nedostaneme, bez ohledu na jakékoliv automatizační systémy a železnou ruku vedení. Pro ladění problémů stejně nikdo nebude zasahovat do systémy konfigurace. Tím spíše, že model konfigurace to může ani neumožňovat.
Například, pravidlo firewallu pro počítání počtu paketů na určitou IP, pro lokalizaci problému - zcela běžná dočasná konfigurace.
Komponent 10. Systém monitorování
Zpočátku jsem nechtěl rozebírat téma monitorování - je to přece jeden z objemných, kontroverzních a složitých témat. Ale z průběhu se ukázalo, že je to neodmyslitelná součást automatizace. A nelze se jí vyhnout alespoň bez praxe.
Pokud to rozvinu - je to organická část procesu CI/CD. Po nasazení konfigurace do sítě, potřebujeme umět určit, zda je nyní vše v pořádku.
A mluvíme nejen a nejen o grafech využití rozhraní nebo dostupnosti uzlů, ale o v mnohem jemnějších věcech - přítomnosti potřebných tras, jejich atribitů, počtu BGP sezení, OSPF sousedů, End-to-End funkčnosti nadřazených servisů.
Nebyly zastaveny sběry s sistemovými logy na externí server, nepraskl SFlow agent, nezačaly se zvyšovat ztráty v frontách, nenarušila se spojitost mezi nějakou dvojicí prefixů?
V samostatném článku se nad tím zamyslíme.
Závěr
Jako základ jsem zvolil jeden z moderních designů datacentrové sítě — L3 Clos Fabric s BGP jako protokolem routování.
Síť budeme tentokrát stavět na Juniperu, protože nyní je rozhraní JunOs velice přívětivé.
Ukomplikujeme si život používáním pouze Open Source nástrojů a více dodavatelskou sítí — takže kromě Juniperu vyberu během procesu také dalšího šťastlivce.
Plán budoucích publikací vypadá přibližně takto:
Nejprve budu mluvit o virtuálních sítích. Především proto, že mě to zajímá, a druhým důvodem je, že bez toho nebude design infrastrukturální sítě příliš srozumitelný.
Poté se skutečně zaměřím na design sítě: topologii, routování, politiky.
Sestavíme laboratorní stanici.
Zamyslíme se a možná si vyzkoušíme inicializaci zařízení v síti.
A dál se podíváme na každou komponentu v intimních podrobnostech.
A ano, neslibuji, že elegantně zakončím tuto sérii hotovým řešením. 🙂
Užitečné odkazy
- Než se ponoříme do série, je dobré přečíst knihu Nataši Samoylenko . A možná také absolvovat .
- Užitečné bude také přečíst si o designu datacentrových továren od Facebooku od Petra Lapušova.
- Informace o tom, jak funguje overlay SDN, vám poskytne dokumentace k architektuře (dříve Open Contrail).
Děkuji
Romanu Gorgemu. Za komentáře a úpravy.
Arťomu Černobajovi. Za KDPV.
Zdroj: habr.com
