

V prvních dvou článcích jsem se zabýval otázkou automatizace a načrtl její rámec, ve druhém jsem udělal odbočku do virtualizace sítě jako prvního přístupu k automatizaci nastavení služeb.
A teď je čas nakreslit schéma fyzické sítě.
Pokud nejste v blízkém kontaktu s zařízeními datových center, důrazně doporučuji začít s .
Všechny díly:
V této sérii popsané praktiky by měly být použitelné pro síť jakéhokoli typu, jakékoli velikosti a s jakoukoli rozmanitostí dodavatelů (ne). Nicméně nelze popsat univerzální příklad použití těchto přístupů. Proto se zastavím u moderní architektury sítě DC: .
DCI provedeme na MPLS L3VPN.
Nad fyzickou sítí pracuje Overlay-síť z hostitele (to může být VXLAN OpenStacku nebo Tungsten Fabric nebo co koliv jiného, co vyžaduje od sítě pouze základní IP konektivitu).
V tomto případě vznikne relativně jednoduchý scénář pro automatizaci, protože máme hodně zařízení, která se konfigurují stejným způsobem.
Vybereme si sférické DC ve vakuu:
- Jedna verze designu všude.
- Dva dodavatelé, tvořící dvě roviny sítě.
- Jedno DC vypadá jako druhé jako dvě kapky vody.
Obsah
- Fyzická topologie
- Směrování
- IP plán
- Lab
- Závěr
- Užitečné odkazy
Nechť náš Služební Poskytovatel LAN_DC bude například hostit výuková videa o přežití v uvězněných výtazích.
Ve velkoměstech je to mimořádně populární, takže je potřeba hodně fyzických strojů.
Nejprve popíšu síť přibližně tak, jak bych ji rád viděl. A pak ji zjednoduším pro lab.
Fyzická topologie
Lokace
LAN_DC bude mít 6 DC:
- Rusko (RU):
- Moskva (msk)
- Kazan (kzn)
- Španělsko (SP):
- Barcelona (bcn)
- Malaga (mlg)
- Čína (CN):
- Šanghaj (sha)
- Si-an (sia)

Uvnitř DC (Intra-DC)
Ve všech DC jsou identické sítě vnitřní konektivity založené na topologii Clos.
Jaké jsou sítě Clos a proč právě ty — v samostatném .
V každém DC je 10 racků se stroji, budou číslovány jako A, B, C A tak dále.
V každém racku je 30 strojů. Ty nás nezajímají.
Také v každém racku je switch, ke kterému jsou připojeny všechny stroje — to je Top of the Rack switch — ToR nebo jinak v termínech Clos Fabric jej budeme nazývat Leaf.

Obecná schéma fabriky.
Budeme je nazývat XXX-leafY, kde XXX — třípísmenná zkratka DC, a Y — pořadové číslo. Například, kzn-leaf11.
V článcích si dovolím poměrně volně používat termíny Leaf a ToR jako synonyma. Je však třeba si uvědomit, že tomu tak není.
ToR je switch umístěný v racku, k němuž se připojují zařízení.
Leaf je role zařízení v fyzické síti nebo switch první úrovně v terminologii topologie Clos.
To znamená, že Leaf != ToR.
Tak Leafem může být například switch EndofRow.
Nicméně v rámci tohoto článku se budeme stále obracet k nim jako synonymům.
Každý ToR switch je zároveň připojen ke čtyřem nadřazeným agregujícím switchům — Spine. Pro Spine je vyhrazena jedna skříň v DC. Pojmenovávat budeme analogicky: XXX-spineY.
Ve stejné skříni bude umístěno síťové vybavení pro konektivitu mezi DC — 2 směrovače s MPLS na palubě. Ale v podstatě jde o ty samé ToRy. Z pohledu Spine switchů není žádný rozdíl mezi běžným ToRem s připojenými zařízeními nebo směrovačem pro DCI — v obou případech se jedná o forwarding.
Tyto speciální ToRy se nazývají Edge-leaf. My je budeme pojmenovávat XXX-edgeY.
Bude to vypadat takto.
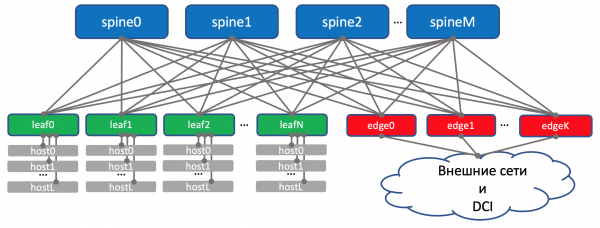
Na schématu výše jsem skutečně umístil edge a leaf na stejnou úroveň. nás naučily považovat uplink (odtud také termín) za linky nahoru. A tady se ukazuje, že "uplink" DCI jde zpět dolů, což někomu poněkud narušuje obvyklou logiku. V případě velkých sítí, kdy jsou datacentra rozdělena na menší jednotky — POD‘y (Point Of Delivery) se vyčleňují jednotlivé Edge-POD‘y pro DCI a výstup do externích sítí.
Aby bylo dalšímu porozumění pohodlnější, budu i nadále nakreslit Edge nad Spine, přičemž budeme mít na paměti, že na Spine není žádná inteligence a žádné rozdíly při práci s běžnými Leaf a Edge-leaf (i když zde mohou být nuance, ale v zásadě je to tak).
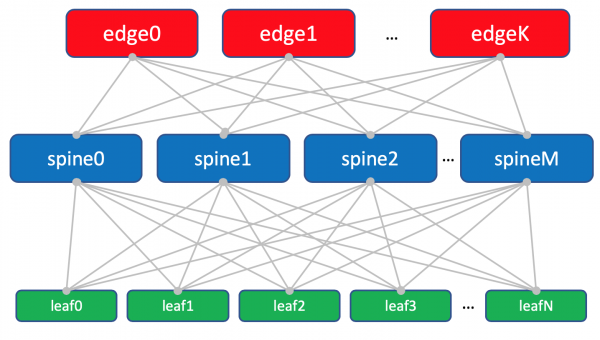
Schéma fabriky s Edge-leafy.
Trojice Leaf, Spine a Edge tvoří síť Underlay nebo fabriku.
Úkolem síťové fabriky (čti Underlay), jak jsme již určili v , je velmi a velmi jednoduché — zajistit IP konektivitu mezi zařízeními jak v rámci jednoho DC, tak i mezi nimi.
Odtud také název síť, která se nazývá fabrikou, podobně jako továrna na přepínání uvnitř modulárních síťových boxů, o čemž se podrobněji můžete dočíst v .
A mimochodem, taková topologie se nazývá fabrikou, protože fabric v překladu znamená tkanina. A těžko by s tím někdo nesouhlasil:
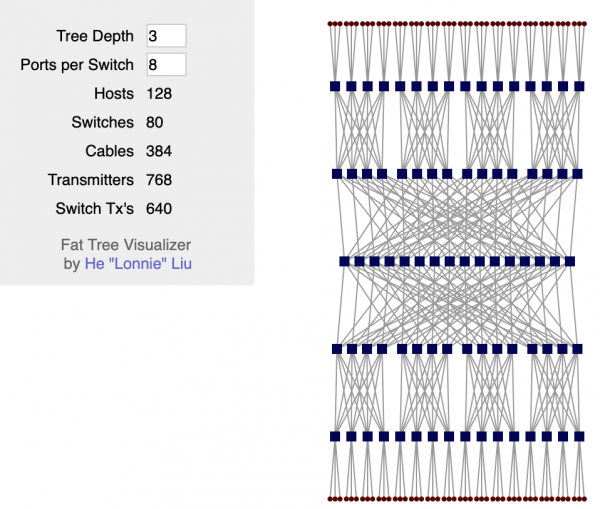
Fabrika je plně L3. Žádné VLANy, žádná broadcastová komunikace — naši úžasní programátoři v LAN_DC umějí psát aplikace, které žijí v paradigmech L3, a virtuální stroje nevyžadují Live Migration s uchováním IP adresy.
A ještě jednou: odpověď na otázku proč fabrika a proč L3 — v samostatném .
DCI — Data Center Interconnect (Inter-DC)
DCI bude zorganizováno pomocí Edge-Leaf, což je naše výstupní bod do páteřní sítě.
Pro zjednodušení předpokládejme, že DCe jsou mezi sebou spojeny přímými linky.
Vyloučíme externí konektivitu.
Uvědomuji si, že pokaždé, když odstraním nějakou komponentu, výrazně zjednodušuji síť. A při automatizaci naší abstraktní sítě bude vše v pořádku, ale v reálné síti se objeví kostlivci.
To je pravda. A přesto cílem této série je přemýšlet a pracovat na přístupech, nikoli heroicky řešit vymyšlené problémy.
Na Edge-Leaf se podkladová struktura umisťuje do VPN a přenáší se přes MPLS páteř (ten přímý link).
Takto vypadá obrysová schéma.

Směrování
Pro routování uvnitř DCe budeme používat BGP.
Na MPLS páteři OSPF+LDP.
Pro DCI, tedy organizaci konektivity v podkladu — BGP L3VPN přes MPLS.
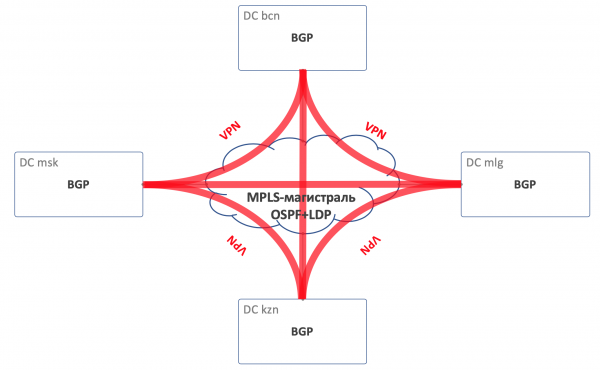
Celková schéma routování
Na fabrice nejsou žádné OSPF a ISIS (ve Federaci Ruské zakázaný protokol routování).
A to znamená, že nebudou automatické objevování a výpočet nejkratších cest — pouze ruční (ve skutečnosti automatické — vždyť mluvíme o automatizaci) konfigurace protokolu, sousedství a politik.
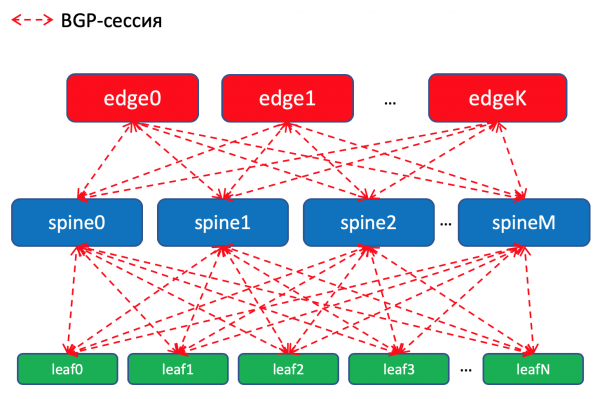
Schéma routování BGP uvnitř DCe
Proč BGP?
Na toto téma existuje od Facebooku a Aristy, kde se popisuje, jak stavět velmi rozsáhlé datové centra, využívající BGP. Čte se to skoro jako literatura, velmi doporučuji pro lenivý večer.
A také celá sekce v mém článku je věnována tomu. Tam vás a .
Ale přesto, pokud to shrneme, žádné IGP nejsou vhodné pro sítě velkých datových center, kde se počítá sítěmi na tisíce.
Kromě toho využití BGP všude zajistí, že nebudeme rozptýlení na podporu několika různých protokolů a synchronizaci mezi nimi.
Upřímně, na naší továrně, která pravděpodobně nebude rychle expandovat, by nám stačilo i OSPF. To jsou ve skutečnosti problémy megaskalérů a cloudových titanů. Ale pojďme si jen na pár vydání představit, že to potřebujeme, a použijme BGP, jak nařídil Petr Lapuchov.
Politiky směrování
Na Leaf switchích importujeme do BGP prefixy z Underlay rozhraní sítě.
Budeme mít BGP session mezi každou párem Leaf-Spine, ve kterém budou tyto Underlay prefixy oznámeny sítí.
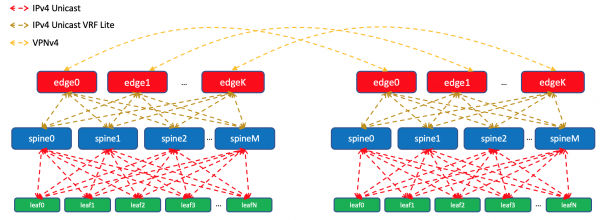
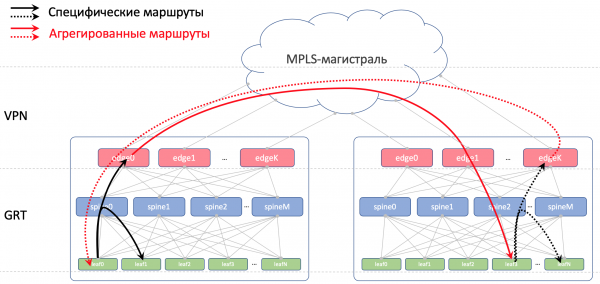
Uvnitř jednoho datacentra budeme šířit specifikace, které jsme importovali na ToR. Na Edge-Leafs je budeme agregovat a oznamovat do vzdálených DC a snižovat zpět na ToRy. To znamená, že každý ToR bude přesně vědět, jak se dostat k jinému ToRu v tomto stejném DC a kde je vstupní bod pro přístup k ToRu v jiném DC.
V DCI budou trasy předávány jako VPNv4. K tomu bude na Edge-Leaf rozhraní směrem k továrně umístěn v VRF, nazvěme ho UNDERLAY, a sousedství se Spine na Edge-Leaf bude vytvářeno uvnitř VRF, zatímco mezi Edge-Leafy v VPNv4-family.
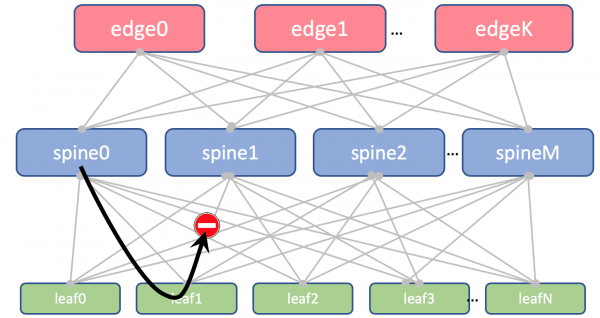
Také zakážeme znovu oznamovat trasy získané od spainů zpět na ně.
Na Leaf a Spine nebudeme importovat Loopbacky. Ty nám budou potřebné pouze k určení Router ID.
Na Edge-Leaf však importujeme do globálního BGP. Mezi Loopback adresami Edge-Leafy vytvoří BGP session v IPv4 VPN-family navzájem.
Mezi EDGE zařízeními budeme mít expandovanou páteř na OSPF+LDP. Vše v jedné zóně. Velmi jednoduchá konfigurace.
Takto vypadá směřování.
BGP ASN
Edge-Leaf ASN
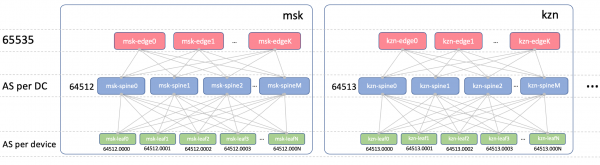
Na Edge-Leaf bude jeden ASN ve všech DC. Je důležité, aby mezi Edge-Leafy byl iBGP, a abychom se vyhnuli nuancím eBGP. Nechť je to 65535. Ve skutečnosti by to mohl být číslo veřejné AS.
Spine ASN
Na Spine budeme mít jeden ASN na DC. Začneme s prvním číslem z řady privátních AS — 64512, 64513 a tak dále.
Proč ASN na DC?
Dejme si na tuto otázku dva aspekty:
- Proč stejné ASN na všech spinech jednoho DC?
- Proč různé v různých DC?
Proč stejné ASN na všech spinech jednoho DC
Takto bude vypadat AS-Path underlay trasy na Edge-Leaf:
[leafX_ASN, spine_ASN, edge_ASN]
Při pokusu o opětovné oznámení na Spine to odmítne, protože jeho AS (Spine_AS) je již v seznamu.
Nicméně v rámci DC nám zcela vyhovuje, že cesty Underlay, které se zdvihnou k Edge, se nemohou vrátit dolů. Veškerá komunikace mezi hostiteli uvnitř DC by měla probíhat na úrovni spine.
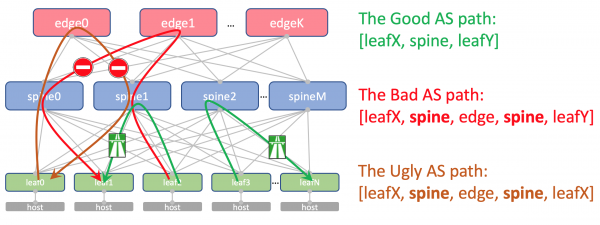
Agregované cesty z jiných DC se v každém případě bez překážek dostanou k ToR — jejich AS-Path bude mít pouze ASN 65535 — číslo AS Edge-Leaf, protože právě tam byly vytvořeny.
Proč jsou v různých DC odlišné
Teoreticky bychom mohli potřebovat protáhnout Loopbacky nějakých servisních virtuálních strojů mezi DC.
Například na hostiteli nám poběží Route Reflector nebo (Virtual Network Gateway), který se přes BGP spojí s ToR a oznámí svůj loopback, který by měl být přístupný ze všech DC.
Takto by měl vypadat jeho AS-Path:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
A nikde by neměly být opakující se ASN.
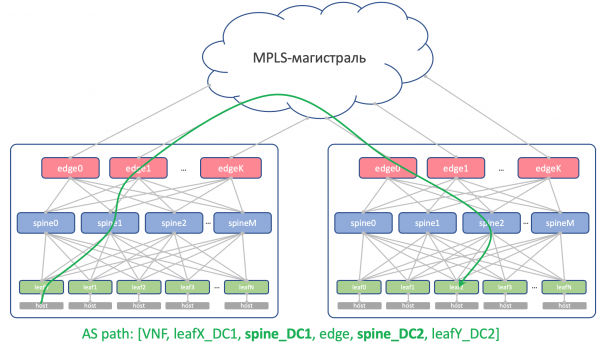
To znamená, že Spine_DC1 a Spine_DC2 by měly být různé, stejně jako leafX_DC1 a leafY_DC2, ke čemuž se právě dostáváme.
Jak asi víte, existují hacky, které umožňují přijímat cesty s opakujícími se ASN v rozporu s mechanismem prevence smyček (allowas-in na Cisco). A to má i docela legitimní použití. Ale je to potenciální mezera v stabilitě sítě. A já jsem do ní osobně párkrát spadl.
A pokud máme možnost nepoužívat nebezpečné věci, využijeme jí.
Leaf ASN
Na každém Leaf switchi v celé síti budeme mít individuální ASN.
Děláme to z důvodů uvedených výše: AS-Path bez smyček, konfigurace BGP bez zadní stránky.
Aby cesty mezi Leafy bez problémů procházely, měl by AS-Path vypadat takto:
[leafX_ASN, spine_ASN, leafY_ASN]
kde by leafX_ASN a leafY_ASN měly být odlišné.
To je potřeba také pro situaci s oznámením loopbacku VNF mezi DC:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Použijeme 4-bajtový ASN a vygenerujeme ho na základě ASN Spine a čísla Leaf switch, a to konkrétně takto: Spine_ASN.0000X.
Takhle vypadá situace s ASN.
IP plán
Principiálně je potřeba vyčlenit adresy pro následující připojení:
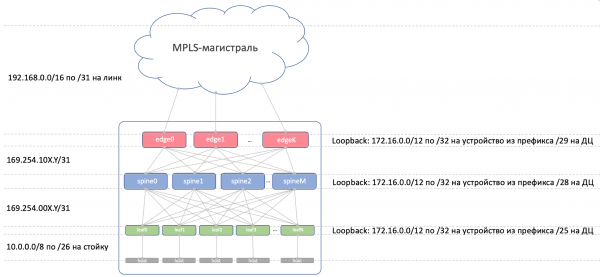
- Adresy sítě Underlay mezi ToR a stroj. Musí být unikátní v celé síti, aby se jakýkoliv stroj mohl spojit s jakýmikoliv jinými. Skvěle se hodí 10/8. Na každou skříň po /26 s rezervou. Budeme přidělovat /19 na DC a /17 na region.
- Linkové adresy mezi Leaf/Tor a Spine.
Měly by být určovány algoritmicky, to znamená, že budou vypočítávány z názvů zařízení, která je třeba připojit.
Nechť je to… 169.254.0.0/16.
A konkrétně 169.254.00X.Y/31, kde X — číslo Spine, Y — P2P síť /31.
To umožní spustit až 128 stojanů a až 10 Spine v DC. Odkazové adresy se mohou (a budou) opakovat z DC do DC. - Spojení Spine — Edge-Leaf zorganizujeme na podsítích 169.254.10X.Y/31, kde to bude fungovat stejně X — číslo Spine, Y — P2P síť /31.
- Odkazové adresy z Edge-Leaf do MPLS páteře. Zde je situace poněkud jiná — je to místo, kde se všechny části spojují do jednoho celku, takže stejné adresy není možné znovu použít — je třeba vybrat další volnou podsíť. Proto vezmeme jako základ 192.168.0.0/16 a budeme z ní vybírat volné.
- Adresy Loopback. Přiřadíme jim celé rozmezí 172.16.0.0/12.
- Leaf — podle /25 na DC — stejných 128 stojanů. Vyčleníme podle /23 pro region.
- Spine — podle /28 na DC — až 16 Spine. Vyčleníme podle /26 pro region.
- Edge-Leaf — podle /29 na DC — až 8 jednotek. Vyčleníme podle /27 pro region.
Pokud nám na DC nebudou stačit přidělené rozsahy (což nebude — přece máme ambice na hyperscale), prostě vyčleníme další blok.
Takový je obraz s IP adresací.
Loopback’y:
Prefix
Úloha zařízení
Region
DC
172.16.0.0/23
edge
172.16.0.0/27
cs
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
cs
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
cs
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Prefix
Region
DC
10.0.0.0/17
cs
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Lab
Dva dodavatelé. Jedna síť. ADSM.
Juniper + Arista. Ubuntu. Stará dobrá Eva.
Počet zdrojů na našem virtuálu v Mirane je přesto omezený, takže pro praxi použijeme takto maximálně zjednodušenou síť.
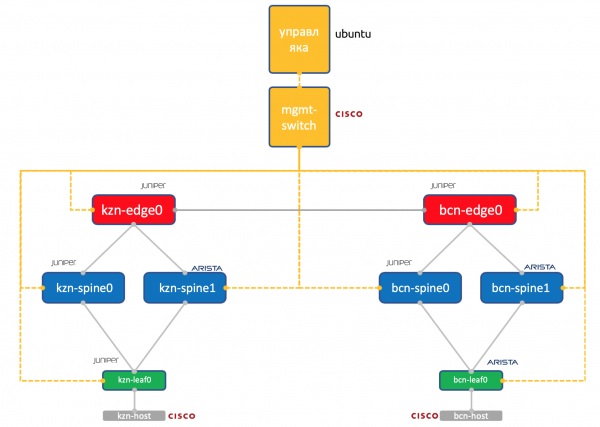
Dva datacentra: Kazan a Barcelona.
- Po dva spine v každém: Juniper a Arista.
- Po jednom toru (Leaf) v každém — Juniper a Arista, s jedním připojeným hostem (vezmeme lehkobřezový Cisco IOL pro to).
- Po jedné jednotce Edge-Leaf (zatím jen Juniper).
- Jeden Cisco switch, aby je všechny ovládal.
- Kromě síťových krabic je spuštěna virtuální stroj-řízení. Pod řízením Ubuntu.
Má přístup ke všem zařízením, na něm poběží IPAM/DCIM systémy, soubor python skriptů, ansible a cokoliv jiného, co bychom mohli potřebovat.
všech síťových zařízení, kterou se pokusíme reprodukovat pomocí automatizace.
Závěr
Je to tak obvyklé? Pod každým článkem dělat krátké shrnutí?
Takže jsme vybrali síť Clos uvnitř DC, protože očekáváme hodně East-West provozu a chceme ECMP.
Rozděleno na fyzickou (underlay) a virtuální (overlay) síť. Přičemž overlay začíná na hostiteli — tím se zjednodušily požadavky na underlay.
Vybrali jsme BGP jako protokol směrování anedrélových sítí pro jeho škálovatelnost a flexibilitu politik.
Budeme mít samostatné uzly pro organizaci DCI — Edge-leaf.
Na páteři bude OSPF+LDP.
DCI bude realizováno na základě MPLS L3VPN.
Pro P2P linky budeme IP adresy počítat algoritmicky na základě názvů zařízení.
Loopbacky přiřadíme podle rolí zařízení a jejich umístění postupně.
Anedrélové prefixy — pouze na Leaf switche postupně na základě jejich umístění.
Předpokládáme, že právě teď nemáme ještě nainstalované vybavení.
Proto budou naše další kroky — zavést je do systémů (IPAM, inventář), uspořádat přístup, vygenerovat konfiguraci a nasadit ji.
V příštím článku se podíváme na Netbox — systém inventarizace a správy IP prostoru v datovém centru.
Děkuji
- Andrejovi Glazkovovi aka @glazgoo za korekturu a úpravy
- Alexandru Klimenkovi aka @v00lk za korekturu a úpravy
- Artěmu Černobajovi za KDOV
Zdroj: habr.com
