

Tento článek vám pomůže pochopit, jak funguje vyvažování zátěže v Kubernetes, co se děje při škálování dlouhotrvajících spojení a proč byste měli zvážit vyvažování na straně klienta, pokud používáte HTTP/2, gRPC, RSockets, AMQP nebo jiné dlouhotrvající protokoly.
Krátce o tom, jak se v Kubernetes přerozděluje provoz
Kubernetes poskytuje dvě užitečné abstrakce pro nasazení aplikací: služby (Services) a nasazení (Deployments).
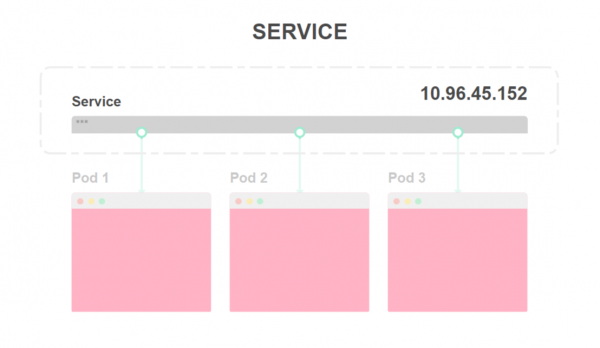
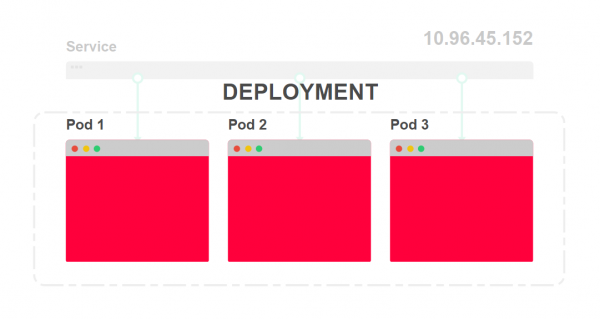
Nasazení popisují, jakým způsobem a kolik kopií vaší aplikace by mělo být spuštěno v každém okamžiku. Každá aplikace je nasazena jako pod (Pod) a je jí přidělen IP adresa.
Služby se funkcionalitou podobají vyvážeči zátěže. Jsou určeny k rozdělení provozu mezi více podů.
Podívejme se, jak to vypadá.
- Na diagramu níže vidíte tři instance jedné aplikace a vyvažovač zátěže:

- Vyvažovač zátěže se nazývá služba (Service), má přidělenou IP adresu. Každý příchozí požadavek je přesměrován na jeden z podů:

- Scénář nasazení určuje počet instancí aplikace. Prakticky nikdy nebudete muset nasazovat přímo pod:

- Každému podu je přidělena jeho IP adresa:

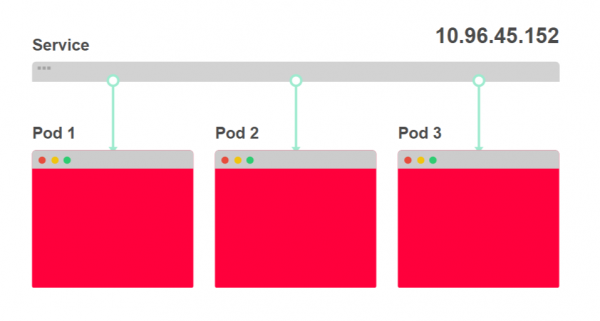
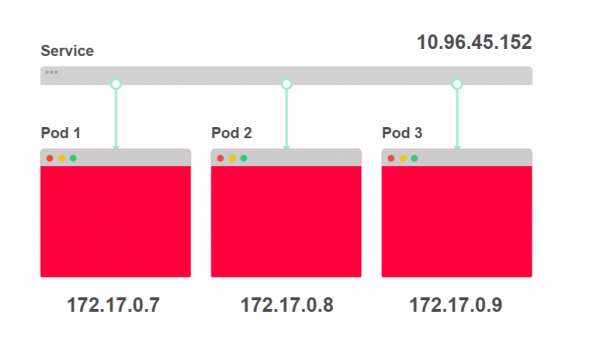
Je užitečné zvažovat služby jako soubor IP adres. Kdykoli se obrátíte na službu, jedna z IP adres je vybrána ze seznamu a použita jako cílová adresa.
Vypadá to takto.
- Požadavek curl 10.96.45.152 na službu:

- Služba vybírá jednu z třech adres podů jako cílovou:

- Provoz je přesměrován na konkrétní pod:


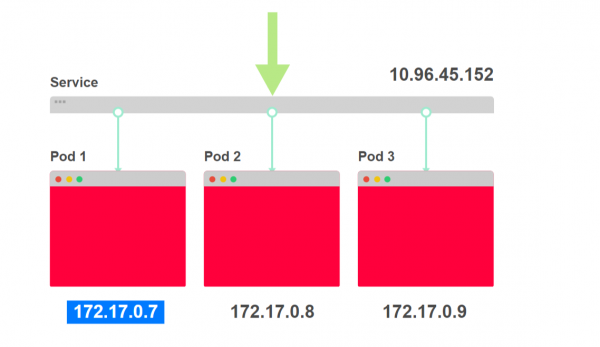
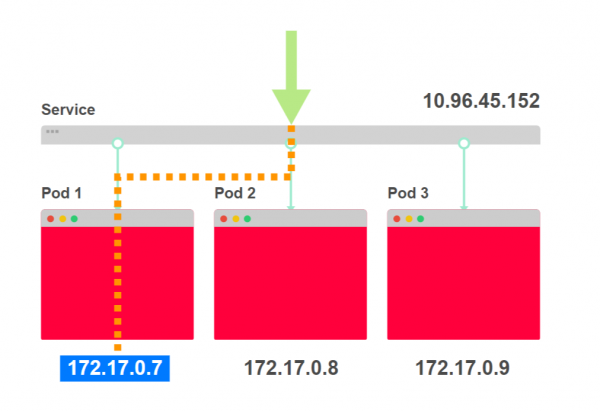
Pokud se vaše aplikace skládá z frontend a backend, budete mít službu i nasazení pro každé.
Když frontend provádí požadavek na backend, nemusí vědět, kolik přesně podů backend obsluhuje: může jich být jeden, deset nebo sto.
Frontend také nic neví o adresách podů, které obsluhují backend.
Když frontend provádí požadavek na backend, používá IP adresu služby backendu, která se nemění.
Takto to vypadá.
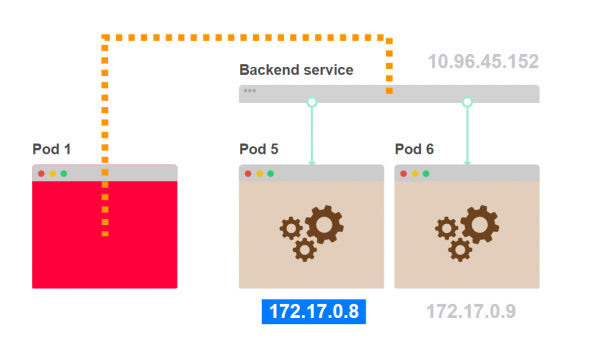
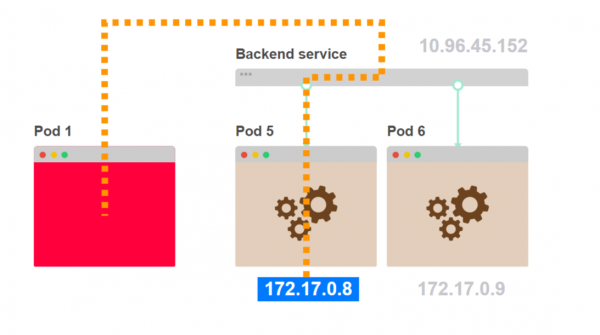
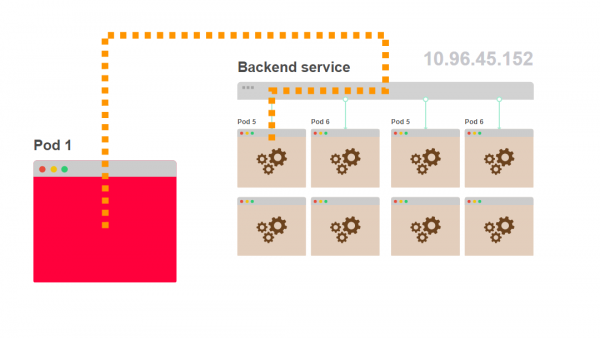
- Pod 1 provádí požadavek na interní komponentu backendu. Místo aby vybral konkrétní pod backendu, provádí požadavek na službu:

- Služba vybírá jeden z podů backendu jako cílovou adresu:

- Provoz jde od podu 1 k podu 5, který vybrala služba:

- Pod 1 neví, kolik přesně takových podů jako pod 5 je skryto za službou:

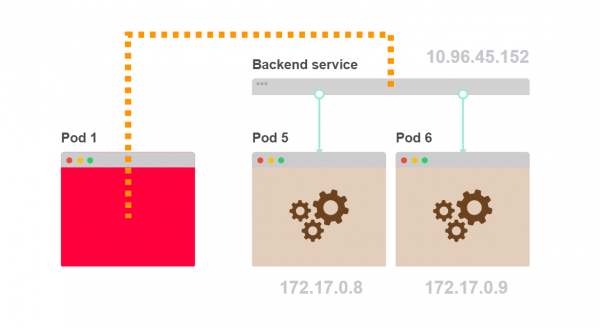
Ale jak přesně služba rozděluje dotazy? Vypadá to, že se používá vyvažování zátěže round-robin? Pojďme se na to podívat.
Vyvažování v službách Kubernetes
Služby Kubernetes neexistují. Pro službu neexistuje proces, kterému je přidělena IP adresa a port.
Můžete se o tom přesvědčit tím, že přejdete na libovolný uzel klastru a spustíte příkaz netstat -ntlp.
Ani nebudete schopni najít IP adresu přidělenou službě.
IP adresa služby je umístěna v řídicím rámci, v controlleru, a je zaznamenána v databázi — etcd. Tuto adresu používá také další komponent — kube-proxy.
Kube-proxy dostává seznam IP adres pro všechny služby a vytváří sadu pravidel iptables na každém uzlu klastru.
Tato pravidla říkají: „Pokud vidíme IP adresu služby, je třeba změnit cílovou adresu dotazu a poslat jej na jeden z podů.“
IP adresa služby se používá pouze jako vstupní bod a není obsluhována žádným procesem, který by naslouchal této IP adrese a portu.
Podívejme se na to.
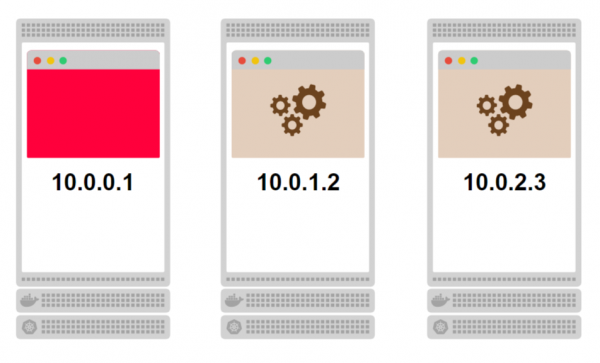
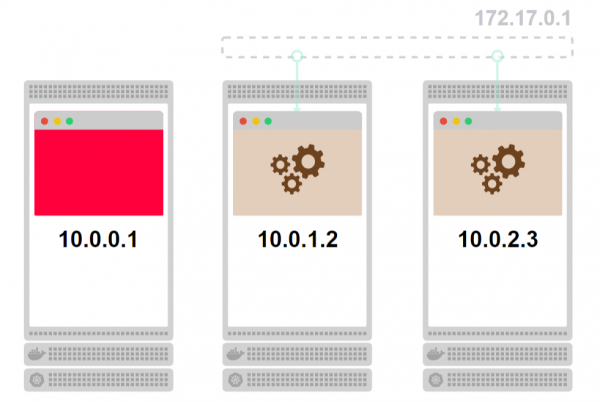
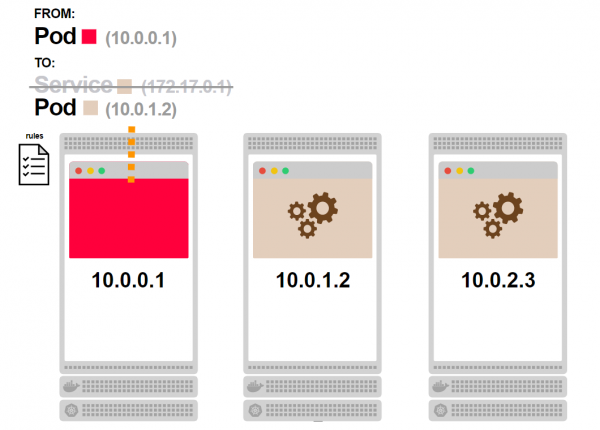
- Zvažme klastr ze tří uzlů. Na každém uzlu se nacházejí pady:

- Související pady, nabarvené béžovou barvou, jsou součástí služby. Protože služba neexistuje jako proces, je znázorněna šedou barvou:

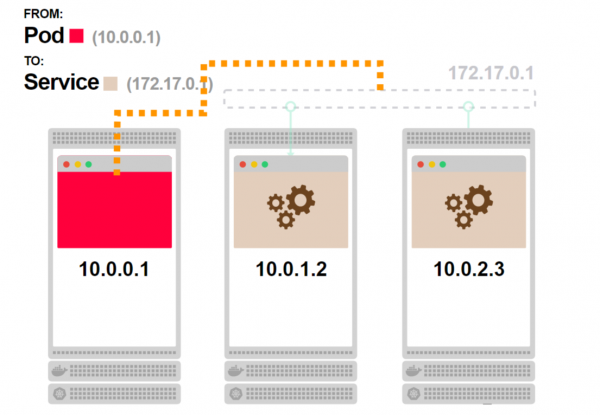
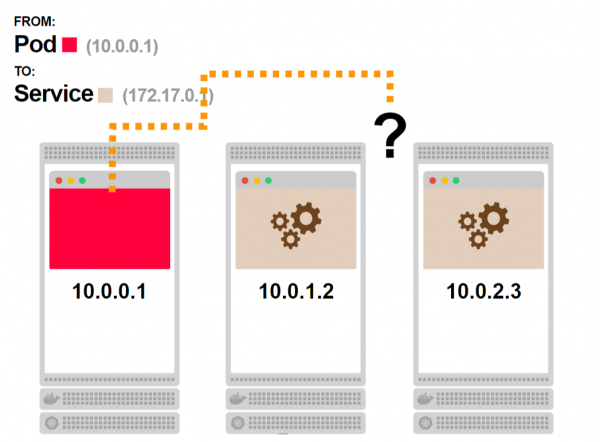
- První pod žádá o službu a měl by se dostat na jeden z souvisejících podů:

- Ale služba neexistuje, proces neexistuje. Jak to tedy funguje?

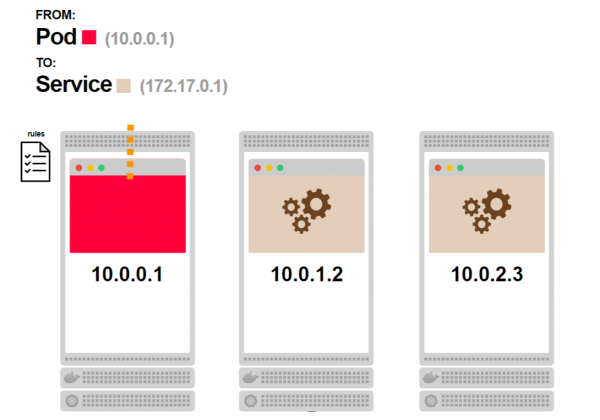
- Předtím, než žádost opustí uzel, prochází pravidly iptables:

- Pravidla iptables vědí, že služba neexistuje, a nahrazují její IP adresu jednou z IP adres podů souvisejících s touto službou:

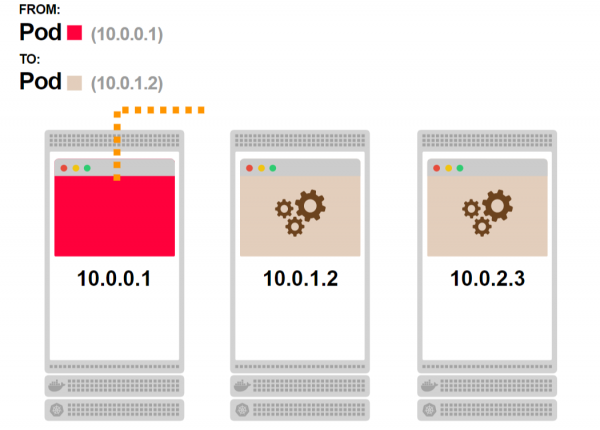
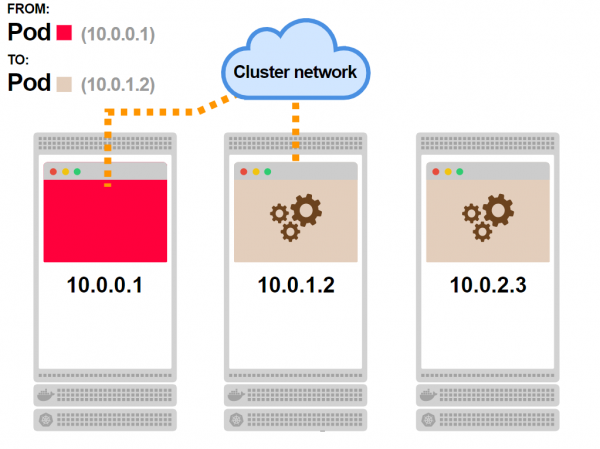
- Žádost dostává platnou IP adresu jako cílovou adresu a je normálně zpracována:
- V závislosti na síťové topologii dotaz nakonec dosáhne podu:

Umí iptables vyvažovat zátěž?
Ne, iptables se používají pro filtraci a nebyly navrženy pro vyvažování.
Existuje však možnost napsat sadu pravidel, která fungují jako .
A právě to je implementováno v Kubernetes.
Pokud máte tři pady, kube-proxy napíše následující pravidla:
- Vybrat první pod s pravděpodobností 33%, jinak přejít na další pravidlo.
- Vybrat druhý pod s pravděpodobností 50 %, jinak přejít na další pravidlo.
- Vybrat třetí pod.
Takový systém způsobuje, že každý pod je vybírán s pravděpodobností 33 %.
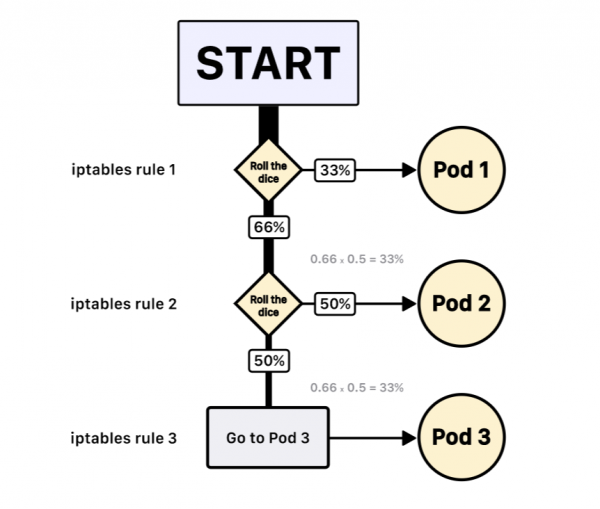
A neexistuje žádná záruka, že pod 2 bude vybrán jako další po podu 1.
Poznámka: iptables používá statistický modul se náhodným rozdělením. Takže algoritmus vyvažování je založen na náhodném výběru.
Teď, když rozumíte, jak služby fungují, podívejme se na zajímavější scénáře provozu.
Dlouhotrvající spojení v Kubernetes se standardně neškálují.
Každý HTTP požadavek z frontendu na backend je obsluhován samostatným TCP spojením, které se otevírá a zavírá.
Pokud frontend posílá 100 požadavků za sekundu na backend, otevře a zavře 100 různých TCP spojení.
Čas zpracování požadavku a zátěž lze snížit, pokud otevřete jedno TCP spojení a použijete ho pro všechny následující HTTP požadavky.
V protokolu HTTP je zakotvena možnost zvaná HTTP keep-alive, nebo opětovné použití spojení. V tomto případě se jedno TCP spojení používá k odesílání a přijímání mnoha HTTP požadavků a odpovědí:
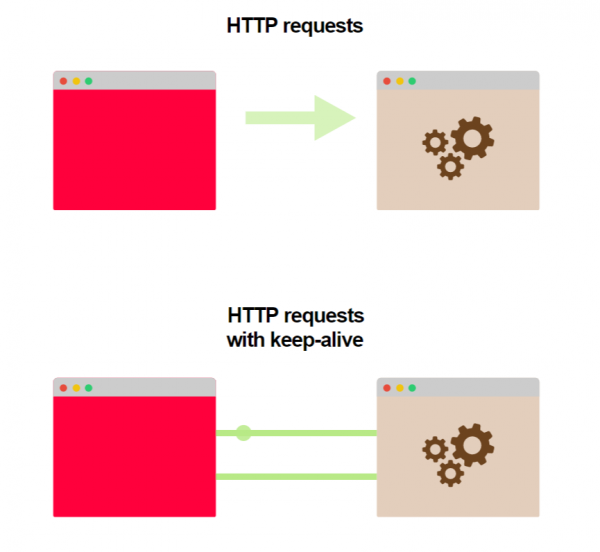
Tato možnost není ve výchozím nastavení povolena: jak server, tak klient musí být nakonfigurováni odpovídajícím způsobem.
Nastavení samotné je jednoduché a dostupné pro většinu programovacích jazyků a prostředí.
Tady je několik odkazů na příklady v různých jazycích:
Co se stane, pokud budeme používat keep-alive v Kubernetes službě?
Předpokládejme, že jak frontend, tak backend podporují keep-alive.
Máme jednu kopii frontendu a tři instance backendu. Frontend provede první požadavek a otevře TCP spojení na backend. Požadavek dorazí k službě, jeden z podů backendu je vybrán jako cílová adresa. Pod backendu posílá odpověď a frontend ji přijímá.
Na rozdíl od běžné situace, kdy se TCP spojení po přijetí odpovědi zavírá, je nyní udržováno otevřené pro další HTTP požadavky.
Co se stane, pokud frontend odešle další požadavky na backend?
Pro přeposílání těchto požadavků bude využito otevřené TCP spojení, všechny požadavky přijdou na ten samý pod backendu, kam dorazil první požadavek.
Nemělo by iptables přesměrovat provoz?
Ne v tomto případě.
Když je navázáno TCP spojení, prochází pravidly iptables, která vyberou konkrétní pod backendu, kam bude provoz směřovat.
Protože všechny následující požadavky jdou po již otevřeném TCP spojení, pravidla iptables už nejsou volána.
Podívejme se, jak to vypadá.
- První pod odešle požadavek na službu:

- Už víte, co se stane dál. Služba neexistuje, ale existují pravidla iptables, která zpracují požadavek:
- Jeden z podů backendu bude vybrán jako cílová adresa:

- Požadavek se dostává k podu. V tuto chvíli bude navázáno trvalé TCP spojení mezi dvěma pody:

- Každý další požadavek od prvního podu bude směřovat již na navázané spojení:

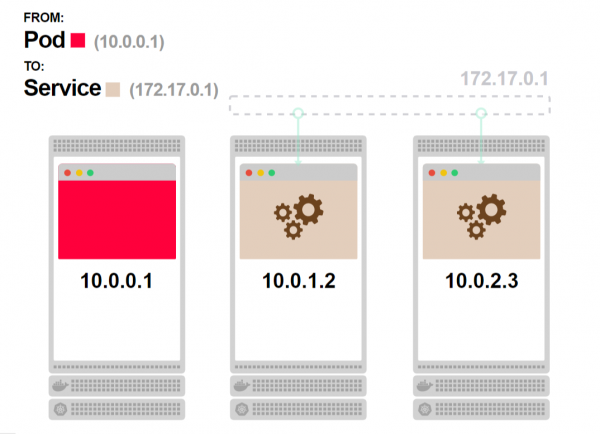
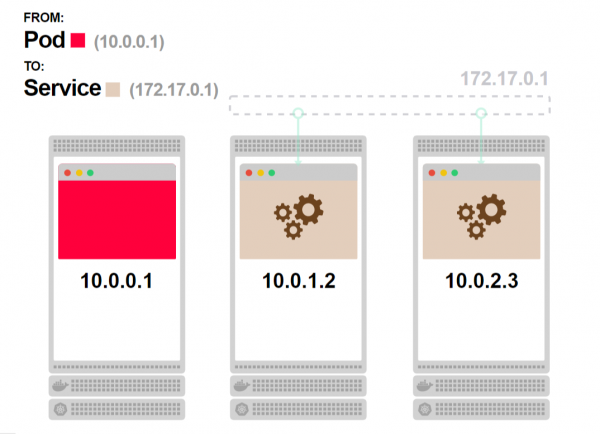
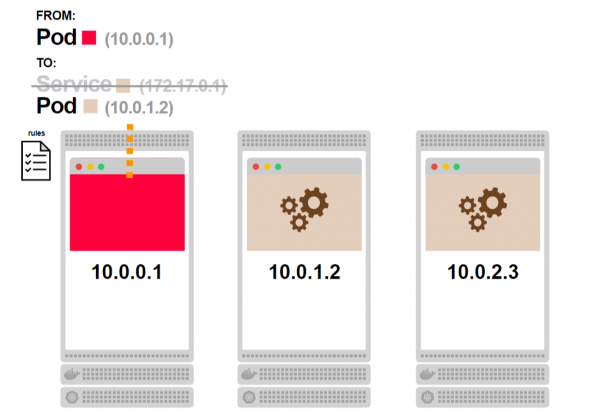
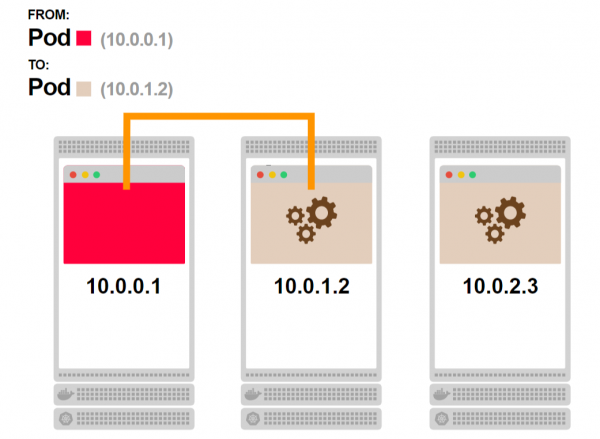
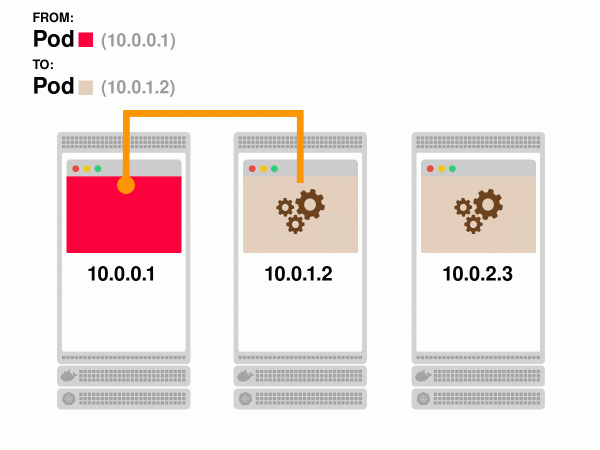
V důsledku toho máte rychlejší odezvu a vyšší propustnost, ale ztrácíte možnost škálovat backend.
I když máte v backendu dva pody, při trvalém spojení bude provoz neustále směřovat na jeden z nich.
Lze to napravit?
Protože Kubernetes neví, jak vyvážit trvalá spojení, je tato úloha svěřena vám.
Služby jsou soubor IP adres a portů, které se nazývají koncové body.
Vaše aplikace může získat seznam koncových bodů ze služby a rozhodnout, jak rozdělit požadavky mezi nimi. Můžete otevřít trvalé spojení s každým pod a vyvážit požadavky mezi těmito spojeními pomocí round-robin.
Nebo aplikovat složitější .
Kód na straně klienta, který odpovídá za vyvažování, by měl dodržovat následující logiku:
- Získat seznam koncových bodů ze služby.
- Pro každý koncový bod otevřít trvalé spojení.
- Když je potřeba provést požadavek, použít jedno z otevřených spojení.
- Pravidelně aktualizovat seznam koncových bodů, vytvářet nová nebo uzavírat stará trvalá spojení v případě změny seznamu.
Takto to bude vypadat:.
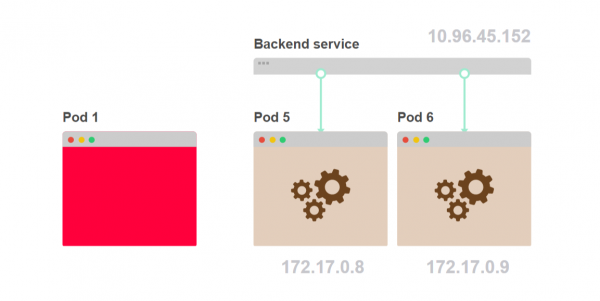
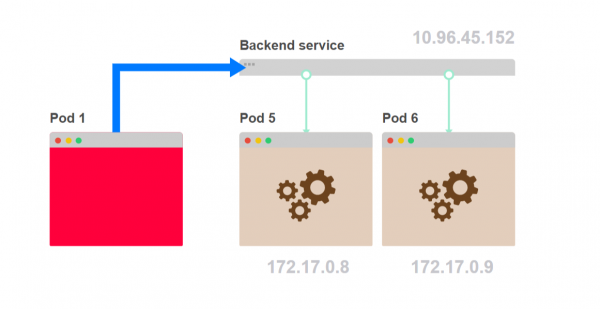
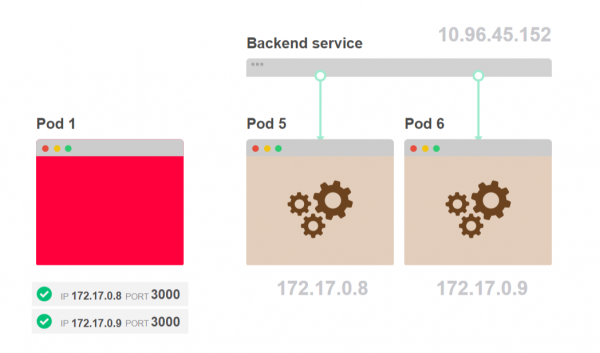
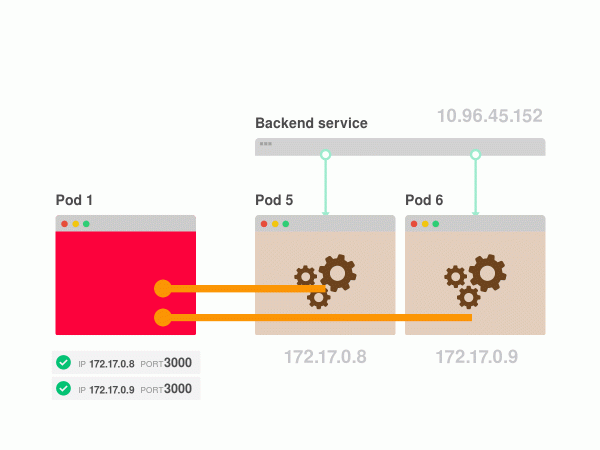
- Místo toho, aby první pod odesílal požadavek na službu, můžete balancovat požadavky na straně klienta:

- Musíte napsat kód, který se zeptá, které pody jsou součástí služby:

- Jakmile získáte seznam, uložte ho na straně klienta a použijte ho k připojení k podům:

- Nesete si odpovědnost za algoritmus vyvažování zátěže:
Teď se objeví otázka: vztahuje se tento problém pouze na HTTP keep-alive?
Vyvažování zátěže na straně klienta
HTTP není jediný protokol, který může využívat trvalá TCP spojení.
Pokud vaše aplikace používá databázi, TCP spojení se neotevírá pokaždé, když potřebujete provést dotaz nebo získat dokument z DB.
Místo toho se otevře a používá trvalé TCP spojení k databázi.
Pokud je vaše databáze nasazena v Kubernetes a přístup je poskytován jako služba, potkáte se se stejnými problémy, které jsou popsány v předchozí části.
Jedna replika databáze bude zatížena více než ostatní. Kube-proxy a Kubernetes nepomohou vyvažovat spojení. Musíte se postarat o vyvažování dotazů na vaši databázi.
V závislosti na tom, kterou knihovnu používáte pro připojení k DB, můžete mít různé možnosti, jak tento problém vyřešit.
Níže je příklad přístupu ke clustru DB MySQL z Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* retrieve endpoints from the Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Make queries to the clustered MySQL database
Existuje spousta dalších protokolů, které využívají trvalá TCP spojení:
- WebSockets a zabezpečené WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
Musíte být už obeznámeni s většinou těchto protokolů.
Ale pokud jsou tyto protokoly tak populární, proč neexistuje standardizované řešení pro vyvažování? Proč je potřeba změna logiky klienta? Existuje nativní řešení Kubernetes?
Kube-proxy a iptables jsou vytvořeny tak, aby pokryly většinu standardních scénářů použití při nasazení v Kubernetes. Je to uděláno pro pohodlí.
Pokud používáte webovou službu, která poskytuje REST API, máte štěstí — v tomto případě se trvalá TCP spojení nepoužívají, můžete použít jakoukoli službu Kubernetes.
Ale jakmile začnete používat trvalá TCP spojení, budete muset zjistit, jak rovnoměrně rozdělit zátěž na backendy. Kubernetes neobsahuje hotová řešení pro tento případ.
Existují však možnosti, které mohou pomoci.
Vyvažování dlouhodobých spojení v Kubernetes
V Kubernetes existují čtyři typy služeb:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
První tři služby fungují na základě virtuální IP adresy, kterou kube-proxy používá k vytváření iptables pravidel. Ale základní podstatou všech služeb je headless služba.
Headless služba není spojená s žádnou IP adresou a pouze poskytuje mechanismus pro získání seznamu IP adres a portů souvisejících s ním podů (koncové body).
Všechny služby jsou založeny na headless službě.
Služba ClusterIP je headless služba s některými doplněními:
- Správa vrstva jí přiřazuje IP adresu.
- Kube-proxy vytváří potřebná iptables pravidla.
Takže můžete ignorovat kube-proxy a přímo použít seznam koncových bodů získaných ze služby headless pro vyvažování zatížení ve vaší aplikaci.
Ale jak přidat takovou logiku do všech aplikací nasazených v clusteru?
Pokud je vaše aplikace již nasazena, může se tato úloha zdát nemožná. Existuje však alternativní možnost.
Service Mesh vám pomůže
Určitě jste si už všimli, že strategie vyvažování zatížení na straně klienta je poměrně standardní.
Když se aplikace spouští, dělá toto:
- Získává seznam IP adres ze služby.
- Otevírá a udržuje pool spojení.
- Pravidelně aktualizuje pool, přidává nebo odstraňuje koncové body.
Jakmile aplikace chce provést požadavek, dělá toto:
- Vybere dostupné spojení, pomocí nějaké logiky (například round-robin).
- Provádí požadavek.
Tyto kroky fungují i pro WebSocket spojení, gRPC a AMQP.
Tuto logiku můžete vyčlenit do samostatné knihovny a používat ji ve vašich aplikacích.
Místo toho však můžete použít servisní sítě, například Istio nebo Linkerd.
Service Mesh doplňuje vaši aplikaci procesem, který:
- Automaticky vyhledává IP adresy služeb.
- Kontroluje spojení jako WebSockets a gRPC.
- Vyvažuje požadavky, používajíc správný protokol.
Service Mesh pomáhá řídit provoz uvnitř clusteru, ale je poměrně náročný na zdroje. Další varianty zahrnují použití třetích knihoven, jako je Netflix Ribbon, nebo programovatelných proxy, například Envoy.
Co se stane, pokud ignorujete otázky vyvažování?
Můžete se obejít bez vyvažování zatížení a přitom si nevšimnout žádných změn. Podívejme se na několik scénářů fungování.
Pokud máte více klientů než серверů, není to tak velký problém.
Představme si, že existuje pět klientů, kteří se připojují ke dvěma serverům. I bez vyvažování zátěže budou oba servery používány:
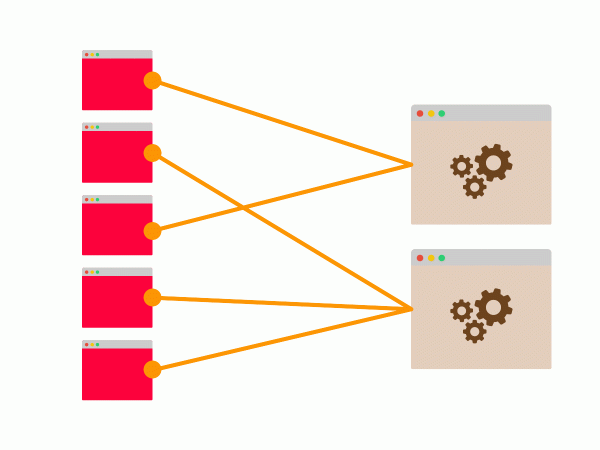
Připojení mohou být rozdělena nevyváženě: čtyři klienti se mohou připojit k jednomu a tomu samému serveru, ale je dobrá šance, že oba servery budou využity.
Oproti tomu je výrazně problematičtější opačný scénář.
Pokud máte méně klientů a více serverů, mohou být vaše zdroje nedostatečně využity a to může vést k potenciálnímu úzkému místu.
Představme si, že jsou dva klienti a pět serverů. V nejlepším případě budou existovat dvě trvalá připojení k dvěma serverům ze pěti.
Ostatní servery budou nečinné:
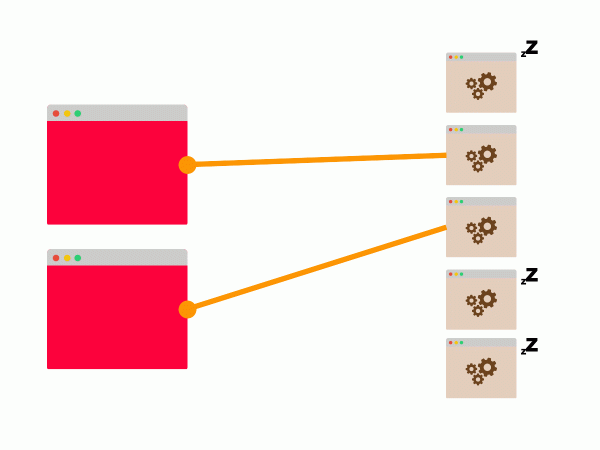
Pokud tyto dva servery nezvládnou zpracování požadavků klientů, horizontální škálování nepomůže.
Závěr
Služby Kubernetes jsou navrženy pro práci ve většině standardních scénářů webových aplikací.
Jakmile však začnete pracovat s aplikačními protokoly, které používají trvalá TCP připojení, jako jsou databáze, gRPC nebo WebSockets, služby už nejsou vhodné. Kubernetes nenabízí žádné vnitřní mechanismy pro vyvažování trvalých TCP připojení.
To znamená, že musíte psát aplikace s ohledem na možnost vyvažování na straně klienta.
Překlad připravila tým .
Co dalšího si přečíst na toto téma:
- .
- .
- .
Zdroj: habr.com
