

KDB+, produkt společnosti — je široce známá v úzkých kruzích jako mimořádně rychlá sloupcová databáze určená pro ukládání časových řad a analytické výpočty na jejich základě. Původně byla (a stále je) velmi populární v odvětví financí — používají ji všechny top-10 investiční banky a mnoho známých hedge fondů, burz a dalších organizací. V poslední době se KX rozhodla rozšířit svou zákaznickou základnu a nyní nabízí řešení i v jiných oblastech, kde existuje velké množství dat seřazených podle času nebo jinak — telekomunikace, bioinformatika, výroba atd. Stali se také partnerem týmu Aston Martin Red Bull Racing ve "Formuli 1", kde pomáhají shromažďovat a zpracovávat data ze senzorů vozů a analyzovat testy v aerodynamickém tunelu. V tomto článku chci vyprávět, jaké vlastnosti KDB+ ji činí vysoce výkonnou, proč jsou společnosti ochotny investovat do ní velké peníze a konečně, proč to ve skutečnosti není databáze.
V tomto článku se pokusím celkově popsat, co KDB+ představuje, jaké má možnosti a omezení, a jaký je její přínos pro společnosti, které chtějí zpracovávat velké objemy dat. Nehodlám se zabývat podrobnostmi implementace KDB+ a jejím programovacím jazykem Q. Obě tato témata jsou velmi rozsáhlá a zaslouží si samostatné články. Mnoho informací k těmto tématům lze nalézt na webu code.kx.com, včetně knihy o Q — Q For Mortals (viz odkaz níže).
Některé termíny
- In-memory databáze. Databáze, která uchovává data v operační paměti pro urychlení přístupu. Výhody takové databáze jsou jasné, ale nevýhody — možnost ztráty dat, nutnost mít na serveru hodně paměti.
- Sloupcová databáze. Databáze, kde se data uchovávají po sloupcích, nikoli po záznamech. Hlavní výhodou takové databáze je, že data z jednoho sloupce se uchovávají pohromadě na disku a v paměti, což značně urychluje přístup k nim. Není třeba načítat sloupce, které se v dotazu nepoužívají. Hlavní nevýhodou je, že je složité měnit a mazat záznamy.
- Časová řada. Data s typem sloupce jako datum nebo čas. Obvykle je u těchto dat důležité časové uspořádání, aby bylo snadné určit, který záznam předchází nebo následuje po aktuálním, nebo aby bylo možné aplikovat funkce, jejichž výsledek závisí na pořadí záznamů. Klasické databáze jsou založeny na zcela jiném principu – představují soubor záznamů jako množinu, kde pořadí záznamů není obecně definováno.
- Vektor. V kontextu KDB+ je to seznam prvků jednoho atomárního typu, například čísel. Jinými slovy, pole prvků. Pole, na rozdíl od seznamů, lze skladovat kompaktně a zpracovávat pomocí vektorových instrukcí procesoru.
Historie
Společnost KX byla založena v roce 1993 Arthurem Whitney, který předtím pracoval v bance Morgan Stanley na jazyce A+, nástupci APL — velmi originálním a v době svého vzniku populárním jazykem ve finančním světě. Samozřejmě, že v KX Arthur pokračoval v tomto duchu a vytvořil vektorově-funkční jazyk K, řízený myšlenkami radikálního minimalismu. Programy v K vypadají jako neuspořádaný soubor interpunkčních znamének a speciálních symbolů, jejichž význam závisí na kontextu, a každá operace nese mnohem větší smysl, než je obvyklé v tradičních programovacích jazycích. Díky tomu program v K zabírá minimální prostor — několik řádků může nahradit stránky textu obsažného jazyka jako Java — a je vysoce koncentrovanou realizací algoritmu.
Funkce v K, která implementuje většinu generátoru LL1 parseru podle dané gramatiky:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Tuto filozofii extrémní efektivity s minimem pohybu Arthur zrealizoval také v KDB+, která vznikla v roce 2003 (myslím, že už je jasné, odkud pochází písmeno K v názvu) a není ničím jiným než interpretem čtvrté verze jazyka K. Na K byla přidána uživatelsky příjemnější verze K nazvaná Q. V Q byla také přidána podpora specifického dialektu SQL — QSQL, a do interpretu byla integrována podpora tabulek jako systémového typu dat, prostředků pro práci s tabulkami v paměti a na disku atd.
Z pohledu uživatele je KDB+ tedy prostě interpretem jazyka Q s podporou tabulek a SQL podobných výrazů ve stylu LINQ z C#. To je nejvýznamnější rozdíl KDB+ od ostatních databází a hlavní konkurentní výhoda, kterou si často málokdo uvědomuje. Není to databáze + pomocný jazyk, ale plnohodnotný výkonný programovací jazyk + vestavěná podpora databázových funkcí. Tento rozdíl bude hrát rozhodující roli při vyjmenovávání všech výhod KDB+. Například…
Velikost
Z moderního pohledu má KDB+ neuvěřitelně malou velikost. Je to v doslovném smyslu jeden spustitelný soubor menší než megabajt a jeden malý textový soubor s některými systémovými funkcemi. Opraveno — méně než jeden megabajt a za tento program firmy platí desítky tisíc dolarů ročně za jeden procesor na serveru.
- Taková velikost umožňuje KDB+ výborně fungovat na jakémkoliv hardwaru — od mikrocomputeru Pi po servery s terabajty paměti. Na funkčnost to nijak neovlivňuje, navíc Q startuje okamžitě, což umožňuje jeho použití i jako skriptovací jazyk.
- Při takové velikosti se interpret Q vejde zcela do procesorové cache, což urychluje výkon programů.
- Při takové velikosti spustitelného souboru proces Q zabírá nepatrné množství paměti, lze je spouštět v řádu stovek. Přitom v případě potřeby Q může pracovat i s desítkami až stovkami gigabajtů paměti v rámci jednoho procesu.
Univerzálnost
Q je ideální pro nejrůznější úkoly. Proces Q může fungovat jako historická databáze a poskytovat rychlý přístup k terabajtům informací. Například máme desítky historických databází, přičemž v některých z nich zabírá jeden nekomprimovaný den dat více než 100 gigabajtů. Přesto, s rozumnými omezeními, je dotaz do databáze proveden v řádu desítek až stovek milisekund. Obecně máme pro uživatelské dotazy univerzální timeout - 30 sekund - a ten se spouští velmi zřídka.
Se stejnou lehkostí může být Q in-memory databází. Přidání nových dat do tabulek v paměti probíhá tak rychle, že limitujícím faktorem jsou uživatelské dotazy. Data v tabulkách jsou uložena podle sloupců, což znamená, že jakákoli operace se sloupci využije procesorovou cache naplno. Kromě toho se v KX snažili implementovat všechny základní operace, jako jsou aritmetické, prostřednictvím vektorových instrukcí procesoru, čímž maximalizují jejich rychlost. Q může vykonávat také úkoly, které nejsou typické pro databáze - například zpracovávat streamová data a počítat v "reálném čase" (s prodlevou od desítek milisekund do několika sekund v závislosti na úkolu) různé agregační funkce pro finanční nástroje pro různé časové intervaly, nebo vytvářet model vlivu uskutečněné transakce na trh a provádět její profilaci prakticky okamžitě po jejím uskutečnění. U takových úkolů často způsobuje hlavní časovou prodlevu nikoli Q, ale potřeba synchronizace dat z různých zdrojů. Vysoké rychlosti je dosaženo díky tomu, že data a funkce, které je zpracovávají, jsou ve stejném procesu, a zpracování spočívá ve vykonávání několika QSQL výrazů a spojení, která nejsou interpretována, ale vykonávána v binárním kódu.
Konečně, na Q lze psát také jakékoli servisní procesy. Například Gateway procesy, které automaticky rozdělují uživatelské dotazy mezi potřebu databází a serverů. Programátor má úplnou svobodu implementovat jakýkoli algoritmus pro vyvažování, prioritizaci, odolnost proti chybám, práva přístupu, kvóty a obecně cokoli, co si přeje. Hlavní problém tkví v tom, že si to všechno bude muset implementovat sám.
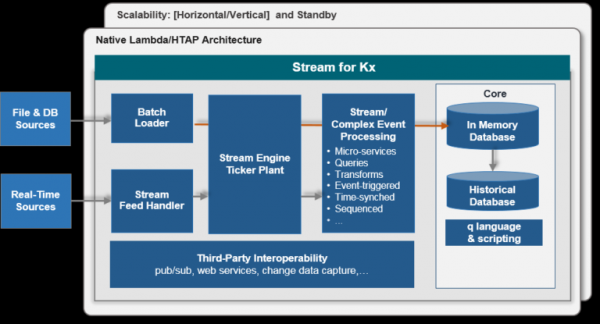
Jako příklad uvedu, jaké typy procesů máme. Všechny jsou aktivně používány a spolupracují, spojují do jednoho celku desítky různých databází, zpracovávají data z mnoha zdrojů a obsluhují stovky uživatelů a aplikací.
- Konektory (feedhandler) k datovým zdrojům. Tyto procesy obvykle využívají externí knihovny, které se načítají do Q. C-interface v Q je velmi jednoduchý a umožňuje snadno vytvořit proxy funkce pro jakoukoli C/C++ knihovnu. Q je dostatečně rychlý, aby zvládl například zpracování proudu FIX zpráv ze všech evropských burz současně.
- Datové distributory (tickerplant), které slouží jako mezičlánek mezi konektory a spotřebiteli. Současně zapisují příchozí data do speciálního binárního logu, což zajišťuje odolnost spotřebitelů vůči ztrátám připojení nebo restartům.
- In-memory databáze (rdb). Tyto databáze poskytují co nejrychlejší přístup k čerstvým syrovým datům, ukládají je do paměti. Obvykle shromažďují data v tabulkách během dne a v noci je resetují.
- Persist databáze (pdb). Tyto databáze zajišťují uchování dat za dnešek do historické databáze. Na rozdíl od rdb obvykle neukládají data do paměti, ale využívají speciální cache na disku během dne a kopírují data o půlnoci do historické databáze.
- Historické databáze (hdb). Tyto databáze poskytují přístup k datům za předchozí dny, měsíce a roky. Jejich velikost (v dnech) je omezena pouze velikostí pevných disků. Data mohou být uložena kdekoli, například na různých discích pro urychlení přístupu. Existuje možnost komprimace dat pomocí několika vybraných algoritmů. Struktura databáze je dobře zdokumentována a jednoduchá, data jsou ukládána po sloupcích v běžných souborech, což umožňuje jejich zpracování také nástroji operačního systému.
- Databáze s agregovanými informacemi. Ukládají různé agregace, obvykle seskupené podle názvu nástroje a časového intervalu. In-memory databáze aktualizují svůj stav při každé příchozí zprávě, zatímco historické uchovávají předpočítaná data pro urychlení přístupu k historickým datům.
- Nakonec gateway procesy, spravující aplikace a uživatele. Q umožňuje plně asynchronní zpracování příchozích zpráv, jejich rozdělení mezi databázemi, kontrolu přístupových práv atd. Podotýkám, že zprávy nejsou omezeny a často nejsou SQL výrazy, jak to bývá v jiných databázích. Nejčastěji je SQL výraz skryt v speciální funkci a konstruován na základě parametrů požadovaných uživatelem — provádí se konverze času, filtrování, data se normalizují (například cena akcií se upraví, pokud došlo k vyplacení dividend) atd.
Typická architektura pro jeden typ dat:
Rychlost
Ačkoliv je Q interpretovaný jazyk, je to také jazyk vektorový. To znamená, že mnoho vestavěných funkcí, zejména aritmetických, přijímá argumenty jakékoli formy — čísla, vektory, matice, seznamy, a od programátora se očekává, že bude realizovat program jako operace nad poli. V takovém jazyce, pokud sčítáte dva vektory s milionem prvků, už nezáleží na tom, že je jazyk interpretovaný, sčítání bude prováděno superoptimalizovanou binární funkcí. Protože velká část času v programech na Q je věnována operacím s tabulkami, které používají tyto základní vektorizované funkce, tak výsledná rychlost zpracování je docela slušná, což umožňuje zpracovávat obrovské objemy dat i v jednom procesu. Je to podobné jako matematické knihovny v pythonu — ačkoliv je python jazyk poměrně pomalý, má mnoho skvělých knihoven, jako je numpy, které umožňují zpracování číselných dat rychlostí kompilovaného jazyka (mimochodem, numpy je ideologicky blízká Q).
KX se velmi pečlivě věnuje designu tabulek a optimalizaci práce s nimi. Za prvé, podporuje několik typů indexů, které jsou podporovány vestavěnými funkcemi a mohou být aplikovány nejen na sloupce tabulek, ale i na jakékoli vektory — agregace, třídění, atribut uniqueness a speciální agregace pro historické databáze. Index je aplikován jednoduše a automaticky se upravuje při přidání prvků do sloupce / vektoru. Indexy mohou být úspěšně aplikovány na sloupce tabulek jak v paměti, tak na disku. Při provádění dotazu QSQL se indexy automaticky používají, pokud je to možné. Za druhé, práce s historickými daty je realizována prostřednictvím mechanismu mapování souborů OS (memory map). Velké tabulky se nikdy nenačítají do paměti, místo toho se potřebné sloupce přímo mapují do paměti a skutečně se načítá pouze ta část (s pomocí indexů), která je potřeba. Pro programátora není rozdíl, zda jsou data v paměti nebo ne, mechanismus práce s mmap je plně skryt uvnitř Q.
KDB+ je nerelační databáze, tabulky mohou obsahovat libovolná data, přičemž pořadí řádků v tabulce se při přidání nových prvků nemění a musí být použito při psaní dotazů. Tato vlastnost je nezbytná pro práci s časovými řadami (data z burzy, telemetrie, logy událostí), protože pokud jsou data seřazena podle času, uživatel nemusí používat žádné SQL triky, aby nalezl v tabulce první nebo poslední časový řádek nebo N řádků, určil, který řádek následuje po N-tém řádku atd. Ještě více se zjednodušují joiny tabulek, například nalezení poslední nabídky pro 16000 obchodů VOD.L (Vodafone) v tabulce o 500 milionech prvků trvá na disku přibližně jednu sekundu a desítky milisekund v paměti.
Příklad joinu podle času — tabulka quote je mapována do paměti, proto není nutné uvádět VOD.L ve where, implicitně se používá index na sloupci sym a skutečnost, že data jsou seřazena podle času. Téměř všechny joiny v Q jsou běžné funkce, nikoli součástí select výrazu:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Nakonec je třeba zmínit, že inženýři v KX, počínaje samotným Arthurem Whitneyem, jsou skutečně posedlí efektivitou a vydávají veškeré úsilí, aby vytěžili maximum ze standardních funkcí Q a optimalizovali nejběžnější modely využití.
Výsledek
KDB+ je populární v podnikání zejména díky své výjimečné univerzálnosti - funguje stejně dobře jako in-memory databáze, jako databáze pro ukládání terabajtů historických dat, a jako platforma pro analýzu dat. Díky tomu, že zpracování dat probíhá přímo v databázi, je dosaženo vysoké rychlosti práce a úspory zdrojů. Plnohodnotný programovací jazyk integrovaný s funkcemi databáze umožňuje realizovat na jedné platformě celý potřebný procesní stack - od získávání dat po zpracování uživatelských dotazů.
Další informace
Nevýhody
Podstatnou nevýhodou KDB+/Q je vysoký prah vstupu. Jazyk má podivnou syntaxi, některé funkce jsou silně přetížené (value například má asi 11 variant použití). Nejvíce důležité je, že vyžaduje radikálně jiný přístup k psaní programů. Ve vektorovém jazyce je nutné neustále myslet v termínech transformací polí, všechny smyčky realizovat prostřednictvím několika variant funkcí map/reduce (které se nazývají adverbs v Q), a nikdy se nepokoušet šetřit nahrazením vektorových operací atomovými. Například pro nalezení indexu N-tého výskytu prvku v poli byste měli psát:
1. (where element=vector)[N]
i když to vypadá hrozně neefektivně podle měřítek C/Java (= vytváří booleovský vektor, where vrací indexy true prvků v něm). Ale takový zápis činí smysl výrazu jasnějším a používáte rychlé vektorové operace místo pomalých atomových. Konceptuální rozdíl mezi vektorovým jazykem a ostatními je srovnatelný s rozdílem mezi imperativními a funkcionálními přístupy k programování, a na to je třeba se připravit.
Někteří uživatelé také vyjadřují nespokojenost s QSQL. Je to proto, že se jen podobá skutečnému SQL. Ve skutečnosti je to pouze interpreter SQL-podobných výrazů, který nepodporuje optimalizaci dotazů. Uživatel musí sám psát optimální dotazy, a to v Q, což mnozí nejsou připraveni udělat. Na druhou stranu je samozřejmě vždy možné napsat optimální dotaz sám, místo aby se spolehli na černou skříňku-optimalizátor.
Další výhodou je, že kniha o Q — Q For Mortals je dostupná zdarma na , kde je také shromážděno mnoho dalších užitečných materiálů.
Dalším velkým mínusem je cena licence. To jsou desítky tisíc dolarů ročně za jeden CPU. Takové výdaje si mohou dovolit jen velké firmy. V poslední době KX učinila svou licenční politiku flexibilnější a umožňuje platit pouze za dobu používání nebo si pronajmout KDB+ v cloudech Google a Amazon. Kromě toho KX nabízí ke stažení (32bitová verze nebo 64bitová na vyžádání).
Konkurenti
Existuje poměrně hodně specializovaných databází, které jsou postaveny na podobných principech — sloupcové, in-memory, orientované na velmi velké objemy dat. Problém je v tom, že se jedná o specializované databáze. Jasným příkladem je Clickhouse. Tato databáze má velmi podobný princip ukládání dat na disk a struktury indexu jako KDB+, některé dotazy provádí rychleji než KDB+, i když ne výrazně. Ale i jako databáze je Clickhouse více specializovaná než KDB+ — webová analytika versus libovolné časové řady (toto rozlišení je velmi důležité — například v Clickhouse není možnost používat pořadí záznamů). Ale hlavně, Clickhouse postrádá univerzálnost KDB+, jazyka, který by umožnil zpracovávat data přímo v databázi, a ne je předem načítat do samostatné aplikace, vytvářet libovolné SQL výrazy, aplikovat libovolné funkce v dotazu, vytvářet procesy nesouvisející s prováděním funkcí historické databáze. Proto je obtížné srovnávat KDB+ s jinými databázemi, mohou být lepší v určitých scénářích použití nebo jednoduše lepší, pokud jde o úkoly klasických databází, ale neznám jiný tak účinný a univerzální nástroj pro zpracování časových dat.
Integrace s Pythonem
Aby KX usnadnili práci s KDB+ lidem, kteří nejsou obeznámeni s touto technologií, vytvořili knihovny pro úzkou integraci s Pythonem v rámci jednoho procesu. Je možné volat jakoukoli python funkci z Q, tak i naopak — volat jakoukoli Q funkci z Pythonu (zejména QSQL výrazy). Knihovny konvertují při potřebě (kvůli efektivitě ne vždy) data z formátu jednoho jazyka do formátu druhého. Výsledkem je, že Q a Python žijí v tak úzkém symbiotickém vztahu, že hranice mezi nimi jsou rozmazané. Programátor tak má na jedné straně plný přístup k mnoha užitečným knihovnám Pythonu a na druhé straně dostává rychlou databázi integrovanou do Pythonu pro práci s velkými daty, což je obzvlášť užitečné pro ty, kteří se zabývají strojovým učením nebo modelováním.
Práce s Q v Pythonu:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Odkazy
Web společnosti —
Web pro vývojáře —
Kniha Q For Mortals (v angličtině) —
Články o aplikacích KDB+/Q od zaměstnanců kx —
Zdroj: habr.com
