

RabbitMQ – broker zpráv napsaný v jazyce Erlang, který umožňuje organizaci vysoce dostupného clusteru s plnou replikací dat na několik uzlů, přičemž každý uzel může obsluhovat požadavky na čtení a zápis. Vzhledem k tomu, že máme v produkčním prostředí několik clusterů Kubernetes, podporujeme velké množství instalací RabbitMQ a setkali jsme se s potřebou migrace dat z jednoho clusteru do druhého bez výpadku.
Tato operace byla nutná minimálně ve dvou případech:
- Přenos dat z clusteru RabbitMQ, který není v Kubernetes, do nového — již "kubernezovaného" (tj. fungujícího v pod K8s) — clusteru.
- Migrace RabbitMQ v rámci Kubernetes z jednoho namespace do druhého (například pokud jsou obrysy omezeny prostory jmen, pak pro přenos infrastruktury z jednoho obrysu do druhého).
Navrhovaný recept v článku je zaměřen na situace (ale není jimi omezen), kdy existuje starý cluster RabbitMQ (například ze 3 uzlů), který je buď již v K8s, nebo na nějakých starých serverech. S ním pracuje aplikace umístěná v Kubernetes (už tam nebo v budoucnu):
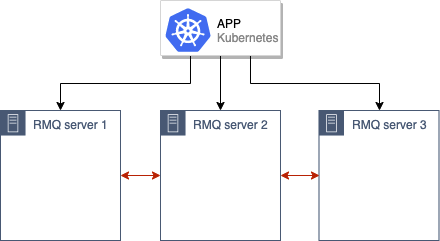
… a před námi stojí úkol jeho migrace do nového produkčního prostředí v Kubernetes.
Nejprve bude popsán obecný přístup k samotné migraci, a teprve poté – technické detaily její realizace.
Algoritmus migrace
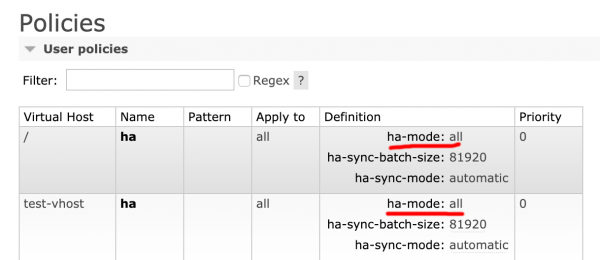
První, předběžný krok před jakýmikoli akcemi – zkontrolovat, že ve staré instalaci RabbitMQ je zapnutý režim vysoké dostupnosti (). Důvod je zřejmý – nechceme přece přijít o žádná data. K ověření tohoto stavu lze vstoupit do administrace RabbitMQ a v záložce Admin → Policies se ujistit, že je nastavena hodnota ha-mode: all:
Dalším krokem je spuštění nového clusteru RabbitMQ v podech Kubernetes (v našem případě například složeného ze 3 uzlů, ale jejich počet může být i jiný).
Poté spojíme starý a nový cluster RabbitMQ a získáme jednotný cluster (ze 6 uzlů):
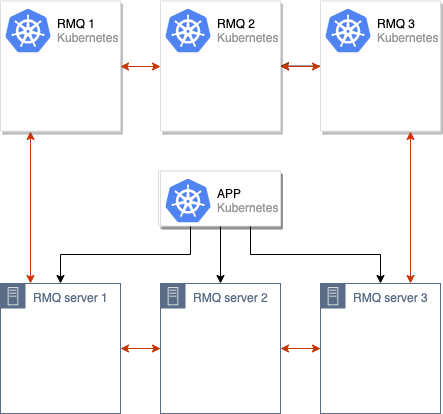
Spouští se proces synchronizace dat mezi starým a novým clusterem RabbitMQ. Jakmile se všechna data synchronizují mezi všemi uzly v clusteru, můžeme přepnout aplikaci na používání nového clusteru:
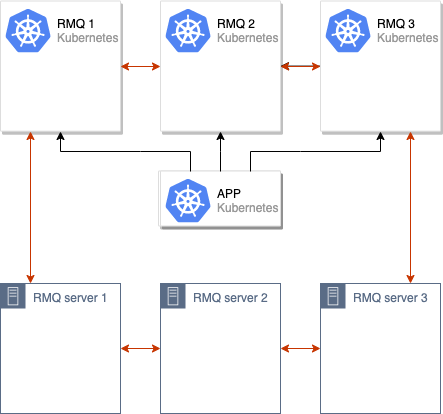
Po těchto operacích stačí odpojit staré uzly z clusteru RabbitMQ a přesun můžeme považovat za dokončený:
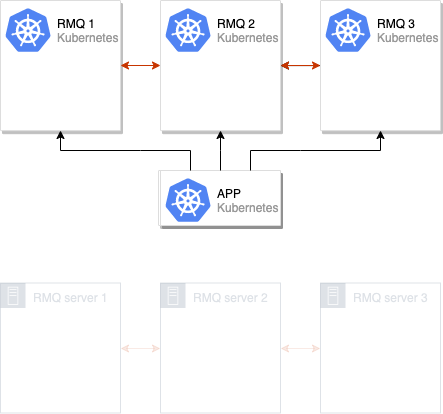
Tento schéma jsme opakovaně aplikovali v našich produkčních prostředích. Nicméně, pro vlastní pohodlí jsme ji implementovali v rámci specializovaného systému, který distribuuje standardní konfigurace RMQ na mnoha clusterech Kubernetes. (pro ty, kdo se zajímají: mluvíme o , o kterém jsme ). Níže budou uvedeny jednotlivé pokyny, které si každý může aplikovat na svých instalacích, aby vyzkoušel navrhované řešení v akci.
Zkoušíme v praxi
Požadavky
Požadavky jsou velmi jednoduché:
- Kubernetes cluster (vhodný je i minikube);
- RabbitMQ cluster (může být nasazen na bare metal, nebo vytvořen jako běžný cluster v Kubernetes pomocí oficiálního Helm chartu).
Pro níže popsaný příklad jsem nasadil RMQ v Kubernetes a pojmenoval ho rmq-old.
Příprava prostředí
1. Stáhneme Helm chart a trochu jej upravíme:
helm fetch --untar stable/rabbitmq-ha Pro pohodlí nastavíme heslo, ErlangCookie a nastavíme politiku ha-all, aby se fronty ve výchozím nastavení synchronizovaly mezi všemi uzly RMQ clusteru:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Instalujeme chart:
helm install . --name rmq-old --namespace rmq-old3. Přihlásíme se do admin rozhraní RabbitMQ, vytvoříme novou frontu a přidáme několik zpráv. Ty budou potřebné k tomu, abychom po migraci mohli potvrdit, že všechna data byla zachována a nic jsme neztratili:

Testovací prostředí je připraveno: máme "starý" RabbitMQ s daty, které je třeba přenést.
Migrace RabbitMQ clusteru
1. Nejprve nasadíme nový RabbitMQ v přítelem namespace se stejnými ErlangCookie a heslem pro uživatele. K tomu provedeme výše popsané operace, přičemž změníme koncovou příkazovou instalaci RMQ na následující:
helm install . --name rmq-new --namespace rmq-new2. Nyní je třeba spojit nový cluster se starým. K tomu se přihlásíme do každého z podů nového RabbitMQ a provedeme příkazy:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
V proměnné OLD_RMQ se nachází adresa jednoho z uzlů starého clusteru RMQ.
Tyto příkazy zastaví aktuální uzel nového clusteru RMQ, připojí ho ke starému clusteru a znovu ho spustí.
3. RMQ cluster se 6 uzly je připraven:
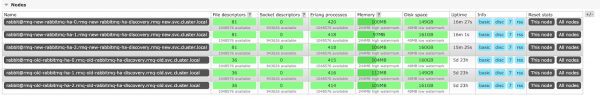
Je třeba počkat, až se zprávy synchronizují mezi všemi uzly. Není těžké uhodnout, že čas synchronizace zpráv závisí na výkonu hardware, na kterém je cluster nasazen, a na počtu zpráv. V popisovaném scénáři je jich pouze 10, a proto se data synchronizovala okamžitě, ale při dostatečně velkém množství zpráv může synchronizace trvat hodiny.
Takže, stav synchronizace:

Zde +5 znamená, že zprávy jsou již ještě na 5 uzlech (kromě toho, který je uveden v poli Node). Tím pádem byla synchronizace úspěšná.
4. Zůstává jen přepnout v aplikaci adresu RMQ na nový cluster (konkrétní kroky závisí na technologickém stacku, který používáte, a jiné specifice aplikace), poté se můžete rozloučit se starým.
Pro poslední operaci (tj. již po přepnutí aplikace na nový cluster) se přihlásíme na každý uzel starého clusteru a provedeme příkazy:
rabbitmqctl stop_app
rabbitmqctl reset
Cluster «zapomněl» na staré uzly: starý RMQ lze odstranit, čímž bude migrace dokončena.
Poznámka: Pokud používáte RMQ s certifikáty, principálně se nic nemění — proces migrace proběhne přesně stejným způsobem.
Závěry
Popisovaná schéma se hodí prakticky pro všechny případy, kdy potřebujeme přenést RabbitMQ nebo se jednoduše přestěhovat do nového clusteru.
V našem případě se komplikace objevily pouze jednou, když se k RMQ přistupovalo z mnoha míst, a my neměli možnost všude změnit adresu RMQ na novou. V takovém případě jsme spustili nový RMQ ve stejném jmenném prostoru se stejnými štítky, aby se dostal pod již existující služby a Ingressy, a při spuštění podu jsme ručně manipulovali se štítky, jejichž odstraněním na začátku jsme zajistili, aby prázdný RMQ nereagoval na dotazy, a po synchronizaci zpráv jsme je znovu přidali.
Stejnou strategii jsme použili při aktualizaci RabbitMQ na novou verzi se změněnou konfigurací — všechno fungovalo jako hodinky.
P.S.
Jako logické pokračování tohoto materiálu připravujeme články o MongoDB (migrace z fyzického serveru do Kubernetes) a MySQL (jak tuto DB připravujeme uvnitř Kubernetes). Ty budou publikovány v následujících měsících.
P.P.S.
Přečtěte si také náš blog:
- «»;
- «».
Zdroj: habr.com
