

Prelude
Tento článek se zabývá binárními vyhledávacími stromy. Nedávno jsem psal článek o Tam jsem se příliš nezaměřoval na binární stromy, protože metody vyhledávání, vkládání a mazání nebyly relevantní. Nyní jsem se rozhodl napsat článek právě o stromech. Myslím, že začneme.
Strom je datová struktura složená z uzlů spojených hranami. Můžeme říci, že strom je zvláštním případem grafu. Zde je příklad stromu:
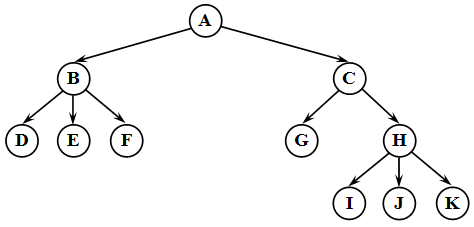
To není binární vyhledávací strom! Všechno níže!
Terminologie
Kořen
Kořen stromu je nejvyšší uzel. V příkladu to je uzel A. Ze stromu může k jakémukoli jinému uzlu vést pouze jedna cesta! Ve skutečnosti může být jakýkoli uzel považován za kořen odpovídajícího podstromu.
Rodiče/potomci
Všechny uzly kromě kořenového mají přesně jednu hranu vedoucí nahoru k jinému uzlu. Uzel umístěný nad aktuálním se nazývá rodičem tohoto uzlu. Uzel umístěný pod aktuálním uzlem a spojený s ním se nazývá potomkem tohoto uzlu. Pojďme tomu dát příklad. Vezměme uzel B, jeho rodičem bude uzel A a potomky budou uzly D, E a F.
List
Uzel, který nemá žádné potomky, se nazývá list stromu. V příkladu budou listy uzly D, E, F, G, I, J, K.
To je základní terminologie. Další pojmy budou rozebrány dále. Takže binární strom je strom, ve kterém má každý uzel maximálně dva potomky. Jak jste asi uhodli, strom z příkladu nebude binární, protože uzly B a H mají více než dva potomky. Zde je příklad binárního stromu:
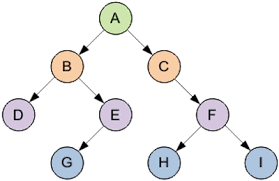
Uzlech stromu může být jakákoli informace. Binární vyhledávací strom je binární strom, který má následující vlastnosti:
- Obě podstromy – levý a pravý – jsou binárními vyhledávacími stromy.
- U všech uzlů levého podstromu libovolného uzlu X jsou hodnoty klíčů dat menší než hodnota klíče dat samotného uzlu X.
- U všech uzlů pravého podstromu libovolného uzlu X jsou hodnoty klíčů dat větší nebo rovny hodnotě klíče dat samotného uzlu X.
Klíč – jakákoli charakteristika uzlu (například číslo). Klíč je potřebný, aby bylo možné najít prvek stromu, který odpovídá tomuto klíči. Příklad binárního vyhledávacího stromu:
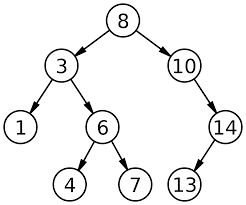
Zobrazení stromu
Během postupu budu uvádět některé (možná neúplné) úryvky kódu, abych zlepšil vaše porozumění. Kompletní kód bude na konci článku.
Strom se skládá z uzlů. Struktura uzlu:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...další metody uzlu
}
Každý uzel má dva potomky (pravděpodobně, potomci leftChild a/nebo rightChild mohou mít hodnotu null). Asi jste pochopili, že v tomto případě data — data uložená v uzlu; key — klíč uzlu.
S uzlem jsme se seznámili, teď si promluvme o aktuálních problémech stromů. Zde a dále pod pojmem "strom" budu mít na mysli koncept binárního vyhledávacího stromu. Struktura binárního stromu:
public class BinaryTree<T> {
     private Node<T> root;

    //metody stromu
}
Jako pole třídy potřebujeme pouze kořen stromu, protože od kořene pomocí metod getLeftChild() a getRightChild() se můžeme dostat k libovolnému uzlu stromu.
Algoritmy ve stromě
Hledání
Představte si, že máte postavený strom. Jak nalézt prvek s klíčem key? Je třeba postupně jít od kořene dolů po stromě a porovnávat hodnotu key s klíčem aktuálního uzlu: pokud je key menší než klíč aktuálního uzlu, přejděte na levého potomka uzlu, pokud větší — na pravého, pokud jsou klíče stejné — hledaný uzel byl nalezen! Odpovídající kód:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Pokud current se stane rovno null, znamená to, že prohledávání dosáhlo konce stromu (na konceptuální úrovni se nacházíte na neexistujícím místě stromu — potomku listu).
Zvažme účinnost algoritmu hledání na vyváženém stromu (stromu, ve kterém jsou uzly rozloženy více či méně rovnoměrně). V tomto případě bude účinnost hledání O(log(n)), přičemž logaritmus je se základem 2. Podívejte se: pokud je v vyváženém stromě n prvků, znamená to, že bude log(n) se základem 2 úrovní stromu. A při hledání, během jednoho kroku cyklu, sestupujete o jednu úroveň.
Vložení
Pokud jste pochopili podstatu hledání, nebude pro vás obtížné pochopit vložení. Stačí jen sestoupit na úroveň stromu (podle pravidel uvedených v hledání) a stát se jeho potomkem — levým nebo pravým, v závislosti na klíči. Implementace:
   public void insert(T insertData, int key) {
        Node current = root;
        Node parent;
        Node newNode = new Node(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
V tomto případě je nutné kromě aktuálního uzlu uchovávat také informace o jeho rodiči. Když current bude rovno null, v proměnné parent bude potřebný list.
Efektivita vkládání bude zjevně stejná jako při hledání — O(log(n)).
Odstranit
Odstranění je nejtěžší operace, kterou je potřeba provést se stromem. Je jasné, že nejprve bude nutné najít prvek, který se chystáme odstranit. Ale co potom? Pokud pouze přiřadíme jeho odkazu hodnotu null, ztratíme informace o podstromu, jehož kořenem je tento uzel. Metody odstranění stromu dělíme na tři případy.
První případ. Odstraňovaný uzel nemá potomky.
Pokud odstraňovaný uzel nemá potomky, znamená to, že je listem. Proto můžeme jednoduše přiřadit polím leftChild nebo rightChild jeho rodiče hodnotu null.
Druhý případ. Odstraňovaný uzel má jednoho potomka.
Tento případ také není příliš složitý. Vraťme se k našemu příkladu. Předpokládejme, že musíme odstranit prvek s klíčem 14. Souhlasíte, že protože je — pravým potomkem uzlu s klíčem 10, jakýkoli jeho potomek (v tomto případě pravý) bude mít klíč větší než 10, takže ho lze snadno 'vyříznout' ze stromu, a rodiče propojit přímo s potomkem odstraňovaného uzlu, tj. uzel s klíčem 10 propojit s uzlem 13. Podobná situace by nastala, kdybychom museli odstranit uzel, který je levým potomkem svého rodiče. Zamyslete se nad tím sami — přesná analogie.
Třetí případ. Uzel má dva potomky.
Nejkomplexnější případ. Rozebere na novém příkladu.
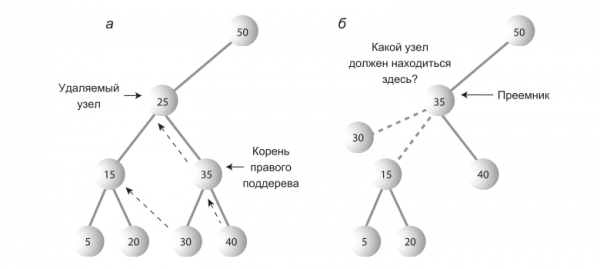
Hledání nástupce.
Představme si, že je potřeba odstranit uzel s klíčem 25. Kdo ho nahradí? Někdo z jeho následovníků (potomků nebo potomků potomků) by měl být nástupcem(ten, kdo obsadí místo odstraněného uzlu).
Jak pochopit, kdo by měl být nástupcem? Intuitivně je jasné, že jde o uzel v stromě, jehož klíč je největší, ale stále menší než klíč odstranitelných uzlů. Algoritmus spočívá v následujícím. Musíme přejít k jeho pravému potomkovi (vždy k pravému, protože, jak již bylo zmíněno, klíč nástupce je větší než klíč odstraňovaného uzlu) a poté projít řetězec levých potomků tohoto pravého potomka. V příkladu přejdeme k uzlu s klíčem 35 a poté se procházíme dolů po řetězci jeho levých potomků – v tomto případě se tento řetězec skládá pouze z uzlu s klíčem 30. Přísně vzato, hledáme nejmenší uzel v sadě uzlů, které jsou větší než hledaný uzel.
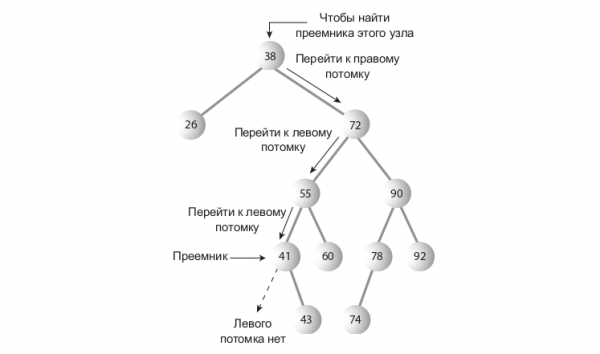
Kód metody pro hledání nástupce:
    public Node getSuccessor(Node deleteNode) {
        Node parentSuccessor = deleteNode; // rodič nástupce
        Node successor = deleteNode; // nástupce
        Node current = successor.getRightChild(); // prostě "procházející" uzel
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // při výstupu z cyklu máme nástupce a rodiče nástupce
        if (successor != deleteNode.getRightChild()) { // pokud nástupce nesouhlasí s pravým potomkem odstraněného uzlu
            parentSuccessor.setLeftChild(successor.getRightChild()); // pak si jeho rodič vezme potomka nástupce, aby ho neztratil
            successor.setRightChild(deleteNode.getRightChild()); // propojujeme nástupce s pravým potomkem odstraněného uzlu
        }
        return successor;
    }
Celý kód metody delete:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false;  // V závislosti na tom, zda je odstraňovaný uzel levým nebo pravým potomkem svého rodiče, bude boolean proměnná isLeftChild nabývat hodnoty true nebo false.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {  // první případ
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {  // druhý případ
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {  // třetí případ
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
Složitost může být aproximována k O(log(n)).
Hledání maxima/minima v stromu
Je zřejmé, jak najít minimální/maximální hodnotu ve stromu — je třeba se postupně přesouvat po řetězci levých/právních prvků stromu; když se dostanete k listu, ten bude minimálním/maximálním prvkem.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
Složitost — O(log(n))
Symetrický průchod
Průchod — návštěva každého uzlu stromu s cílem provést s ním nějakou akci.
Algoritmus rekurzivního symetrického průchodu:
- Proveďte akci s levým potomkem
- Proveďte akci se sebou
- Proveďte akci s pravým potomkem
Kód:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " "); // Zde může být cokoliv
            inOrder(current.getRightChild());
        }
    }
Závěr
Konečně! Pokud jsem něco nedořekl nebo máte nějaké připomínky, budu čekat na komentáře. Jak jsem slíbil, uvádím celý kód.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Degenerace do O(n)
Mnozí z vás si možná všimli: co když uděláme, aby se strom stal nevyváženým? Například, pokud do stromu vložíme uzly s rostoucími klíči: 1,2,3,4,5,6… To by byl strom s něčím připomínající spojový seznam. A ano, strom ztratí svou stromovou strukturu, a tedy i efektivitu přístupu k datům. Složitost operací vyhledávání, vkládání, odstraňování se stanou podobnými jako u spojového seznamu: O(n). A to je jeden z nejdůležitějších nedostatků binárních stromů, podle mého názoru.
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Nedávno jsem na Habru a chtěl bych vědět, o jakých tématech byste chtěli vidět více článků?
Datové struktury
Algoritmy (DP, rekurze, komprese dat atd.)
Aplikace datových struktur a algoritmů v reálném životě
Programování android aplikací v Javě
Programování webových aplikací v Javě
Hlasovalo 2 uživatelů. Zdržel se 1 uživatel.
Zdroj: habr.com
