

Ahoj všem! Jmenuji se Dmitrij Samsonov, pracuji jako vedoucí systémový administrátor v „Odnoklassnikách“. Máme více než 7 tisíc fyzických serverů, 11 tisíc kontejnerů v našem cloudu a 200 aplikací, které v různých konfiguracích tvoří 700 různých clusterů. Drtivá většina serverů běží na CentOS 7.
Dne 14. srpna 2018 byla zveřejněna informace o zranitelnosti FragmentSmack
() a SegmentSmack (). Jsou to zranitelnosti se síťovým vektorem útoku a dost vysokým hodnocením (7.5), které hrozí nedostupností (DoS) kvůli vyčerpání zdrojů (CPU). Oprava v jádře pro FragmentSmack v té době navržena nebyla, kromě toho byla vydána výrazně později po zveřejnění informace o zranitelnosti. Pro odstranění SegmentSmack bylo doporučeno aktualizovat jádro. Samotný balíček s aktualizací byl vydán ve stejný den, stačilo jej pouze nainstalovat.
Ne, rozhodně nejsme proti aktualizaci jádra! Jenže jsou tu nuance...
Jak aktualizujeme jádro na produkci
Obecně vzato, nic složitého:
- Stáhnout balíčky;
- Nainstalovat je na určité množství serverů (včetně serverů, které hostují náš cloud);
- Ujistit se, že se nic nerozbilo;
- Ověřit, že všechna standardní nastavení jádra byla aplikována bez chyb;
- Počkat několik dní;
- Zkontrolovat ukazatele serverů;
- Přepnout nasazení nových serverů na nové jádro;
- Aktualizovat všechny servery podle datových center (jedno datové centrum najednou, aby se minimalizoval dopad pro uživatele v případě problémů);
- Restartovat všechny servery.
Opakovat pro všechny větve našich jader. V současné době jsou to:
- Základní CentOS 7 3.10 — pro většinu běžných serverů;
- Vanilkové 4.19 — pro náš , protože potřebujeme BFQ, BBR a tak dále;
- Elrepo kernel-ml 5.2 — pro , protože 4.19 se dříve choval nestabilně a potřebné funkce jsou stejné.
Jak jste mohli hádat, nejvíce času zabere restartování tisíců serverů. Jelikož ne všechny zranitelnosti jsou kritické pro všechny servery, restartujeme pouze ty, které jsou přímo dostupné z internetu. V cloudu, abychom neomezovali flexibilitu, nepřidělujeme externě dostupné kontejnery ke konkrétním serverům s novým jádrem, ale restartujeme všechny hostitele bez výjimky. Naštěstí je tam procedura jednodušší než u běžných serverů. Například stateless kontejnery se mohou během restartu jednoduše přestěhovat na jiný server.
Nicméně práce je stále hodně a může trvat několik týdnů, a při vzniku problémů s novou verzí až několik měsíců. Útočníci to velmi dobře chápou, a proto je potřeba mít plán "B".
FragmentSmack/SegmentSmack. Oběh oken
Naštěstí pro některé zranitelnosti existuje plán "B", který se nazývá Oběh oken. Nejčastěji jde o změnu nastavení jádra/aplikací, které umožňují minimalizovat možný dopad nebo zcela vyloučit zneužití zranitelností.
V případě FragmentSmack/SegmentSmack následující Oběh oken:
«Lze změnit výchozí hodnoty 4MB a 3MB v net.ipv4.ipfrag_high_thresh a net.ipv4.ipfrag_low_thresh (a jejich ekvivalenty pro ipv6 net.ipv6.ipfrag_high_thresh a net.ipv6.ipfrag_low_thresh) na 256 kB a 192 kB nebo nižší. Testy ukazují na malý až značný pokles využití CPU během útoku v závislosti na hardwaru, nastavení a podmínkách. Může však být nějaký vliv na výkon kvůli ipfrag_high_thresh=262144 bytes, protože pouze dva 64K fragmenty se mohou současně vejít do fronty na přestavbu. Například hrozí riziko, že aplikace pracující s velkými UDP pakety mohou selhat.».
Samotné parametry jsou popsány takto:
ipfrag_high_thresh - DLOUHÉ ČÍSLO
     Maximální paměť použitá pro sestavení IP fragmentů.
ipfrag_low_thresh - DLOUHÉ ČÍSLO
     Maximální paměť použitá k opětovnému složení fragmentů IP před tím, než jádro
     začne odstraňovat neúplné fronty fragmentů pro uvolnění zdrojů.
     Jádro stále přijímá nové fragmenty pro defragmentaci.
Na produkčních službách nemáme velké UDP. V LAN je fragmentovaný provoz nepřítomný, ve WAN je, ale ne výrazný. Nic nenaznačuje — můžeme aplikovat Oběh oken!
FragmentSmack/SegmentSmack. První krev
První problém, kterému jsme čelili, spočíval v tom, že cloudové kontejnery občas aplikovaly nové nastavení pouze částečně (pouze ipfrag_low_thresh) a někdy je vůbec neaplikovaly — jednoduše padaly při startu. Stabilně reprodukovat problém se nedařilo (ručně se všechna nastavení aplikovala bez jakýchkoli obtíží). Pochopit, proč kontejner padá při startu, také není tak jednoduché: žádné chyby nebyly nalezeny. Jisté bylo pouze jedno: návrat k předchozímu nastavení řešil problém s pády kontejnerů.
Proč nestačí aplikovat Sysctl na hostiteli? Kontejner žije ve svém vyhrazeném síťovém Namespace, takže alespoň v kontejneru se může lišit od hostitele.
Jak přesně se aplikují nastavení Sysctl v kontejneru? Jelikož kontejnery jsou u nás neprivilegované, změnit jakékoli nastavení Sysctl vstupem do samotného kontejneru není možné — prostě na to nejsou dostatečné pravomoci. Pro spuštění kontejnerů naše cloudové řešení v té době používalo Docker (nyní již ). Parametry nového kontejneru, včetně potřebných nastavení Sysctl, byly předávány do Dockeru prostřednictvím API.
Při zkoumání verzí se ukázalo, že API Dockeru nevracelo všechny chyby (alespoň ve verzi 1.10). Při pokusu o spuštění kontejneru prostřednictvím “docker run” jsme konečně něco viděli:
write /proc/sys/net/ipv4/ipfrag_high_thresh: invalid argument docker: Error response from daemon: Cannot start container : [9] System error: could not synchronise with container process.
Hodnota parametru není platná. Ale proč? A proč není platná pouze někdy? Ukázalo se, že Docker nezaručuje pořadí aplikace parametrů Sysctl (poslední ověřená verze — 1.13.1), proto se někdy ipfrag_high_thresh pokoušel nastavit na 256K, když ipfrag_low_thresh byl ještě 3M, což znamenalo, že horní mez byla nižší než dolní, což vedlo k chybě.
V té době jsme již používali vlastní mechanismus dokonfigurování kontejneru po spuštění (zmražení kontejneru prostřednictvím a provádění příkazů v namespace kontejneru prostřednictvím ), a do této části jsme přidali také zapisování nastavení Sysctl. Problém byl vyřešen.
FragmentSmack/SegmentSmack. První krev 2
Jakmile jsme se pustili do aplikace Workaround v cloudu, začaly se objevovat první vzácné stížnosti od uživatelů. Od zahájení aplikace Workaround na prvních serverech uplynulo několik týdnů. První vyšetřování ukázalo, že stížnosti byly zaměřeny na jednotlivé služby, a ne na všechny servery těchto služeb. Problém opět nabyl velmi nejasného charakteru.
V první řadě jsme samozřejmě zkusili vrátit nastavení Sysctl, ale to nemělo žádný efekt. Různé manipulace s nastaveními serveru a aplikace také nepomohly. Pomohl reboot. Reboot pro Linux je stejně proti přírodě, jak byl normálním požadavkem pro práci s Windows v minulosti. Nicméně to pomohlo, a vše jsme připsali na "chybu v jádře" při aplikaci nových nastavení v Sysctl. Jak naivní to bylo…
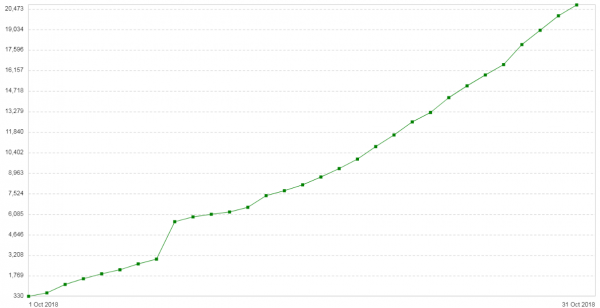
Po třech týdnech se problém opakoval. Konfigurace těchto serverů byla poměrně jednoduchá: Nginx v režimu proxy/zátěžového vyvážení. Provoz byl malý. Nový poznatek: u klientů každým dnem přibývalo 504 chyb (). Na grafu je znázorněn počet 504 chyb za den pro tuto službu:
Všechny chyby se týkaly jednoho a téhož backendu — toho, který se nachází v cloudu. Graf spotřeby paměti pro fragmenty paketů na tomto backendu vypadal následovně:
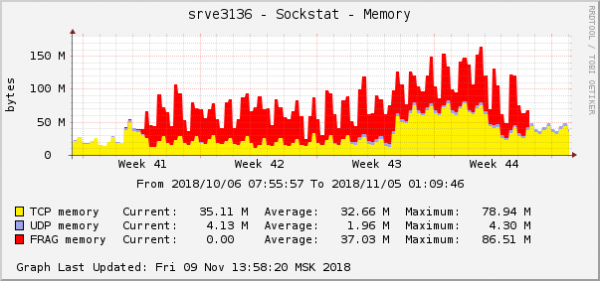
To je jeden z nejvýraznějších projevů problému na grafech operačního systému. V cloudu byla právě v tu dobu opravena jiná síťová chyba s nastavením QoS (Traffic Control). Na grafu spotřeby paměti pro fragmenty paketů vypadala přesně takto:
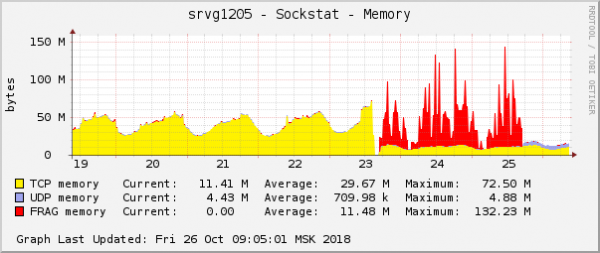
Domněnka byla jednoduchá: pokud grafy vypadají stejně, pak mají stejnou příčinu. Tím spíše, že problémy s tímto typem paměti se vyskytují extrémně zřídka.
Podstata opraveného problému spočívala v tom, že jsme používali v QoS paketový plánovač fq s výchozími nastaveními. Ve výchozím nastavení umožňuje pro jedno spojení přidávat do fronty 100 paketů a některá spojení v situaci nedostatku pásma začala frontu zaplňovat do maxima. V takovém případě jsou pakety zahazovány. V statistice tc (tc -s qdisc) je to vidět takto:
qdisc fq 2c6c: parent 1:2c6c limit 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Odesláno 454701676345 bajtů 491683359 pkt (zahazeno 464545, překročení 0, opakování 0)
  backlog 0b 0p opakování 0
   1024 toků (1021 neaktivních, 0 zpomalených)
   0 gc, 0 vysoká priorita, 0 zpomalených, 464545 flows_plimit
«464545 flows_plimit» označuje balíčky, které byly ztraceny kvůli překročení limitu fronty jediného připojení, zatímco „dropped 464545“ je součet všech ztracených balíčků tohoto plánovače. Po zvýšení délky fronty na 1 000 a restartování kontejnerů problém přestal být patrný. Můžete si pohodlně sednout do křesla a vychutnat si smoothie.
FragmentSmack/SegmentSmack. Poslední krev
Za prvé, po několika měsících od oznámení zranitelností v jádře konečně vyšel patch pro FragmentSmack (připomínám, že s oznámením v srpnu vyšel patch pouze pro SegmentSmack), což nám umožnilo vzdát se workaroundu, který nám přinesl mnoho nepříjemností. Některé servery jsme již stihli přenést na nové jádro a nyní bylo potřeba začít znovu. Proč jsme aktualizovali jádro, aniž bychom čekali na patch pro FragmentSmack? Skutečností je, že proces ochrany před těmito zranitelnostmi se kryl (a slil) s procesem aktualizace samotného CentOS (což zabere ještě více času než aktualizace pouze jádra). Kromě toho je SegmentSmack mnohem nebezpečnější zranitelnost a patch pro něj se objevil hned, takže to mělo smysl v každém případě. Nicméně, jen tak aktualizovat jádro na CentOS jsme nemohli, protože zranitelnost FragmentSmack, která se objevila v době CentOS 7.5, byla opravena až ve verzi 7.6, a tak jsme museli zastavit aktualizaci na 7.5 a začít znovu s aktualizací na 7.6. Takové věci se také stávají.
Za druhé, vrátily se k nám vzácné stížnosti uživatelů na problémy. Nyní už víme, že všechny se vztahují k nahrávání souborů od klientů na některé naše servery. A přitom přes tyto servery probíhalo velmi malé množství nahrání z celkového objemu.
Jak si pamatujeme z předchozího příběhu, rollback Sysctl nepomohl. Pomohl restart, ale jen dočasně.
Podezření na Sysctl zůstala, ale tentokrát bylo potřeba shromáždit co nejvíce informací. Také výrazně chyběla možnost reprodukovat problém s nahráváním na klientovi, abychom přesněji zjistili, co se děje.
Analýza všech dostupných statistik a logů nám nepomohla pochopit, co se děje. Odrážela se nedostatečná možnost reprodukovat problém a „osahat“ konkrétní spojení. Nakonec se vývojářům v speciální verzi aplikace podařilo stabilně reprodukovat problémy na testovacím zařízení při připojení přes Wi-Fi. To bylo průlomem ve vyšetřování. Klient se připojil k Nginx, který propojoval na backend, což byla naše aplikace na Java.
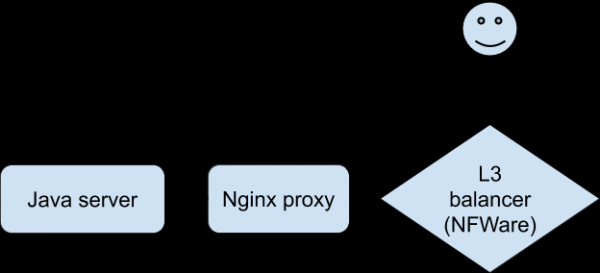
Dialog při problémech byl následující (zaznamenáno na straně Nginx-proxy):
- Klient: požadavek na získání informací o dohašení souboru.
- Java-server: odpověď.
- Klient: POST se souborem.
- Java-server: chyba.
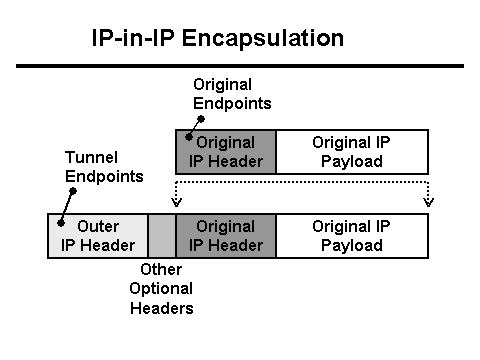
Java-server přitom píše do logu, že od klienta obdržel 0 bajtů dat, a Nginx-proxy, že požadavek trval více než 30 sekund (30 sekund je doba timeoutu u klientské aplikace). Proč tedy timeout a proč 0 bajtů? Z pohledu HTTP vše funguje, jak má, ale POST se souborem jakoby zmizí ze sítě. Zmizí mezi klientem a Nginx. Je čas se zabavit Tcpdumpem! Ale nejprve je třeba pochopit konfiguraci sítě. Nginx-proxy je za L3-load balancerem. . Používá se tunelování k doručení paketů od L3-load balanceru k serveru, které přidává své hlavičky do paketů:
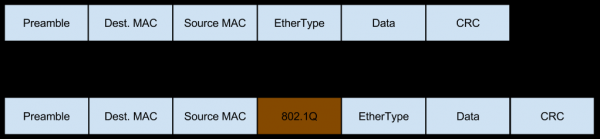
Přitom síť na tento server přichází ve formě Vlan-tagovaného provozu, který také přidává svá pole do paketů:
A tento provoz může být také fragmentován (ten malý procentuální podíl příchozího fragmentovaného provozu, o kterém jsme hovořili při hodnocení rizik z Workaround), což také mění obsah hlaviček:
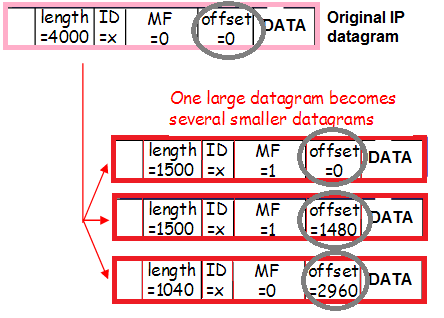
Ještě jednou: pakety jsou enkapsulovány Vlan-tagem, enkapsulovány tunelem, fragmentovány. Abychom lépe pochopili, jak se to děje, sledujme trasu paketu od klienta k Nginx-proxy.
- Packet se dostává na L3-load balancer. Pro správné směrování uvnitř datového centra je paket enkapsulován do tunelu a odeslán na síťovou kartu.
- Protože paket + hlavičky tunelu se nevejdou do MTU, paket se rozděluje na fragmenty a odesílá se do sítě.
- Switch po L3-load balanceru při obdržení paketu přidává k němu Vlan-tag a posílá dál.
- Switch před Nginx proxy vidí (podle nastavení portu), že server očekává Vlan-inkapslovaný paket, a proto ho posílá tak, jak je, aniž by odstranil Vlan-tag.
- Linux přijímá fragmenty jednotlivých paketů a spojuje je do jednoho velkého paketu.
- Paket se dále dostává na Vlan rozhraní, kde se odstraní první vrstva — Vlan-inkapslování.
- Poté Linux posílá paket na Tunnel rozhraní, kde se odstraní další vrstva — Tunnel-inkapslování.
Složitost spočívá v tom, že to všechno předáme jako parametry do tcpdump.
Začněme od konce: existují čisté (bez zbytečných hlaviček) IP pakety od klientů, se staženým vlan a tunnel inkapslováním?
tcpdump host
Ne, takové pakety na serveru nebyly. Tím pádem by problém měl být dříve. Existují pakety pouze se staženým Vlan-inkapslováním?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx — to je IP adresa klienta v hex formátu.
32:4 — adresa a délka pole, ve kterém je zapsán SCR IP v Tunnel paketu.
Adresa pole musela být hledána pokusem a omylem, protože na internetu píší o 40, 44, 50, 54, ale tam IP adresa nebyla. Také je možné se podívat na jeden z paketů v hex (parametr -xx nebo -XX v tcpdump) a spočítat, podle které adresy je vám známá IP.
Existují fragmenty paketů bez staženého Vlan a Tunnel-inkapslování?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Tato magie nám ukáže všechny fragmenty, včetně posledního. Pravděpodobně lze také filtrovat podle IP, ale nezkoušel jsem to, protože takových paketů není příliš mnoho, a ve všeobecném toku se snadno našly ty, které jsem potřeboval. Tady jsou:
14:02:58.471063 V 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), délka 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), délka 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 bajtů chybí! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), délka 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], délka 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), délka 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), délka 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
To jsou dva fragmenty jednoho paketu (stejný ID 53652) s fotografií (je vidět slovo Exif v prvním paketu). Z důvodu toho, že na této úrovni pakety existují, ale ve spojeném stavu v dumpu — ne, je jasné, že problém je evidentně se skládáním. Konečně existuje dokumentární potvrzení tohoto!
Dekodér paketů neodhalil žádné problémy, které by bránily skládání. Zkoušel jsem to zde: . Nejdříve, při pokusu o nasazení něčeho, decodér neuznával formát paketu. Ukázalo se, že tam byly nějaké nadbytečné dva octety mezi Srcmac a Ethertype (které se netýkaly informací o fragmentech). Po jejich odstranění decodér začal fungovat. Nicméně žádné problémy nehlásil.
Ať se dělo, co se dělo, kromě oněch Sysctl se nic jiného nenašlo. Bylo třeba najít způsob, jak zjistit problémové servery, abychom pochopili rozsah a mohli učinit rozhodnutí o dalších krocích. Docela rychle jsem našel potřebný čítač:
netstat -s | grep "packet reassembles failed”
Ten samý existuje v snmpd pod OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
„Počet selhání detekovaných algoritmem IP pro sestavení (z jakéhokoliv důvodu: časový limit, chyby atd.)“.
V rámci skupiny serverů, na kterých bylo zkoumáno problémy, na dvou tento čítač rostl rychleji, na dvou pomaleji a na dvou vůbec nerostl. Porovnání dynamiky tohoto čítače s dynamikou HTTP chyb na Java serveru odhalilo korelaci. To znamená, že bylo možné čítač vložit na monitorování.
Mít spolehlivý indikátor problémů je velmi důležité, aby bylo možné přesně určit, zda rollback Sysctl pomáhá, protože, jak víme z předchozího vyprávění, to není možné okamžitě poznat na aplikaci. Tento indikátor by umožnil identifikovat všechna problémová místa v produkci dříve, než je zaznamenají uživatelé.
Po rollbacku Sysctl chyby v monitorování přestaly, tím pádem byla příčina problémů prokázána, stejně jako to, že rollback pomáhá.
Rollbackli jsme nastavení fragmentace na ostatních serverech, kde se rozsvítila nová monitorovací sekce, a někde dokonce pod fragmenty vyhradili více paměti, než bylo dříve ve výchozím nastavení (to byla udp statistika, jejíž částečná ztráta nebyla na celkovém pozadí vidět).
Nejdůležitější otázky
Proč se nám na L3 vyvážecích zařízeních fragmentují pakety? Většina paketů, které přicházejí od uživatelů na vyvážiče, jsou SYN a ACK. Velikosti těchto paketů jsou malé. Ale protože podíl takových paketů je velmi vysoký, na jejich pozadí jsme si nevšimli přítomnosti větších paketů, které se začaly fragmentovat.
Příčinou byl rozbitý konfigurační skript na serverech s VLAN rozhraními (v době, kdy bylo velmi málo serverů s označeným provozem v produkci). Advmss umožňuje přenést k zákazníkovi informaci, že pakety směrem k nám by měly být menší, aby po připojení k nim hlaviček tunelu nedošlo k fragmentaci.
Proč rollback Sysctl nepomohl, zatímco restart pomohl? Rollback Sysctl měnil objem paměti dostupné pro spojování paketů. Přitom, soudě podle všeho, sám fakt přetečení paměti pro fragmenty způsobil zpomalení spojení, což vedlo k tomu, že fragmenty na dlouho uvízly v čekárně. To znamenalo, že se proces dostal do smyčky.
Restart vymazal paměť a všechno se dostalo do pořádku.
Šlo by obejít se bez workaroundu? Ano, ale hrozilo by nebezpečí, že bychom uživatele nechali bez obsluhy v případě útoku. Samozřejmě, že použití workaroundu nakonec vedlo k různým problémům, včetně zpomalení jednoho ze služeb pro uživatele, ale přesto považujeme, že akce byla odůvodněná.
Velké díky Andreji Timofejevovi () za pomoc při vyšetřování, a také Alexi Kreněvovi () — za titánskou práci na aktualizaci CentOS a jader na serverech. Proces, který bylo nutné několikrát začínat od začátku, což vedlo k tomu, že se protáhl na mnoho měsíců.
Zdroj: habr.com
