

Berkeley Packet Filters (BPF) — je technologie jádra Linux, která se už několik let pravidelně objevuje na předních stránkách anglicky psaných technických publikací. Konference jsou zaplněny prezentacemi o používání a vývoji BPF. David Miller, udržovatel síťového subsystému Linux, nazval svou přednášku na Linux Plumbers 2018 (XDP – to je jedna z možností použití BPF). Brendan Gregg přednáší o . Toke Høiland-Jørgensen , že jádro je nyní microkernel. Thomas Graf propaguje myšlenku, že .
Na Habré stále neexistuje systematický popis BPF, a proto se v sérii článků pokusím vyprávět o historii technologie, popsat architekturu a vývojové nástroje, vymezit oblasti použití a praktiky spojené s BPF. V tomto úvodním článku cyklu se vypráví příběh a architektura klasického BPF, a odhalují se tajemství principů fungování tcpdump, seccomp, strace, a mnoho dalšího.
Vývoj BPF je řízen síťovou komunitou Linuxu, hlavní existující použití BPF je spojeno se sítěmi, a tak, se svolením , jsem nazval sérii "BPF pro nejmenší", na počest velké série .
Krátký kurz historie BPF (s)
Moderní technologie BPF — to je vylepšená a doplněná verze staré technologie se stejným názvem, která je nyní, aby se předešlo záměně, nazývána classic BPF. Na základě klasického BPF byly vytvořeny známé nástroje tcpdump, mechanismus seccomp, a také méně známé moduly xt_bpf pro iptables a klasifikátor cls_bpf. V moderním Linuxu jsou klasické programy BPF automaticky překládány do nové formy, avšak z pohledu uživatele API zůstalo na svém místě a nová použití klasického BPF, jak uvidíme v tomto článku, stále přetrvávají. Z tohoto důvodu, stejně jako proto, že sledování historie vývoje klasického BPF v Linuxu objasní, jak a proč se tato technologie vyvinula do moderní podoby, jsem se rozhodl začít právě článkem o klasickém BPF.
Na konci osmdesátých let minulého století se inženýři z proslulé Laboratoře Lawrence Berkeley zajímali o to, jak správně filtrovat síťové pakety na tehdejší moderní hardwarové platformě. Základní myšlenka filtrace, která byla původně implementována v technologii CSPF (CMU/Stanford Packet Filter), spočívala v tom, že je potřeba filtrovat nepotřebné pakety co nejdříve, tj. v jádře, protože to zabraňuje kopírování zbytečných dat do uživatelského prostoru. K zajištění bezpečnosti při spuštění uživatelského kódu v jádře byla použita virtuální stroj - sandbox.
Nicméně virtuální stroje pro stávající filtry byly navrženy pro provoz na strojích se zásobníkovou architekturou a na nových RISC strojích nefungovaly efektivně. Nakonec inženýři z Berkeley Labs vyvinuli novou technologii BPF (Berkeley Packet Filters), jejíž architektura virtuálního stroje byla navržena na základě procesoru Motorola 6502 - pracovního koně takových známých produktů jako nebo . Nový virtuální stroj zvyšoval výkon filtrů desítkykrát oproti stávajícím řešením.
Architektura stroje BPF
Seznámíme se s architekturou pracovní formou, prozkoumáme příklady. Nicméně pro začátek řekneme, že stroj měl dva dostupné 32bitové registry pro uživatele, akumulátor A a indexový registr X, 64 bajtů paměti (16 slov), dostupných pro zápis a následné čtení, a malý soubor instrukcí pro práci s těmito objekty. V programech byly dostupné i instrukce skoku pro realizaci podmínkových výrazů, nicméně pro zajištění včasného ukončení programu bylo povoleno přecházet pouze vpřed, což znamenalo, že vytváření smyček bylo zakázáno.
Obecná schéma spuštění stroje je následující. Uživatel vytvoří program pro architekturu BPF a pomocí nějakého mechanismu jádra (například systémového volání) načte a připojí program k nějakému generátoru událostí v jádře (například událostí je příchozí paket na síťovou kartu). Při vzniku události jádro spustí program (například v interpretu), přičemž paměť stroje odpovídá. nějakému regionu paměti jádra (například data přijatého paketu).
To, co jsme si dosud řekli, nám postačí, abychom začali zkoumat příklady: se systémem a formátem příkazů se seznámíme podle potřeby. Pokud však chcete okamžitě studovat systém příkazů virtuálního stroje a dozvědět se o všech jeho možnostech, můžete přečíst originální článek a/nebo první polovinu souboru dokumentace jádra. Kromě toho si můžete prostudovat prezentaci , ve které McCanne, jeden z autorů BPF, hovoří o historii jeho vzniku. libpcap.
My se však přesuneme k prozkoumání všech významných příkladů aplikace klasického BPF v Linuxu: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Vývoj BPF probíhal paralelně s vývojem frontendu pro filtrování paketů — známé utility tcpdump. A protože se jedná o nejstarší a nejznámější příklad použití klasického BPF, dostupný na mnoha operačních systémech, tímto začneme naše studium technologie.
(Všechny příklady v tomto článku jsem spouštěl na Linuxu 5.6.0-rc6. Výstupy některých příkazů byly upraveny pro větší čitelnost.)
Příklad: sledujeme IPv6 pakety
Představme si, že chceme sledovat všechny IPv6 pakety na rozhraní eth0. K tomu můžeme spustit program tcpdump s nejjednodušším filtrem ip6:
$ sudo tcpdump -i eth0 ip6Přitom tcpdump skompiluje filtr ip6 do bajtkódu architektury BPF a odešle ho do jádra (viz podrobnosti v sekci ). Načtený filtr bude prováděn pro každý paket, který prochází rozhraním eth0. Pokud filtr vrátí nenulovou hodnotu n, pak do n bajtů paketu bude zkopírováno do prostoru uživatele a uvidíme ho ve výstupu. tcpdump.
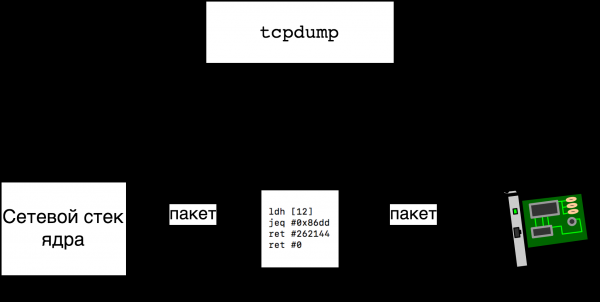
Ukazuje se, že můžeme snadno zjistit, jaký bajtkód byl odeslán do jádra tcpdump pomocí samotného tcpdump, pokud ho spustíme s volbou -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Na nultém řádku spouštíme příkaz ldh [12], který se rozkládá jako „načíst do registru A půl-slova (16 bitů), nacházející se na adrese 12“ a jediná otázka — jakou paměť adresujeme? Odpověď spočívá v tom, že na adrese x začíná (x+1)-ý bajt analyzovaného síťového paketu. Čteme pakety z Ethernetového rozhraní eth0, a to znamená , že paket vypadá následovně (pro zjednodušení předpokládáme, že paket neobsahuje VLAN tagy):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
To je tedy po provedení příkazu ldh [12] v registru A bude pole Ether Type — typ paketů přenášených v tomto Ethernetovém rámci. V řádku 1 porovnáváme obsah registru A (typ paketu) s 0x86dd, a to znamená typ IPv6, který nás zajímá. V řádku 1 kromě příkazu pro porovnání jsou ještě dva sloupce — jt 2 a jf 3 — štítky, na které je třeba přejít v případě úspěšného porovnání (A == 0x86dd) a neúspěšného. Takže v případě úspěchu (IPv6) přejdeme na řádek 2, a v případě neúspěchu — na řádek 3. Na řádku 3 program končí kódem 0 (nekopíruj paket), na řádku 2 program končí kódem 262144 (zkopíruj maximálně 256 kilobajtů paketu).
Složitější příklad: podívejme se na TCP pakety podle cílového portu.
Podívejme se, jak vypadá filtr, který kopíruje všechny TCP pakety s cílovým portem 666. Prozkoumáme případ IPv4, protože případ IPv6 je jednodušší. Po prostudování tohoto příkladu si můžete ve cvičení samostatně prostudovat filtr pro IPv6 (ip6 and tcp dst port 666) a filtr pro obecný případ (tcp dst port 666). Takže filtr, který nás zajímá, vypadá takto:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Co dělají řádky 0 a 1 už víme. Na řádku 2 jsme už ověřili, že se jedná o IPv4 paket (Ether Type = 0x800) a načítáme do registru A 24. bajt paketu. Náš paket vypadá jako
       14            8      1     1
|ethernet header|ip fields|ttl|protocol|...
a to znamená, že načítáme do registru A pole Protocol hlavičky IP, což dává smysl, protože chceme kopírovat pouze TCP pakety. Porovnáváme Protocol s 0x6 () na řádku 3.
Na řádcích 4 a 5 načítáme poloviny slova, které se nacházejí na adrese 20, a pomocí příkazu jset kontrolujeme, zda není nastaven jedna ze tří — v masce dané jset byly vymazány tři nejvyšší bity. Dva bity ze tří nám říkají, zda je paket součástí fragmentovaného IP paketu, a pokud ano, zda je posledním fragmentem. Třetí bit je vyhrazen a měl by být roven nule. Nechceme kontrolovat ani neúplné, ani poškozené pakety, proto kontrolujeme všechny tři bity.
Řádek 6 — nejzajímavější části tohoto výpisu. Výraz ldxb 4*([14]&0xf) označuje, že načítáme do registru X čtyři nejmenší bity patnáctého bajtu paketu, násobené čtyřmi. Čtyři nejmenší bity patnáctého bajtu představují pole IPv4, kde je uložena délka hlavičky ve slovech, takže je třeba ji potom vynásobit čtyřmi. Zajímavé je, že výraz 4*([14]&0xf) je označení speciální adresovací schémy, kterou lze použít pouze tímto způsobem a pouze pro registr X, tj. nemůžeme říci ani ldb 4*([14]&0xf) ani ldxb 5*([14]&0xf) (můžeme pouze uvést jiný offset, například ldxb 4*([16]&0xf)). Je jasné, že tato adresovací schéma byla do BPF přidána právě proto, aby se získala v X (indexový registr) délka hlavičky IPv4.
Takže na řádku 7 se snažíme načíst půl slova na adrese (X+16). Když si vzpomeneme, že 14 bajtů zabírá hlavička Ethernetu a X obsahuje délku hlavičky IPv4, pochopíme, že v A se načítá cílový port TCP:
       14           X           2             2
|hlavička ethernetu|hlavička ip|zdrojový port|cílový port|
Nakonec na řádku 8 porovnáváme cílový port se hledanou hodnotou a na řádcích 9 nebo 10 vracíme výsledek — zkopírovat paket nebo ne.
Tcpdump: načítání
V předchozích příkladech jsme se záměrně podrobně nezabývali tím, jak konkrétně nahráváme BPF bajtkód do jádra pro filtrování paketů. Obecně tcpdump byl portován na mnoho systémů a pro práci s filtry využívá knihovnu . Stručně řečeno, abychom nastavili filtr na rozhraní pomocí libpcap, musíme udělat následující:
- vytvořit deskriptor typu
pcap_tz názvu rozhraní: , - aktivovat rozhraní: ,
- kompilovat filtr: ,
- připojit filtr: .
Pro zobrazení, jak je funkce pcap_setfilter implementována v Linuxu, použijeme strace (některé řádky byly odstraněny):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Na prvních dvou řádcích výstupu vytváříme pro čtení všech Ethernetových rámců a připevňujeme jej k rozhraní eth0. Z víme, že filtr ip se bude skládat ze čtyř BPF instrukcí, a na třetím řádku vidíme, jak pomocí volby systémového volání setsockopt nahráváme a připojujeme filtr délky 4. To je náš filtr.
Je třeba poznamenat, že v klasickém BPF je načtení a připojení filtru vždy atomická operace, zatímco v nové verzi BPF je načtení programu a jeho připojení k generátoru událostí časově odděleno.
Skrytá pravda
O něco úplnější verze výstupu vypadá takto:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Resource temporarily unavailable)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Jak bylo uvedeno výše, načítáme a připojujeme náš filtr k soketu na řádku 5, ale co se děje na řádcích 3 a 4? Ukazuje se, že libpcap se o to postarají — aby do výstupu našeho filtru nezapadly pakety, které mu nevyhovují, knihovna fiktivní filtr ret #0 (zahodit všechny pakety), převádí soket do neblokujícího režimu a snaží se přečíst všechny pakety, které mohly zůstat od předchozích filtrů.
Celkově, abychom filtrovali pakety v Linuxu pomocí klasického BPF, je třeba mít filtr ve formě struktury typu struct sock_fprog a otevřený soket, poté lze filtr připojit k soketu pomocí systémového volání. setsockopt.
Je zajímavé, že filtr lze připojit k jakémukoli soketu, nejen k raw. Zde je program, který odstraňuje vše kromě dvou prvních bytů u všech příchozích UDP datagramů. (Komentáře jsem přidal do kódu, abych nezatěžoval článek.)
Více o použití setsockopt pro připojení filtrů viz , a o psaní vlastních filtrů typu struct sock_fprog bez pomoci tcpdump si promluvíme v sekci .
Klasický BPF a XXI. století
BPF byl do Linuxu zařazen v roce 1997 a dlouho zůstal pracovním koněm libpcap bez zvláštních změn (změny specifické pro Linux, samozřejmě, , ale ty nezměnily celkový obraz). První vážné známky toho, že se BPF začne vyvíjet, se objevily v roce 2011, kdy Eric Dumazet navrhl , který přidal do jádra Just In Time Compiler — překladač pro převod bytecode BPF na nativní x86_64 kód.
JIT compiler byl prvním v řetězci změn: v roce 2012 možnost psát filtry pro , využívající BPF, v lednu 2013 byl modul xt_bpf, který umožňuje psát pravidla pro iptables pomocí BPF, a v říjnu 2013 byl ještě i modul cls_bpf, což umožňuje psát klasifikátory provozu pomocí BPF.
Tyto příklady prozkoumáme podrobněji, ale nejprve se budeme muset naučit psát a kompilovat libovolné programy pro BPF, protože možnosti, které poskytuje knihovna libpcap jsou omezené (jednoduchý příklad: filtr, generovaný libpcap může vrátit pouze dvě hodnoty — 0 nebo 0x40000) nebo vůbec, jako v případě seccomp, nepoužitelné.
Programujeme BPF vlastními rukama
Seznámíme se s binárním formátem instrukcí BPF, který je velmi jednoduchý:
   16    8    8     32
| code | jt | jf |  k  |
Každá instrukce zabírá 64 bitů, z nichž prvních 16 bitů je kód příkazu, následují dva osmizubé posuny, jt a jf, a 32 bitů pro argument, jehož význam se mění v závislosti na příkazu. Například příkaz K, který ukončuje program, má kód ret, a vrácená hodnota pochází z konstanty 6. V jazyce C je jedna instrukce BPF reprezentována strukturou Kstruct sock_filter { __u16 code; __u8 jt; __u8 jf; __u32 k; }
a celý program je reprezentován strukturoustruct sock_fprog { unsigned short len; struct sock_filter *filter; }
Tím pádem už můžeme psát programy (kódy instrukcí jsme, předpokládejme, znal z). Takto by vypadal filtr struct sock_filter code[] = { { 0x28, 0, 0, 0x0000000c }, { 0x15, 0, 1, 0x000086dd }, { 0x06, 0, 0, 0x00040000 }, { 0x06, 0, 0, 0x00000000 }, }; struct sock_fprog prog = { .len = ARRAY_SIZE(code), .filter = code, }; ip6 z :
Programuprog můžeme legálně použít v této výzvě setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))
Psaní programů ve formě strojových kódů není příliš pohodlné, ale někdy je to nutné (například pro ladění, psaní unit testů, psaní článků na Habru atd.). Pro pohodlí se v souboru<linux/filter.h> definují pomocné makra — stejný příklad jako výše by bylo možné přepsat jako struct sock_filter code[] = { BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12), BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1), BPF_STMT(BPF_RET|BPF_K, 0x00040000), BPF_STMT(BPF_RET|BPF_K, 0), }
Nicméně ani tato varianta není příliš pohodlná. Tak to usoudili i programátoři jádra Linux a proto v adresářitools/bpf Assembler je velmi podobný ladicímu výstupu
, ale navíc můžeme uvádět symbolické značky. Například zde je program, který zneplatňuje všechny pakety kromě TCP/IPv4: tcpdump$ cat /tmp/tcp-over-ipv4.bpf ldh [12] jne #0x800, drop ldb [23] jneq #6, drop ret #-1 drop: ret #0
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Standardně assembler generuje kód ve formátu , ,..., pro náš příklad s TCP to bude
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Pro pohodlí programátorů v C lze použít jiný formát výstupu:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Tento text lze zkopírovat do definice struktury typu struct sock_filter, jak jsme udělali na začátku této části.
Rozšíření Linuxu a netsniff-ng
Kromě standardních instrukcí BPF, Linux a tools/bpf/bpf_asm podporují také . Většinou instrukce slouží k přístupu k polím struktury struct sk_buff, popisující síťový paket v jádře. Nicméně existují také instrukce-pomocníci jiného typu, například ldw cpu načte do registru A výsledek spuštění funkce jádra raw_smp_processor_id().(V nové verzi BPF byla tato nestandardní rozšíření rozšířena ve formě poskytování programům sady kernel helpers pro přístup k paměti, strukturám a generování událostí.) Tady je zajímavý příklad filtru, ve kterém kopírujeme do uživatelského prostoru pouze hlavičky paketů, používajíc rozšíření poff, offset payloadu:
ld poff
ret a
Rozšíření BPF nebude možné použít v tcpdump, ale to je dobrý důvod se seznámit s balíčkem utilit , který kromě jiného obsahuje pokročilý program netsniff-ng, který kromě filtrování pomocí BPF obsahuje také efektivní generátor provozu a pokročilejší assembler BPF nazvaný tools/bpf/bpf_asmbpfc. Balíček obsahuje docela podrobnou dokumentaci, viz také odkazy na konci článku.Takže už umíme psát BPF programy libovolné složitosti a jsme připraveni se podívat na nové příklady, prvním z nichž je technologie seccomp, která pomocí filtrů BPF umožňuje řídit množství a sadu argumentů systémových volání, dostupných tomuto procesu a jeho potomkům.
seccomp
První verze seccomp byla přidána do jádra v roce 2005 a neměla velkou popularitu, protože poskytovala pouze jedinou možnost — omezit množství systémových volání, dostupných procesu, a to:
sigreturn read, write, exit a , a proces, který porušil pravidla, byl zabit pomocíSIGKILL SIGKILL. V roce 2012 byla do seccomp přidána možnost používat BPF filtry, které umožňují definovat množství povolených systémových volání a dokonce provádět kontroly jejich argumentů. (Zajímavé je, že jedním z prvních uživatelů této funkce byl Chrome, a v současnosti lidé z Chrome vyvíjejí mechanismus KRSI, založený na nové verzi BPF, který umožňuje přizpůsobení Linux Security Modules.) Odkazy na další dokumentaci najdete na konci článku.
Upozorňujeme, že na Habr již byly články o použití seccomp, možná by někoho zajímalo si je přečíst před (nebo místo) čtení následujících podkapitol. V článku jsou uvedeny příklady použití seccomp jak z verze 2007, tak i verze s použitím BPF (filtry se generují pomocí libseccomp), popisuje se propojení seccomp s Dockerem a také je uvedeno mnoho užitečných odkazů. V článku se pojednává mimo jiné o tom, jak přidávat černé nebo bílé seznamy systémových volání pro démony řízené systemd.
Dále se podíváme, jak psát a nahrávat filtry pro seccomp v čistém C a pomocí knihovny libseccomp a jaké jsou výhody a nevýhody každé varianty, a nakonec se podíváme, jak seccomp používá program strace.
Píšeme a nahráváme filtry pro seccomp
Už umíme psát BPF programy, a proto se nejprve podíváme na programové rozhraní seccomp. Filtr lze nastavit na úrovni procesu, přičemž všechny potomky budou tato omezení dědit. To se provádí pomocí systémového volání :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)kde &filter — to je ukazatel na již známou strukturu struct sock_fprog, tj. BPF program.
Jak se liší programy pro seccomp od programů pro sokety? Předávaným kontextem. V případě soketů se nám předávaly oblasti paměti obsahující paket, zatímco v případě seccomp nám je předávána struktura typu
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Zde nr — to je číslo spouštěného systémového volání, arch — aktuální architektura (o tom níže), args — až šest argumentů systémového volání, a instruction_pointer — je ukazatel na instrukci v uživatelském prostoru, která provedla tento systémový volání. Například abychom načetli číslo systémového volání do registru A musíme říct
ldw [0]Pro programy seccomp existují další vlastnosti, například přístup k kontextu je možný pouze na 32-bitovém zarovnání a nelze načítat půl slova nebo byte — při pokusu o načtení filtr ldh [0] systémový hovor seccomp vrátí EINVAL. Kontrolu načítaných filtrů provádí funkce jádra. (Ze směšného, v původním commitu, který přidal funkčnost seccomp, zapomněli do této funkce přidat povolení pro použití instrukce mod (zbytek po dělení) a nyní není dostupná pro seccomp BPF programy, protože její přidání ABI.)
V zásadě už víme vše, co potřebujeme k zápisu a čtení seccomp programů. Obvykle je logika programu uspořádána jako bílý nebo černý seznam systémových volání, například program
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
kontroluje černý seznam čtyř systémových volání s čísly 304, 176, 239, 279. Jaká to systémová volání jsou? Nemůžeme říct přesně, protože nevíme, pro jakou architekturu byl program napsán. Proto autoři seccomp začít všechny programy kontrolou architektury (aktuální architektura je uvedena v kontextu jako pole arch struktury struct seccomp_data). S kontrolou architektury by začátek příkladu vypadal takto:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
a potom naše čísla systémových volání by dostala určité hodnoty.
Píšeme a načítáme filtry pro seccomp pomocí libseccomp
Napsání filtrů v strojovém kódu nebo pro assembler BPF umožňuje získat plnou kontrolu nad výsledkem, ale někdy je také vhodnější mít přenosný a/nebo čitelný kód. V tom nám pomůže knihovna , která poskytuje standardní rozhraní pro zápis černých nebo bílých filtrů.
Pojďme například napsat program, který spustí binární soubor podle výběru uživatele, přičemž předtím nastavíme černý seznam systémových volání z (program je zjednodušen pro větší čitelnost, plnou verzi lze nalézt ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Na začátku definujeme pole sys_numbers s více než 40 čísly systémových volání k blokování. Potom inicializujeme kontext ctx a říkáme knihovně, že chceme povolit (SCMP_ACT_ALLOW) všechny systémové volání ve výchozím nastavení (je snadnější sestavit černé seznamy). Poté, jeden po druhém, přidáváme všechna systémová volání z černého seznamu. V reakci na systémové volání ze seznamu vyžadujeme SCMP_ACT_TRAP, v tomto případě seccomp odešle procesu signál SIGSYS s popisem, jaké konkrétní systémové volání porušilo pravidla. Nakonec program načítáme do jádra pomocí seccomp_load, který zkompiluje program a připojí ho k procesu pomocí systémového volání seccomp(2).
Pro úspěšnou kompilaci je potřeba program zlinkovat s knihovnou libseccomp, například:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Příklad úspěšného spuštění:
$ ./seccomp_lib echo ok
ok
Příklad zablokovaného systémového volání:
$ sudo ./seccomp_lib mount -t bpf bpf /tmp
Špatné systémové volání
Používáme strace, pro podrobnosti:
$ sudo strace -e seccomp ./seccomp_lib mount -t bpf bpf /tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ zabilo SIGSYS (core dumped) +++
Špatné systémové volání
odkud můžeme zjistit, že program byl ukončen kvůli použití zakázaného systémového volání mount(2).
Celkově jsme napsali filtr pomocí knihovny libseccomp, se znalostním kódem ve čtyřech řádcích. V uvedeném příkladu může doba provádění výrazně klesnout při velkém množství systémových volání, protože kontrola je jednoduše seznam porovnání. Pro optimalizaci byl nedávno do libseccomp přidán , který přidává podporu atributu filtru SCMP_FLTATR_CTL_OPTIMIZE. Pokud tento atribut nastavíte na 2, filtr bude převeden na program binárního vyhledávání.
Pokud chcete vidět, jak fungují filtry s binárním vyhledáváním, podívejte se na , který generuje takové programy v assembleru BPF na základě sady čísel systémových volání, například:
$ echo 1 3 6 8 13 | ./generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Není možné napsat nic zásadně rychlejšího, protože programy BPF nemohou provádět skoky na odsazení (nemůžeme například provést jmp A nebo jmp [label+X]) a proto jsou všechny skoky statické.
seccomp a strace
Všichni znají utilitu strace — nepostradatelný nástroj pro zkoumání chování procesů v Linuxu. Nicméně, mnoho lidí také slyšelo o při použití této utility. Je to proto, že strace je realizováno pomocí ptrace(2), a v tomto mechanismu nemůžeme určit, na jakém konkrétním souboru systémových volání se má proces zastavit, tedy například na příkazech
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
a
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
pracují zhruba ve stejném čase, ačkoli ve druhém případě chceme sledovat pouze jedno systémové volání.
Nová možnost --seccomp-bpf, přidaná v strace verzi 5.3, umožňuje mnohonásobně urychlit proces a doba spuštění při sledování jednoho systémového volání je již srovnatelná s dobou běžného spuštění:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Zde je samozřejmě malý podvod v tom, že nesledujeme hlavní systémové volání tohoto příkazu. Kdybychom například sledovali newfsstat, pak strace , zpomalil by stejně silně jako bez --seccomp-bpf.)
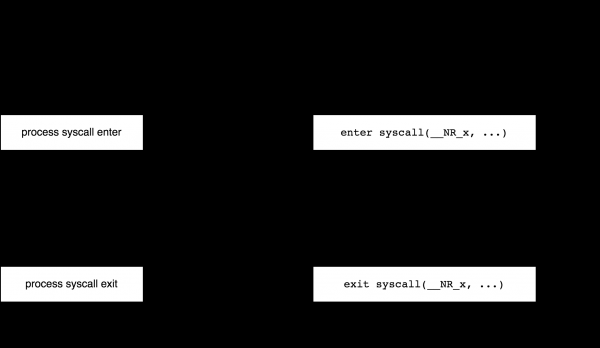
Jak tedy tato možnost funguje? Bez ní strace se připojuje k procesu a spouští ho pomocí PTRACE_SYSCALL. Když řízený proces spustí (jakékoli) systémové volání, řízení se předává strace, který se podívá na argumenty systémového volání a spustí ho pomocí PTRACE_SYSCALL. Po nějaké době proces dokončí systémové volání a při jeho výstupu se řízení opět předá strace, který se podívá na návratové hodnoty a spustí proces pomocí PTRACE_SYSCALL, atd.
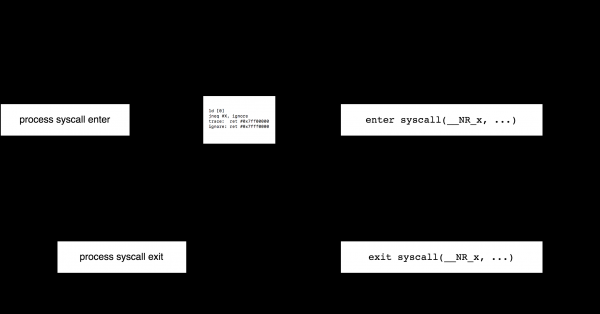
Pomocí seccomp však lze tento proces optimalizovat právě tak, jak bychom chtěli. Pokud chceme sledovat pouze systémové volání X, můžeme napsat BPF filtr, který X vrátí hodnotu SECCOMP_RET_TRACE, a pro nás nezajímavá volání - SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
V tomto případě strace původně spouští proces jako PTRACE_CONT, na každé systémové volání provádí náš filtr, pokud systémové volání není X, pokračuje proces v práci, ale pokud je to X, seccomp předá řízení strace, který se podívá na argumenty a spustí proces jako PTRACE_SYSCALL (protože v seccomp není možnost spustit program při výstupu ze systémového volání). Když se systémové volání vrátí, strace znovu spustí proces pomocí PTRACE_CONT a bude čekat na nová oznámení od seccomp.
Při použití možnosti --seccomp-bpf existují dvě omezení. Za prvé, nelze se připojit k již existujícímu procesu (možnost -p programu strace), protože to není podporováno seccomp. Za druhé, není možné ne sledovat potomky, protože seccomp filtry jsou děděny všemi potomky bez možnosti je vypnout.
Trochu více podrobností o tom, jak přesně strace funguje s seccomp se můžete dozvědět z . Pro nás je nejzajímavějším faktem, že klasický BPF v podobě seccomp se používá dodnes.
xt_bpf
Nyní se vraťme zpět do světa sítí.
Pozadí: kdysi dávno, v roce 2007, byl do jádra přidán modul xt_u32 pro netfilter. Byl napsán podle vzoru ještě staršího klasifikátoru provozu cls_u32 a umožnil psát libovolná binární pravidla pro iptables pomocí následujících jednoduchých operací: načíst 32 bitů z paketu a provést na nich sadu aritmetických operací. Například,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Načítá 32 bitů z hlavičky IP, počínaje posunem 6, a aplikuje na ně masku 0xFF (vezme nejmladší byte). To je pole protocol hlavičky IP a porovnáváme ho s 1 (ICMP). V jednom pravidle lze kombinovat mnoho kontrol, a také lze provádět operátor @ — přejít o X byte doprava. Například, pravidlo
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"ověřuje, zda není TCP Sequence Number 0x29. Nechci se dále dostávat do podrobností, protože už je jasné, že ručně psát taková pravidla není příliš pohodlné. V článku , je několik odkazů s příklady použití a generování pravidel pro xt_u32. Viz také odkazy na konci tohoto článku.
Od roku 2013 lze místo modulu xt_u32 použít modul založený na BPF. xt_bpfVšem, kteří dočetli až sem, by měl být jasný princip jeho fungování: spouštět bytecode BPF jako pravidla iptables. Nové pravidlo lze vytvořit například takto:
iptables -A INPUT -m bpf --bytecode -j LOGzde <байткод> — je to kód ve formátu výstupu assembleru bpf_asm podle výchozího nastavení, například,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
V tomto příkladu filtrujeme všechny UDP pakety. Kontext pro BPF program v modulu xt_bpf, samozřejmě, ukazuje na data paketu, v případě iptables — na začátek hlavičky IPv4. Návratová hodnota z BPF programu , kde false znamená, že paket se neshodoval.
Je jasné, že modul xt_bpf podporuje složitější filtry než v předchozím příkladu. Podívejme se na skutečné příklady od společnosti Cloudfare. Do nedávna používali modul xt_bpf pro ochranu před DDoS útoky. V článku vyprávějí, jak (a proč) generují BPF filtry a publikují odkazy na sadu nástrojů pro vytváření takových filtrů. Například pomocí nástroje bpfgen můžete vytvořit BPF program, který vyhledává DNS dotaz na jméno habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
V programu nejprve načteme do registru X adresu počátečního řetězce x04habrx03comx00 uvnitř UDP datagramu a pak kontrolujeme dotaz: 0x04686162 "x04hab" atd.
O něco později Cloudfare publikovala kód kompilátoru p0f -> BPF. V článku vyprávějí o tom, co je p0f a jak převádět p0f podpisy na BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
V současné době Cloudfare již více nepoužívá xt_bpf, protože přešli na XDP — jednu z variant použití nové verze BPF, viz. .
cls_bpf
Poslední z příkladů použití klasického BPF v jádře — to je klasifikátor cls_bpf pro subsystém řízení provozu v Linuxu, přidaný do Linuxu na konci roku 2013 a konceptuálně nahradil archaický cls_u32.
O tom, jak funguje cls_bpf, nebudeme teď hovořit — z hlediska znalostí o klasickém BPF nám to nic nepřinese — již jsme se seznámili se všemi funkcemi. Navíc v následujících článcích, které se věnují Extended BPF, se ještě několikrát setkáme s tímto klasifikátorem.
Další důvod, proč nemluvit o klasickém BPF s cls_bpf spočívá v tom, že v porovnání s Extended BPF je v tomto případě radikálně zúžena oblast použitelnosti: klasické programy nemohou měnit obsah paketů a nemohou uchovávat stav mezi voláními.
Je tedy čas se rozloučit s klasickým BPF a nahlédnout do budoucnosti.
Rozloučení s classic BPF
Podívali jsme se na to, jak technologie BPF, vyvinutá na začátku devadesátých let, úspěšně přežila čtvrt století a neustále nacházela nová uplatnění. Nicméně, stejně jako přechod ze zásobníkových strojů na RISC, který podnítil vývoj klasického BPF, došlo v roce 2000 k přechodu z 32bitových na 64bitové stroje a klasické BPF začalo zastarávat. Kromě toho jsou možnosti klasického BPF silně omezené; kromě zastaralé architektury nemáme možnost uchovávat stav mezi voláními BPF programů, nemáme možnost přímé interakce s uživateli a nemáme možnost interakce s jádrem kromě čtení omezeného počtu polí struktury. sk_buff a spouštět jednoduché pomocné funkce, nelze měnit obsah paketů ani je přesměrovávat.
Ve skutečnosti v současnosti z klasického BPF v Linuxu zůstal pouze rozhraní API, a uvnitř jádra jsou všechny klasické programy, ať už jde o filtry socketů nebo filtry seccomp, automaticky překládány do nového formátu, Extended BPF. (O tom, jak přesně to probíhá, se zmíníme v příštím článku.)
Přechod na novou architekturu začal v roce 2013, kdy Alexej Starovoitov navrhl plán na aktualizaci BPF. V roce 2014 začaly odpovídající patchi v jádře. Jak chápu, původně se plánovalo pouze optimalizovat architekturu a JIT-compiler pro efektivnější fungování na 64bitových strojích, ale namísto toho tyto optimalizace zahájily novou kapitolu ve vývoji Linuxu.
Další články v této sérii se zabývají architekturou a aplikacemi nové technologie, původně známé jako internal BPF, pak extended BPF a nyní jednoduše jako BPF.
Odkazy
- Steven McCanne a Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — zapomenutý bytecode:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Představujeme nástroj BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Přehled seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: pohled pod kapotu",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Zdroj: habr.com
