

Trh distribuovaných výpočtů a velkých dat, pokud se má věřit , roste o 18-19 % ročně. To znamená, že otázka výběru softwaru pro tyto účely zůstává aktuální. V tomto příspěvku začneme tím, proč jsou distribuované výpočty potřeba, podrobně se zaměříme na výběr softwaru, povíme si o využití Hadoopu pomocí Cloudera a nakonec se budeme zabývat výběrem hardwaru a tím, jak různými způsoby ovlivňuje výkon.
Proč jsou distribuované výpočty potřebné v běžném podnikání? Je to jednoduché a zároveň složité. Jednoduché — protože ve většině případů provádíme relativně jednoduché výpočty na jednotku informací. Složitě — protože takové informace je hodně. Opravdu hodně. V důsledku toho je zapotřebí . Scénáře použití jsou tak poměrně universální: výpočty lze aplikovat všude tam, kde je třeba zohlednit velké množství metrik na ještě větším množství dat.
Jedním z nedávných příkladů je: síť pizzerií Dodo Pizza na základě analýzy zákaznické objednávkové databáze, že při výběru pizzy s libovolnou náplní uživatelé obvykle operují jen šesti základními soubory ingrediencí plus pár náhodnými. S tímto přizpůsobila pizzerie své nákupy. Navíc se jí podařilo lépe doporučovat zákazníkům další produkty nabídnuté během objednávky, což vedlo k zvýšení zisku.
Další příklad: snížení počtu položek umožnilo obchodům H&M zkrátit sortiment v jednotlivých obchodech o 40 %, přičemž úroveň prodeje zůstala zachována. Toho se podařilo dosáhnout vyloučením špatně prodávaných položek, přičemž se zohlednila sezónnost.
Výběr nástroje
Odvětvovým standardem výpočtů tohoto druhu je Hadoop. Proč? Protože Hadoop je skvělý, dobře zdokumentovaný rámec (stejně jako Habr poskytuje množství podrobných článků na toto téma), který je doprovázen celou sadou utilit a knihoven. Můžete do něj dodávat obrovské sady strukturovaných i nestrukturovaných dat, a systém je sám rozdělí mezi výpočetní zdroje. Tyto zdroje můžete kdykoli rozšířit nebo deaktivovat — to je horizontální škálovatelnost v akci.
V roce 2017 vlivná konzultační společnost Gartner , že Hadoop brzy vyjde z módy. Důvod je poměrně banální: analytici se domnívají, že společnosti masivně migrují do cloudu, kde budou moci platit za skutečné využití výpočetních zdrojů. Druhým důležitým faktorem, který údajně může "pohřbít" Hadoop, je rychlost práce. Možnosti jako Apache Spark nebo Google Cloud DataFlow totiž pracují rychleji než MapReduce, což je základ Hadoopu.
Hadoop spočívá na několika pilířích, mezi nimiž jsou nejvýraznější technologie MapReduce (systém distribuce dat pro výpočty mezi servery) a souborový systém HDFS. Ten je speciálně navržen pro ukládání informací rozdělených mezi uzly clustera: každý blok pevné velikosti může být umístěn na několika uzlech, a díky replikaci se zajišťuje odolnost systému vůči selhání jednotlivých uzlů. Místo tabulky souborů se používá speciální server nazývaný NameNode.
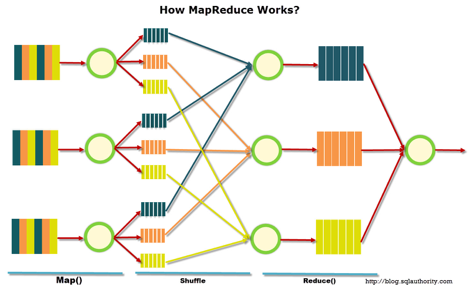
Na ilustraci níže je schéma práce MapReduce. V prvním kroku se data dělí podle určitého kritéria, ve druhém se distribuuje podle výpočetních kapacit, ve třetím probíhá výpočet.
Původně MapReduce vytvořil Google pro potřeby svého vyhledávání. Poté přešla MapReduce do svobodného kódu a projektu se ujal Apache. Google přitom postupně migroval na jiné řešení. Zajímavý detail: v současnosti má Google projekt nazývaný Google Cloud Dataflow, který je prezentován jako další krok po Hadoopu, jako jeho rychlá náhrada.
Při bližším zkoumání je zřejmé, že Google Cloud Dataflow je založen na variantě Apache Beam, přičemž Apache Beam obsahuje dobře zdokumentovaný framework Apache Spark, což umožňuje hovořit o téměř stejné rychlosti realizace řešení. Apache Spark výborně funguje na souborovém systému HDFS, což umožňuje jeho nasazení na serverech Hadoop.
Přičteme sem objem dokumentace a hotových řešení pro Hadoop a Spark ve srovnání s Google Cloud Dataflow, a volba nástroje se stává zřejmou. Navíc mohou inženýři sami rozhodovat, který kód — pro Hadoop nebo Spark — budou provádět, přičemž se orientují na úkol, zkušenosti a kvalifikaci.
Cloud nebo lokální server
Tendence ke všeobecnému přechodu do cloudu přivedla k zajímavému termínu jako Hadoop-as-a-service. V tomto scénáři se stalo velmi důležitým spravování připojených serverů. Protože, bohužel, navzdory své popularitě je čistý Hadoop poměrně složitý nástroj na nastavení, neboť mnoho věcí je třeba dělat manuálně. Například jednotlivě konfigurovat servery, sledovat jejich parametry, pečlivě nastavovat řadu parametrů. Celkově je to práce pro nadšence a existuje velké riziko, že se někde něco pokazí nebo něco přehlédnete.
Proto získaly velkou popularitu různé distribuce, které jsou od začátku vybaveny pohodlnými prostředky pro nasazení a administraci. Jedna z nejpopulárnějších distribucí, které podporují Spark a všechno usnadňují, je Cloudera. Ta má jak placenou, tak bezplatnou verzi — a v té poslední je dostupná veškerá základní funkčnost, a to bez omezení počtu uzlů.
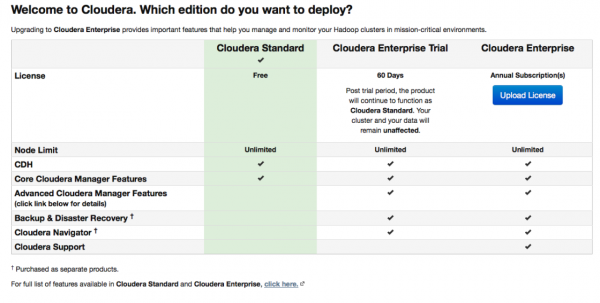
Během nastavení Cloudera Manager se bude připojovat přes SSH k vašim serverům. Zajímavý detail: při instalaci je lepší uvést, aby se to provádělo takzvanými parcelami: speciálními balíčky, které obsahují všechny potřebné komponenty nakonfigurované pro vzájemnou spolupráci. V podstatě jde o vylepšenou verzi správce balíčků.
Po instalaci získáme konzoli pro správu clusteru, na které lze vidět telemetrii clusterů, nainstalované služby a navíc budete moci přidávat/odebírat zdroje a upravovat konfiguraci clusteru.
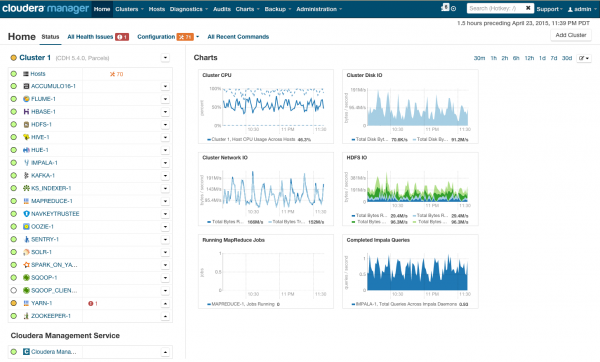
V důsledku toho se před vámi objeví startovní pozice rakety, která vás vynese do světlé budoucnosti BigData. Ale než řeknete „jedeme“, přesuňme se pod kapotu.
Požadavky na hardware
Na svém webu Cloudera zmiňuje různé možné konfigurace. Obecné principy, podle kterých jsou stavěny, jsou uvedeny na ilustraci:
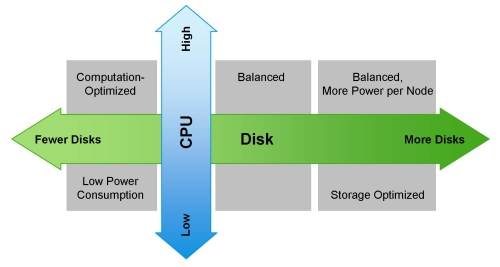
Optimistický obrázek může pokazit MapReduce. Při pohledu na schéma z předchozího oddílu je jasné, že se téměř ve všech případech může úloha MapReduce setkat s "úzkým hrdlem" při čtení dat z disku nebo sítě. To je také zmíněno v blogu Cloudera. Výsledkem je, že pro jakékoli rychlé výpočty, včetně těch přes Spark, který se často používá pro výpočty v reálném čase, je důležitá rychlost vstupu/výstupu. Proto je při používání Hadoopu velmi důležité, aby do clusteru připadaly vyvážené a rychlé stroje, což, mírně řečeno, není vždy zajištěno v cloudové infrastruktuře.
Vyváženost v distribuci zátěže se dosahuje díky použití virtualizace OpenStack na serverech s výkonnými vícejádrovými CPU. Datovým uzlům jsou vyhrazeny vlastní procesorové zdroje a určité disky. V našem řešení Atos Codex Data Lake Engine se dosahuje široké virtualizace, takže získáváme výhody jak v oblasti výkonu (minimalizuje se dopad síťové infrastruktury), tak v TCO (vylučují se nadbytečné fyzické servery).
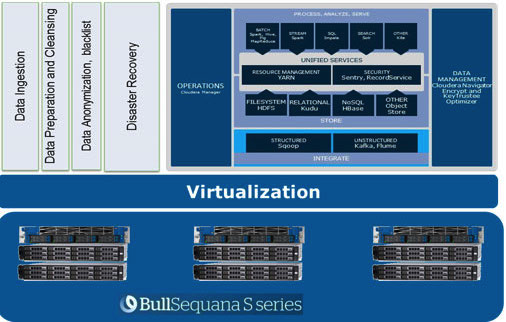
Při použití serverů BullSequana S200 dosahujeme poměrně rovnoměrného zatížení, zbaveného některých úzkých míst. Minimální konfigurace zahrnuje 3 servery BullSequana S200, každý se dvěma JBOD, plus volitelně jsou připojeny další S200, obsahující čtyři datové uzly. Zde je příklad zatížení z testu TeraGen:
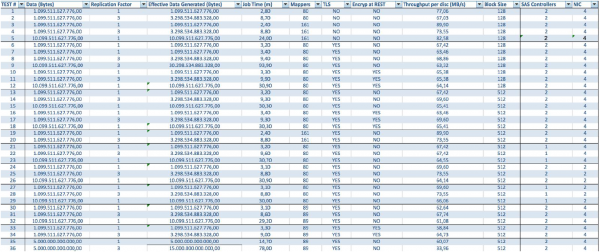
Testy s různými objemy dat a hodnotami replikace ukazují shodné výsledky z hlediska distribuce zátěže mezi uzly clusteru. Níže je graf distribuce přístupu k disku v testech výkonu.
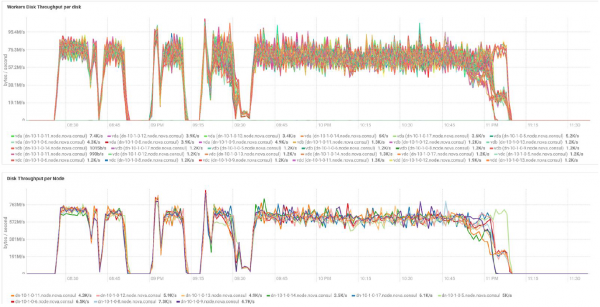
Výpočty byly provedeny na bázi minimální konfigurace ze 3 serverů BullSequana S200. Ta zahrnuje 9 datových uzlů a 3 hlavní uzly, stejně jako rezervované virtuální stroje pro případ nasazení ochrany na základě virtualizace OpenStack. Výsledek testu TeraSort: velikost bloku 512 MB s koeficientem replikace tři a s šifrováním činí 23,1 min.
Jak lze systém rozšířit? Pro Data Lake Engine jsou k dispozici různé typy rozšíření:
- Datové uzly: pro každý 40 TB užitného prostoru
- Analytické uzly s možností instalace grafického procesoru
- Další možnosti v závislosti na potřebách podnikání (například pokud potřebujete Kafka a podobně)
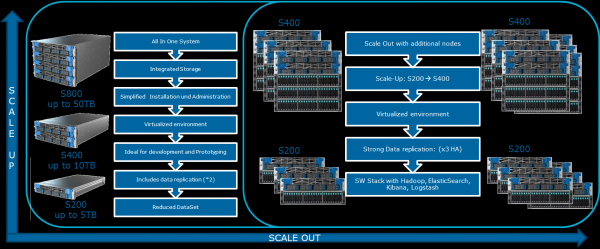
Systém Atos Codex Data Lake Engine zahrnuje nejen servery, ale také předinstalovaný software, který obsahuje balíček Cloudera s licencí; samotný Hadoop, OpenStack s virtuálními stroji založenými na jádru RedHat Enterprise Linux, systémy replikace dat a zálohování (včetně pomocí záložního uzlu a Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine se stal prvním řešením s virtualizací, které bylo certifikováno. .
Pokud máte zájem o podrobnosti, rádi odpovíme na vaše otázky v komentářích.
Zdroj: habr.com
