

9. ledna byl vydán Pandas 1.0.0rc. Předchozí verze knihovny byla 0.25.
První hlavní vydání obsahuje řadu skvělých novinek, včetně vylepšeného automatického součtování datových rámců, více výstupních formátů, nové datové typy a dokonce nový web s dokumentací.
Všechny změny lze zobrazit , v tomto článku se však omezíme na menší, méně technický přehled toho nejdůležitějšího.
Knihovnu lze nainstalovat obvyklým způsobem pomocí pip, ale protože v době psaní článku je Pandas 1.0 stále release candidate, je třeba jasně uvést verzi:
pip install --upgrade pandas==1.0.0rc0Buďte opatrní: protože se jedná o hlavní vydání, aktualizace může rozbít starý kód!
Mimochodem, od této verze je plně ukončena podpora pro Python 2 (což může být dobrý důvod — pozn. překl.). Pandas 1.0 vyžaduje alespoň Python 3.6+, takže pokud si nejste jisti, ověřte, která verze je nainstalována u vás:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Nejjednodušší způsob, jak zkontrolovat verzi Pandas, je takto:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Vylepšené automatické součtování s DataFrame.info
Moji oblíbenou novinkou bylo vylepšení metody DataFrame.info. Funkce se stala mnohem čitelnější, což usnadňuje proces prozkoumávání dat:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Výstup tabulek ve formátu Markdown
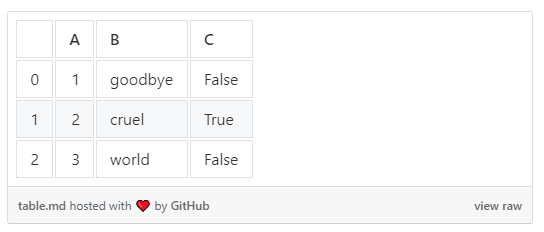
Další příjemnou novinkou je možnost exportovat datové rámce do tabulek Markdown pomocí DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
To výrazně zjednodušuje publikaci tabulek na webech jako Medium s použitím github gists.
Nové typy pro řetězce a logické hodnoty
Vydání Pandas 1.0 také přidalo nové experimentální typy. Jejich API se ještě může změnit, takže je používajte opatrně. Ale obecně Pandas doporučuje používat nové typy všude tam, kde to dává smysl.
Zatím je potřebné provádět převod explicitně:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 do 2
Data columns (total 3 columns):
 #   Sloupec  Ne-null počet  Typ
---  ------  --------------  -----
 0   A       3 ne-null      int64
 1   B       3 ne-null      string
 2   C       3 ne-null      bool
dtypes: int64(1), object(1), string(1)
využití paměti: 200.0+ bajtů
Všimněte si, jak sloupec Typ zobrazuje nové typy — string a bool.
Nejvíce užitečnou funkcí nového typového řetězce je možnost výběru pouze sloupců řetězců z datových rámců. To může výrazně usnadnit analýzu textových dat:
df.select_dtypes("string")Dříve nebylo možné vybírat sloupce řetězců bez výslovného uvedení názvů.
Více o nových typech si můžete přečíst .
Děkujeme, že jste dočetli! Kompletní seznam změn, jak bylo již zmíněno, si můžete prohlédnout .
Zdroj: habr.com
