

Definice DevOps je velmi složitá, a proto musíme pokaždé znovu spouštět diskuzi o tom. Jen na Habr je tisíc publikací na toto téma. Ale pokud to čtete, určitě víte, co DevOps je. Protože já to nevím. Ahoj, jmenuji se Alexander Titov (@), a budeme si jen povídat o DevOps a já se podělím o své zkušenosti.
Dlouho jsem přemýšlel, jak udělat svůj příběh užitečným, proto zde bude mnoho otázek - těch, které si sám pokládám, a těch, které pokládám klientům naší společnosti. Odpovědí na tyto otázky se porozumění zlepší. Řeknu, proč je DevOps důležitý z mého pohledu, co to vlastně je, opět z mé pozice, a jak pochopit, že se posouváte k DevOps, opět z mého pohledu. Poslední bod bude skrze otázky. Odpovědi na ně si můžete položit sami a zjistit, zda vaše společnost směřuje k DevOps nebo jsou v tom nějaké problémy.
Nějakou dobu jsem jezdil na vlnách fúzí a akvizic. Nejdříve jsem pracoval v malém startupu Qik, který pak koupila trochu větší firma Skype, kterou pak koupila ještě větší firma Microsoft. V tuto chvíli jsem získal pohled na to, jak se vnímání DevOps transformuje v různě velkých firmách. Po tomto jsem byl zvědavý podívat se na DevOps z hlediska trhu a my s kolegy jsme založili společnost Ekspress 42. Už 6 let se na ní pohybujeme po vlnách trhu.
Kromě toho jsem jedním z organizátorů komunity DevOps Moscow a organizátor DevOps -Days 2017, ale v roce 2018 jsem to neorganizoval. Ekspress 42 spolupracuje s mnoha firmami. Rozvíjíme tam DevOps, sledujeme, jak to probíhá, děláme závěry, analyzujeme, sdílíme své závěry s ostatními, školíme lidi v prakticích DevOps. Obecně se snažíme zvyšovat zkušenosti a odbornost v této oblasti.
Proč DevOps
První otázka, která trápí všechny a vždy - proč? Mnozí si myslí, že DevOps je jen automatizace nebo něco podobného, co již bylo v každé společnosti.
- Měli jsme Continuous Integration - to znamená, že už byl DevOps, a proč je to všechno potřeba? Tam na západě si dělají srandu, a nám překážejí v práci!
Za 9 let vývoje komunity a metodologie už je jasné, že to není jen marketingová póza, ale stále není úplně jasné, proč je to potřebné. Jako každý nástroj a proces má DevOps konkrétní cíle, které nakonec naplňuje.
To vše souvisí s tím, že svět se mění. Vzdaluje se od podoby enterprise, kdy firmy míří přímo za svým snem, jak zpíval náš klasický peterský autor, z bodu A do bodu B podle určité strategie, s jasně definovanou strukturou.
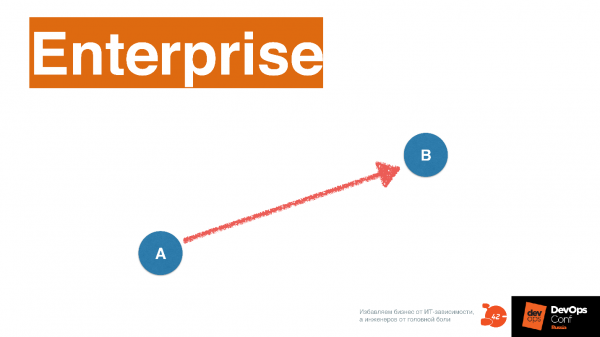
V zásadě by mělo být vše v IT postaveno podle tohoto přístupu. Zde se IT používá výhradně k automatizaci procesů.
Automatizace se často nemění, protože když firma jede po vyjeté koleji — co tam měnit? Když to funguje — nechej to být. Dnes se však přístupy ve světě mění, a ten, který se nazývá Agile, říká, že konečné místo B není hned vidět.
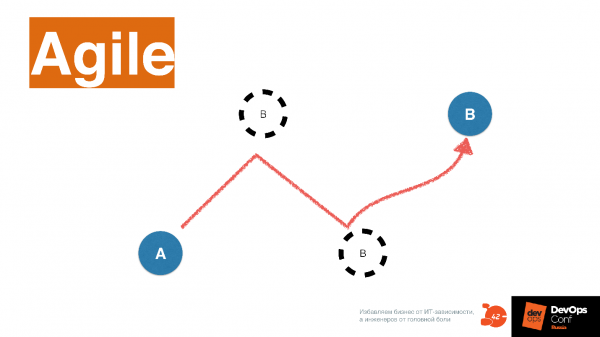
Když firma jde trhem a spolupracuje se zákazníkem — neustále zkoumá trh a mění konečný cíl B. Čím častěji firma mění svůj směr, tím úspěšnější je nakonec, protože si vybírá více tržních nika.
Strategie demonstruje zajímavá firma, o které jsem se nedávno dozvěděl. One Box Shave — služba pro dodávku holících strojků a holicích potřeb na základě předplatného v krabičce. Umějí přizpůsobit svoji "krabičku" různým klientům. Tomu se věnuje specifický software, který poté posílá objednávku na korejskou fabriku vyrábějící zboží.
Tento produkt zakoupila firma Unilever za 1 miliardu dolarů. Nyní konkuruje Gillette a získal od něj značný podíl zákazníků na americkém trhu. One Box Shave říká:
— 4 čepele? Opravdu? Proč vám to je potřeba — to nijak nezlepšuje kvalitu holení. Speciálně vybraný krém, vůně a kvalitní holicí strojek se dvěma čepelemi vyřeší mnohem více problémů než ty bláznivé 4 čepele Gillette! Tak brzy dojdeme až ke 10?
Tak se svět mění. Unilever prohlašují, že mají skvělý IT systém, který to umožňuje. Nakonec to vypadá jako koncept Time-to-market, o kterém už mluvili snad všichni.
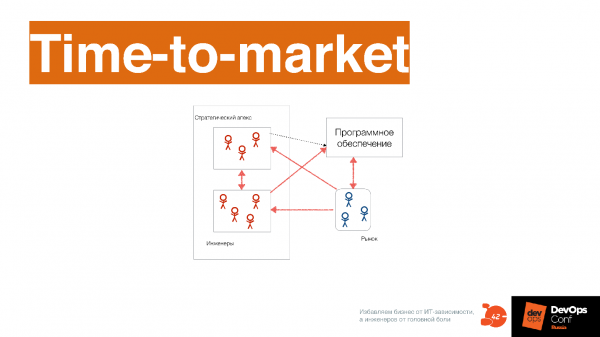
Smysl Time-to-market není v tom, jak často se nasazujeme. Můžeme často nasazovat, ale přitom mít dlouhé cykly vydání. Pokud na sebe naskládáme tří měsíční cykly vydání s posunem o týden, vychází to tak, že společnost se jakoby nasazuje jednou týdně. A od nápadu po konečnou realizaci uběhne 3 měsíce.
Time-to-market je o minimalizaci času od nápadu po konečnou realizaci.
V tomto případě s trhem interaguje software. Tak jako One Box Shave s klientem interaguje web. Nemají prodavače — je to prostě web, kde návštěvník klikne a nechá své přání. Proto je třeba na webu neustále umisťovat něco nového a aktualizovat ho podle těchto přání. Například v Jižní Koreji se holí jinak než v Rusku a mají rádi vůni mrkve vanilky spíše než vůni borovice.
Jelikož je potřeba rychle měnit obsah webu, vývoj software se silně mění. Skrze software musíme zjistit, co klient chce. Dříve jsme to zjišťovali nějakými obcházejícími cestami, například skrze business management. Pak jsme projektovali, zakládali požadavky v IT systému, a vše bylo skvělé. Teď je to jinak — software projektuje každý, kdo je zapojen do procesu, včetně inženýrů, protože získávají zpětnou vazbu prostřednictvím technických specifikací o tom, jak funguje trh, a sdílejí se business jejich poznatky.
Například ve společnosti Qik jsme náhle zjistili, že lidé mají velmi rádi nahrávat kontaktní seznamy na server, a přidali nám aplikaci. Původně jsme o tom nepřemýšleli. V klasické společnosti by všichni usoudili, že to je chyba, protože v specifikaci není napsáno, že to musí fungovat skvěle, a vzhledem k tomu, že to bylo realizováno na koleně, vypnuli by tuto funkci a řekli: 'To nikomu není potřeba, hlavní je, že základní funkčnost funguje.' Technologie společnost v tom vidí příležitost a začíná měnit software v souladu s tím.
V roce 1968 pronesl bystrý mladík Melvin Conway následující myšlenku.
Organizace, která vytváří systém, je omezena designem, který kopíruje strukturu komunikace v této organizaci.
Pokud jde o podrobnosti, abyste mohli vyrábět systémy jiného typu, musíte mít také komunikační strukturu uvnitř společnosti jiného typu. Pokud máte komunikační strukturu s horní hierarchií, to vám nepovolí vytvářet systémy, které mohou zajistit velmi vysokou hodnotu Time-to-market.
Přečíst lze . Je důležitý pro pochopení kultury nebo filozofie DevOps, protože jediná věc, která se základně mění v DevOps, je právě struktura komunikace mezi týmy.
Z pohledu procesu všechny fáze před DevOps: analýza, vývoj, testování, provoz, probíhaly lineárně.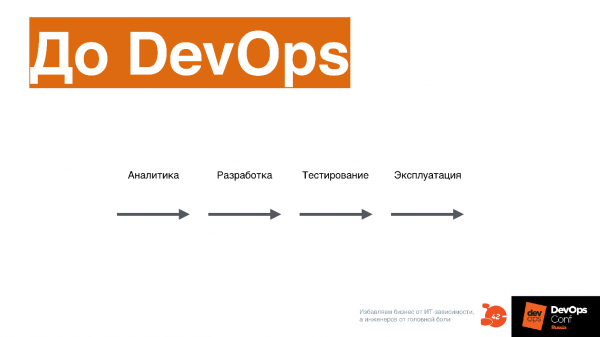
V případě DevOps probíhají všechny tyto procesy současně.
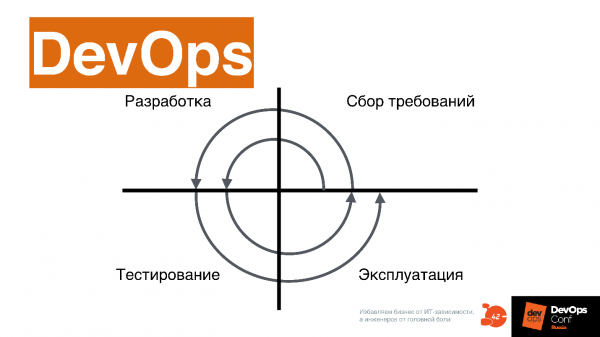
Time-to-market může být plněn jen takto. Pro lidi, kteří pracovali ve starém procesu, to vypadá poněkud kosmicky, a vůbec tak nějak.
Tak proč potřebujeme DevOps?
Pro vývoj digitálních produktů. Pokud nemáte v společnosti žádný digitální produkt, DevOps není potřeba - to je velmi důležité.
DevOps překonává rychlostní omezení sekvenčního schématu výroby softwaru. V něm probíhají všechny procesy současně.
Zvyšuje se složitost. Když evangelisté DevOps říkají, že s ním bude jednodušší vydávat software - to je nesmysl.
S DevOps všechno bude jen složitější.
Na konferenci na stánku Avito jste si mohli prohlédnout, co znamená deploynout Docker kontejner - nerealizovatelný úkol. Složitost přesahuje meze, musíte žonglovat s mnoha míčky současně.
DevOps mění zcela proces a organizaci ve společnosti – přesněji, nemění DevOps, ale digitální produkt. Abychom dospěli k DevOps, musíme tento proces zcela změnit.
Otázky pro odborníka
A co vy? Otázky, které si můžete položit, když pracujete ve společnosti a rozvíjíte se jako odborník.
Máte strategii pro vytváření digitálního produktu? Pokud ano - už je to dobré. To znamená, že vaše společnost směřuje k DevOps.
Vytváří vaše společnost již digitální produkt? To znamená, že můžete vystoupit na další úroveň, zabývat se zajímavějšími věcmi - znovu z pohledu DevOps. O tomto pohledu právě hovořím.
Je vaše společnost jedním z lídrů trhu v oblasti digitálního produktu? Spotify, Yandex, Uber – společnosti, které jsou nyní na vrcholu technologického pokroku.
Zeptejte se sami sebe na tyto otázky, a pokud jsou všechny odpovědi záporné, možná se opravdu neměli věnovat DevOps v této společnosti. Pokud vás však téma DevOps skutečně zajímá, možná… byste měli přejít do jiné společnosti? Pokud vaše společnost chce vstoupit do světa DevOps, ale na všechny otázky jste odpověděli „Ne“, pak připomíná toho nádherného nosorožce, který se nikdy nezmění.
Organizace
Jak už jsem řekl, podle zákona Conwaye se ve společnosti mění organizace. Začnu tím, co brání DevOps proniknout dovnitř společnosti z pohledu organizace.
Problém „silo“
Anglické slovo „silo“ je zde přeloženo do ruštiny jako „silo“. Smysl tohoto problému spočívá v tom, že mezi týmy nedochází k výměně informací. Každý tým vykopává svou expertizu do hloubky, přičemž nebuduje společnou mapu, podle které by se dalo orientovat.
Něčím to připomíná člověka, který právě přijel do Moskvy a ještě neumí číst mapu metra. Moskvici obvykle skvěle znají svou čtvrť a v celé Moskvě se orientují podle mapy metra. Když přijedete do Moskvy poprvé, tuto dovednost nemáte, a jste jednoduše dezorientovaní.
DevOps se snaží překonat tento moment dezorientace a všem oddělením společně vybudovat společnou mapu interakce.
K tomu brání dva faktory.
Důsledek firemního systému řízení. Je postavena na oddělených hierarchických „silech“. Například existují určité KPI ve firmách, které tento systém podporují. Na druhou stranu brání mysli člověka, který má problém překročit hranice své expertízy a orientovat se v celém systému. To je prostě nepohodlné. Představte si, že se nacházíte na letišti v Bangkoku – tam se rychle neorientujete. V DevOps se také těžko orientuje, a proto lidé říkají, že je třeba najít průvodce, aby se tam dostali.
Ale nejdůležitější je, že problém „silo“ pro inženýra, který se nechal unést duchem DevOps, přečetl Fowlere a spoustu dalších knih, spočívá v tom, že "silo" nedovolují dělat "zřejmé" věci. Často se po DevOps Moscow scházíme, bavíme se navzájem a lidé si stěžují:
— Chtěli jsme pouze spustit CI, ale ukázalo se, že to managementu není potřeba.
To se děje právě proto, že CI a Proces kontinuálního dodávání se nacházejí na pomezí mnoha odborností. Pokud se nepřekoná problém "studní" na organizační úrovni, nebude možné se posunout dál, ať už uděláte cokoliv, a jak smutné to bylo.
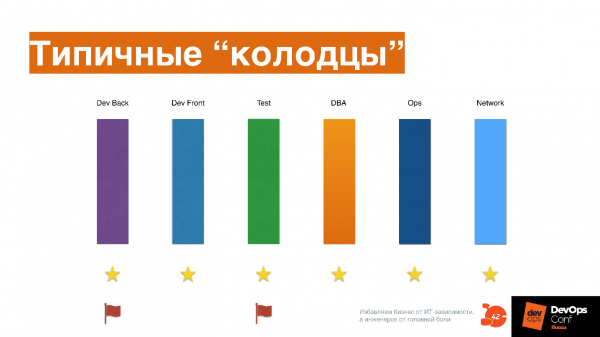
Každý účastník procesu ve společnosti: vývojáři backendu a frontendu, testování, DBA, provoz, síť, kopá v tom svém směru, a nikdo nemá společnou mapu, kromě manažera, který jaksi dohlíží a řídí metodou "rozděluj a panuj".
Lidé se perou o nějaké hvězdičky nebo vlaječky, každý se zabývá svou odborností.
Nakonec, když se objeví úkol všechno to spojit dohromady a postavit společný pipeline, a o hvězdičky a vlaječky už není potřeba bojovat, objevuje se otázka – co se má vlastně dělat? Je potřeba se nějak domluvit, ale jak to udělat, nás ve škole nikdo neučil. Ještě ze školy jsme naučeni: osmý ročník – wow! – ve srovnání se sedmým ročníkem! Tady je to stejné.
Je to ve vaší společnosti také tak?
Abychom to ověřili, můžeme si položit následující otázky.
Používají týmy společné nástroje, přispívají ke změnám těchto společných nástrojů?
Jak často se týmy přeformovávají – někteří odborníci z jedné týmu přecházejí do jiného týmu? Právě v DevOps prostředí se to stává normálním, protože někdy se člověk prostě nemůže pochopit, co dělá jiná odbornost. Přechází do jiného oddělení, tam dva týdny pracuje, aby si vytvořil mapu orientace a interakce s tím oddělením.
Lze vytvořit výbor pro změny a něco změnit? Nebo je k tomu potřeba silná ruka nejvyššího vedení a nařízení? Nedávno jsem napsal na Facebook, jak jeden málo známý bankovní ústav prostřednictvím nařízení zavádí nástroje: napsali nařízení, rok zavádíme, sledujeme, co se děje. To je samozřejmě dlouhé a smutné.
Jak důležité je pro manažery získávat osobní úspěchy bez ohledu na úspěchy společnosti?
Pokud si na tyto otázky odpovíte, bude jasnější, zda máte v společnosti takový problém.
Infrastruktura jako kód
Jakmile je tento problém vyřešen, prvním důležitým krokem, bez něhož je těžké pokročit v DevOps, je infrastruktura jako kód.
Infrastrukturu jako kód většinou vnímají takto:
— Pojďme všechno automatizovat pomocí bash, obalíme se skripty, aby administrátoři měli méně ruční práce!
Ale to není pravda.
Infrastruktura jako kód znamená, že IT systém, se kterým pracujete, popisujete ve formě kódu, abyste neustále rozuměli jeho stavu.
Společně s dalšími týmy vytváříte mapu ve formě kódu, která je všem srozumitelná, podle které se může orientovat a navigovat. Nezáleží na tom, na čem je to uděláno — Chef, Ansible, Salt, nebo se používají YAML soubory v Kubernetes — na tom nezáleží.
Na konferenci kolega z 2GIS vyprávěl, jak vytvořili svůj vnitřní nástroj pro Kubernetes, který popisuje strukturu jednotlivých systémů. Aby popsali 500 systémů, potřebovali zvláštní nástroj, který toto popisování generuje. Když je toto popisování k dispozici, každý si může srovnávat informace, monitorovat změny, jak to upravit a zlepšit, co chybí.
Souhlasíte, že jednotlivé bash skripty obvykle nedávají toto porozumění. V jedné z firem, kde jsem pracoval, bylo dokonce označení `write only` skript — když je skript napsaný, už ho není možné přečíst. Myslím, že to vám také připadá povědomé.
Infrastruktura jako kód je kód, který popisuje aktuální stav infrastruktury. Na tomto kódu společně pracuje mnoho produktových, infrastrukturních a servisních týmů, a co je nejdůležitější, všichni musí rozumět, jak tento kód vlastně funguje.
Kód je udržován podle nejlepších praktik práce s kódem: společný vývoj, revize kódu, XP-programming, testování, pull requesty, CI pro infrastrukturní kód — to vše je kvalitní a lze to použít.
Kód se stává společným jazykem pro všechny inženýry.
Změna infrastruktury v kódu nezabere mnoho času. Ano, v infrastrukturním kódu může také být technický dluh. Týmy se s ním obvykle setkávají zhruba po jednom a půl roce od doby, kdy začaly zavádět „infrastrukturu jako kód“ ve formě hromady skriptů nebo dokonce Ansible, které píší jako spaghetti kód, a ještě bash skripty tam přihazují do ohně!
Je důležité: pokud jste tuto věc ještě nezkusili, pamatujte, že Ansible není bash! Pečlivě čtěte dokumentaci, zkoumejte, co o tom vlastně píší.
Infrastruktura jako kód je rozdělení infrastrukturního kódu na jednotlivé vrstvy.
V naší společnosti vyčleňujeme 3 základní vrstvy, které jsou velmi srozumitelné a jednoduché, ale může jich být více. Můžete se podívat na svůj infrastrukturní kód a říct si, zda máte tuto podmínku nebo ne. Pokud se žádné vrstvy nevyčleňují, je třeba vyčlenit čas a trochu refaktorovat.
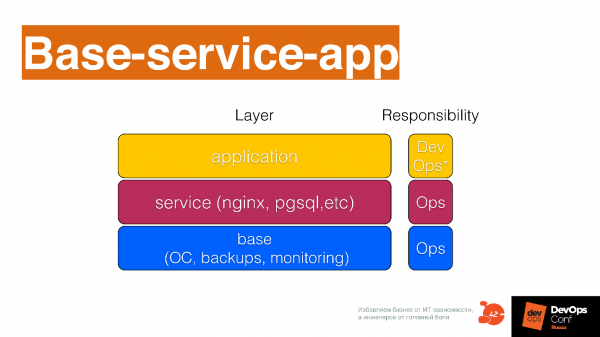
Základní vrstva — to je, jak se nastavuje OS, zálohování a další nízkoúrovňové věci, například jak se nasazuje Kubernetes na základní úrovni.
Úroveň služeb — to jsou služby, které dáváte vývojáři: logování jako služba, monitoring jako služba, databáze jako služba, vyvažovač zátěže jako služba, fronta jako služba, Continuous Delivery jako služba — spousta služeb, které mohou různé týmy poskytovat vývoji. To vše je třeba popsat jako samostatné moduly ve vašem systému pro správu konfigurace.
Vrstva, kde se vytvářejí aplikace a popisuje se, jak se budou nasazovat na dvě předchozí vrstvy.
Kontrolní otázky
Máte ve své společnosti společný infrastrukturní repozitář? Sledujete technický dluh v infrastruktuře? Používáte vývojové praktiky v infrastrukturním repozitáři? Je vaše infrastruktura rozdělena na vrstvy? Můžete se řídit schématem Base-service-APP. Jak těžké je provést změnu?
Pokud jste se setkali s tím, že provedení změn trvalo den a půl, znamená to, že máte technický dluh a je potřeba s ním pracovat. Právě jste narazili na úskalí technického dluhu v infrastrukturním kódu. Pamatuji si mnoho takových příběhů, kdy k provedení nějaké změny, třeba CCTL, bylo nutné přepsat polovinu infrastrukturního kódu, protože kreativita a touha vše automatizovat vedly k tomu, že je všechno zakorkováno, všechny ruční zásahy byly odstraněny a je třeba provést refaktoring.
Nepřetržitá dodávka
Shrneme debet s kreditem. Nejprve se objeví popis infrastruktury, který může být poměrně základní. Není nutné vše podrobně popisovat, ale nějaký základní popis je vyžadován, abyste s tím mohli pracovat. Jinak není jasné, na čem dále budeme provádět nepřetržitou dodávku. Všechny tyto praktiky se rozvíjejí současně, když přecházíte k DevOps, ale začít je třeba porozuměním tomu, co máte a jak s tím spravovat. To je právě praxe infrastruktury jako kódu.
Jakmile je jasné, co máte a jak s tím spravovat, začínáte vymýšlet, jak kód vývojáře co nejrychleji dostat do produkce. Mám na mysli společně s vývojářem – pamatujeme na problém 'studní', to znamená, že to nevymýšlí jednotlivci, ale tým.
Když jsme s Ivanem Jevtušovičem uviděli první knížku Jezze Hamblena a skupiny autorů „Continuous Delivery“, která vyšla v roce 2009, jsme dlouho přemýšleli, jak přeložit její název do češtiny. Chtěli jsme ji přeložit jako „Pravidelně dodávat“, ale bohužel jsme ji přeložili jako „Nepřetržitá dodávka“. Myslím, že v našem názvu je něco takového ruského, s naléhavostí.
Pravidelně dodávat znamená
Kód, který leží v produktovém repozitáři, může být vždy vytažen do produkce. Může být i nevytažen, ale vždy je na to připraven. Odpovídajícím způsobem vždy píšete kód s těžko vysvětlitelným pocitem určitého znepokojení v oblasti kostrče. Tento pocit se často objevuje, když vydáváte infrastrukturní kód. Tento pocit určitého znepokojení by měl být přítomen – vyvolává myšlenkové procesy, které umožňují psát kód poněkud jinak. To by mělo být zafixováno v pravidlech uvnitř vývoje.
Abychom pravidelně dodávali, potřebujeme formát artefaktu, který prochází infrastrukturní platformou. Pokud na infrastrukturní platformu házíte různé formáty "odpadní produkty", stává se nejednotnou, je obtížné ji spravovat a vzniká problém technického dluhu. Formát artefaktu je třeba vyrovnat – to je také kolektivní úkol: musíme se všichni společně sejít, zamyslet se a vymyslet tento formát.
Artefakt se neustále zlepšuje a mění podle produkčního prostředí během průchodu dodavatelským pipeline. Když se artefakt pohybuje po pipeline, neustále se setkává s různými nepříjemnostmi, které jsou podobné tomu, s čím se setkává artefakt, který nasazujete do produkce. Pokud se v klasickém vývoji o to stará systémový administrátor, který provádí nasazení, v procesu DevOps se to děje neustále: tady ho testují různými testy, tam ho hodili do Kubernetes clusteru, který více méně připomíná produkci, a tam náhle začali s zátěžovým testováním.
To trochu připomíná hru Pac-Man – artefakt prochází nějakým příběhem. Je důležité kontrolovat, zda kód skutečně prochází příběhem a zda nějak souvisí s vaší produkcí. Příběhy z produkce lze vkládat do procesu Continuous Delivery: bylo tomu tak, když něco selhalo, teď pojďme tento scénář prostě naprogramovat do systému. Každý příště kód projde tímto scénářem také a nebudete čelit této problému znovu. O ní se dozvíte daleko dříve, než dorazí k vašemu klientovi.
Různé strategie nasazení. Například používáte A/B testování nebo kanárkové nasazení, abyste různě "oťukávali" kód u různých klientů, získávali informace o tom, jak kód funguje, a daleko dříve, než se nasadí na 100 milionů uživatelů.
"Nepřetržitá dodávka" vypadá takto.
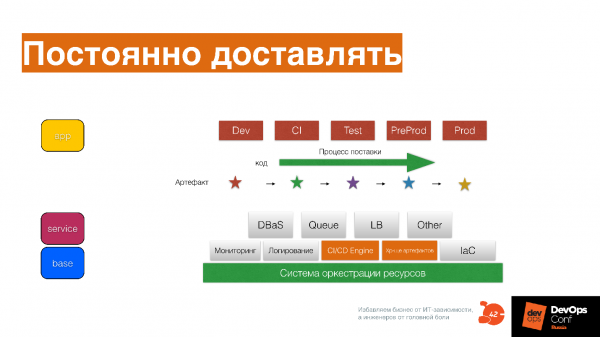
Proces dodávání Dev, CI, Test, PreProd, Prod – to není oddělené prostředí, to jsou fáze nebo stanice s nehořlavými částkami, kterými prochází váš artefakt.
Pokud máte infrastrukturní kód, který je popsán jako Base Service APP, pak pomáhá nezapomenout na všechny scénáře, a zaznamenat je také jako kód pro tento artefakt, posouvat artefakt a měnit ho za pochodu.
Otázky pro sebehodnocení
Je doba od popisu funkce po nasazení do produkce v 95 % případů kratší než týden? Zvyšuje se kvalita artefaktu v každé fázi pipeline? Existuje příběh, kterým prochází? Používáte různé strategie nasazení?
Pokud jsou všechny odpovědi ano, pak jste opravdu úžasní! Napište odpovědi do komentářů – budu rád).
Zpětná vazba
Toto je nejkomplexnější praxe ze všech. Na konferenci DevOpsConf kolega z Infobip, když o tom mluvil, se trochu zamotával do slov, protože to je opravdu velmi složitá praxe o tom, co je třeba monitorovat úplně všechno!
Například, už dávno, když jsem pracoval ve Qik a zjistili jsme, že je potřeba monitorovat opravdu všechno. Udělali jsme to, a v Zabbixu jsme měli 150 000 položek, které se neustále monitorovaly. Bylo to děsivé, technický ředitel točil prstem u spánku:
— Kluci, proč mučíte server něčím nepochopitelným?
Ale pak se stala událost, která ukázala, že to je opravdu velmi cool strategie.
Jedna ze služeb začala neustále padat. Původně nepadala, což je zajímavé, kód se tam neposouval, protože to byl základní broker, ve kterém bylo prakticky žádné podnikové funkce — jen předával zprávy mezi jednotlivými službami. Služba se nezměnila po dobu 4 měsíců a najednou začala padat s chybou "Segmentation fault".
Byli jsme v šoku, otevřeli jsme naše grafy v Zabbixu a zjistili jsme, že zhruba před čtrnácti dny se výrazně změnilo chování požadavků v API službě, která používá tento broker. Poté jsme si všimli, že se změnila frekvence posílání určitého typu zpráv. A dále jsme zjistili, že to byly android klienti. Zeptali jsme se:
— Kluci, co se vám stalo před čtrnácti dny?
V odpovědi jsme slyšeli zajímavý příběh o tom, že předělali UI. O lidech jen málokdo hned řekne, že změnili HTTP knihovnu. Pro android klienty je to jako vyměnit mýdlo v koupelně — jen si to prostě nepamatují. Nakonec, po 40 minutách rozhovoru, jsme zjistili, že přeci jen vyměnili HTTP knihovnu a ta měla změněné výchozí časování. To vedlo k tomu, že se změnilo chování provozu na API serveru, což vedlo k situaci, která způsobila závod uvnitř brokera, a začal padat.
Bez důkladného monitorování to vůbec není možné odhalit.. Pokud v organizaci existuje problém „studní“, kdy si každý přehazuje zodpovědnost, může to trvat roky. Jen restartujete server, protože není možné problém vyřešit. Když monitorujete, sledjete a trackujete všechny události, které máte, a používáte monitoring jako testování — píšete kód a ihned uvádíte, jak ho monitorovat, také formou kódu (už máme infrastrukturu jako kód), vše se stává jasné jako facka. I tak složité problémy jsou snadno sledovatelné.
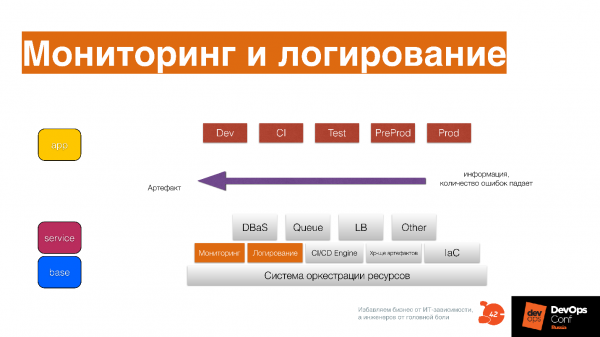
Shromažďujte všechny informace o tom, co se děje s artefaktem v každé fázi dodacího procesu — ne pouze v produkci.
Monitorování nahrávejte do CI, a tam už budou viditelné nějaké základní věci. Dále je uvidíte jak v Test, tak v PredProd, a také při zátěžovém testování. Shromažďujte informace ve všech fázích, přičemž nejen metriky, statistiky, ale i logy: jak bylo nasazeno aplikace, a anomálie — shromažďujte vše.
V opačném případě bude obtížné pochopit. Už jsem říkal, že DevOps je větší složitost. Abychom se s touto složitostí vyrovnali, je třeba mít dobrou analytiku..
Otázky pro sebereflexi
Je váš monitoring a logování pro vás nástrojem vývoje? Myslí vaši vývojáři, a vy také, při psaní kódu na to, jak ho monitorovat?
Zjistíte o problémech od zákazníků? Chápete zákazníka lépe prostřednictvím monitorování a logování? Chápete systém lépe díky monitorování a logování? Měníte systém jen proto, že vidíte, že trend v systému roste a chápete, že za 3 týdny to všechno skolabuje?
Když máte tyto tři komponenty, můžete přemýšlet o tom, jaká je vaše infrastrukturní platforma ve společnosti.
Infrastrukturní platforma
Smysl není v tom, že je to soubor rozptýlených nástrojů, které má každá firma.
Smyslem infrastrukturní platformy je, že všechny týmy tyto nástroje používají a společně je rozvíjejí.
Je jasné, že existují samostatné týmy, které nesou odpovědnost za rozvoj jednotlivých částí infrastrukturní platformy. Ale odpovědnost za rozvoj, funkčnost a propagaci infrastrukturní platformy nese každý inženýr. Na vnitřní úrovni se to stává společným nástrojem.
Všechny týmy rozvíjejí infrastrukturní platformu a pečují o ni jako o své vlastní IDE. Ve svém IDE si instalujete různé pluginy, aby vše vypadalo hezky a rychle, nastavujete klávesové zkratky. Když otevřete Sublime, Atom nebo Visual Studio Code, hned se vám hrnou chyby kódu a vy si uvědomíte, že není možné pracovat, najednou vám je smutno a běžíte opravovat své IDE.
Stejně tak se chovejte k vaší infrastrukturní platformě. Pokud zjistíte, že je něco špatně, podávejte žádost, pokud to nedokážete opravit sami. Pokud je to něco jednoduchého — opravujte to sami, posílejte pull request — kluci to posoudí a přidají. Je to trochu jiný přístup k inženýrskému nástroji v myslích vývojářů.
Infrastrukturní platforma zajišťuje převod artefaktu od vývoje k klientovi s neustálým zvyšováním kvality. V IP je naprogramována sada příběhů, které se odehrávají s kódem v produkci. Během let vývoje se těchto příběhů stává skutečně hodně, část z nich je jedinečná a týká se pouze vás — nelze je snadno vyhledat.
V tuto chvíli se infrastrukturní platforma stává vaším konkurenceschopným přínosem, protože v ní je zakódováno to, co ve nástroji konkurence není. Čím hlubší je vaše IP, tím větší je vaše konkurenční výhoda z pohledu Time-to-market. Zde se objevuje problém vendor lock: můžete si vzít cizí platformu, ale používáním cizího zkušeností nebudete rozumět, jak je relevantní pro vás. Ano, ne každá společnost může vybudovat platformu jako Amazon. Je to složitá hranice, kde jsou zkušenosti společnosti relevantní k její pozici na trhu, a vendor lock se sem nesmí pustit. O tom je také důležité uvažovat.
Schéma
Toto je základní schéma infrastrukturní platformy, které vám pomůže nastavit všechny praktiky a procesy ve Vaší DevOps společnosti.
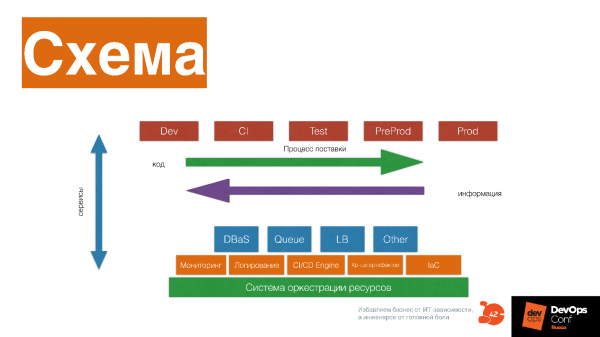
Podívejme se, z čeho se skládá.
Systém orchestrace zdrojů, který poskytuje CPU, paměť a disk aplikacím a dalším službám. Nad tímto — nízkolevelové služby: monitorování, logování, CI/CD engine, úložiště artefaktů, infrastruktura jako kód systému.
Vyšší úroveň služeb: databáze jako služba, fronty jako služba, Load Balance jako služba, resize obrázků jako služba, Big Data factory jako služba. Nad tím vším - pipeline, který neustále dodává modifikovaný kód vašemu klientovi.
Získáváte informace o tom, jak vaše software funguje u klienta, měníte, znovu dodáváte tento kód, získáváte informace - a tak neustále rozvíjíte jak infrastrukturu platformy, tak vaše software.
Na diagramu dodávací pipeline se skládá z mnoha fází. Ale tohle je principální schéma, které je uvedeno jako příklad - není třeba ho opakovat jeden k jednomu. Fáze interagují se službami, jako se službami - každý cihlička platformy nese svůj příběh: jak se vyčleňují zdroje, jak se aplikace spouští, pracuje se zdroji, monitoruje, mění.
Je důležité chápat, že každá část platformy nese příběh, a ptát se sebe - jaký příběh nese tento cihlička, zda by se mohla vyhodit a nahradit externí službou. Například, lze místo cihličky nasadit Okmeter? Možná, že hoši už rozvinuli tuto odbornost mnohem více, než my. Ale možná že ne – možná máme unikátní odbornost, musíme nasadit Prometheus a rozvíjet to dál.
Vytváření platformy
Je to složitý komunikační proces. Když máte základní praxe, spustíte komunikaci mezi různými inženýry a specialisty, kteří vypracovávají požadavky a standardy, a neustále je mění na různé nástroje a přístupy. Zde je důležitá kultura, která je v DevOps.
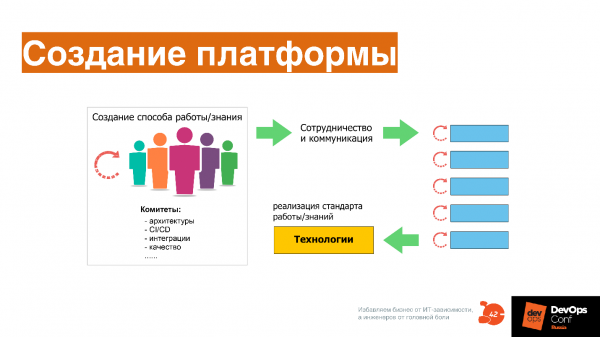
S kulturou je to velmi jednoduché - je to spolupráce a komunikace, tedy ochota pracovat v společném poli navzájem, ochota ovládat jeden nástroj společně. Tady není žádná rocket science - všechno je velmi jednoduché, banální. Například všichni žijeme v domě a udržujeme jeho čistotu - taková úroveň kultury.
A co u vás?
Znovu otázky, které si můžete položit.
Je infrastruktura platformy jasně vyčleněna? Kdo odpovídá za její rozvoj? Chápete konkurenční výhody své infrastruktury platformy?
Tyto otázky si musíte neustále klást. Pokud je něco možné přenést na externí služby, je třeba to udělat; pokud externí služba začne blokovat váš pokrok, je třeba vybudovat systém uvnitř sebe.
Takže, DevOps...
… to je složitý systém, který by měl mít:
- Digitální produkt.
- Obchodní moduly, které tento digitální produkt rozvíjejí.
- Produktové týmy, které píší kód.
- Praktiky Continuous Delivery.
- Platformy jako služba.
- Infrastruktura jako služba.
- Infrastruktura jako kód.
- Jednotlivé praktiky zajištění spolehlivosti, které jsou zakomponovány do DevOps.
- Praxe zpětné vazby, která to vše popisuje.
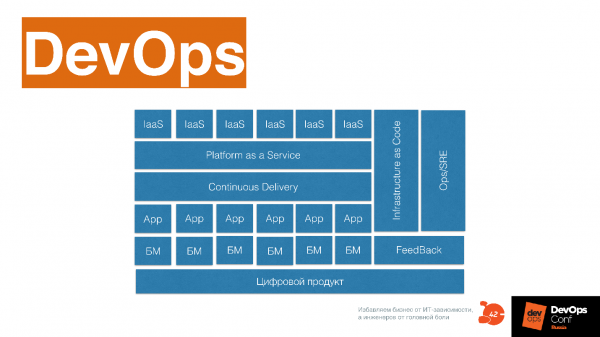
Tento schéma můžete použít a obarvit v ní to, co už ve vaší společnosti existuje v nějaké formě: to se vyvinulo nebo je třeba ještě vyvinout.
Už za pár týdnů proběhne . v rámci RIT++. Přijďte na konferenci, kde vás čeká spousta skvělých přednášek o kontinuálním dodávání, infrastruktuře jako kódu a DevOps transformaci. , poslední termín pro ceny je 20. května
Zdroj: habr.com
