

Vítám vás, habr.
Pokud někdo využívá systém a narazil na problém s výkonem úložiště (I/O, spotřebované diskové místo), pak by pravděpodobnost, že se podíval na ClickHouse jako alternativu, měla směřovat k jedné. Tato tvrzení předpokládají, že se již používá externí implementace pro přijímání metrik, například nebo .
ClickHouse dobře řeší výše popsané problémy. Například po přetlaku 2TiB dat z whisper se vejdou do 300GiB. Podrobně se tímto srovnáním zabývat nebudu, článků na toto téma je dost. Kromě toho, do nedávné doby to s naším ClickHouse úložištěm nebylo úplně ideální.
Problémy se spotřebovaným místem
Na první pohled by to mělo fungovat dobře. Následujeme , vytvoříme konfiguraci pro schéma ukládání metrik (dále retention), pak vytvoříme tabulku podle doporučení vybraného backendu pro graphite-web: + nebo , v závislosti na tom, jaký stack se používá. A... spouští se bomba se zpožděním.
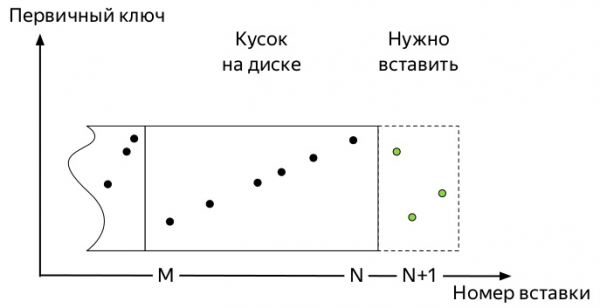
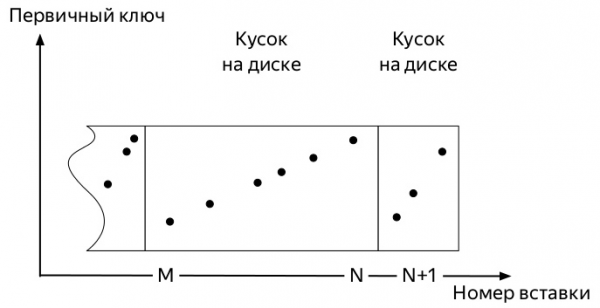
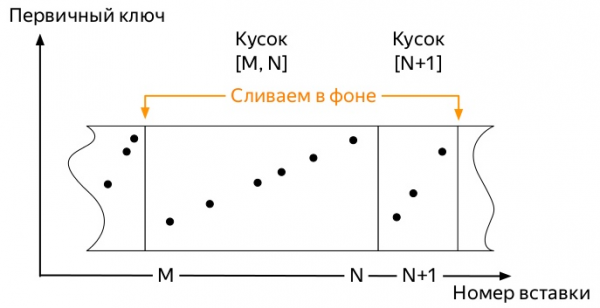
Abychom pochopili, jaká, musíme vědět, jak fungují vkládání a další životní cyklus dat v tabulkách motorů rodiny *MergeTree ClickHouse (diagramy převzaty od Alexeje Zatelepin):
- Vkládá se
blokdat. V našem případě to byly přijaté metriky.

- Každý takový blok je před zapsáním na disk seřazen podle klíče
ORDER BY, uvedeného při vytváření tabulky. - Po seřazení,
kousek(part) dat se zapíše na disk.
- Server na pozadí sleduje, aby takových kousků nebylo mnoho, a spouští pozadí
sloučení(sloučit, dále mergen).
- Server přestává spouštět mergen automaticky, jakmile data přestávají aktivně přicházet do
partice(partition), ale proces lze spustit ručně příkazemOPTIMIZE. - Pokud v partici zůstal pouze jeden kousek, pak nelze spustit mergen běžným příkazem, je nutné použít
OPTIMIZE ... FINAL
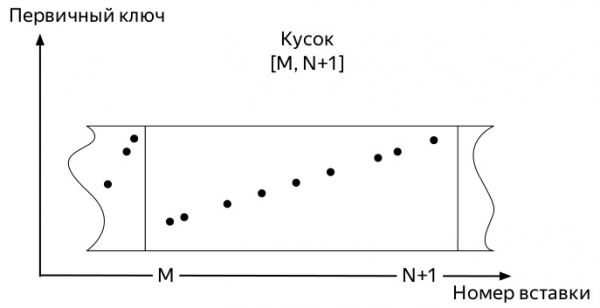
A tak, přicházejí první metriky. A ty zabírají určité místo. Následující události se mohou mírně lišit v závislosti na mnoha faktorech:
- Klíč pro partitioning může být buď velmi malý (den), nebo velmi velký (několik měsíců).
- Konfigurace retention může obsahovat několik významných prahů agregace dat uvnitř aktivní partice (kam se zapisují metriky), nebo také nemusí.
- Pokud je dat příliš mnoho, pak nejstarší kusy, které díky pozadí slučování mohou být už obrovské (při volbě neoptimálního klíče pro partitioning), se nebudou slučovat samy s novými malými kusy.
A vždy to končí stejně. Místo, které zabírají metriky v ClickHouse, pouze roste, pokud:
- se neaplikuje
OPTIMIZE ... FINALručně nebo - se nedávají data do všech partií na trvalém základě, aby dříve či později spuštěla pozadí slučování.
Druhý způsob se zdá být nejjednodušší na realizaci, a proto je špatný a byl vyzkoušen jako první.
Napsal jsem dost jednoduchý skript v pythonu, který odesílal fiktivní metriky za každý den za poslední 4 roky a spouštěl se každou hodinu pomocí cron.
Jelikož veškerá práce ClickHouse DBMS je postavena na tom, že tento systém dříve nebo později udělá veškerou pozadí práci, ale není známo kdy, nedokázal jsem se dočkat okamžiku, kdy se staré obrovské kusy uráčí začít slučování s novými malými. Bylo jasné, že je potřeba hledat způsob, jak automatizovat nucené optimalizace.
Informace v systémových tabulkách ClickHouse
Podívejme se na strukturu tabulky . To je vyčerpávající informace o každém kusu všech tabulek na serveru ClickHouse. Obsahuje mimo jiné následující sloupce:
- název DB (
database); - název tabulky (
table); - název a ID partiční (
partition&&partition_id); - kdy byl kus vytvořen (
modification_time); - minimální a maximální datum v kuse (partitioning jde podle dní) (
min_date&&max_date);
Existuje také tabulka , s následujícími zajímavými poli:
- název DB (
Tables.database); - název tabulky (
Tables.table); - věk metriky, kdy by měla být aplikována další agregace (
age);
Takže:
- Máme tabulku kusů a tabulku pravidel agregace.
- Slučujeme jejich průsečík a získáváme všechny tabulky *GraphiteMergeTree.
- Hledáme všechny partie, ve kterých:
- je více než jeden kus
- nebo nastal okamžik aplikovat další pravidlo agregace, a
modification_timeje starší než tento okamžik.
Implementace
Tento dotaz
VYBERTE
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- Nejstarší pravidlo, které může být aplikováno na
    -- partition, ale ne v budoucnu, viz (*)
    max(g.age) AS age,
    -- Počet částí v partition
    countDistinct(p.name) AS parts,
    -- Nejstarší metrika v partition se považuje za 00:00:00 následujícího dne
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Kdy by měla být partition optimalizována
    max_time + age AS rollup_time,
    -- Kdy byla nejstarší část v partition aktualizována
    min(p.modification_time) AS modified_at
Z system.parts AS p
INNER JOIN
(
    -- Všechna pravidla pro všechny tabulky *GraphiteMergeTree
    VYBERTE
        Tables.database AS database,
        Tables.table AS table,
        age
    Z system.graphite_retentions
    ARRAY JOIN Tables
    GROUP BY
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    A (p.database = g.database)
KDE
    -- Pouze aktivní části
    p.active
    -- (*) A pouze řádky, kde již měla být aplikována pravidla agregace
    A ((toDateTime(p.max_date + 1) + g.age) < now())
GROUP BY
    table,
    partition
HAVING
    -- Pouze partition, které jsou mladší než čas optimalizace
    (modified_at  1)
ORDINUJTE PODLE
    table ASC,
    partition ASC,
    age ASC
vrací každou z partition tabulek *GraphiteMergeTree, jejichž sloučení by mělo vést k uvolnění diskového prostoru. Zbývá jen malý detail: projít je všechny dotazem OPTIMIZE ... FINAL. V konečné realizaci byl také zohledněn fakt, že partition s aktivním zápisem není třeba se dotýkat.
Právě to dělá projekt . Bývalí kolegové z Yandex.Market ho vyzkoušeli v produkci, výsledek práce můžete vidět níže.
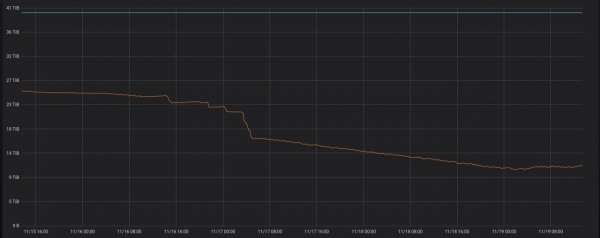
Pokud spustíte program na serveru s ClickHouse, začne jednoduše fungovat v režimu démona. Každou hodinu bude provádět dotaz, aby zkontroloval, zda se neobjevily nové partition starší tří dnů, které lze optimalizovat.
V nejbližších plánech je poskytnout alespoň deb balíčky, a pokud to bude možné, i rpm.
Na závěr
V uplynulých 9 měsících jsem ve své společnosti strávil hodně času, varu na pomezí ClickHouse a graphite-web. Byla to dobrá zkušenost, jejímž výsledkem byl možný rychlý přechod z whisper na ClickHouse jako úložiště metrik. Doufám, že tento článek je jakýmsi začátkem cyklu o tom, jaká zlepšení jsme zavedli do různých částí tohoto stacku, a co bude uděláno v budoucnu.
Na vývoj dotazu bylo spotřebováno několik litrů piva a administrativních dnů společně s , za což chci vyjádřit svou vděčnost. Také za recenzování tohoto článku.
Zdroj: habr.com
