

V tomto příspěvku bychom rádi sdíleli zajímavý způsob, jak se vypořádat s konfigurací distribuovaného systému.
Konfigurace je představena přímo v jazyce Scala bezpečným typovým způsobem. Příklad implementace je podrobně popsán. Diskutovány jsou různé aspekty návrhu, včetně dopadu na celkový vývojový proces.
()
Úvod
Vytváření robustních distribuovaných systémů vyžaduje použití správné a soudržné konfigurace na všech uzlech. Typické řešení je použít textový popis nasazení (terraform, ansible nebo něco podobného) a automaticky generované konfigurační soubory (často věnované každému uzlu/roli). Také bychom chtěli používat stejné protokoly stejné verze na všech komunikujících uzlech (jinak bychom čelili problémům s nekompatibilitou). Ve světě JVM to znamená, že alespoň knihovna pro zpracování zpráv by měla být ve stejné verzi na všech komunikujících uzlech.
Co testování systému? Samozřejmě bychom měli mít jednotkové testy pro všechny komponenty před tím, než se dostaneme k integračním testům. Abychom mohli extrapolovat výsledky testů během běhu, měli bychom zajistit, že verze všech knihoven zůstávají shodné jak v provozním, tak v testovacím prostředí.
Při provádění integračních testů je často mnohem jednodušší mít stejnou classpath na všech uzlech. Musíme se jen ujistit, že při nasazení je použita stejná classpath. (Je možné používat různé classpaths na různých uzlech, ale je obtížnější tuto konfiguraci představit a správně ji nasadit.) Takže abychom udrželi věci jednoduché, budeme uvažovat pouze o identických classpaths na všech uzlech.
Konfigurace má tendenci se vyvíjet společně se softwarem. Obvykle používáme verze k identifikaci různých
fází vývoje softwaru. Zdá se rozumné zakrýt konfiguraci pod správou verzí a identifikovat různé konfigurace pomocí nějakých štítků. Pokud existuje pouze jedna konfigurace v produkci, můžeme použít jednu verzi jako identifikátor. Někdy máme více produkčních prostředí. A pro každé prostředí můžeme potřebovat samostatnou větev konfigurace. Takže konfigurace by mohly být označeny větví a verzí, aby jedinečně identifikovaly různé konfigurace. Každý štítek větve a verze odpovídá jedné kombinaci distribuovaných uzlů, portů, externích zdrojů, verzí knihoven classpath na každém uzlu. Zde se budeme zabývat pouze jednou větví a identifikovat konfigurace trojkovým decimálním číslem verze (1.2.3), stejně jako ostatní artefakty.
V moderních prostředích se konfigurační soubory již ručně nemodifikují. Typicky generujeme
konfigurační soubory v době nasazení a poté. Takže byste se mohli ptát, proč stále používáme textový formát pro konfigurační soubory? Životaschopnou možností je umístit konfiguraci do jednotky kompilace a těžit z validace konfigurace během kompilace.
V tomto příspěvku prozkoumáme myšlenku uchovávání konfigurace v kompilovaném artefaktu.
Kompilovatelná konfigurace
V této části probereme příklad statické konfigurace. Dva jednoduché služby — echo služba a klient echo služby jsou nakonfigurovány a implementovány. Poté jsou instanciovány dva různé distribuované systémy s oběma službami. Jedna je pro konfiguraci jednoho uzlu a druhá pro konfiguraci dvou uzlů.
Typický distribuovaný systém se skládá z několika uzlů. Uzly mohou být identifikovány pomocí nějakého typu:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
nebo jednoduše
case class NodeId(hostName: String)nebo dokonce
object Singleton
type NodeId = Singleton.type
Tyto uzly mají různé role, provozují různé služby a měly by být schopny komunikovat s ostatními uzly pomocí TCP/HTTP připojení.
Pro TCP připojení je vyžadováno alespoň číslo portu. Také chceme zajistit, aby klient a server hovořili stejným protokolem. Abychom modelovali připojení mezi uzly, prohlásíme následující třídu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])where Port je jen Int v rámci povoleného rozsahu:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined typy
Viz knihovna. Stručně řečeno, umožňuje přidávat restrikce času kompilace k jiným typům. V tomto případě Int je dovoleno mít pouze 16-bitové hodnoty, které mohou reprezentovat číslo portu. Není zde požadavek používat tuto knihovnu pro tento přístup k konfiguraci. Jednoduše se to zde velmi dobře hodí.
Pro HTTP (REST) možná budeme potřebovat také cestu služby:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom typ
Abychom identifikovali protokol během kompilace, používáme funkci Scaly pro deklaraci typu argumentu Protokol který se v třídě nepoužívá. Je to takzvaný phantom typ. V běhu vzácně potřebujeme instanci identifikátoru protokolu, proto ho neukládáme. Během kompilace tento phantom typ poskytuje další typovou bezpečnost. Nemůžeme předat port s nesprávným protokolem.
Jedním z nejpoužívanějších protokolů je REST API s Json serializací:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]where RequestMessage je základní typ zpráv, které může klient poslat serveru a ResponseMessage je odpovědní zpráva ze serveru. Samozřejmě můžeme vytvořit další popisy protokolů, které specifikují komunikační protokol s požadovanou přesností.
Pro účely této příspěvku použijeme jednodušší verzi protokolu:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]V tomto protokolu je zpráva požadavku připojena k URL a odpovědní zpráva je vrácena jako prostý řetězec.
Konfigurace služby může být popsána názvem služby, kolekcí portů a některými závislostmi. Existuje několik možných způsobů, jak reprezentovat všechny tyto prvky ve Scale (například, HList, algebraické datové typy). Pro účely tohoto příspěvku použijeme Cake Pattern a reprezentujeme kombinovatelné části (moduly) jako traits. (Cake Pattern není požadavek pro tento kompilovatelný přístup k konfiguraci. Je to pouze jedna možná implementace myšlenky.)
Závislosti mohou být reprezentovány pomocí Cake Pattern jako koncové body dalších uzlů:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo služba potřebuje jen port nakonfigurovaný. A deklarujeme, že tento port podporuje echo protokol. Všimněte si, že momentálně nemusíme specifikovat konkrétní port, protože trait dovoluje deklarace abstraktních metod. Pokud použijeme abstraktní metody, kompilátor bude vyžadovat implementaci v konfiguraci instance. Zde jsme poskytli implementaci (8081) a bude použita jako výchozí hodnota, pokud ji v konkrétní konfiguraci přeskočíme.
Můžeme deklarovat závislost v konfiguraci klienta echo služby:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Závislost má stejný typ jako echoService. Konkrétně to vyžaduje stejný protokol. Tudíž si můžeme být jisti, že pokud tyto dvě závislosti propojí, budou fungovat správně.
Implementace služeb
Služba potřebuje funkci pro spuštění a plynulé ukončení. (Schopnost vypnout službu je kritická pro testování.) Opět existuje několik možností specifikace takové funkce pro danou konfiguraci (například, mohli bychom použít typové třídy). Pro tento příspěvek opět použijeme Cake Pattern. Můžeme reprezentovat službu pomocí cats.Resource který již poskytuje uchovávání a uvolnění prostředků. Abychom získali prostředek, musíme poskytnout konfiguraci a nějaký kontext běhu. Takže funkce pro spuštění služby by mohla vypadat následovně:
  typ ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
where
Nastavení— typ konfigurace, která je vyžadována tímto spouštěčem službyAddressResolver— objekt běhu, který má schopnost získávat skutečné adresy jiných uzlů (pokračujte ve čtení pro detaily).
ostatní typy pocházejí z cats:
F[_]— typ efektu (v nejjednodušším případěF[A]může být prostě() => A. V tomto příspěvku budeme používatcats.IO.)Reader[A,B]— je více či méně synonymem pro funkciA => Bcats.Resource— má způsoby, jak získat a uvolnitTimer— umožňuje spát/měřit časContextShift— analogExecutionContextApplicative— obal funkcí v efektu (skoro monáda) (nakonec jej možná vyměníme za něco jiného)
Pomocí tohoto rozhraní můžeme implementovat několik služeb. Například službu, která nic nedělá:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Viz pro implementace dalších služeb — ,
and .)
Uzel je jediný objekt, který spouští několik služeb (spuštění řetězce prostředků je povoleno vzorcem Cake):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Všimněte si, že v uzlu specifikujeme přesný typ konfigurace, který je pro tento uzel potřebný. Kompilátor nám nedovolí vytvořit objekt (Cake) s nedostatečným typem, protože každá služba deklaruje omezení k Nastavení typu. Také nebudeme schopni spustit uzel, pokud neposkytneme kompletní konfiguraci.
Řešení adres uzlů
Abychom navázali spojení, potřebujeme skutečnou hostitelskou adresu pro každý uzel. Může být známa později než jiné části konfigurace. Proto potřebujeme způsob, jak poskytnout mapování mezi id uzlu a jeho skutečnou adresou. Toto mapování je funkce:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Existuje několik možných způsobů, jak takovou funkci implementovat.
- Pokud známe skutečné adresy před nasazením, během instancování hostitelů uzlů, můžeme vygenerovat Scala kód se skutečnými adresami a poté spustit sestavení (což provede kontroly v čase kompilace a poté spustí sadu integračních testů). V tomto případě je naše mapovací funkce známa staticky a může být zjednodušena na něco jako
Map[NodeId, NodeAddress]. - Někdy získáme skutečné adresy až později, když je uzel skutečně spuštěn, nebo nemáme adresy uzlů, které ještě nebyly spuštěny. V tomto případě můžeme mít službu objevování, která je spuštěna před všemi ostatními uzly a každý uzel může inzerovat svou adresu v této službě a přihlásit se k závislostem.
- Pokud můžeme upravit
/etc/hosts, můžeme použít předdefinovaná jména hostitelů (jakomy-project-main-nodeandecho-backend) a jednoduše toto jméno přiřadit k adrese IP v čase nasazení.
V tomto příspěvku se těmto případům nevěnujeme podrobněji. Ve skutečnosti v našem příkladu budou všechny uzly mít stejnou IP adresu — 127.0.0.1.
V tomto příspěvku zvážíme dvě uspořádání distribuovaného systému:
- Uspořádání jednoho uzlu, kde jsou všechny služby umístěny na jednom uzlu.
- Uspořádání dvou uzlů, kde jsou služba a klient na různých uzlech.
Konfigurace pro je následující:
Konfigurace jediného uzlu
objekt SingleNodeConfig extends EchoConfig[String]
  s EchoClientConfig[String] s FiniteDurationLifecycleConfig
{
  případný objekt Singleton

  typ NodeId = Singleton.type
  def nodeId = Singleton


  /** Specifikace portu služby typu safe. */
  override def portNumber: PortNumber = 8088


  /** Použijeme službu poskytovanou stejným hostitelem. */
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second


  def lifetime: FiniteDuration = 10500.milliseconds
}
Zde vytváříme jednu konfiguraci, která rozšiřuje jak konfiguraci serveru, tak klienta. Také konfigurujeme řídicí prvek životního cyklu, který obvykle ukončí klienta a server po životnosti uplynutí intervalu.
Tentýž soubor implementací služby a konfigurací lze použít k vytvoření rozložení systému se dvěma samostatnými uzly. Stačí vytvořit s odpovídajícími službami:
Konfigurace dvou uzlů
  objekt NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    typ NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {

    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds

    def testMessage: String = "dolly"
  }
Podívejte se, jak specifikujeme závislost. Zmiňujeme službu poskytovanou jiným uzlem jako závislost současného uzlu. Typ závislosti je zkontrolován, protože obsahuje fantomový typ, který popisuje protokol. A v době běhu budeme mít správné id uzlu. To je jeden z důležitých aspektů navrhovaného přístupu k konfiguraci. Poskytuje nám možnost nastavit port pouze jednou a zajistit, že uvádíme správný port.
Implementace dvou uzlů
Pro tuto konfiguraci používáme přesně stejné implementace služeb. Žádné změny. Nicméně, vytváříme dvě různé implementace uzlů, které obsahují různý soubor služeb:
  objekt TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    typ Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    typ Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
První uzel implementuje server a potřebuje pouze konfiguraci serverové strany. Druhý uzel implementuje klienta a potřebuje jinou část konfigurace. Oba uzly vyžadují nějakou specifikaci životnosti. Pro účely tohoto příspěvku bude služba uzlu mít nekonečnou životnost, která může být přerušena pomocí SIGTERM, zatímco echo klient se ukončí po nastavené konečné době. Viz pro podrobnosti.
Celkový proces vývoje
Podívejme se, jak tento přístup mění způsob, jakým pracujeme s konfigurací.
Konfigurace jako kód bude zkompilována a vytvoří artefakt. Zdá se rozumné oddělit artefakt konfigurace od ostatních kódových artefaktů. Často můžeme mít množství konfigurací na stejné základně kódu. A samozřejmě můžeme mít také více verzí různých větví konfigurace. V konfiguraci můžeme vybrat konkrétní verze knihoven a to zůstane konstantní, kdykoli nasadíme tuto konfiguraci.
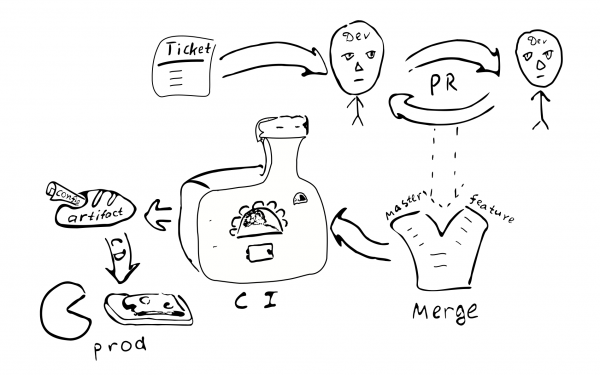
Změna konfigurace se stává změnou kódu. Měla by být pokryta stejným procesem zajištění kvality:
Ticket -> PR -> revize -> sloučení -> kontinuální integrace -> kontinuální nasazení
Tento přístup má následující důsledky:
- Konfigurace je koherentní pro konkrétní instanci systému. Zdá se, že není možné mít nesprávné spojení mezi uzly.
- Není snadné změnit konfiguraci pouze v jednom uzlu. Zdá se nerozumné se přihlašovat a měnit některé textové soubory. Takže se stává méně pravděpodobné, že dojde k odchylce v konfiguraci.
- Malé změny konfigurace se neprovádějí snadno.
- Většina změn konfigurace bude dodržovat stejný vývojový proces a projde nějakou revizí.
Potřebujeme samostatné úložiště pro produkční konfiguraci? Produkční konfigurace může obsahovat citlivé informace, které bychom chtěli udržet mimo dosah mnoha lidí. Mělo by tedy smysl mít samostatné úložiště s omezeným přístupem, které bude obsahovat produkční konfiguraci. Můžeme rozdělit konfiguraci na dvě části — jednu, která obsahuje většinu otevřených parametrů produkce, a jednu, která obsahuje tajnou část konfigurace. To by umožnilo přístup většiny vývojářů k většině parametrů, zatímco přístup k opravdu citlivým informacím by byl omezen. Je snadné toho dosáhnout pomocí mezilehlých atributů s výchozími hodnotami parametrů.
Variace
Podívejme se na výhody a nevýhody navrhovaného přístupu ve srovnání s jinými technikami správy konfigurace.
Nejprve uvedeme několik alternativ k různým aspektům navrhovaného způsobu řešení konfigurace:
- Textový soubor na cílovém stroji.
- Centralizované úložiště klíč-hodnota (jako je
etcd/zookeeper). - Složkové podprocesy, které by mohly být přeconfigurovány/znovu spuštěny bez restartování procesu.
- Konfigurace mimo artefakt a verzovací systém.
Textový soubor poskytuje určitou flexibilitu z hlediska ad-hoc oprav. Správce systému se může přihlásit do cílového uzlu, provést změnu a jednoduše restartovat službu. To nemusí být tak dobré pro větší systémy. Není po této změně zanechána žádná stopa. Změna není zkontrolována jinou osobou. Může být obtížné zjistit, co změnu způsobilo. Nebyla otestována. Z pohledu distribuovaného systému může administrátor jednoduše zapomenout aktualizovat konfiguraci v některém z dalších uzlů.
(Mimochodem, pokud nakonec bude potřeba začít používat textové konfigurační soubory, budeme muset pouze přidat parser + validator, který by mohl produkovat stejný Nastavení typ a to by bylo dostatečné k tomu, abychom začali používat textové konfigurace. Toto také ukazuje, že složitost konfigurace za běhu je o něco menší než složitost konfiguračních souborů, protože v textové verzi potřebujeme nějaký dodatečný kód.)
Centralizované úložiště klíč-hodnota je dobrý mechanismus pro distribuci meta parametrů aplikace. Zde musíme přemýšlet o tom, co považujeme za hodnoty konfigurace a co je pouze data. Vzhledem k funkci C => A => B obvykle nazýváme zřídka se měnící hodnoty C «konfigurace», zatímco často měněná data A — pouze vstupní data. Konfigurace by měla být poskytnuta funkci dříve než data. A. Vzhledem k této myšlence můžeme říci, že očekávaná frekvence změn by mohla být použita k odlišení konfiguračních dat od běžných dat. Také data typicky pocházejí z jednoho zdroje (uživatel) a konfigurace pochází z jiného zdroje (admin). Řešení s parametry, které lze měnit po inicializaci procesu, vede ke zvýšení složitosti aplikace. Pro takové parametry budeme muset řešit mechanismus jejich dodání, analýzu a validaci, zpracování nesprávných hodnot. Proto, abychom snížili složitost programu, měli bychom spíše snížit počet parametrů, které se mohou měnit za běhu (nebo je dokonce zcela eliminovat).
Z pohledu tohoto příspěvku bychom měli rozlišovat mezi statickými a dynamickými parametry. Pokud logika služby vyžaduje vzácné změny některých parametrů za běhu, pak je můžeme nazvat dynamickými parametry. Jinak jsou statické a mohly by být konfigurovány navrhovaným způsobem. Pro dynamickou rekonfiguraci mohou být potřeba jiné přístupy. Například části systému mohou být restartovány s novými konfiguračními parametry podobným způsobem jako restartování samostatných procesů distribuovaného systému.
(Můj skromný názor je vyhnout se rekonfiguraci za běhu, protože to zvyšuje složitost systému.
Bylo by možná jednodušší spolehnout se na podporu OS při restartování procesů. I když to nemusí být vždy možné.)
Jedním důležitým aspektem použití statické konfigurace, který někdy způsobuje, že lidé zvažují dynamickou konfiguraci (bez dalších důvodů), je prostoje služby během aktualizace konfigurace. Opravu, pokud musíme provést změny v statické konfiguraci, musíme restartovat systém, aby nové hodnoty nabyly účinnosti. Požadavky na prostoje se liší pro různé systémy, takže to nemusí být tak kritické. Pokud je to kritické, musíme předem naplánovat jakékoliv restarty systému. Například můžeme implementovat . V tomto scénáři, když potřebujeme restartovat systém, spusťme novou instanci systému paralelně, poté přepneme ELB na ni a necháme starý systém dokončit obsluhu existujících připojení.
Co takhle uchovávat konfiguraci uvnitř verzovaného artefaktu nebo venku? Uchovávání konfigurace uvnitř artefaktu většinou znamená, že tato konfigurace prošla stejným procesem zajištění kvality jako ostatní artefakty. Takže si může být člověk jistý, že konfigurace je dobré kvality a důvěryhodná. Naopak konfigurace v samostatném souboru znamená, že neexistují žádné stopy o tom, kdo a proč provedl změny v tomto souboru. Je to důležité? Domníváme se, že pro většinu výrobních systémů je lepší mít stabilní a vysoce kvalitní konfiguraci.
Verze artefaktu umožňuje zjistit, kdy byla vytvořena, jaké hodnoty obsahuje, jaké funkce jsou povoleny/zakázány, kdo byl odpovědný za provedení každé změny v konfiguraci. Může to vyžadovat určité úsilí udržovat konfiguraci uvnitř artefaktu a je to volba designu.
Výhody a nevýhody
Zde bychom chtěli zvýraznit některé výhody a diskutovat o některých nevýhodách navrhovaného přístupu.
Výhody
Vlastnosti kompilovatelné konfigurace kompletního distribuovaného systému:
- Statická kontrola konfigurace. To dává vysokou úroveň důvěry, že konfigurace je správná s ohledem na typové omezení.
- Bohatý jazyk konfigurace. Typicky jiné přístupy k konfiguraci jsou omezeny nejvýše na substituci proměnných.
Použitím Scaly můžete využít širokou škálu jazykových funkcí ke zlepšení konfigurace. Například můžeme použít trait k poskytnutí výchozích hodnot, objekty k nastavování různých rozsahů, můžeme se odkazovat navals definovaných pouze jednou v externím rozsahu (DRY). Je možné použít doslovné sekvence nebo instance určitých tříd (Seq,Mapa, atd.). - DSL. Scala má dobré možnosti pro psaní DSL. Tyto funkce lze použít k vytvoření konfiguračního jazyka, který je pohodlnější a přívětivější pro koncového uživatele, aby byla konečná konfigurace alespoň čitelná pro uživatele oboru.
- Integrita a koherence napříč uzly. Jednou z výhod mít konfiguraci pro celý distribuovaný systém na jednom místě je, že všechny hodnoty jsou definovány striktně jednou a následně znovu použity ve všech místech, kde je potřebujeme. Také bezpečné deklarace portů zajišťují, že ve všech možných správných konfiguracích uzly systému hovoří stejným jazykem. Existují explicitní závislosti mezi uzly, což ztěžuje zapomenout na poskytnutí některých služeb.
- Vysoká kvalita změn. Celkový přístup přenášení změn konfigurace prostřednictvím běžného PR procesu vytváří vysoké standardy kvality také v konfiguraci.
- Současné změny konfigurace. Kdykoli provedeme změny v konfiguraci, automatické nasazení zajišťuje, že všechny uzly jsou aktualizovány.
- Zjednodušení aplikace. Aplikace nemusí analyzovat a validovat konfiguraci a zpracovávat nesprávné hodnoty konfigurace. To zjednodušuje celkovou aplikaci. (Některé zvýšení složitosti je v samotné konfiguraci, ale jedná se o vědomý kompromis ve prospěch bezpečnosti.) Je docela snadné vrátit se k běžné konfiguraci — stačí přidat chybějící části. Je snazší začít s kompilovanou konfigurací a odložit implementaci dalších částí na pozdější dobu.
- Verzovaná konfigurace. Vzhledem k tomu, že změny konfigurace sledují stejný vývojový proces, výsledkem je artefakt s unikátní verzí. Umožňuje nám přepnout konfiguraci zpět, pokud je to nutné. Můžeme nasadit i konfiguraci, která byla použita před rokem, a bude fungovat přesně stejným způsobem. Stabilní konfigurace zlepšuje předvídatelnost a spolehlivost distribuovaného systému. Konfigurace je fixována v době kompilace a nelze ji snadno manipulovat v produkčním systému.
- Modularita. Navrhovaný rámec je modulární a moduly lze kombinovat různými způsoby, aby
podporovaly různé konfigurace (nastavení/rozvržení). Konkrétně je možné mít malé uspořádání s jedním uzlem a velké víceuzlové nastavení. Je rozumné mít více produkčních rozložení. - Testování. Pro testovací účely lze implementovat simulovanou službu a použít ji jako závislost bezpečným způsobem. Je možné udržovat několik různých testovacích rozložení s různými částmi nahrazenými simulacemi souběžně.
- Integrační testování. Někdy je v distribuovaných systémech obtížné provádět integrační testy. Použitím popsaného přístupu k bezpečné konfiguraci celého distribuovaného systému můžeme spustit všechny distribuované části na jednom serveru kontrolovaným způsobem. Je snadné emulovat situaci,
když je jedna z služeb nedostupná.
Nevýhody
Přístup ke kompilované konfiguraci se liší od „normální“ konfigurace a nemusí vyhovovat všem potřebám. Zde jsou některé nevýhody kompilované konfigurace:
- Statická konfigurace. Může být nevhodná pro všechny aplikace. V některých případech je třeba rychle opravit konfiguraci v produkci a obejít všechna bezpečnostní opatření. Tento přístup to ztěžuje. Po provedení změny v konfiguraci je nutná kompilace a nové nasazení. To je jak výhodou, tak zátěží.
- Generování konfigurace. Pokud je konfigurace generována nějakým automatizačním nástrojem, tento přístup vyžaduje následnou kompilaci (která může také selhat). Může to vyžadovat další úsilí o integraci tohoto dodatečného kroku do systému sestavování.
- Nástroje. Dnes existuje mnoho nástrojů, které rely na textových konfiguracích. Některé z nich
nebudou použitelné, když je konfigurace kompilována. - Je třeba změnit myšlení. Vývojáři a DevOps jsou zvyklí na textové konfigurační soubory. Myšlenka na kompilaci konfigurace se jim může zdát podivná.
- Před zavedením kompilovatelné konfigurace je zapotřebí procesu vysoce kvalitního vývoje softwaru.
Existují některá omezení implementovaného příkladu:
- Pokud poskytneme další konfiguraci, která není vyžadována implementací uzlu, kompilátor nám nepomůže odhalit chybějící implementaci. To lze řešit použitím
HListnebo ADT (case classes) pro konfiguraci uzlu místo vlastností a Cake Patternu. - Musíme poskytnout nějaké boilerplate v konfiguračním souboru: (
balíček,import,objektdeklarace;
override def's pro parametry, které mají výchozí hodnoty). To může být částečně vyřešeno pomocí DSL. - V tomto příspěvku nepokrýváme dynamickou rekonstrukci clusterů podobných uzlů.
Závěr
V tomto příspěvku jsme se zabývali myšlenkou reprezentace konfigurace přímo v zdrojovém kódu způsobem, který je typově bezpečný. Tento přístup lze využít v mnoha aplikacích jako náhradu za konfigurační soubory založené na XML a jiných textových formátech. Přestože byl náš příklad implementován ve Scalě, mohl by být také přeložen do dalších kompilovatelných jazyků (jako Kotlin, C#, Swift atd.). Tento přístup můžete vyzkoušet v novém projektu a pokud nebude vhodný, přejít na staromódní způsob.
Samozřejmě, kompilovatelná konfigurace vyžaduje vysoce kvalitní vývojový proces. Na oplátku slibuje poskytnout stejně kvalitní a robustní konfiguraci.
Tento přístup by mohl být rozšířen různými způsoby:
- Můžete použít makra pro provádění validace konfigurace a selhat během kompilace v případě, že dojde k porušení jakýchkoli omezení obchodní logiky.
- Mohl by být implementován DSL pro reprezentaci konfigurace způsobem přátelským k uživatelskému prostředí.
- Dynamické řízení zdrojů s automatickými úpravami konfigurace. Například při úpravě počtu uzlů v clusterech bychom mohli chtít (1) aby uzly získaly mírně upravenou konfiguraci; (2) aby správce clusteru obdržel informace o nových uzlech.
Děkuji
Rád bych poděkoval Andreji Saksonovovi, Pavlu Popovovi a Antonu Nehaevovi za inspirativní zpětnou vazbu k návrhu tohoto příspěvku, která mi pomohla učinit jej jasnějším.
Zdroj: habr.com
