

Probereme, proč jsou CI nástroje a CI zcela odlišné věci.
Jaký problém má CI řešit, odkud nápad pochází, jaké jsou poslední důkazy o tom, že to funguje, jak pochopit, že máte skutečnou praxi a ne pouze nainstalovaný Jenkins.
Nápad udělat prezentaci o Continuous Integration přišel už před rokem, když jsem chodil na pohovory a hledal práci. Mluvil jsem s 10-15 společnostmi, z nichž jen jedna dokázala srozumitelně odpovědět, co to CI je, a vysvětlit, jak pochopili, že to u nich chybí. Ostatní jen hlásali nesmysly o Jenkinsu 🙂 No máme Jenkins, dělá buildy, CI! Na prezentaci se pokusím vysvětlit, co vlastně Continuous Integration je a proč Jenkins a podobné nástroje mají k tomu velmi slabý vztah.
A co obvykle člověku přijde na mysl, když slyší CI? Většině lidem se vybaví Jenkins, Gitlab CI, Travis atd.
I když vyhledáme, zobrazí se nám tyto nástroje.
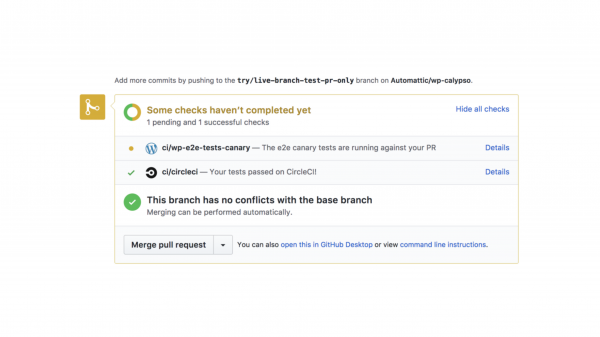
Pokud se ptáte známých, hned po vyjmenování nástrojů vám vysvětlí, že CI je, když se v Pull Requestu pro commit provádí build a testy.
Continuous Integration není o nástrojích, není o buildování a testech ve větvi! Continuous Integration je praxe velmi časté integrace nového kódu a k jejímu použití vůbec není nutné budovat Jenkinsy, GitLaby a podobně.
Než se podíváme na to, jak vypadá plnohodnotný CI, pojďme se nejprve ponořit do kontextu lidí, kteří to vymysleli, a prožít bolest, kterou se snažili vyřešit.
A řešili bolest spolupráce v týmu!
Pojďme se podívat na příklady, s jakými obtížemi se vývojáři potýkají při týmovém vývoji. Máme projekt, master větev v gitu a dva vývojáře.
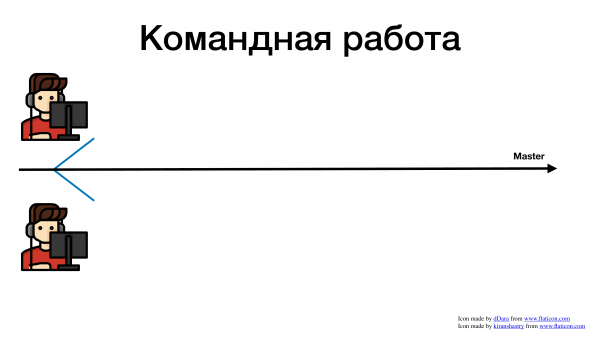
A začali pracovat jako všichni, na co jsou zvyklí. Vzali úkol v JIRA, založili feature branch a píší kód.
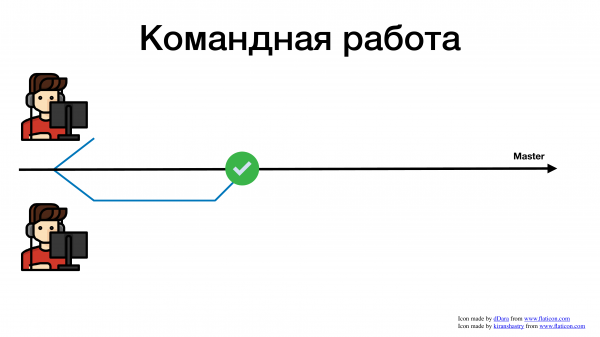
Jeden dokončil funkci dříve a sloučil do masteru.
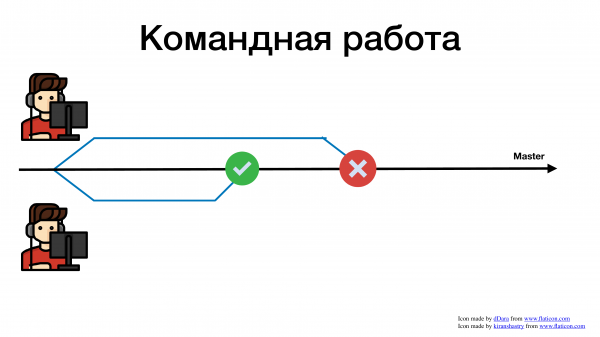
Druhému to zabralo více času, sloučil se později a dostal konflikt. Teď místo toho, aby psal potřebné funkce pro byznys, tráví vývojář svůj čas a úsilí řešením konfliktů.
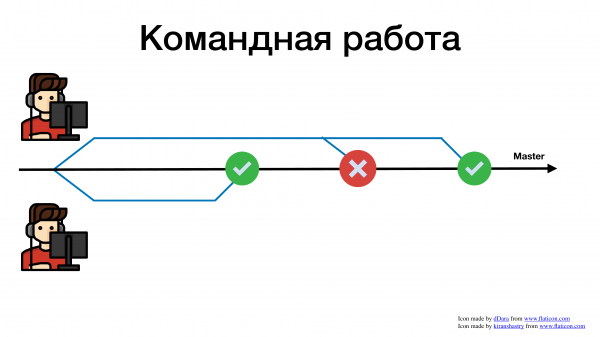
Čím složitější je spojit svou funkci se společným masterem, tím více času na to potřebujeme. A to jsem ukázal ještě docela jednoduchý příklad. To je příklad, kde jsou vývojáři jen dva. A představte si, pokud 10, 15 nebo 100 lidí ve firmě píše do jednoho repozitáře. Zbláznili byste se, když byste měli vyřešit všechny tyto konflikty.
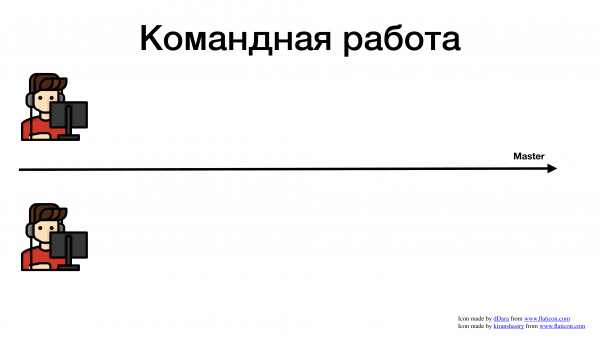
Existuje trochu jiný případ. Máme mastera a několik vývojářů, kteří něco dělají.
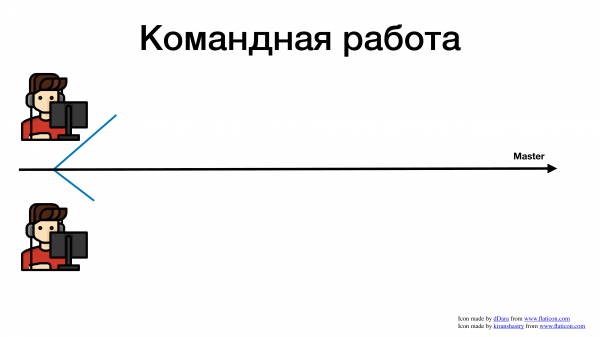
Vytvořili si každý větev.
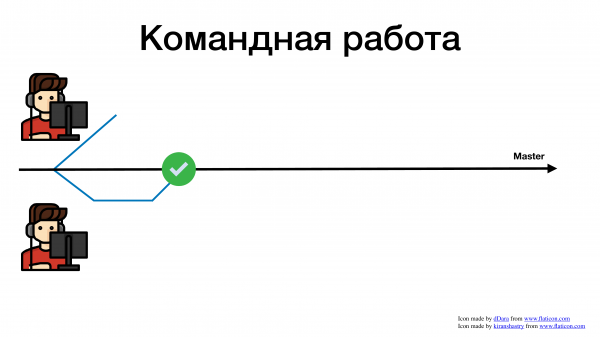
Jeden se sloučil, vše bylo v pořádku, splnil úkol.
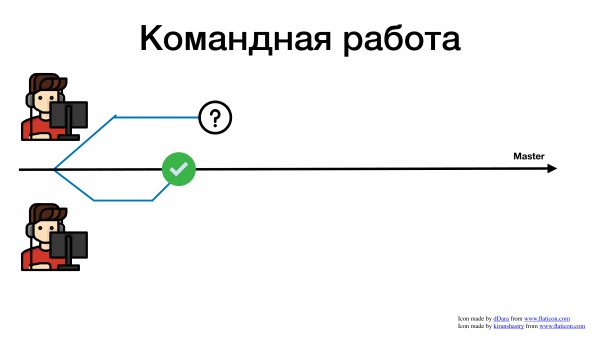
Druhý vývojář mezitím splnil svůj úkol. Řekněme, že ho dal na revizi. Ve mnoha firmách existuje praxe – revize. Na jedné straně je to dobrá a užitečná praxe, na druhé straně nás to v mnoha ohledech zpomaluje. Nezabíhejme do toho, ale je to výborný příklad, kam může vést špatná historie s revizemi. Dal jste pull request na revizi. Vývojář nemá už co dělat. Co začne dělat? Začne brát další úkoly.
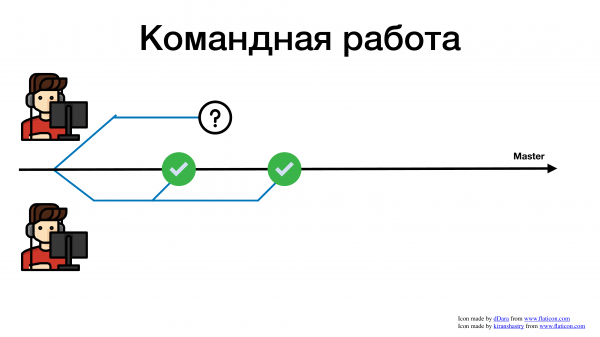
Za tu dobu druhý vývojář ještě něco stihl udělat.
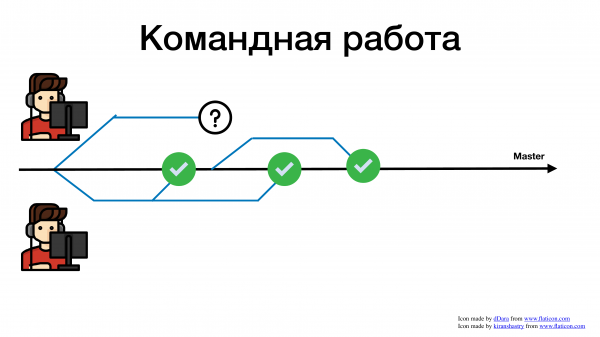
První splnil třetí úkol.
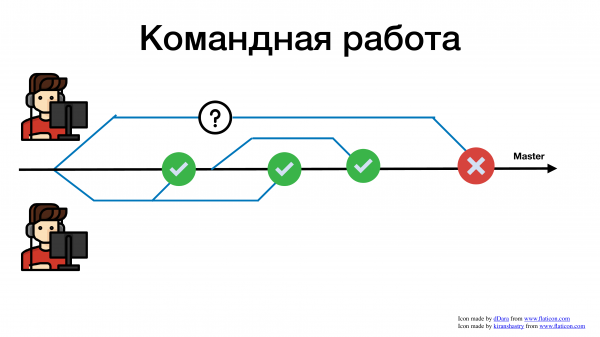
A po delší době bylo jeho revize zkontrolováno a pokouší se sloučit. A co se stane? Chytá obrovské množství konfliktů. Proč? Protože zatímco jeho pull request visel na revizi, v kódu už se hodně změnilo.
Kromě historie konfliktů existuje i příběh s komunikací. Dokud má vaše větev visící na revizi, dokud něco čeká, dokud dlouho vyvíjíte funkci, přestáváte sledovat, co se ještě mění v kódové základně vašeho servisu. Možná, že to, co teď se snažíte vyřešit, již včera vyřešili a můžete vzít a znovu použít nějakou metodu. Ale to neuvidíte, protože vždy pracujete se zastaralou větví. A tato zastaralá větev vždy vede k tomu, že budete muset řešit merge konflikt.
Vychází to tak, že pokud pracujeme v týmu, tj. pokud v repozitáři nepracuje jen jedna osoba, ale 5-10 lidí, tím déle nebudeme přidávat svůj kód do masteru, tím více trpíme tím, že nakonec musíme něco sloučit. A čím více máme konfliktů a čím starší verzi používáme, tím více máme problémů.
Společně něco dělat – to je bolest! Vždy si navzájem překážíme.
Na tento problém se upozorňovalo před více než 20 lety. První zmínka o praxi Continuous Integration se našla v extrémním programování.
Extrémní programování je první agilní framework. Stránka se objevila v roce 96. Byla myšlenka využívat určité praktiky programování, plánování a podobně, aby vývoj byl co nejflexibilnější, abychom mohli rychleji reagovat na nějaké změny a požadavky našich klientů. A již před 24 lety se začali potýkat s tím, že pokud děláte něco velmi dlouho a bokem, trávíte tím více času, protože máte konflikty.
Nyní si rozebere slovní spojení „Continuous Integration“ po jednotlivých slovech. Pokud bychom to přeložili doslovně, dostáváme nepřetržitou integraci. Ale jak moc je nepřetržitá, to není úplně jasné, je to spíše přerušovaná. A také není jasné, jak moc je integration.
A proto vám nyní přináším citace z extrémního programování. Obě slova si rozebere jednotlivě.
Integration — Jak jsem již řekl, usilujeme o to, aby každý inženýr pracoval s nejaktuálnější verzí kódu, aby co nejčastěji přidával svůj kód do hlavní větve, aby to byly malé větve. Protože pokud jsou velké, můžeme snadno uváznout na týden s merge konflikty. Obzvlášť když máme dlouhý vývojový cyklus typu waterfall, kde vývojář odejde na měsíc kódovat nějakou obrovskou funkci. A v etapě integrace se může zaseknout po velmi dlouhou dobu.
Integration — to je, když vezmeme svou větev a integrujeme ji s master, mergeujeme ji. Existuje ultimátní varianta, kdy transbase developer cílíme na to, že hned píšeme do master bez jakýchkoli zbytečných větví.
Obecně, integration — to je vzít svůj kód a dostat ho do master.
Co se zde myslí slovem „continuous“, co to vlastně znamená nepřetržitost? Praxe znamená, že vývojář se snaží co nejrychleji integrovat svůj kód. To je jeho cíl při vykonávání jakékoliv úlohy – dostat svůj kód do masteru co nejrychleji. V ideálním světě by to vývojáři dělali každých pár hodin. Tedy vezmete malou úlohu, sloučíte ji do masteru. Vše je skvělé. O to usilujete. A to je třeba dělat nepřetržitě. Jakmile něco uděláte, hned to zařadíte do masteru.
A vývojář, který něco dělá, nese odpovědnost za to, co udělal, aby to fungovalo a nic nezdokumentovalo. Zde obvykle vyvstává otázka s testy. Chceme spustit nějaké testy na našem commitu, na našem merge, abychom si byli jisti, že to funguje. A zde vám může pomoci Jenkins.
Ale pokud jde o myšlenky: pojďme, aby změny byly malé, a pojďme, aby úlohy byly malé, a pojďme, abychom úlohu udělali a hned se snažili nějak ji sloučit do masteru – tady vám žádný Jenkins nepomůže. Protože Jenkins vám pomůže výhradně spustit testy.
Můžete se obejít i bez nich. To vám nijak nepřekáží. Protože cílem praxe je slučovat se co nejčastěji, abyste neplýtvali obrovským množstvím času na nějaké konflikty v budoucnosti.
Představme si, že máme rok 2020, a z nějakého důvodu bez internetu. A pracujeme lokálně. Nemáme Jenkins. To je v pořádku. Stále si můžete vytvořit lokální větev. Napsali jste nějaký kód. Úkol jste splnili za 3-4 hodinky. Přepnuli jste se na master, udělali git pull, sloučili tam svou větev. Hotovo. Pokud to děláte často – gratuluji, máte Continuous Integration!
Jaké jsou v současném světě důkazy, že na to stojí za to vynaložit síly? Protože celkově je to obtížné. Pokud se pokusíte takto pracovat, zjistíte, že se nyní budete muset věnovat nějakému plánování, budete muset více času věnovat dekompozici úloh. Protože pokud budete dělat velké úkoly, nebudete se moci rychle sloučit a tudíž se dostanete do nesnází. Praktiky už mít nebudete.
A to bude drahé. Hned od zítřka nebude možné pracovat s Continuous Integration. Všichni si na to budete velmi dlouho zvykat, velmi dlouho se budete učit, jak rozdělovat úkoly, velmi dlouho se budete přeučovat na praxi revize, pokud ji máte. Naším cílem je, aby se to dnes sloučilo. A pokud děláte revizi po dobu tří dnů, máte problémy a Continuous Integration nemáte.
Ale máme nějaké aktuální důkazy, které nám říkají, že investovat do této praxe má smysl?
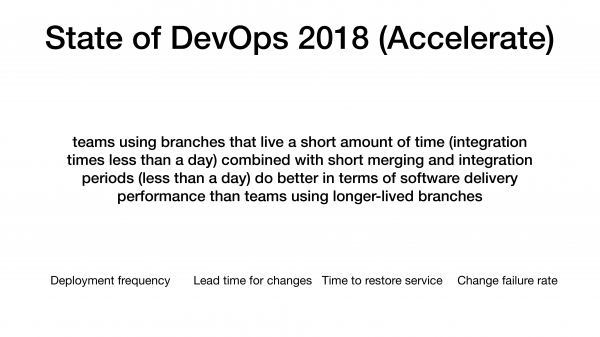
První, co mě napadlo, je State of DevOps. Je to výzkum, který lidé provádějí již 7 let. Teď to dělají jako nezávislá organizace, ale pod Google.
A jejich výzkum v roce 2018 ukázal korelaci mezi společnostmi, které se snaží používat krátkodobé větve, které se rychle integrují a často integrují, a mají lepší výsledky výkonnosti IT.
Jaké jsou to ukazatele? Jsou to 4 metriky, které shromažďují ze všech společností v jejich dotaznících: frekvence nasazení, doba potřebná na změny, doba na obnovu služeb, míra selhání změn.
A za prvé, je zde tato korelace, víme, že společnosti, které se často slučují, mají tyto metriky mnohem lepší. A mají rozdělení společností do několika kategorií: jsou to pomalé společnosti, které produkují něco pomalu, střední výkonnost, vysoká výkonnost a elita. Elita – to jsou Netflix, Amazon, kteří jsou velmi rychlí, všechno dělají rychle, krásně a kvalitně.
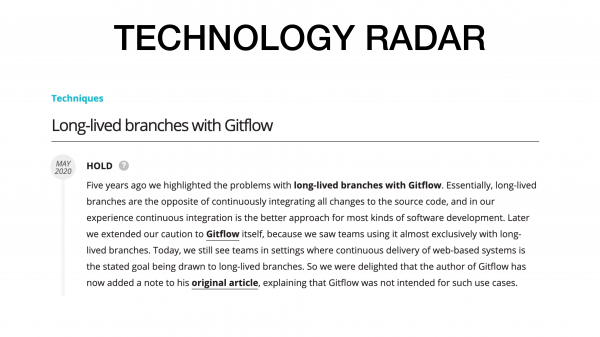
Druhá věc, která se stala před měsícem. V Technology Radar se objevila skvělá poznámka o Gitflow. Gitflow se liší od všech ostatních tím, že jeho větve žijí dlouho. Existují release větve, které žijí dlouho, a feature větve, které také žijí dlouho. Tato praxe v Technology Radar byla přeřazena do HOLD. Proč? Protože lidé se potýkají s bolestí integrace.
Pokud vaše větev žije velmi dlouho, zasekne se, ztratí se, začínáme trávit více času na tom, abychom do ní provedli nějakou změnu.
A nedávno autor Gitflow uvedl, že pokud se snažíte o Continuous Integration a chcete provádět integrace co nejčastěji, Gitflow není dobrý nápad. Ve své článku také poznamenal, že pokud máte backend, kde se k tomu můžete přiblížit, Gitflow pro vás není nutný, protože vás zpomalí a přinese vám problémy s integrací.
To neznamená, že Gitflow je špatný a neměli byste ho používat. Je vhodný pro jiné případy. Například když potřebujete udržovat více verzí služby či aplikace, tedy když potřebujete poskytovat podporu po delší dobu.
Ale pokud se zeptáte lidí, kteří takové služby podporují, uslyšíte spoustu bolesti ohledně toho, že verze byla 3.2, která byla před 4 měsíci, a tento oprava se do ní nedostala, a nyní, abyste ji přidali, musíte udělat spoustu změn. A tak se znovu ocitají v patové situaci, kdy týdny bojují s tím, aby vzali a sloučili nějakou novou funkci.
Jak správně poznamenal Alexander Kovalev v chatu, korelace neznamená kauzální vztah. To je pravda. Jen proto, že máte Continuous Integration, neznamená, že všechny metriky budou skvělé. Existuje ale pozitivní korelace, že pokud je jedno, pravděpodobně je i druhé. Není to jisté, ale pravděpodobné. Je to jen korelace.
Zdá se, že už něco děláme, vypadá to, že už se slučujeme, ale jak zjistit, že máme Continuous Integration, že se slučujeme dostatečně často?
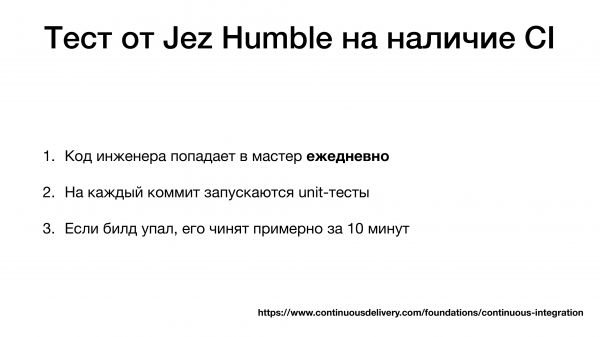
Jez Humble je autorem Handbook, Accelerate, webu Continuous Delivery a knihy „Continuous Delivery“. Navrhuje takový test:
- Kód inženýra se dostává do masteru každý den.
- Na každý commit spouštíte unit testy.
- Build v masteru spadl, opravil se přibližně za 10 minut.
Navrhuje použít takový test, abyste se ujistili, že tuto praxi opravdu máte.
To poslední považuji za poněkud sporné. Tj. pokud to můžete opravit za 10 minut, znamená to, že máte Continuous Integration, to mi zní poněkud divně, ale dává to smysl. Proč? Protože pokud se mícháte často, znamená to, že vaše změny jsou drobné. Pokud malá změna způsobí, že se vám rozpadne build mastera, můžete rychle najít příklad, protože změna je maličká. Měli jste malý merge, ve kterém se změnilo 20–30 řádků. A odpovídajícím způsobem můžete rychle pochopit, v čem byl problém, protože změny jsou drobné, máte velmi malou oblast hledání problému.
A i když se nám po vydání rozpadne prod, pokud máme praxi Continuous Integration, je pro nás mnohem snazší jednat, protože změny jsou drobné. Ano, to ovlivní plánování. Bude to bolet. A asi největší problém v této praxi spočívá v tom, zvyknout si rozdělit úkoly, tj. jak udělat něco za pár hodin a zároveň projít revizí, pokud ji máte. Revize je samostatná bolest.
Unit testy jsou prostě pomocník, který vám pomáhá pochopit, zda vaše integrace proběhla úspěšně, zda se nic nezlomilo. Podle mě to není úplně povinný bod, protože smyslem praxe to není.
To je stručné shrnutí o Continuous Integration. To je všechno, co v této praxi existuje. Jsem připraven na otázky.
Stručně ještě jednou shrnu:
- Continuous Integration – to není Jenkins, to není Gitlab.
- To není nástroj, je to praxe, že co nejčastěji mícháme náš kód do masteru.
- Děláme to, abychom se vyhnuli obrovské bolesti, která vzniká s mícháním v budoucnu, tj. nyní zažíváme malou bolest, abychom se vyhnuli velké v budoucnosti. V tom je celý smysl.
- Z pohledu prochází komunikace prostřednictvím kódu, ale to velmi vzácně vidím, ale pro to byla také zamýšlena.
Otázky
Co dělat s nedekomponovanými úkoly?
Dekomponovat. V čem je problém? Můžete uvést příklad, že je úkol a ten není dekomponovatelný?
Existují takové úkoly, které nelze dekomponovat, od slova "vůbec", například ty, které vyžadují velmi hlubokou odbornost a které mohou být skutečně řešeny po měsíci, než dosáhnou nějakého přijatelného výsledku.
Pokud jsem tě správně pochopil, existuje nějaký velký a složitý úkol, jehož výsledek uvidíme až za měsíc?
Ano, je to správně. Výsledek budeme moci posoudit nejdříve za měsíc.
Dobře. To obecně není problém. Proč? Protože v tomto případě, když mluvíme o větvích, nemluvíme o větvi s funkcí. Funkce mohou být velké a složité. Mohou se týkat mnoha komponentů. A možná je nemůžeme udělat zcela v jedné větvi. To je v pořádku. Musíme tuto záležitost jen rozdělit. Pokud funkce není úplně hotová, neznamená to, že některé části jejího kódu nelze sloučit. Řekněme, že jsi přidal migraci a uvnitř funkce jsou nějaké fáze. Například máš fázi – udělat migraci, přidat novou metodu. A tyto věci už můžeš sloučit denně.
Dobře. Jaký má tedy smysl?
Jaký má smysl sloučit malé věci denně?
Ano.
Pokud ti něco rozbilo, vidíš to hned. Máš malý kousek, který něco rozbil, a je snazší to opravit. Smysl je v tom, že sloučit malý kousek teď je mnohem snazší než sloučit něco velkého za několik týdnů. A třetí smysl je v tom, že ostatní inženýři budou pracovat s aktuální verzí kódu. Uvidí, že tady byly přidány nějaké migrace a tady se objevila nějaká metoda, kterou mohou také chtít použít. Všichni uvidí, co se v kódu děje. Právě kvůli těmto třem důvodům se tato praxe dělá.
Děkuji, otázka je uzavřena!
(Oleg Soroka) Můžu se přidat? Řekl jsi to správně, chci jen přidat jednu větu.
Tak.
Při Continuous Integration se kód slučuje do hlavní větve ne tehdy, když je funkce úplně hotová, ale tehdy, když se zastavil rozpad buildu. A nebojte se commitovat do masteru, kolikrát chcete za den. Druhý aspekt – pokud z nějakého důvodu nemůžete rozdělit měsíční úkol na úkoly alespoň po třech dnech, nemluvě o třech hodinách, máte obrovský problém. A skutečnost, že nemáte Continuous Integration, je menší z těchto problémů. To znamená, že máte problémy s architekturou a inženýrské praktiky jsou na nule. Protože i když jde o výzkum, je to stejně třeba prezentovat formou hypotéz nebo cyklů.
Hovořili jsme o 4 metrikách, které oddělují úspěšné společnosti od těch, co zaostávají. Ještě se musíme dostat k těmto 4 metrikám. Pokud průměrná úloha trvá měsíc, měl bych se nejprve soustředit na tuto metriku. Zkrátil bych ji nejprve na 3 dny. A až poté bych začal přemýšlet o Continuous.
Správně tě chápu, že si myslíš, že investice do inženýrských praktik, když máš jakoukoli úlohu na měsíc, zatím nedává smysl?
Máš Continuous Integration. A tam je taková věc, že za 10 minut buď opravíš chybu, nebo ji vrátíš zpět. Představ si, že jsi ji nasadil. Dokonce máš i continuous deployment, nasadil jsi ji na prod a až poté sis všiml, že něco nefunguje. A musíš ji vrátit zpět, a už došlo k migraci databáze. Už máš schéma databáze v nové verzi, navíc už proběhla nějaká záloha, navíc byly zapsány nějaké údaje.
A jakou alternativu máš? Pokud vracíš kód zpět, pak už nemůže pracovat s touto aktualizovanou databází.
Databáze se posouvá pouze vpřed, ano.
Lidé, kteří mají špatnou inženýrskou praxi, pravděpodobně ani nečetli tlustou knihu o ... Co dělat se zálohou? Pokud se obnovuješ ze zálohy, znamená to, že ztrácíš data, která byla shromážděna od té doby. Například jsi pracoval tři hodiny s novou verzí databáze, už se zaregistrovali uživatelé. Vrátíš se k staré záloze, protože se s novou verzí schéma nefunguje, čímž tyto uživatele ztratíš. A jsou nespokojení, nadávají.
Aby ovládli celý soubor praktik podporujících Continuous Integration a Continuous Delivery, nestačí se pouze naučit programovat.... Za prvé, může jich být velmi mnoho, což bude nepraktické. Navíc jsou tu i další praktiky, jako je Scientific. Existuje taková praktika, kterou popularizoval GitHub. To se děje, když současně běží starý a nový kód. To je, když vytváříte nedokončenou funkci, ale ta může vracet nějakou hodnotu: buď jako funkci, nebo jako Rest API. Spouštíte jak nový kód, tak starý kód a porovnáváte rozdíl mezi nimi. A pokud je nějaký rozdíl, logujete tuto událost. Tímto způsobem víte, že vaše nová funkce je připravena být nasazena na starou, pokud během určité doby nedošlo k rozdílu mezi těmito dvěma.
Takových praktik jsou stovky. Doporučil bych začít s transbase development. Není to 100% o Continuous Integration, ale praktiky jsou stejné, jedna bez druhé špatně žije.
Uvedl jsi transbase development jako příklad, kde se dají vidět praktiky, nebo navrhuješ lidem začít používat transbase development?
Podívat se, protože používat je nebudou moci. Aby je mohli používat, je potřeba si mnoho věcí přečíst. A když má člověk otázku: „Co dělat s funkcí, která trvá měsíc“, znamená to, že si nečetl o transbase development. A já bych to zatím nedoporučoval. Doporučil bych se zaměřit výhradně na téma, jak správně architektonicky rozdělovat velké úkoly na menší. V tom je podstata dekompozice.
Dekompozice je jedním z nástrojů architekta. Nejprve děláme analýzu, poté dekompozici, pak syntézu, a pak integraci. A tímto způsobem nám vše do sebe zapadá. A k Continuous Integration je třeba ještě dospět skrze dekompozici. Na první etapě se objevují otázky, a my už mluvíme o čtvrté etapě, tj. čím častěji provádět integraci, tím lépe. Je ještě brzy na to, abychom ji prováděli, nebylo by špatné nejprve rozčlenit svůj monolit.
Je potřeba nakreslit několik šipek a čtverců na nějakém schématu. Nemůžeš říct, že teď ukážu architektonické schéma nové aplikace a ukážu jeden čtverec, ve kterém je zelené tlačítko pro aplikaci. V každém případě bude více čtverců a šipek. Na jakémkoli schématu, které jsem viděl, jich bylo více než jeden. A dekompozice už na úrovni grafického zobrazení probíhá. Proto mohou být čtverce nezávislé. Pokud ne, mám velké otázky k architektovi.
Je otázka z chatu: „Pokud je revize povinná a trvá dlouho, někde den a více?“.
Máte problémy s praxí. Revize by neměla trvat den a více. To je příběh k předchozí otázce, jen trochu měkčí. Pokud revize trvá den, znamená to, že pravděpodobně jde o revizi nějaké velmi velké změny. To znamená, že by se mělo dělat méně. V transbase development, které doporučil Oleg, existuje taková věc, která se nazývá continuous review. Její myšlenka je, že děláme záměrně tak malé pull requesty, protože se snažíme neustále slučovat a postupně. A proto pull request mění jednu abstrakci nebo 10 řádků. Díky tomu nám revize zabere pár minut.
Pokud revize trvá den a více, znamená to, že něco není v pořádku. Za prvé, možná máte nějaké problémy s architekturou. Nebo se jedná o velký kus kódu, například na 1 000 řádků. Nebo máte tak složitou architekturu, že ji člověk nedokáže pochopit. To je problém trochu bokem, ale také se s tím bude muset něco udělat. Možná vůbec není potřeba revize. Nad tím byste měli také přemýšlet. Revize je něco, co vás brzdí. Dává své výhody celkově, ale musíte pochopit, proč to děláte. Je to pro vás způsob, jak rychle předat informace, je to váš způsob, jak stanovit uvnitř nějaké standardy, nebo co? Proč to potřebujete? Protože revizi je potřeba dělat buď velmi rychle, nebo ji úplně zrušit. Je to jako transbase development - velmi hezký příběh, ale jen pro rozvinuté lidi.
Pokud jde o 4 metriky, doporučil bych je přece jenom odstranit, abychom pochopili, k čemu to vede. Podívat se na čísla, podívat se na obrázek, jak moc je to špatné.
(Dmitrij) Jsem připraven s tebou diskutovat o této záležitosti. Čísla a metriky – to vše je skvělé, praxe je skvělá. Ale musíme pochopit, zda je to pro podnikání potřebné. Existují podniky, které nepotřebují tak rychlé změny. Znám firmy, ve kterých není možné provádět změny každých 15 minut. A ne proto, že by byly špatné. Je to takový životní cyklus. A abyste mohli dělat funkci branches, funkci toggle, potřebujete hluboké znalosti.
Je to složité. Pokud se chcete dozvědět více o historii funkce toggle, doporučuji to. . A existuje skvělý článek od Martina Fowlera o funkci toggle: o tom, jaké typy existují, životní cykly atd. Funkce toggle – to je složité.
A přesto jsi neodpověděl na otázku: „Je Jenkins potřeba nebo ne?“
Jenkins ve skutečnosti není potřeba. Pokud to myslím vážně, pak nástroje: Jenkins, Gitlab vám přinesou pohodlí. Uvidíte, jestli se sestava povedla nebo ne. Mohou vám pomoci, ale praktiku vám nezajistí. Mohou vám pouze dát kroužek – OK, ne OK. A to, pokud ještě píšete testy, protože pokud nejsou testy, je to téměř bezvýznamné. Takže je to potřeba, protože – je to pohodlnější, ale celkově můžete žít i bez něj, moc neztratíte.
Tedy, pokud máte praxe, znamená to, že ho nepotřebujete?
Přesně tak. Doporučuji test Jez Humble. Tam mám dvojí postoj k poslednímu bodu. Ale celkově, pokud máte tři věci, neustále se slučujete, spouštíte testy na commity v masteru, rychle opravujete build v masteru, pak možná už nic jiného nepotřebujete.
Zatímco čekáme na otázky od účastníků, mám otázku. Hovořili jsme o produktu kódu. Používal jsi také pro infrastrukturní kód? Je to stejný kód, má stejné principy a stejný životní cyklus, nebo tam jsou jiné životní cykly a principy? Obvykle, když všichni mluví o Continuous Integration a Development, zapomínají na to, že existuje také infrastrukturní kód. A v poslední době ho přibývá. Měli bychom tam přenést všechna tato pravidla?
Ani ne to, že bychom měli, to by bylo skvělé, protože to určitě usnadní život. Jakmile pracujeme s kódem, ne se skripty na bash, ale máme normální kód.
Stop-stop, skript na bash – to je také kód. Nedotýkej se mé staré lásky.
Dobře, nebudu ti narušovat vzpomínky. Mám k bash osobní averzi. Neustále se rozpadá, a to velmi nevzhledně a strašidelně. A padá nepředvídatelně, a proto ho nemám rád. Ale dobře, předpokládejme, že máš kód v bash. Možná opravdu nerozumím a existují tam normální testovací frameworky. Prostě se v tom nevyznám. A získáváme stejné výhody.
Jakmile pracujeme s infrastrukturou jako s kódem, dostáváme stejné problémy jako vývojáři. Před několika měsíci jsem se setkal se situací, kdy mi kolega poslal pull request na 1 000 řádků v bash. A ty jsi zůstal na revizi 4 hodiny. Problémy jsou opět stejné. Je to stále kód. A stále společná práce. Zasekneme se nad pull request a narazíme na stejné merge konflikty bash.
V současnosti se velmi aktivně dívám na maximálně hezké programování infrastruktury. Nyní jsem do infrastruktury přidal Pulumi. To je programování v čisté podobě. Je to tam ještě sympatičtější, protože mám všechny možnosti programovacího jazyka, tj. udělal jsem krásné toggle s normálními if, a všechno vypadá dobře. Tedy má změna už je v masteru. Už si ji všichni mohou prohlédnout. Ostatní inženýři o ní vědí. Už to na něco vliv má. Ale zároveň se to nezapnulo pro všechny infrastruktury. Zapnulo se to pro mé testovací stanice, například. Proto, abych odpověděl na tvoji otázku znovu, je to potřeba. Nám, jako inženýrům pracujícím s kódem, to určitě usnadňuje život.
Má ještě někdo další otázky?
Mám otázku. Chci pokračovat v diskuzi s Olegem. Obecně si myslím, že máš pravdu, že pokud ti úkol trvá měsíc, máš problém s architekturou, máš problém s analýzou, dekompozicí, plánováním atd. Ale mám pocit, že pokud začneš žít podle Continuous Integration, začneš opravovat bolesti s plánováním, protože se od toho nikam jinam nedostaneš.
(Oleg) Ano, je to tak. Co se týče pracovního zatížení, tato praxe se dá srovnat s jakoukoli jinou závažnou praxí, která mění kulturu. Nejtěžší na překonání jsou zvyky, zejména špatné zvyky. A pokud pro zavedení této praxe je třeba zásadní změna zvyklostí kolem vás: vývojáři, vedení, produkční manažer, čekají vás překvapení.
Jaká překvapení to mohou být? Představte si, že jste se rozhodli, že budete častěji provádět integraci. A na integraci máte navázány další věci, například artefakty. A ve vaší firmě platí politika, že každý artefakt musí být nějakým způsobem evidován v systému pro skladování artefaktů. A to zabírá nějaký čas. Člověk musí zaškrtnout, že jako release manažer schválil tento artefakt k uvolnění do produkce. Pokud to zabere 5-10-15 minut a přitom děláte uvolnění jednou týdně, tak utratit půl hodiny jednou týdně je malá daň.
Pokud provádíte Continuous Integration 10krát denně, musíte 10krát vynásobit 30 minutami. A to převyšuje pracovní čas tohoto release manažera. Jednoduše se unaví. Existují stálé náklady na některé praktiky. A to je vše.
A buď musíte zrušit toto pravidlo, aby se takovými hloupostmi už nezabýval, tj. nebudete ručně přiřazovat shodu něčeho něčemu. Úplně se spolehnete na nějakou automatizovanou sadu testů připravenosti.
A pokud potřebujete od někoho potvrzení, aby vedoucí podepsal, a nekryjete se do produkce, dokud vám Vašek neřekl, že to povoluje, atd. – celá tato zbytečnost brání praktikám. Protože pokud existují nějaké aktivity ve formě daně, vše se stokrát zkomplikuje. A proto bude posun často přijat jen s neochotou. Protože změnit zvyky lidí je obtížné.
Když člověk dělá svoji obvyklou práci, dělá ji prakticky bez přemýšlení. Její kognitivní zatížení je nulové. Jednoduše se pustí do hotového, v hlavě už má checklist, dělal to tisíckrát. A jakmile přijdeš a řekneš mu: „Zrušíme tuto praxi a od pondělí zavedeme novou,“ stává se to pro něj značným kognitivním zatížením. A to pro všechny nastupuje najednou.
Protože to nejjednodušší je, že tuto luxus si nemusí dovolit každý, ale já to dělám vždy takto: když se spouští nový projekt, obvykle se do něj hned zařadí všechny neověřené praktiky. Zatímco je projekt nový, neriskujeme příliš. Prod ještě není, není co rozpadnout. Takže je možné to použít jako trénink. Tento přístup funguje. Ale ne všechny firmy mají možnost spouštět takové projekty často. I když se to zdá trochu zvláštní, protože teď probíhá masivní digitální transformace, všichni by měli spouštět experimenty, aby se přizpůsobili konkurenci.
Zde se dostáváte k tomu, že musíte mít nejprve jasnou představu o tom, co potřebujete dělat. Svět není dokonalý, prod také není dokonalý.
Ano, tyto věci spolu souvisejí.
Firmy také ne vždy chápou, že by měly jít právě tam.
Existuje situace, kdy jsou jakékoliv změny zcela nemožné. Je to situace, kdy na tým působí větší tlak. Tým je již docela vyčerpaný. Nemá žádný čas na žádné experimenty. Od rána do večera vytváří funkce. A vedení potřebuje stále více a více funkcí. V takové situaci nejsou možné žádné změny. Týmu mohou jen říci, že zítra to uděláme stejně jako včera, prostě musíme udělat o něco více funkcí. Žádné přechody k jiným praktikám v tomto smyslu nejsou možné. To je klasická situace, kdy není čas na broušení sekery, je třeba kácet stromy, proto se kácí tupou sekerou. Zde nejsou žádné jednoduché rady.
(Dmitrij) Přečtu upřesnění z chatu: „Ale potřebujeme vysoké pokrytí testy na různých úrovních. Kolik času se věnuje testování? Je to trochu drahé, zabírá to hodně času“.
(Oleg) To je klasická mylná představa. Testů by mělo být dostatek na to, abyste měli jistotu sami v sobě. Continuous Integration není něco, kde nejprve proběhne 100 % testů a až poté začnete tuto praxi aplikovat. Continuous Integration snižuje vaši kognitivní zátěž tím, že každá změna, kterou vidíte, je tak zřejmá, že chápete – zda něco rozbije, nebo ne, dokonce i bez testů. Můžete to rychle otestovat ve své hlavě, protože změny jsou malé. I když máte pouze manuální testery, je to pro ně také jednodušší. Nasadíte to a říkáte: „Podívej se, nic se neporouchalo?“ Odpoví vám: „Ne, nic se neporouchalo.“ Protože tester ví, na co se má zaměřit. Jeden commit je spojen s jedním fragmentem kódu. A to se odvíjí od konkrétního chování.
Tady jsi to samozřejmě trochu přikrášlil.
(Dmitrij) S tím nesouhlasím. Existuje praxe – test-driven development, která tě právě od toho zachrání.
(Oleg) To jsem se ještě k tomu nedostal. První iluze – je to, že je potřeba napsat přesně 100 % testů, nebo se vůbec nezabývat Continuous Integration. To není pravda. To jsou dvě paralelní praktiky. A přímo na sobě nezávisí. Vaše pokrytí testy by mělo být optimální. Optimální – to znamená, že si sami jste jisti tím, že kvalita vašeho mastera, která zůstala po commitu, vám umožňuje s jistotou stisknout tlačítko „Deploy“ v pátek večer pod vlivem alkoholu. Jak toho dosáhnete? Přes revizi, přes pokrytí, přes dobré monitorování.
Dobrý monitoring se neliší od testů. Pokud spouštíte testy jednou na pre prod, ověřují jednou všechny vaše uživatelské scénáře a tím to končí. Pokud je spouštíte v nekonečném cyklu, pak máte rozvinutý systém monitorování, který nekonečně testuje – spadlo to, nebo ne. V tomto případě je rozdíl pouze v jednorázovosti nebo vícenásobnosti. Velmi dobrá sada testů…, spuštěná nekonečně, je monitoring. A správný monitoring by takový měl být.
A proto, jak přesně dosáhnete stavu, kdy se v pátek večer nasadíte a půjdete domů, je jiná otázka. Možná jste jen odvážný blázen.
Pojďme se na chvíli vrátit k Continuous Integration. Trochu jsme utekli do jiné komplikované praxe.
A druhá iluze je, že MVP se prý musí dělat rychle, takže tam vlastně testy nejsou potřeba. To není úplně pravda. Když píšete user story pro MVP, můžete ji vyvinout buď na koleni – to znamená, že slyšíte, že nějaká user story existuje, a hned se do jejího kódování vrhnete, nebo pracovat podle TDD. A podle TDD, jak ukazuje praxe, to trvá fakticky stejně dlouho, testy jsou vedlejším produktem. Podstata TDD nespočívá v testování. I když se to jmenuje Test Driven Development, ve skutečnosti nejde vůbec o testy. Je to spíše architektonický přístup. Jde o to, jak psát přesně to, co je potřeba, a nepřidávat to, co není potřebné. Tato praxe soustředí pozornost na další iteraci vašeho myšlení v rámci budování architektury aplikace.
Proto není snadné se těchto iluzí zbavit. MVP a testy se navzájem nevylučují. Naopak, pokud děláte MVP podle principů TDD, uděláte to lépe a rychleji, než pokud byste to dělali bez této praxe, na koleni.
To je velmi nepopiratelná a složitá myšlenka. Když slyšíte, že teď budu také psát testy a přitom něco udělám rychleji, zní to naprosto neadekvátně.
(Dmitrij) Mnozí, když mluví o MVP, se prostě nechtějí namáhat s psaním něčeho normálního. A to jsou nakonec dvě odlišné věci. Není dobré, aby se MVP proměnilo v něco špatného, co nefunguje.
Ano, máš pravdu.
A pak náhle MVP v produkci.
Navždy.
A TDD zní velmi nezvykle, když slyšíte, že píšete testy a jakoby děláte více práce. Zní to zvláštně, ale ve skutečnosti to jde rychleji a esteticky lépe. Když píšete test, už v hlavě hodně přemýšlíte o tom, jaký kód a jak bude volán a jaké chování od něj očekáváme. Nejen říkáte, že jsem napsal nějakou funkci a ta něco dělá. Nejdříve přemýšlíte o tom, jaké podmínky to má, jak bude volána. To pokrýváte testy a z toho chápete, jak budou vypadat rozhraní uvnitř vašeho kódu. To má silný vliv na architekturu. Váš kód se automaticky stává více modulárním, protože se nejprve snažíte pochopit, jak ho budete testovat, a teprve potom ho píšete.
Měl jsem s TDD takovou zkušenost, že jsem si v určitém okamžiku najal mentora na Ruby, když jsem byl ještě programátor na Ruby. A on říká: „Dáme se do TDD“. Pomyslel jsem si: „Mě to teď bude obírat o čas“. Domluvili jsme se, že po dobu dvou týdnů budu psát veškerý pracovní kód na Python pomocí TDD. Po dvou týdnech jsem zjistil, že se zpět vrátit už nechci. Během těch dvou týdnů, kdy jsem to všude zkoušel, jsem si uvědomil, jak snadnější je prostě přemýšlet. Ale to není očividné, takže doporučuji všem, že pokud máte pocit, že TDD je komplikované, zdlouhavé a zbytečné, zkuste se tomu držet po dobu dvou týdnů. Mně to stačilo.
(Dmitrij) Tuto myšlenku můžeme rozvinout z pohledu provozu infrastruktury. Než něco nového spustíme, provedeme monitoring, a až pak spouštíme. V tomto případě se monitoring stává běžným testováním. A existuje vývoj přes monitoring. Ale téměř každý říká, že to trvá dlouho, je mu líno, udělal jsem dočasný návrh. Pokud jsme provedli monitoring pořádně, chápeme stav CI systému. A v CI systému je hodně monitoringu. Chápeme stav systému, víme, co se uvnitř děje. A během vývoje vytváříme systém, aby dospěl do požadovaného stavu.
Tyto praktiky jsou známy už dlouho. Diskutovali jsme o tom před čtyřmi lety. Ale za čtyři roky se prakticky nic nezměnilo.
Na této poznámce navrhuji oficiální diskuzi ukončit.
Video (vložené jako mediální prvek, ale z nějakého důvodu nefunguje):
Zdroj: habr.com
