

Tématem DevOps se v současnosti zabývá kdekdo. CI/CD pipeline se zavádí napříč firmami, které se hodlají posunout vpřed. Ale většina z nich nevěnuje vždy dostatečnou pozornost zajištění spolehlivosti informačních systémů v různých fázích CI/CD pipeline. V tomto článku bych chtěl hovořit o svých zkušenostech s automatizací kontrol kvality softwaru a realizací možných scénářů pro jeho „samovytváření“.
Pracuji jako inženýr v oddělení správy IT služeb ve společnosti . Mým zaměřením je implementace různých systémů monitorování výkonu a dostupnosti aplikací. Často komunikuji s IT zákazníky z různých segmentů trhu ohledně aktuálních otázek monitorování kvality jejich IT služeb. Hlavním úkolem je minimalizovat dobu cyklu vydání a zvýšit frekvenci jejich vydávání. To všechno zní krásně: více vydání – více nových funkcí – více spokojených uživatelů – více zisku. Ale ve skutečnosti se to ne vždy podaří. Při velmi vysokých rychlostech nasazení se téměř okamžitě vynořuje otázka kvality našich vydání. I při plně automatizovaném pipeline je jedním z největších problémů převedení služeb z testování do produkce, aniž by to mělo vliv na čas bezporuchového provozu a interakci uživatelů s aplikací.
Na základě četných rozhovorů se zákazníky mohu říci, že kontrola kvality vydání, problém spolehlivosti aplikace a možnost jejího „samovytváření“ (například návrat k stabilní verzi) v různých fázích CI/CD pipeline jsou jedny z nejvíce palčivých a aktuálních témat.
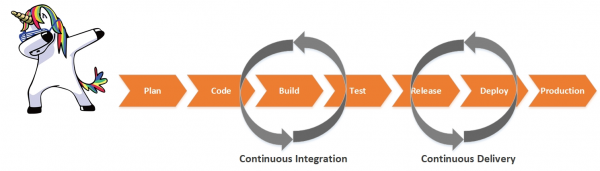
Nedávno jsem sám pracoval na straně zákazníka – v oddělení podpory aplikací online banky. V architektuře naší aplikace bylo použito velké množství vlastnoručně vytvořených mikroslužeb. Nejhorší bylo, že ne všichni vývojáři stíhali vysoké tempo vývoje, kvalita některých mikroslužeb trpěla, což vedlo k vtipným přezdívkám pro ně a jejich tvůrce. Objevovaly se fámy o tom, z jakých materiálů jsou tyto produkty vytvořeny.
„Stanovení úkolu“
Vysoká frekvence vydání a velké množství mikroslužeb přinášejí potíže ve pochopení fungování aplikace jako celku, jak v testovací fázi, tak během provozu. Změny se dějí neustále a sledovat je bez dobrých monitorovacích nástrojů je velmi obtížné. Často po nočním vydání sedí ráno vývojáři jako na střelném prachu a čekají, aby se nic nerozbilo, i když v testovací fázi všechny zkoušky byly úspěšné.
Je tu ještě jeden aspekt. V testovací fázi se kontroluje funkčnost software: provádění základních funkcí aplikace a absence chyb. Kvalitativní hodnocení výkonu buď chybí, nebo nezohledňuje všechny aspekty fungování aplikace a integrační vrstvy. Některé metriky se dokonce vůbec neověřují. Výsledkem je, že při vzniku poruchy v produkčním prostředí tým technické podpory se o ní dozvídá až ve chvíli, kdy si skuteční uživatelé začnou stěžovat. Je žádoucí minimalizovat dopad nekvalitního software na koncové uživatele.
Jedním z řešení je zavádět procesy kontroly kvality software v různých fázích CI/CD Pipeline, přidávat různé scénáře pro obnovení systému v případě havárie. Také pamatujme, že máme DevOps. Byznys očekává co nejrychlejší dodání nového produktu. Proto by všechny naše kontroly a scénáře měly být automatizovány.
Úkol se rozděluje na dvě složky:
- kontrola kvality sestavení v testovací fázi (automatizovat proces zachytávání nekvalitních sestavení);
- kontrola kvality software v produkčním prostředí (mechanismy automatického odhalování problémů a možné scénáře pro jejich automatické obnovení).
Nástroj pro monitorování a sběr metrik
Abychom splnili dané úkoly, je zapotřebí monitorovací systém, který dokáže odhalovat problémy a předávat je do automatizačních systémů v různých fázích CI/CD pipeline. Také by bylo pozitivní, pokud by tento systém poskytoval užitečné metriky pro různé týmy: vývojové, testovací, provozní. A bude úplně skvělé, pokud i pro byznys.
Pro sběr metrik lze použít kombinaci různých systémů (Prometheus, ELK Stack, Zabbix atd.), ale podle mého názoru jsou pro tyto úkoly nejvhodnější řešení třídy APM (), která vám mohou výrazně usnadnit život.
V rámci mé práce v podpoře jsem začal dělat podobný projekt, využívající řešení třídy APM od společnosti Dynatrace. Nyní, pracující v integrátorovi, dobře znám trh systémů monitorování. Můj subjektivní názor: Dynatrace je nejvhodnější pro řešení těchto úkolů.
Řešení Dynatrace poskytuje horizontální zobrazení každé uživatelské operace s hlubokou úrovní detailu až na úroveň provádění kódu. Lze sledovat celý řetězec interakcí mezi různými informačními službami: od úrovní frontendových webových a mobilních aplikací, přes backendové aplikační servery a integrační sběrnici až po konkrétní volání do databáze.
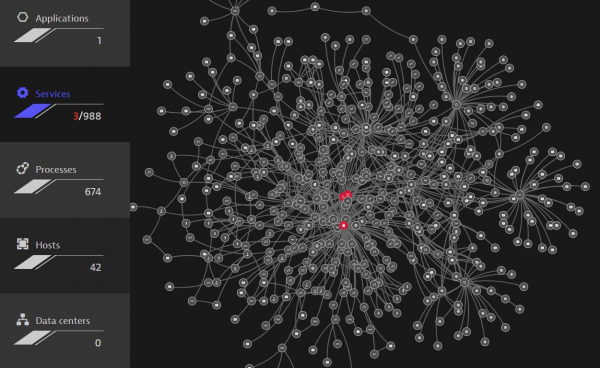 . Automatické vytvoření všech závislostí mezi komponenty systému
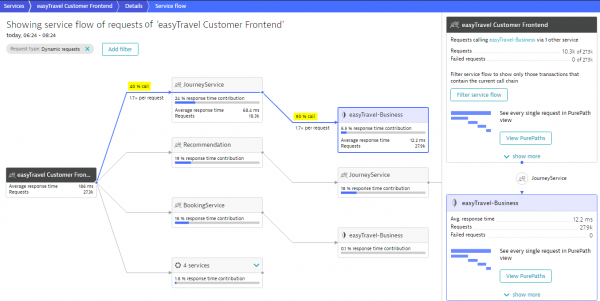 . Automatické určení a vykreslení cesty provádění operace služby
Také si pamatujeme, že se musíme integrovat s různými nástroji automatizace. Tady řešení nabízí pohodlné API, které umožňuje odesílat a přijímat různé metriky a události.
Nyní přejdeme k podrobnějšímu zkoumání, jak řešit stanovené úkoly pomocí systému Dynatrace.
Úkol 1. Automatizace kontroly kvality buildů v testovací fázi
Prvním úkolem je najít problémy co nejdříve v krocích dodávkového konveyor na fázi. Pouze "dobré" buildy kódu by měly dosahovat produkčního prostředí. Pro to by ve vašem pipeline v testovací fázi měly být zahrnuty další monitory pro kontrolu kvality vašich služeb.
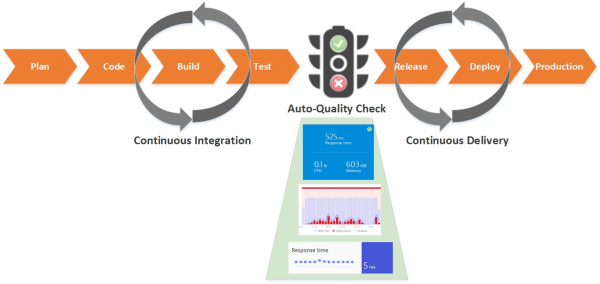
Podívejme se krok po kroku, jak to realizovat a automatizovat tento proces:
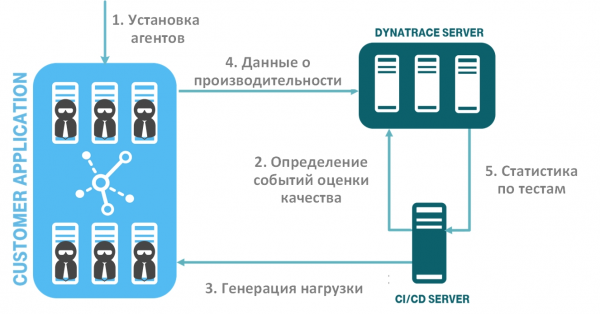
Na obrázku je znázorněn tok automatizovaných kroků kontroly kvality softwaru:
- zavedení monitorovacího systému (instalace agentů);
- určení událostí hodnocení kvality vašeho softwaru (metriky a prahové hodnoty) a jejich předání do monitorovacího systému;
- generace zátěže a testů výkonu;
- shromáždění dat o výkonu a dostupnosti v monitorovacím systému;
- přenášení údajů o testech založených na událostech hodnocení kvality softwaru z monitorovacího systému do systému CI/CD. Automatická analýza sestavení.
Krok 1. Nasazení monitorovacího systému
Nejprve je nutné nainstalovat agenty do vašeho testovacího prostředí. Řešení Dynatrace má příjemnou vlastnost – využívá univerzálního agenta OneAgent, který se instaluje na OS instance (Windows, Linux, AIX), automaticky objevuje vaše služby a začíná sbírat údaje o monitorování. Není třeba nastavovat agenta zvlášť pro každý proces. Podobná situace platí pro cloudové a kontejnerové platformy. Proces instalace agentů můžete také automatizovat. Dynatrace skvěle zapadá do konceptu „infrastruktura jako kód“ (): existují již hotové skripty a pokyny pro všechny populární platformy. Vložte agenta do konfigurace vaší služby a při jejím nasazení okamžitě získáte novou službu s již funkčním agentem.
Krok 2. Určení událostí hodnocení kvality vašeho softwaru
Nyní je třeba určit seznam služeb a obchodních operací. Důležité je vzít v úvahu právě ty operace uživatelů, které jsou obchodně kritické pro vaši službu. Doporučuji konzultovat s obchodními a systémovými analytiky.
Dále je třeba určit, které metriky chcete zahrnout do testování pro každou z úrovní. Například to mohou být doby provádění (s dělením na průměr, medián, percentily atd.), chyby (logické, servisní, infrastrukturní atd.) a různé infrastrukturní metriky (memory heap, garbage collector, count of threads atd.).
Pro automatizaci a usnadnění práce týmu DevOps vzniká koncept „monitorování jako kód“. Co tím myslím – vývojář/tester může napsat jednoduchý JSON soubor, který definuje ukazatele hodnocení kvality softwaru.
Podívejme se na příklad takového JSON souboru. Jako pár klíč/hodnota jsou použity objekty z Dynatrace API (popis API lze vidět zde ).
{
   "timeseries": [
   {
     "timeseriesId": "service.ResponseTime",
     "aggregation": "avg",
     "tags": "Frontend",
     "severe": 250000,
     "warning": 1000000
   },
   {
     "timeseriesId": "service.ResponseTime ",
     "aggregation": "avg",
     "tags": "Backend",
     "severe": 4000000,
     "warning": 8000000
   },
   {
     "timeseriesId": "docker.Container.Cpu",
     "aggregation": "avg",
     "severe": 50,
     "warning": 70
   }
  ]
}
Soubor představuje pole definic časových řad (timeseries):
- timeseriesId – měřená metrika, například Response Time, Error count, Memory used atd.;
- aggregation — úroveň agregace metrik, v našem případě avg, ale můžete použít jakoukoli potřebnou (avg, min, max, sum, count, percentile);
- tags – štítek objektu v monitorovacím systému, nebo můžete uvést konkrétní identifikátor objektu;
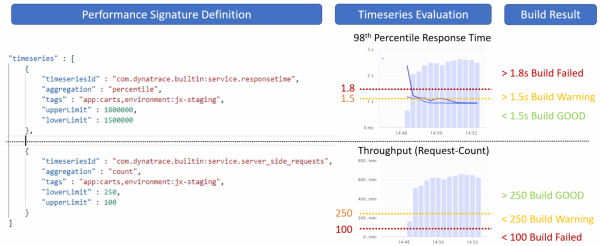
- severe a warning – tyto ukazatele nastavují prahové hodnoty našich metrik, pokud hodnoty testů překročí prahovou hodnotu severe, pak se naše sestavení označuje jako neúspěšné.
Na následujícím obrázku je uveden příklad použití takových prahů.
Krok 3. Generování zátěže
Poté, co jsme stanovili úrovně kvality našich služeb, je třeba vygenerovat testovací zátěž. Můžete použít jakýkoli z pohodlných nástrojů pro testování, například Jmeter, Selenium, Neotys, Gatling atd.
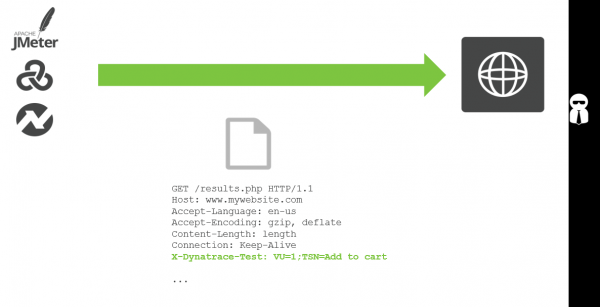
Monitorovací systém Dynatrace umožňuje zachycovat různé metadata z vašich testů a rozpoznávat, který test se vztahuje k jakému cyklu vydání a k jaké službě. Doporučuje se přidávat další záhlaví do HTTP požadavků testu.
Na následujícím obrázku je uveden příklad, kde pomocí dalšího záhlaví X-Dynatrace-Test označujeme, že tento test se týká testování operace přidání zboží do košíku.
Při spuštění každého zátěžového testu posíláte další kontextové informace do Dynatrace pomocí API události z CI/CD serveru. Tak systém může rozlišovat různé testy mezi sebou.
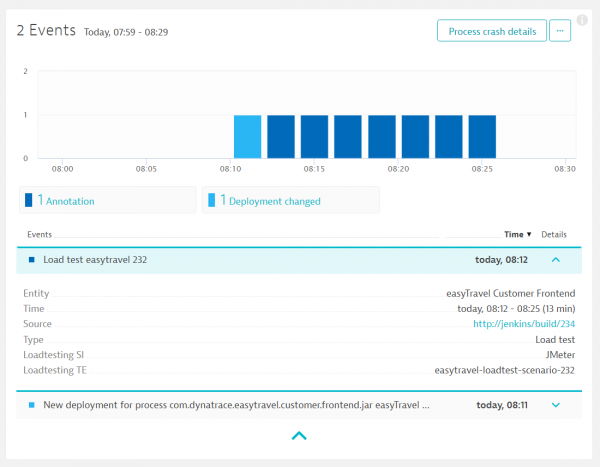 . Událost v monitorovacím systému o spuštění zátěžového testování
Krok 4-5. Sběr dat o výkonnosti a předání dat do systému CI/CD
Společně s generovaným testem se do monitorovacího systému přenáší událost o nutnosti sběru dat o ověření ukazatelů kvality služby. Také se uvádí náš JSON soubor, ve kterém jsou definovány klíčové metriky.
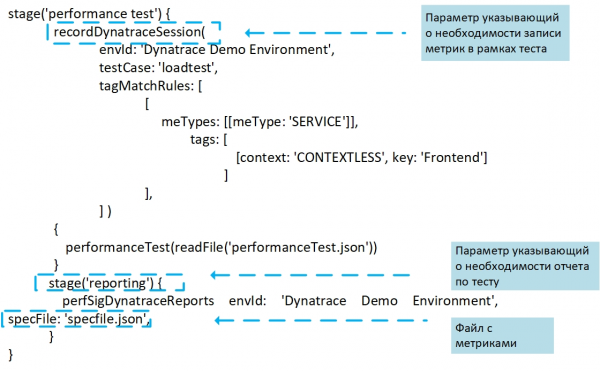 Událost o potřebě kontroly kvality softwaru vytvářená na serveru CI/CD pro zasílání do monitorovacího systému
V našem příkladu se událost kontroly kvality nazývá perfSigDynatraceReport (Performance_Signature) – je to připravené pro integraci s Jenkins, kterou vyvinuli kluci z T-Systems Multimedia Solutions. V každé události o spuštění kontroly je obsažena informace o službě, čísle sestavení a čase testování. Plugin shromažďuje hodnoty výkonu během sestavení, hodnotí je a porovnává výsledek s předchozími sestaveními a nefunkčními požadavky.
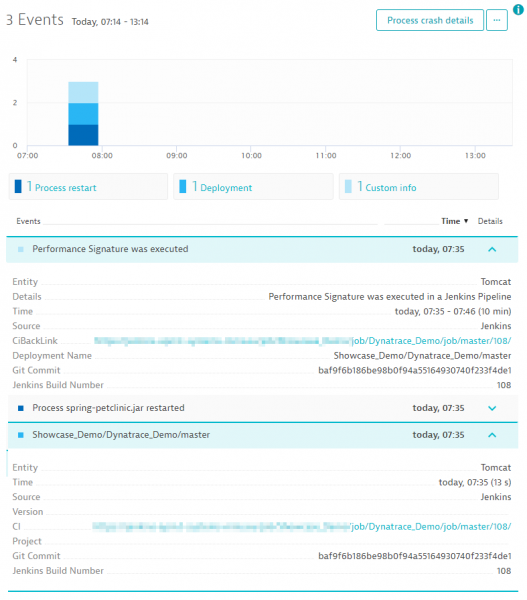 Událost v monitorovacím systému o začátku kontroly kvality sestavení.
Po dokončení testu se všechny metriky hodnocení kvality softwaru odešlou zpět do systému kontinuální integrace, např. Jenkins, který vytváří zprávu o výsledcích.
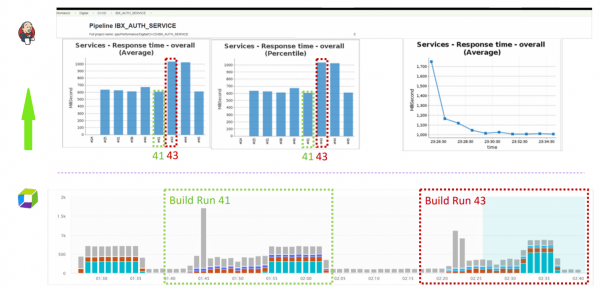 Výsledek statistik o sestaveních na serveru CI/CD.
Pro každé jednotlivé sestavení vidíme statistiku pro každou stanovenou metrickou hodnotu po celou dobu testování. Také vidíme, pokud došlo k porušení určitých prahových hodnot (warning a severe-thresholty). Na základě souhrnných ukazatelů je celé sestavení označeno jako stabilní, nestabilní nebo neúspěšné. Pro větší pohodlí můžete do zprávy přidat ukazatele porovnání aktuálního sestavení s předchozím.
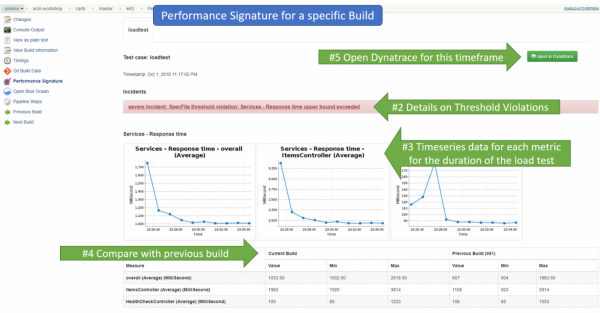 Zobrazení podrobné statistiky o sestaveních na serveru CI/CD.
Podrobné srovnání dvou sestavení
V případě potřeby můžete přejít do rozhraní Dynatrace a tam podrobněji prozkoumat statistiku pro každé vaše sestavení a porovnat je mezi sebou.
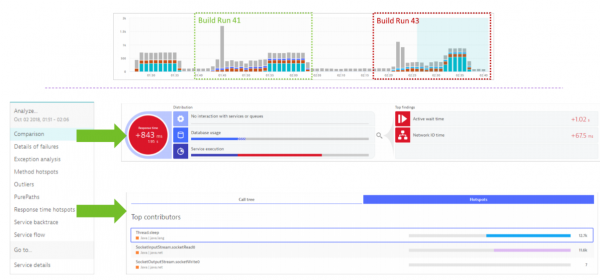 Srovnání statistik o sestaveních v Dynatrace.
Závěry
V důsledku toho získáváme službu „monitoring jako službu“, automatizovanou v procesu kontinuální integrace. Vývojář nebo tester musí pouze definovat seznam metrik v JSON souboru, vše ostatní probíhá automaticky. Získáváme transparentní kontrolu kvality vydání: všechna upozornění o výkonu, spotřebě zdrojů nebo architektonických regresích.
Úkol 2. Automatizace kontroly kvality softwaru v produkčním prostředí
Takže jsme vyřešili úkol, jak automatizovat proces monitorování během testování v Pipeline. Tímto minimalizujeme procento nekvalitních sestavení, která se dostávají do produkčního prostředí.
Co však dělat, když se špatný software dostane do produkce, nebo pokud něco prostě přestane fungovat. Pro utopii bychom chtěli, aby existovaly mechanismy automatického odhalování problémů a aby systém, pokud to je možné, sám obnovil svou funkčnost, alespoň v noci.
K tomu musíme podle předchozího oddílu předpokládat automatické kontroly kvality software v produkčním prostředí a připravit pro ně scénáře pro automatickou obnovu systému.
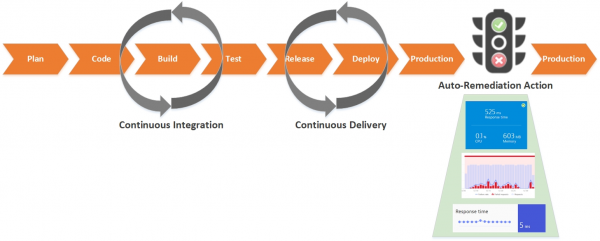
Automatická oprava jako kód
Ve většině firem již existuje nahromaděná znalostní báze o různých typech běžných problémů a seznam akcí pro jejich opravu, například restartování procesů, čištění zdrojů, vracení verzí, obnova nesprávných změn konfigurace, zvyšování nebo snižování počtu komponentů v clusterech, přepínání modrého nebo zeleného okruhu apod.
I když jsou tyto možnosti používání známé už mnoho let mnohým týmům, se kterými komunikuji, jen málo z nich uvažovalo a investovalo do jejich automatizace.
Pokud o tom přemýšlíte, realizace procesů pro automatickou obnovu funkčnosti aplikace není nijak složitá; je potřeba již známé scénáře práce vašich administrátorů představit ve formě kódu (koncept "automatická oprava jako kód"), které jste předem napsali pro každou konkrétní situaci. Scénáře automatické opravy by měly být zaměřeny na odstranění základní příčiny problému. Vy sami určujete správné reakce na incident.
Jako spouštěč pro aktivaci scénáře může sloužit jakákoliv metrika z vašeho monitorovacího systému, hlavně aby tyto metriky přesně určovaly, že je něco špatně, protože byste nechtěli mít falešná varování v produkčním prostředí.
Můžete používat jakýkoli systém nebo kombinaci systémů: Prometheus, ELK Stack, Zabbix apod. Ale uvedu několik příkladů na základě řešení APM (jako příklad bude opět Dynatrace), které také usnadní váš život.
Za prvé, zde je vše, co se týká funkčnosti z pohledu aplikace. Řešení poskytuje stovky metrik na různých úrovních, které můžete použít jako spouštěče:
- úroveň uživatelů (prohlížeče, mobilní aplikace, IoT zařízení, chování uživatelů, konverze atd.);
- úroveň služby a operací (výkonnost, dostupnost, chyby atd.);
- úroveň infrastruktury aplikace (OS metriky hostitele, JMX, MQ, webový server atd.);
- úroveň platforem (virtualizace, cloud, kontejnery atd.).
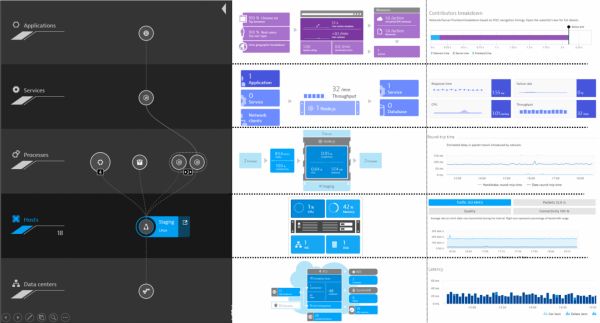 Úrovně monitorování v Dynatrace.
Za druhé, jak jsem již zmínil, Dynatrace má otevřené API, které umožňuje velmi snadnou integraci s různými externími systémy. Například odeslání oznámení do automatizačního systému při překročení kontrolovaných parametrů.
Níže je uveden příklad interakce s Ansible.
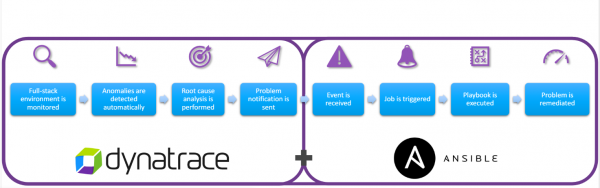
Dále uvedu několik příkladů, jaké konkrétní automatizace lze provádět. To je pouze část scénářů, jejichž seznam ve vaší prostředí může být omezen pouze vaší fantazií a možnostmi vašich monitorovacích nástrojů.
1. Špatné nasazení – návrat k předchozí verzi
I když všechno důkladně kontrolujeme ve testovacím prostředí, stále existuje šance, že nový release může zničit vaši aplikaci v produkčním prostředí. Lidský faktor nikdo nezrušil.
Na následujícím obrázku vidíme, že došlo k prudkému skoku v době provádění operací na službě. Začátek tohoto skoku se shoduje s časem nasazení na aplikaci. Všechny tyto informace jako události předáváme do automatizačního systému. Pokud se funkčnost služby po uplynutí námi stanoveného času nenormalizuje, automaticky se spustí skript, který provede návrat k předchozí verzi.
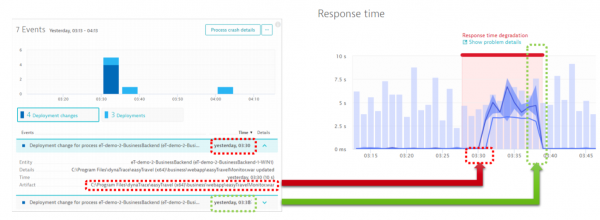 Degradace výkonnosti operací po nasazení.
2. Zatížení zdrojů na 100 % – přidání uzlu do směrování
V následujícím příkladu systém monitorování určuje, že na jednom z komponentů je zatížení CPU na 100 %.
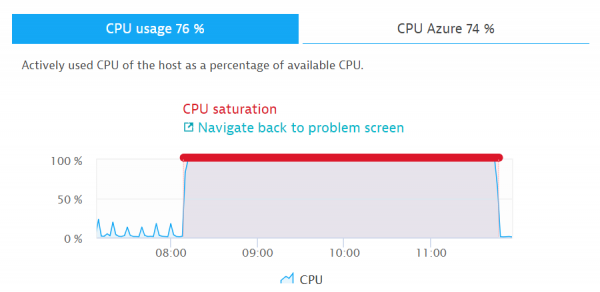 Zatížení CPU 100%
Na základě této události je možné několik různých scénářů. Například, systém monitorování dále kontroluje, zda nedostatek zdrojů souvisí se zvýšením zátěže na službu. Pokud ano, spustí se skript, který automaticky přidá uzel do směrování, čímž obnoví funkčnost systému jako celku.
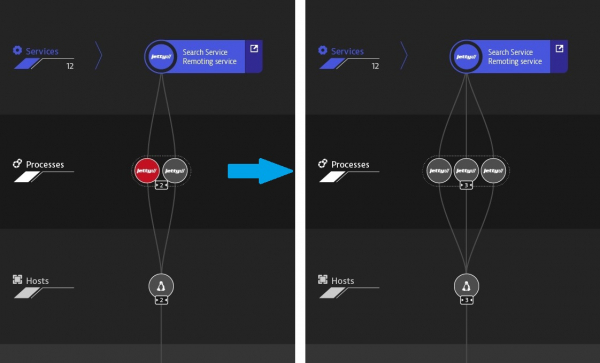 Škálování po incidentu
3. Nedostatek místa na pevném disku – údržba disku
Myslím, že tyto procesy mají mnozí již automatizované. S pomocí APM lze také sledovat volné místo na diskovém subsystému. Pokud není místo nebo disk pracuje pomalu, spouštíme skript pro úklid nebo přidáváme místo.
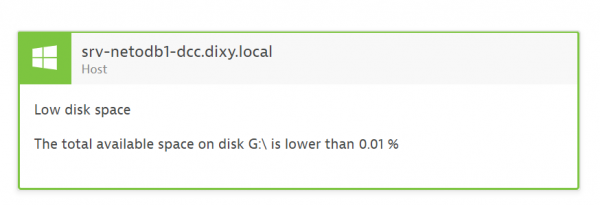
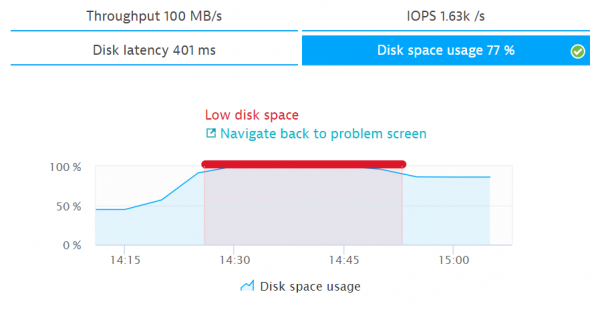 Využití disku 100%
4. Nízká aktivita uživatelů nebo nízká konverze – přepínání mezi modrou a zelenou větví
Často se setkávám s klienty, kteří používají dva kontury (blue-green deploy) pro aplikace v produkčním prostředí. To umožňuje rychlé přepínání mezi větvemi při dodávání nových verzí. Často po nasazení mohou nastat zásadní změny, které není na první pohled možné zaznamenat. Zatímco degradace výkonu a dostupnosti nemusí být patrná. Pro rychlé reagování na takové změny je lepší používat různé metriky, které odrážejí chování uživatelů (počet relací a akcí uživatelů, konverze, míra opuštění stránky). Na následujícím obrázku je uveden příklad, kdy při poklesu konverze dochází k přepnutí mezi větvemi softwaru.
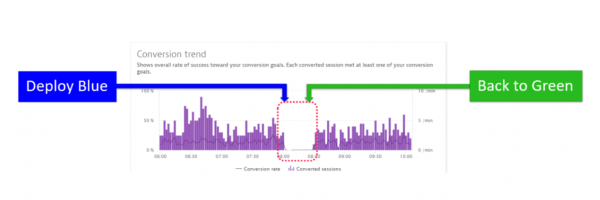 Pokles konverze po přepnutí mezi větvemi softwaru.
Mechanismy automatického zjišťování problémů
Na závěr uvedu ještě jeden příklad, proč mám Dynatrace nejvíce rád.
V části mého vyprávění o automatizaci kontroly kvality sestav v testovacím prostředí jsme všechny prahové hodnoty stanovovali ručně. Pro testovací prostředí je to normální, tester sám určuje ukazatele před každou kontrolou podle zátěže. V produkčním prostředí je žádoucí, aby problémy byly odhalovány automaticky s ohledem na různé mechanismy baseline.
Dynatrace má zajímavé vestavěné nástroje umělé inteligence, které na základě mechanismů pro identifikaci anomálních metrik (baselining) a vytváření mapy interakcí mezi všemi komponentami, porovnávají a korelují události, určují anomálie ve fungování vašeho servisu a poskytují podrobné informace o každém problému a jeho hlavní příčině.
Pomocí automatické analýzy závislostí mezi komponenty Dynatrace určuje nejen to, zda je problémová služba hlavní příčinou, ale také její závislost na dalších službách. V následujícím příkladu Dynatrace automaticky sleduje a hodnotí funkčnost každé služby v rámci vykonávání transakcí a identifikuje službu Golang jako hlavní příčinu.
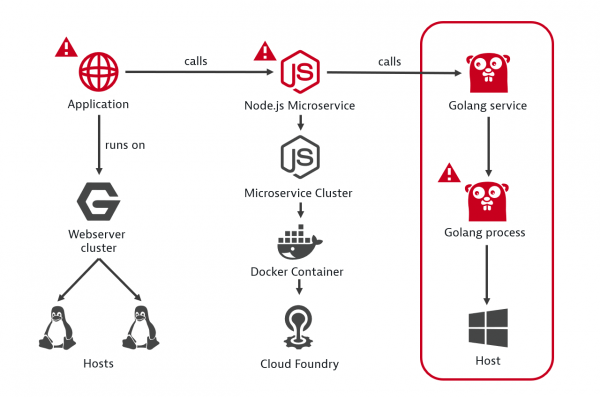 Příklad určení hlavní příčiny selhání.
Na následujícím obrázku je znázorněn proces monitorování problémů s vaší aplikací od začátku incidentu.
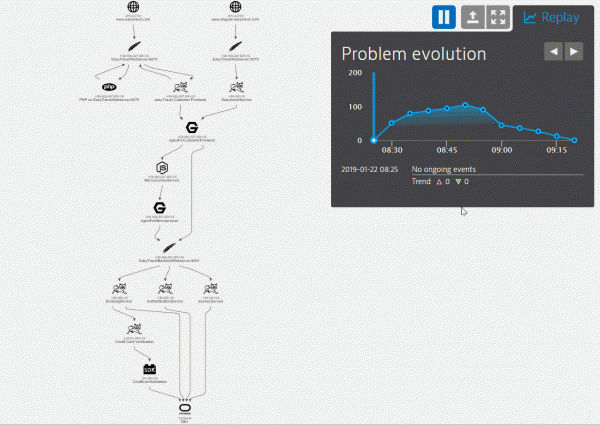 Vizualizace vznikajícího problému s zobrazením všech komponentů a událostí na nich
Systém monitorování shromáždil úplnou chronologii událostí k vzniklému problému. V okně pod časovým grafem vidíme všechna klíčová událost na každém z komponentů. Na základě těchto událostí můžete nastavit procedury pro automatické opravy ve formě skriptů kódu.
Doporučuji také integrovat systém monitorování se Service Desk nebo bug trackerem. Při vzniku problému vývojáři rychle získají kompletní informace pro jeho analýzu na úrovni kódu v produkčním prostředí.
Závěr
V důsledku toho máme CI/CD pipeline se zabudovanými automatizovanými kontrolami kvality software v Pipeline. Minimalizujeme počet nekvalitních sestavení, zvyšujeme spolehlivost systému jako celku a pokud přesto dojde k selhání systému, spouštíme mechanismy pro jeho obnovení.
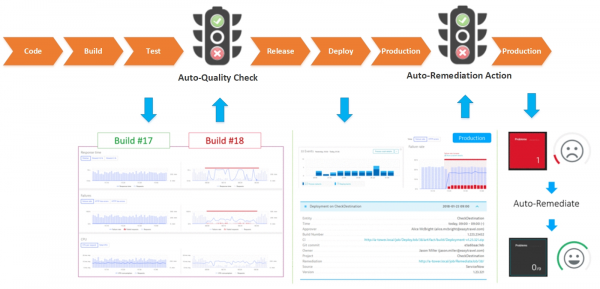
Automatizace monitorování kvality software se určitě vyplatí, není to vždy rychlý proces, ale časem přinese své ovoce. Doporučuji po vyřešení nového incidentu v produkčním prostředí ihned přemýšlet nad tím, jaké monitory přidat pro kontroly v testovacím prostředí, aby se předešlo vstupu špatného sestavení do produkce, a také sestavit skript pro automatické opravy těchto problémů.
Doufám, že mé příklady vám pomohou ve vašich začátcích. Také by mě zajímalo vidět vaše příklady používaných metrik pro realizaci automatického obnovení funkčnosti systémů.
Zdroj: habr.com
