

Takovéto stížnosti jsem slyšel od našich vývojářů. Nejzajímavější je, že to byla pravda, což vedlo k dlouhému vyšetřování. Budeme hovořit o SQL serverech, které běží na našem VMware.
Vlastně, dosáhnout toho, aby se produkční server beznadějně zpozdil za laptopem, je snadné. Proveďte (ne na tempdb a ne na databázi s povolenou delayed durability) tento kód:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Jaký pomalý rychlík!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
Na mém desktopu se to provádí za 5 sekund, zatímco na produkčním serveru za 28 sekund. Protože SQL musí čekat na fyzické dokončení zápisu do transakčního logu, a my zde děláme velmi krátké transakce. Hrubě řečeno, vjeli jsme s velkým mocným nákladním autem do městského provozu a sledujeme, jak nás rychle obcházejí dodavatelé pizzy na skútrech — zde není důležitá propustnost, důležitá je pouze latence. A žádné síťové úložiště, kolik nul by v jeho ceně nebylo, nemůže vyhrát po latenci oproti místnímu SSD.
(v komentářích se ukázalo, že jsem lhal — v obou místech se mi dostala delayed durability. Bez delayed durability to vypadá takto:
Desktop — 39 sekund, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 sekund, 1600 tr/sec, 0.6ms
Měl jsem si dát pozor, že to jde příliš rychle)
Nicméně v tomto případě máme do činění s triviálními nulami z této Riemannovy funkce s triviálním příkladem. V tom příkladu, který mi přinesli vývojáři, to bylo jiné. Ujistil jsem se, že mají pravdu, a začal jsem odstraňovat z příkladu všechnu jejich speciálnost spojenou s obchodní logikou. V určitém okamžiku jsem si uvědomil, že mohu zcela vyhodit jejich kód a napsat svůj — který ukazuje stejný problém — na produkci to probíhá 3-4krát pomaleji:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- zkontrolovat liché čísla až do sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Pokud máte vše v pořádku, kontrola prvočísel bude trvat 6-7-8 sekund. Tak to bylo v řadě servery. Ale na některých trvala kontrola 25-40 sekund. Co je zajímavé, nebyly servery, kde by provádění trvalo například 14 sekund — kód pracoval buď velmi rychle, nebo zcela pomalu, takže problém byl, řekněme, černobílý.
Co jsem udělal? Ponořil jsem se do metrik VMware. Tam všechno vypadalo dobře - zdrojů bylo dost, Ready time = 0, vše bylo dostatek, během testu na rychlých i pomalých serverech CPU=100 na jednom vCPU. Vzal jsem si test pro výpočet čísla Pi - test ukazoval stejné výsledky na jakýchkoli serverech. Stále více to zavánělo černou magií.
Když jsem se dostal na DEV farmu, začal jsem si hrát se servery. Ukázalo se, že vMotion z hostitele na hostitele může 'uzdravit' server, ale může také naopak, 'rychlý' server proměnit na 'pomalý'. Zdá se, že to je ono - některé hosty mají problém... ale... ne. Nějaká virtuálka zpomalovala na hostu A, ale na hostu B fungovala rychle. A jiná virtuálka naopak, fungovala rychle na A a zpomalovala na B! Na hostu se často točily i 'rychlé' i 'pomalé' strojky!
Od této chvíle se ve vzduchu jasně objevil zápach síry. Vždyť problém nemohl být připsán ani virtuálce (např. windows patche) - vždyť se stával 'rychlou' při vMotion. Ale problém také nemohl být připsán hostiteli - vždyť na něm mohly být jak 'rychlé', tak 'pomalé' strojky. Taktéž to nebylo spojeno se zátěží - podařilo se mi získat 'pomalou' mašinu na hostu, kde kromě ní nebylo vůbec nic.
Z beznaděje jsem spustil Process Explorer od Sysinternals a podíval se na SQL zásobník. Na pomalých mašinách mi hned padla do oka následující řádka:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… přeskočeno
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
To už bylo něco. Bylo napsáno program:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Tato aplikace ukázala ještě výraznější zpomalení – na "rychlých" strojích dosahuje 16-18 milionů cyklů za sekundu, zatímco na pomalých to je jen 1,5 milionu, nebo dokonce 700 tisíc. To znamená rozdíl 10-20krát (!!!). To už byl malý úspěch: alespoň nebyla hrozba uvíznout mezi podporou Microsoftu a VMware tak, že by se navzájem obviňovali.
Dále se pokrok zastavil – dovolená, důležité záležitosti, virální hysterie a náhlý nárůst zátěže. Často jsem zmiňoval magický problém kolegům, ale občas mi připadalo, že mi ani nevěří – příliš šílené bylo tvrzení, že VMware zpomaluje kód 10-20krát.
Snažil jsem se sám zjistit, co zpomaluje. Občas mi připadalo, že jsem nalezl řešení – zapínání a vypínání Hot plugs, změna objemu paměti nebo počtu procesorů často proměnila stroj v "rychlý". Ale ne navždy. Ale to, co se ukázalo jako pravda, je, že stačilo vyjít ven a zaklepat na kolo – tedy změnit kdokoliv parametr virtuálního stroje
Nakonec moji američtí kolegové najednou našli kořenovou příčinu.
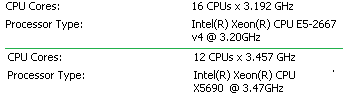
Hostitelé se lišili frekvencí!
- Obvykle to není hrozné. Ale: při přechodu z 'domovského' hostitele na hostitele s 'jinou' frekvencí musí VMware upravit výsledek GetTimePrecise.
- Obvykle to není hrozné, pokud se nejedná o aplikaci, která požaduje přesný čas milionkrát za sekundu, jako je SQL server.
- Ale ani to není hrozné, protože SQL server to nedělá vždy (viz Závěr)
Existují však případy, kdy tyto problémy pořádně zasáhnou. A ano, zaklepáním na kolo (změnou něčeho v nastavení VM) jsem donutil VMware 'přepočítat' konfiguraci, a frekvence aktuálního hostitele se stala 'domovskou' frekvencí stroje.
Řešení
Když zakážete virtualizaci TSC, čtení TSC uvnitř virtuálního stroje vrátí TSC hodnotu fyzického stroje, a zápis TSC uvnitř virtuálního stroje nemá žádný efekt. Migrace virtuálního stroje na jiného hostitele, obnovení ze pozastaveného stavu nebo návrat k snapshotu způsobuje, že TSC skáče nesouvisle. Některé operační systémy hostů se nebootují, nebo vykazují jiné problémy s časovým určením, když je virtualizace TSC zakázána. V minulosti byla tato funkce někdy doporučována ke zlepšení výkonu aplikací, které často čtou TSC., ale výkon virtuálního TSC byl v současných produktech výrazně zlepšen. Tato funkce byla také doporučena pro použití při provádění měření, která vyžadují přesný zdroj reálného času ve virtuálním stroji.
Krátce řečeno, je třeba přidat parametr
monitor_control.virtual_rdtsc = FALSE
Závěr
Určitě se ptáte: na co je potřeba tak často volat GetTimePrecise v SQL?
Nemám zdrojové kódy SQL serveru, ale logika říká toto. SQL je skoro jako operační systém s kooperativní konkurencí, kde každý vlákno by mělo čas od času "ustoupit". A kde je pro to nejlepší místo? Tam, kde je přirozené čekání – zámek nebo IO. Dobře, a co když provádíme výpočetní cykly? Jediným zřejmým místem je tedy v interpretátoru (to není úplně interpretátor), po provedení dalšího příkazu.
Obecně se SQL server nepoužívá k provádění čistých výpočtů a to není problém. Ale cykly pracující s různými dočasnými tabulkami (které se okamžitě ukládají do mezipaměti) promění kód na sekvenci velmi rychle prováděných příkazů.
Mimochodem, pokud obalíte funkci do NATIVELY COMPILED, přestane požadovat čas a její rychlost se zvýší desetkrát. A co kooperativní multitasking? Pro nativně kompilovaný kód bylo v SQL zavedeno PREEMPTIVE MULTITASKING.
Zdroj: habr.com
