

Na jakých principech je postaveno ideální Úložiště Dat?
Zaměření na obchodní hodnotu a analýzu při absenci boilerplate kódu. Správa DWH jako kódová báze: verzování, revize, automatizované testování a CI. Modularita, rozšiřitelnost, otevřený zdrojový kód a komunita. Uživatelsky přívětivá dokumentace a vizualizace závislostí (Data Lineage).
O všem tomto podrobněji a o roli DBT v ekosystému Big Data & Analytiky — vítejte pod článkem.
Ahoj všichni
Na spojení Artemij Kozyr. Již více než 5 let se zabývám úložišti dat, budováním ETL/ELT a také analýzou dat a vizualizací. V současné době pracuji ve , učím na OTUS v kurzu , a dnes se s vámi chci podělit o článek, který jsem napsal v očekávání zahájení nové vlny kurzu.
Krátký přehled
Framework DBT je vše o písmeni T v akronymu ELT (Extract — Transform — Load).
S příchodem tak výkonných a škálovatelných analytických databází jako BigQuery, Redshift, Snowflake, ztrácí jakýkoli smysl provádět transformace mimo Úložiště Dat.
DBT nevytahuje data ze zdrojů, ale poskytuje obrovské možnosti pro práci s již načtenými daty v Úložišti (v Internal nebo External Storage).
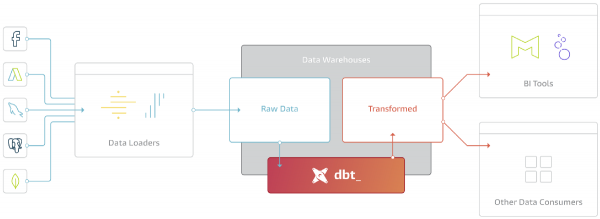
Hlavním účelem DBT je vzít kód, zkompilovat ho do SQL a vykonat příkazy ve správné posloupnosti v Úložišti.
Struktura projektu DBT
Projekt se skládá ze dvou typů adresářů a souborů:
- Model (.sql) — jednotka transformace vyjádřená SELECT dotazem
- Konfigurační soubor (.yml) — parametry, nastavení, testy, dokumentace
Na základní úrovni je práce organizována následujícím způsobem:
- Uživatel připraví kód modelů v jakémkoli pohodlném IDE
- Pomocí CLI se spouští modely, DBT kompiluje kód modelů do SQL
- Zkompilovaný SQL kód se vykonává v Úložišti v určené posloupnosti (graf)
Takto může vypadat spuštění z CLI:
Všechno je SELECT
To je killer feature frameworku Data Build Tool. Jinými slovy, DBT abstrahuje veškerý kód související s materializací vašich dotazů v Úložišti (varianty příkazů CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Každý model zahrnuje napsání jednoho SELECT dotazu, který určuje výsledný soubor dat.
Logika transformací může být vícestupňová a konsolidovat data z několika dalších modelů. Například model, který vytvoří výstavní plochu objednávek (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Co zajímavého tu můžeme vidět?
Za prvé: Používají se CTE (Common Table Expressions) — pro organizaci a porozumění kódu, který obsahuje mnoho transformací a obchodní logiky
Za druhé: Kód modelu — je směs SQL a jazyka (šablonovací jazyk).
V příkladu je použit cyklus for pro vytvoření částky pro každou platební metodu uvedenou ve výrazu set. Rovněž se používá funkce ref — možnost odkazovat v rámci kódu na další modely:
- Během kompilace ref bude převeden na cílový ukazatel na tabulku nebo pohled ve skladu
- ref umožňuje sestavit graf závislostí modelů
Přesně to přidává v DBT téměř neomezené možnosti. Nejčastěji používané z nich jsou:
- If / else statements — větvení
- For loops — cykly
- Variables — proměnné
- Macro — vytváření makra
Materializace: Table, View, Incremental
Strategie materializace — přístup, podle něhož bude výsledná datová sada modelu uložena ve skladu.
V základním pojetí to je:
- Table — fyzická tabulka ve skladu
- View — pohled, virtuální tabulka ve skladu
Existují také složitější strategie materializace:
- Incremental — inkrementální načítání (velkých faktových tabulek); nové řádky se přidávají, změněné se aktualizují, odstraněné se vymazávají
- Ephemeral — model se přímo nematerializuje, ale účastní se jako CTE v jiných modelech
- Jakékoli další strategie, které můžete přidat sami
Vedle strategií materializace se otevírají možnosti pro optimalizaci pro konkrétní sklady, například:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure views
- Redshift: Distkey, Sortkey (interleaved, compound), Late Binding Views
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags
- Spark: Formát souboru (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
V současné době jsou podporována následující úložiště:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (částečně)
- Spark (částečně)
- Microsoft SQL Server (komunitní adaptér)
Pojďme zdokonalit náš model:
- Udělejme jeho naplnění inkrementálním (Incremental)
- Přidáme segmentační a třídící klíče pro Redshift
-- Konfigurace modelu:
-- Inkrementální naplnění, unikátní klíč pro aktualizaci záznamů (unique_key)
-- Klíč segmentace (dist), klíč třídění (sort)
{{
  config(
        materialized='incremental',
        unique_key='order_id',
        dist="customer_id",
        sort="order_date"
    )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Tento filtr bude použit pouze pro inkrementální spuštění
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Graf závislostí modelů
Také známý jako strom závislostí. Také DAG (Directed Acyclic Graph — Řízený Acyklický Graf).
DBT vytváří graf na základě konfigurace všech modelů projektu, přesněji odkazů ref() uvnitř modelů na jiné modely. Přítomnost grafu umožňuje následující:
- Spouštění modelů ve správném pořadí
- Paralelizace formování vitrín
- Spuštění libovolného podgrafu
Příklad vizualizace grafu:
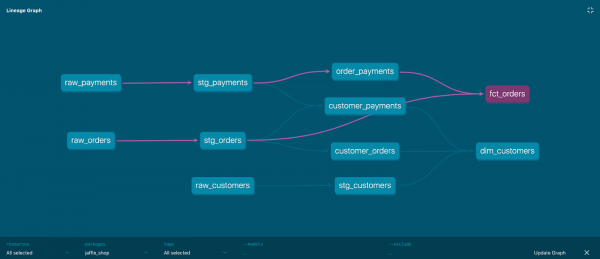
Každý uzel grafu je model, hrany grafu jsou určovány výrazem ref.
Kvalita dat a Dokumentace
Kromě formování samotných modelů umožňuje DBT testovat řadu předpokladů (assertions) o výsledném souboru dat, například:
- Not Null
- Unique
- Reference Integrity — referenční integrita (např. customer_id v tabulce orders odpovídá id v tabulce customers)
- Soulad se seznamem povolených hodnot
Je možné přidat vlastní testy (custom data tests), například % odchylky tržeb z údajů před týdnem, měsícem. Jakýkoli předpoklad formulovaný ve formě SQL dotazu se může stát testem.
Takto lze zachytit v vitrínách úložiště nežádoucí odchylky a chyby v datech.
Pokud jde o dokumentaci, DBT poskytuje mechanismy pro přidávání, verzování a distribuci metadat a komentářů na úrovni modelů a dokonce atributů.
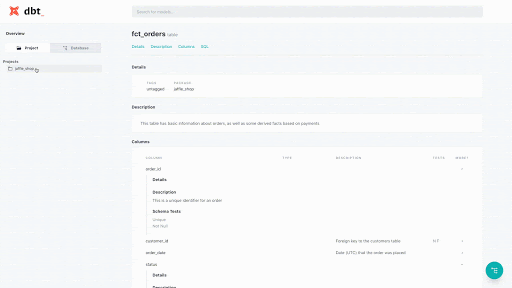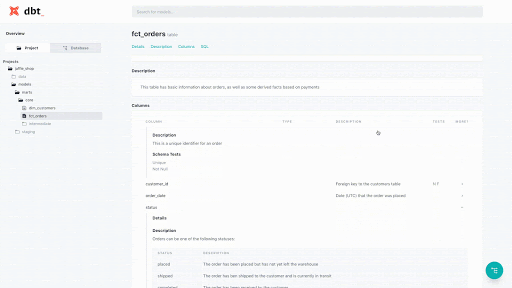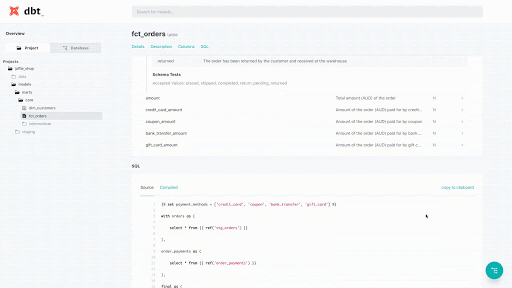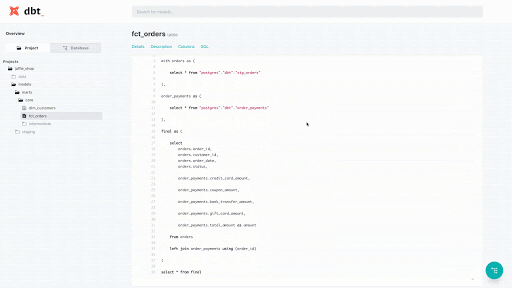
Takto vypadá přidání testů a dokumentace na úrovni konfiguračního souboru:
 - name: fct_orders
   description: Tato tabulka obsahuje základní informace o objednávkách, stejně jako některé odvozené fakta na základě plateb
   columns:
     - name: order_id
       tests:
         - unique # kontrola na jedinečnost hodnot
         - not_null # kontrola na existenci null
       description: Toto je jedinečný identifikátor objednávky
     - name: customer_id
       description: Cizí klíč na tabulku zákazníků
       tests:
         - not_null
         - relationships: # kontrola referenční integrity
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Datum (UTC), kdy byla objednávka provedena
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # kontrola na přijatelné hodnoty
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
A takto vypadá tato dokumentace již na vygenerované webové stránce:
Makra a Moduly
Účelem DBT není stát se souborem SQL skriptů, ale poskytnout uživatelům silné a bohaté nástroje pro vytváření vlastních transformací a distribuci těchto modulů.
Makra jsou sady konstrukcí a výrazů, které mohou být volány jako funkce uvnitř modelů. Makra umožňují opětovné použití SQL mezi modely a projekty podle inženýrského principu DRY (Don't Repeat Yourself).
Příklad makra:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
A jeho použití:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- volání makra
from my_table
DBT přichází s manažerem balíčků (packages), který umožňuje uživatelům publikovat a znovu používat jednotlivé moduly a makra.
To znamená možnost stáhnout a používat takové knihovny jako:
- : práce s Date/Time, Surrogate Keys, Schema tests, Pivot/Unpivot a další
- Hotové šablony vitrin pro takové služby jako a
- Knihovny pro specifické Datové sklady, například
- — Modul pro logování provozu DBT
S kompletním seznamem balíčků se můžete seznámit na .
Ještě více možností
Zde popíšu několik dalších zajímavých funkcí a implementací, které já a tým používáme pro vytváření Datového skladu v .
Oddělení provozních prostředí DEV — TEST — PROD
Dokonce i uvnitř jednoho DWH clusteru (v rámci různých schémat). Například pomocí následujícího výrazu:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Tento kód doslovně říká: pro prostředí dev, test, ci vezmi data pouze za poslední 3 dny a nic víc. To znamená, že běh v těchto prostředích bude mnohem rychlejší a vyžaduje méně zdrojů. Při spuštění v prostředí prod bude podmínka filtru ignorována.
Materializace s alternativním kódováním sloupců
Redshift je sloupcová databázová SYSTÉMA, která umožňuje zadávat algoritmy komprese dat pro každý jednotlivý sloupec. Volba optimálních algoritmů může zkrátit zabraný objem na disku o 20-50%.
Makro provést příkaz ANALYZE COMPRESSION, vytvoří novou tabulku s doporučenými algoritmy kódování sloupců, uvedenými klíči segmentace (dist_key) a řazení (sort_key), přesune do ní data a v případě potřeby odstraní starou kopii.
Podpis makra:
{{ compress_table(schema, table,
                drop_backup=False,
                comprows=none|Integer,
                sort_style=none|compound|interleaved,
                sort_keys=none|List,
                dist_style=none|all|even,
                dist_key=none|String) }}
Logování spuštění modelů
Na každé provedení modelu lze přiřadit háčky (hooks), které se budou provádět před spuštěním nebo ihned po ukončení vytvoření modelu:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
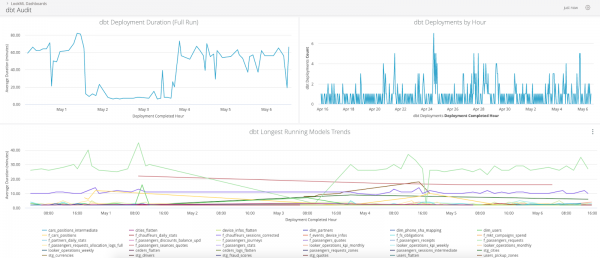
Modul logování umožní zapisovat všechny potřebné metadata do samostatné tabulky, po které lze následně provádět audit a analýzu problematických míst (bottlenecks).
Takto vypadá dashboard na datech logování v Looker:
Automatizace správy Datového skladu
Pokud používáte nějaká rozšíření funkcionality používaného Datového skladu, jako jsou UDF (uživatelsky definované funkce), verzování těchto funkcí, správa přístupů a automatizovaný deployment nových verzí je velmi pohodlné provádět v DBT.
Používáme UDF v Pythonu pro výpočet hash hodnot, domén e-mailových adres a dekódování bitových masek.
Příklad makra, které vytváří UDF v jakémkoli běhovém prostředí (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
Ve Wheely používáme Amazon Redshift, který je založen na PostgreSQL. Pro Redshift je důležité pravidelně shromažďovat statistiky o tabulkách a uvolňovat místo na disku – příkazy ANALYZE a VACUUM, resp.
Proto se každou noc vykonávají příkazy z makra redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " of " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
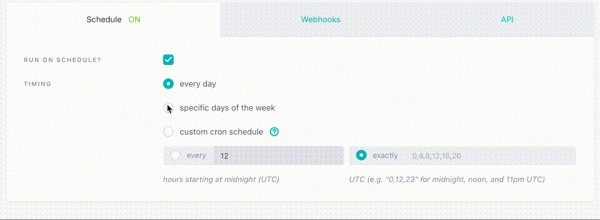
Existuje možnost využívat DBT jako službu (Managed Service). V balení:
- Web IDE pro vývoj projektů a modelů
- Konfigurace úloh a nastavení na plánování
- Snadný a pohodlný přístup k logům
- Webová stránka s dokumentací vašeho projektu
- Připojení CI (Continuous Integration)
Závěr
Příprava a užívání DWH se stává stejně příjemnou a prospěšnou jako pití smoothie. DBT se skládá z Jinja, uživatelských rozšíření (modulů), překladače, enginu (executor) a správce balíčků. Spojením těchto prvků dohromady získáváte plnohodnotné pracovní prostředí pro vaše Úložiště Dat. Dnes těžko najdete lepší způsob správy transformací uvnitř DWH.
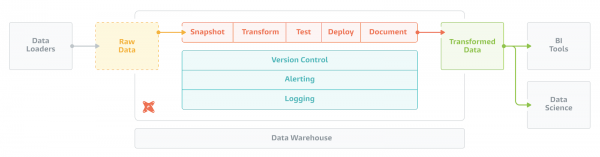
Přesvědčení, která vyznávali vývojáři DBT, se formulují takto:
- Kód, nikoli GUI, je nejlepší abstrakcí pro vyjádření složité analytické logiky.
- Práce s daty by měla přizpůsobit nejlepší praktiky vývoje softwaru (Software Engineering).
- Nejdůležitější infrastruktura pro práci s daty by měla být řízena komunitou uživatelů jako software s otevřeným zdrojovým kódem.
- Nejen analytické nástroje, ale i kód se stále častěji stává majetkem komunity Open Source.
Tato základní přesvědčení vytvořila produkt, který dnes používá více než 850 společností, a tvoří základ mnoha zajímavých rozšíření, která budou vytvořena v budoucnu.
Pro ty, kteří se zajímají, je k dispozici videozáznam otevřené lekce, kterou jsem vedl před několika měsíci v rámci otevřené lekce v OTUS — .
Kromě DBT a Úložišť Dat vedeme v rámci kurzu Data Engineer na platformě OTUS přednášky na řadu dalších aktuálních a moderních témat:
- Architektonické koncepty aplikací Velkých Dat.
- Praktiky se Spark a Spark Streaming.
- Studium metod a nástrojů pro načítání zdrojů dat.
- Vytváření analytických vitrín v DWH.
- Koncepty NoSQL: HBase, Cassandra, ElasticSearch.
- Principy organizace monitorování a orchestrace.
- Finální Projekt: shromáždíme všechny dovednosti dohromady pod mentorskou podporou.
Odkazy:
- — Oficiální dokumentace.
- — Přehledný článek od jednoho z autorů DBT.
- — YouTube, Záznam otevřené lekce OTUS.
- — Nejbližší otevřená lekce 15. května 2020.
- — OTUS.
- — Pohled do budoucnosti práce s daty a analytiky.
- — Evoluce analytiky a vliv Open Source.
- — Principy budování CI s použitím DBT.
- — Praktické, Krok za krokem pokyny pro samostatnou práci.
- — Github, kód školního projektu
Zdroj: habr.com
