

Profese Data Scientist a Data Engineer se často zaměňují. Každá společnost má svou specifiku práce s daty, různé cíle jejich analýzy a odlišné představy o tom, kdo z odborníků by se měl zabývat jakou částí práce, a proto si každý kladе své vlastní požadavky.
Podíváme se na to, jaký je rozdíl mezi těmito specialisty, jaké obchodní úkoly řeší, jaké dovednosti mají a kolik vydělávají. Materiál je rozsáhlý, a proto jsme ho rozdělili na dvě publikace.
V prvním článku Elena Gerasimova, vedoucí fakulty „“ v Netologii, vysvětluje, jaký je rozdíl mezi Data Scientist a Data Engineer a s jakými nástroji pracují.
Jak se liší role inženýrů a vědců
Datový inženýr je odborník, který na jedné straně vyvíjí, testuje a udržuje infrastrukturu pro práci s daty: databáze, úložiště a systémy pro hromadné zpracování. Na druhé straně to je ten, kdo čistí a "vyhlazuje" data pro použití analytiky a datovými vědci, tedy vytváří datové zpracovatelské kanály.
Data Scientist vytváří a trénuje prediktivní (a nejen) modely pomocí algoritmů strojového učení a neuronových sítí, čímž pomáhá podnikům nacházet skryté vzory, předpovídat vývoj událostí a optimalizovat klíčové obchodní procesy.
Hlavní rozdíl mezi Data Scientist a Data Engineer spočívá v tom, že obvykle mají různé cíle. Oba pracují na tom, aby data byla dostupná a kvalitní. Ale Data Scientist hledá odpovědi na své otázky a ověřuje hypotézy v datovém ekosystému (například na platformě Hadoop), zatímco Data Engineer vytváří pipeline pro údržbu algoritmu strojového učení, který napsal datový vědec, v clustru Spark uvnitř stejného ekosystému.
Datový inženýr přináší hodnotu podnikání tím, že pracuje v týmu. Jeho úkolem je vystupovat jako důležitý článek mezi různými účastníky: od vývojářů po obchodní uživatele reportů — a zvyšovat produktivitu analytiků — od marketingových a produktových až po BI.
Data Scientist naopak aktivně se podílí na strategii firmy a získávání insightů, rozhodovacím procesu, implementaci automatizace, modelování a generování hodnoty z dat.
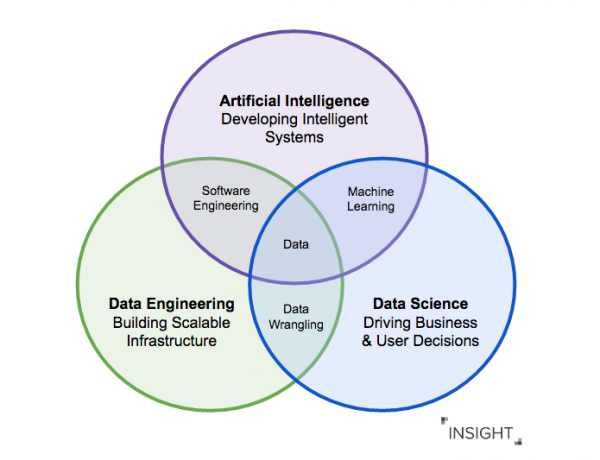
Práce s daty podléhá principu GIGO (garbage in — garbage out): pokud analytici a datoví vědci pracují s nepřipravenými a potenciálně nesprávnými daty, výsledky, i s nejpokročilejšími analytickými algoritmy, budou nesprávné.
Datoví inženýři řeší tento problém tím, že vytvářejí pipeline pro zpracování, čištění a transformaci dat, čímž umožňují datovému vědci pracovat s kvalitními daty.
Na trhu existuje mnoho nástrojů pro práci s daty, které pokrývají každý z kroků: od vzniku dat po výstup na dashboard pro představenstvo. Je důležité, aby rozhodnutí o jejich použití přijímal inženýr, ne proto, že je to trendy, ale protože to skutečně pomůže ostatním účastníkům procesu.
Pokud potřeba společnosti spočívá v integraci BI a ETL — nahrávání dat a aktualizace zpráv, pak je to typický legacy základ, se kterým se Data Engineer bude muset vypořádat (je dobré, pokud v týmu bude ještě architekt).
Povinnosti Data Engineera
- Vývoj, konstrukce a údržba infrastruktury pro práci s daty.
- Zpracování chyb a vytváření spolehlivých pipeline pro zpracování dat.
- Uvedení nestrukturovaných dat z různých dynamických zdrojů do podoby potřebné pro práci analytiků.
- Poskytování doporučení pro zlepšení konzistence a kvality dat.
- Zajištění a podpora datové architektury, kterou používají datoví vědci a analytici dat.
- Zpracování a ukládání dat konzistentně a efektivně v distribuovaném clusteru s desítkami nebo stovkami serverů.
- Hodnocení technických kompromisů nástrojů pro vytváření jednoduchých, avšak spolehlivých architektur, které dokážou přežít selhání.
- Kontrola a podpora datových toků a souvisejících systémů (nastavení monitorování a upozornění).
Existuje ještě jedna specializace v rámci dráhy Data Engineera — ML engineer. Pokud to shrneme, tito inženýři se specializují na uvedení modelů strojového učení do průmyslového nasazení a užívání. Často je model dodaný datovým vědcem součástí výzkumu a nemusí fungovat v reálných podmínkách.
Povinnosti Data Scientist
- Extrakce funkcí z dat pro aplikaci algoritmů strojového učení.
- Použití různých nástrojů strojového učení k predikci a klasifikaci vzorců v datech.
- Zvýšení výkonu a přesnosti algoritmů strojového učení díky jemnému ladění a optimalizaci algoritmů.
- Vytváření 'silných' hypotéz v souladu se strategií společnosti, které je třeba ověřit.
Jak Data Engineer, tak Data Scientist se spojují s výrazným přínosem k rozvoji kultury práce s daty, díky které může společnost získávat dodatečný zisk nebo snižovat náklady.
S jakými jazyky a nástroji pracují inženýři a vědci?
Dnes se očekávání od specialistů na zpracování dat změnila. Dříve inženýři shromažďovali velké SQL dotazy, ručně psali MapReduce a zpracovávali data pomocí nástrojů, jako je Informatica ETL, Pentaho ETL, Talend.
V roce 2020 se specialisté neobejdou bez znalosti Pythonu a moderních nástrojů pro provádění výpočtů (například Airflow), porozumění principům práce s cloudovými platformami (použití k úsporám na 'hardware', při dodržení bezpečnostních principů).
SAP, Oracle, MySQL, Redis — to jsou tradiční nástroje pro inženýry dat ve velkých společnostech. Jsou dobré, ale náklady na licence jsou tak vysoké, že se je má smysl učit pouze v průmyslových projektech. Přitom existuje bezplatná alternativa v podobě Postgres — je zdarma a hodí se nejen pro výuku.
Historicky se často objevoval požadavek na Java a Scala, i když s rozvojem technologií a přístupů tyto jazyky ustupují do pozadí.
Nicméně, hardcore BigData: Hadoop, Spark a další nástroje již nejsou nezbytnou podmínkou pro inženýry dat, ale představují různé nástroje pro řešení problémů, které nelze vyřešit tradičním ETL.
V trendu jsou služby, které umožňují využívat nástroje bez znalosti jazyka, ve kterém jsou napsány (například Hadoop bez znalosti Java), stejně jako poskytování hotových služeb pro zpracování streamovaných dat (rozpoznávání hlasu nebo obrazů na videu).
Průmyslová řešení od SAS a SPSS jsou populární, přičemž Tableau, Rapidminer, Stata a Julia jsou také široce používány datovými vědci pro místní úkoly.
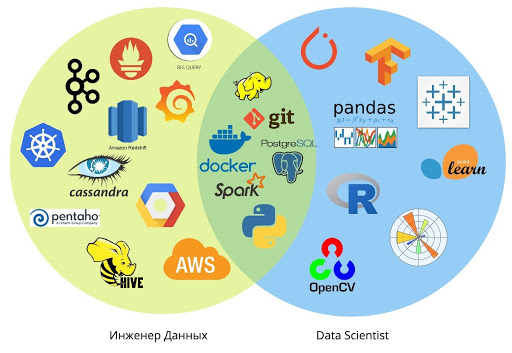
Možnost vytvářet pipeline se analytikům a datovým vědcům objevila teprve před pár lety: například je nyní možné pomocí relativně jednoduchých skriptů směrovat data do úložiště založeného na PostgreSQL.
Obvykle zůstává používání pipeline a integrovaných datových struktur v kompetenci datových inženýrů. Ale dnes je trend na T-odborníky silnější než kdy dříve — s širokými kompetencemi v příbuzných oblastech, jelikož se nástroje neustále zjednodušují.
Proč by měli Data Engineer a Data Scientist spolupracovat
Prací v úzké spolupráci s inženýry se mohou datoví vědci zaměřit na výzkumnou část a vytvářet algoritmy strojového učení připravené k použití.
A inženýři se mohou soustředit na škálovatelnost, znovupoužití dat a zajištění toho, aby pipelines pro vstup a výstup dat v každém jednotlivém projektu vyhovovaly globální architektuře.
Takové rozdělení povinností zajišťuje konzistenci mezi skupinami odborníků, kteří pracují na různých projektech strojového učení.
Spolupráce pomáhá efektivně vytvářet nové produkty. Rychlost a kvalita se dosahují díky rovnováze mezi vytvářením služeb pro všechny (globální úložiště nebo integrace dashboardů) a realizací každé konkrétní potřeby či projektu (specializovaná pipeline, propojení externích zdrojů).
Úzká spolupráce s datovými vědci a analytiky pomáhá inženýrům rozvíjet analytické a výzkumné dovednosti pro psaní kvalitnějšího kódu. Zlepšuje se výměna znalostí mezi uživateli úložišť a datových jezer, což činí projekty flexibilnějšími a zaručuje trvalejší výsledky.
Ve firmách, které mají za cíl rozvoj kultury práce s daty a budování obchodních procesů na jejich základě, se datoví vědci a datoví inženýři vzájemně doplňují a vytvářejí komplexní systém analýzy dat.
V následujícím materiálu se podíváme na to, jaké vzdělání by měli mít datoví inženýři a datoví vědci, jaké dovednosti by měli rozvíjet a jaký je trh.
Od redakce Netologie
Pokud se zvažujete povolání Data Engineera nebo Data Scientista, zveme vás k prozkoumání našich kurzů:
- Povolání „».
- Povolání „».
Zdroj: habr.com
