

DataHub s otevřeným zdrojovým kódem: platforma pro vyhledávání a objevování metadat od LinkedIn
Rychlé vyhledávání potřebných dat je nezbytné pro každou společnost, která se spoléhá na velké množství dat při rozhodování na jejich základě. To nejen ovlivňuje produktivitu uživatelů dat (včetně analytiků, vývojářů strojového učení, specialistů na zpracování dat a datových inženýrů), ale také má přímý dopad na konečné produkty, které závisí na kvalitním strojovém učení (ML) pipeline. Kromě toho trend implementace nebo vytváření strojově učených platforem přirozeně vyvolává otázku: jaká je vaše metoda vnitřního objevování funkcí, modelů, metrik, datových sad atd.
V tomto článku vám přiblížíme, jak jsme publikovali zdroj dat pod otevřenou licencí na naší platformě pro vyhledávání a objevování metadat od prvních dnů projektu . LinkedIn udržuje vlastní verzi DataHub odděleně od veřejně dostupné verze. Začneme vysvětlením, proč potřebujeme dvě oddělené vývojové prostředí, poté budeme diskutovat o prvních přístupech k využívání WhereHows s otevřeným zdrojovým kódem a porovnáme naši interní (produkční) verzi DataHub s verzí na . Také se podělíme o podrobnosti o našem novém automatizovaném řešení pro odesílání a přijímání aktualizací s otevřeným zdrojovým kódem, abychom synchronizovali oba repozitáře. Nakonec poskytneme pokyny, jak začít používat DataHub s otevřeným zdrojovým kódem a stručně probereme jeho architekturu.
WhereHows je nyní DataHub!
Tým metadat LinkedIn dříve představil (nástupce WhereHows), platformu pro vyhledávání a objevování metadat LinkedIn a sdílel plány na jeho otevření. Krátce po tomto oznámení jsme vydali alfa verzi DataHub a sdíleli ji se komunitou. Od té doby jsme neustále přispívali do repozitáře a spolupracovali se zainteresovanými uživateli na přidání nejžádanějších funkcí a řešení problémů. Nyní s radostí oznamujeme oficiální vydání .
Přístupy s otevřeným zdrojovým kódem
WhereHows, původní portál LinkedIn pro vyhledávání dat a jejich původu, byl spuštěn jako interní projekt; tým metadat jej otevřel Od té doby tým vždy podporoval dvě různé základny kódu — jednu pro otevřený zdrojový kód a druhou pro interní použití LinkedIn, protože ne všechny funkce produktu vyvinuté pro využití LinkedIn byly obecně aplikovatelné pro širší publikum. Navíc má WhereHows některé interní závislosti (infrastruktura, knihovny atd.), jejichž zdrojový kód není otevřený. V následujících letech prošel WhereHows mnoha iteracemi a vývojovými cykly, což učinilo synchronizaci dvou základů kódu velkým problémem. Tým pro metadata se po mnoho let snažil použít různé přístupy k synchronizaci interního vývoje a vývoje s otevřeným zdrojem.
První pokus: „Nejprve otevřený kód“
Původně jsme dodržovali model vývoje „nejprve otevřený zdrojový kód“, kde probíhá hlavní vývoj v repozitáři s otevřeným zdrojovým kódem a změny se provádějí pro interní nasazení. Problém s tímto přístupem spočívá v tom, že kód je vždy nejprve odeslán na GitHub, než bude plně prověřen interně. Dokud nebudou provedeny změny z repozitáře s otevřeným zdrojovým kódem a nebude provedeno nové interní nasazení, žádné výrobní problémy neobjevíme. V případě špatného nasazení bylo také velmi obtížné určit viníka, protože změny se prováděly hromadně.
Navíc tento model snížil produktivitu týmu při vývoji nových funkcí, které vyžadovaly rychlé iterace, protože nutily všechny změny nejprve umístit do repozitáře s otevřeným zdrojem a poté je přenést do interního repozitáře. Aby se zkrátila doba zpracování, potřebná oprava nebo změna mohla být provedena nejprve v interním repozitáři, ale to se stalo obrovským problémem, když přišlo na sloučení těchto změn zpět do repozitáře s otevřeným zdrojem, protože se obě repozitáře dostaly z synchronizace.
Tento model je mnohem jednodušší implementovat pro obecné platformy, knihovny nebo infrastrukturní projekty než pro plně funkční uživatelské webové aplikace. Navíc je tento model ideální pro projekty, které začínají s otevřeným zdrojovým kódem od prvního dne, ale WhereHows byl vytvořen jako plně interní webová aplikace. Bylo opravdu obtížné se zcela abstrahovat od všech interních závislostí, takže jsme museli zachovat interní větev, ale uchování interní větve a vývoj převážně s otevřeným zdrojovým kódem úplně nefungovaly.
Druhý pokus: „Nejprve interně“
** V rámci druhého pokusu jsme přešli na model vývoje „nejprve interně“, kde se hlavní vývoj odehrává uvnitř společnosti a změny jsou pravidelně prováděny v otevřeném zdrojovém kódu. I když je tento model nejvhodnější pro naši použití, nese s sebou problémy. Přímé odesílání všech rozdílů do repozitáře s otevřeným zdrojovým kódem a následné pokusy řešit konflikty sloučení později je možnost, ale zabírá spoustu času. Vývojáři se v mnoha případech snaží tomu vyhnout při každé revizi kódu. Výsledkem bude, že to bude prováděno mnohem méně často, po dávkách, což tím pádem ztěžuje následné řešení konfliktů sloučení.
Po třetí to vyšlo!
Dvě výše zmíněné neúspěšné pokusy vedly k tomu, že repozitář WhereHows na GitHubu zůstal dlouho zastaralý. Tým nadále vylepšoval funkce a architekturu produktu, a proto se interní verze WhereHows pro LinkedIn stával stále sofistikovanější než verze s otevřeným zdrojovým kódem. Dokonce měla nové jméno — DataHub. Na základě předchozích neúspěšných pokusů se tým rozhodl vyvinout škálovatelné dlouhodobé řešení.
Pro každý nový projekt s otevřeným zdrojovým kódem tým vývojářů otevřeného zdroje LinkedIn poradenství a podporuje model vývoje, ve kterém jsou moduly projektu plně vyvíjeny s otevřeným zdrojovým kódem. Artefakty s podporou verzí jsou nasazovány v veřejném repozitáři a poté se vrací do interního artefaktu LinkedIn pomocí Následující vývojový model je výhodný nejen pro ty, kteří používají otevřený zdrojový kód, ale také vede ke vzniku modulárnější, rozšiřitelné a propojitelné architektury.
Abychom však dosáhli tohoto stavu pro zralou interní aplikaci, jako je DataHub, bude třeba značného množství času. To také vylučuje možnost otevřeného zdroje plně funkční implementace, dokud nebudou všechny interní závislosti zcela abstrahovány. Proto jsme vyvinuli nástroje, které nám pomáhají přispívat do otevřeného zdroje rychleji a mnohem méně bolestně. Toto řešení je výhodné jak pro tým metadat (vývojář DataHub), tak pro komunitu otevřeného zdroje. V následujících sekcích bude projednán tento nový přístup.
Automatizace publikace s otevřeným zdrojem
Poslední přístup týmu metadat k DataHubu s otevřeným zdrojem spočívá ve vývoji nástroje, který automaticky synchronizuje interní kódovou základnu a repozitář s otevřeným zdrojem. Hlavní funkce tohoto nástroje zahrnují:
- Synchronizaci kódu LinkedIn s / z otevřeného zdroje, obdobně jako .
- Generování licenčního záhlaví, podobně jako .
- Automatické vytváření protokolů commitů s otevřeným zdrojem z interních protokolů commitů.
- Prevenci interních změn, které narušují sestavení s otevřeným zdrojem, pomocí .
V následujících pododdílech budou podrobně prozkoumány výše zmíněné funkce s zajímavými problémy.
Synchronizace zdrojového kódu
Na rozdíl od verze DataHub s otevřeným zdrojem, která představuje jediný repozitář GitHub, verze DataHub pro LinkedIn je kombinací několika repozitářů (v rámci společnosti nazývaných ). Rozhraní DataHub, knihovna modelů metadat, serverová služba pro ukládání metadat a streamovací úkoly se nacházejí v různých repozitářích na LinkedIn. Nicméně abychom usnadnili práci uživatelům s otevřeným zdrojem, máme jediný repozitář pro verzi DataHub s otevřeným zdrojem.
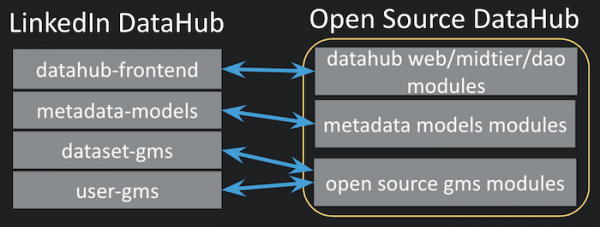
Obrázek 1: Synchronizace mezi repozitáři LinkedIn DataHub a jediným repozitářem DataHub s otevřeným zdrojovým kódem
Pro podporu automatických pracovních procesů pro sestavení, odesílání a získávání náš nový nástroj automaticky vytváří přiřazení na úrovni souboru odpovídající každému zdrojovému souboru. Nicméně pro nástroj je zapotřebí počáteční konfigurace a uživatelé musí poskytnout vysoceúrovňové zobrazení modulů, jak je uvedeno níže.
{
  "datahub-dao": [
    "${datahub-frontend}\/datahub-dao"
  ],
  "gms\/impl": [
    "${dataset-gms}\/impl",
    "${user-gms}\/impl"
  ],
  "metadata-dao": [
    "${metadata-models}\/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}\/metadata-builders"
  ]
}
Přiřazení na úrovni modulu je jednoduchý JSON, jehož klíče jsou cílové moduly v repozitáři s otevřeným zdrojovým kódem a hodnoty jsou seznamem zdrojových modulů v repozitářích LinkedIn. Jakýkoli cílový modul v repozitáři s otevřeným zdrojovým kódem může fungovat s libovolným počtem zdrojových modulů. Pro označení interních názvů repozitářů ve zdrojových modulech se používá ve stylu Bash. Pomocí souboru přiřazení na úrovni modulu nástroje vytvářejí soubor přiřazení na úrovni souborů skenováním všech souborů ve vzájemně propojených adresářích.
{
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java",
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java",
  "${metadata-models}\/metadata-builders\/build.gradle": null,
}
Přiřazení na úrovni souboru se automaticky vytváří nástroji; může být také aktualizováno uživatelem ručně. Toto přiřazení 1:1 pro zdrojový soubor LinkedIn s souborem v repozitáři s otevřeným zdrojovým kódem. Existuje několik pravidel týkajících se tohoto automatického vytváření přiřazení souborů:
- V případě, že existuje několik zdrojových modulů pro cílový modul v otevřeném zdroji, mohou nastat konflikty, například stejný , který existuje ve více než jednom zdrojovém modulu. Jako strategii pro řešení konfliktů naše nástroje ve výchozím nastavení používají možnost "poslední vyhrává".
- "null" znamená, že zdrojový soubor není součástí repozitáře s otevřeným zdrojovým kódem.
- Po každém odeslání do otevřeného zdroje nebo jeho vytažení se toto mapování automaticky aktualizuje a vytváří se snímek. To je nezbytné pro určení přidání a odebrání zdrojového kódu po poslední akci.
Vytváření záznamů o commitech
Záznamy o commitech pro commity s otevřeným zdrojem se také automaticky vytvářejí sloučením záznamů o commitech interních repozitářů. Níže je uveden příklad záznamu o commitu, který ukazuje strukturu záznamu o commitu vytvořeného naším nástrojem. Commit jasně uvádí, které verze zdrojových repozitářů jsou zabaleny do tohoto commitu, a poskytuje souhrnné informace o záznamu o commitu. Zkontrolujte tento na reálném příkladu záznamu o commitu vytvořeného naším nástrojem.
metadata-models 29.0.0 -> 30.0.0
    Přidán model aspektu foo
    Opraven problém bar

dataset-gms 2.3.0 -> 2.3.4
    Přidán rest.li API k obsluze aspektu foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testování závislostí
LinkedIn má , která pomáhá zaručit, že změny interního multi-projektu neporuší sestavení závislých multi-projektů. Repozitář DataHub s otevřeným zdrojem není multi-projektový, a nemůže být přímou závislostí na jakémkoli multi-projektu, ale pomocí multi-projektového obalu, který vytahuje zdrojový kód DataHub s otevřeným zdrojem, stále můžeme tuto systém testování závislostí používat.. Tímto pádem jakákoli změna (která může být později veřejně zveřejněna) v jakémkoli z multi-projektů, které živí repozitář DataHub s otevřeným zdrojem, spouští událost sestavení v multi-projektovém obalu. Proto jakákoli změna, která neumožňuje sestavit multi-projekt-obal, neprojde testy před commitem zdrojového multi-projektu a je vrácena.
To je užitečný mechanismus, který pomáhá zabránit jakémukoli internímu commitu, který porušuje sestavení s otevřeným zdrojem, a odhaluje ho během vytváření commitu. Bez tohoto by bylo docela obtížné určit, který interní commit vedl k selhání sestavení repozitáře s otevřeným zdrojem, protože umísťujeme balíkové interní změny do repozitáře DataHub s otevřeným zdrojem.
Rozdíly mezi DataHub s otevřeným zdrojovým kódem a naší produkční verzí
Doposud jsme diskutovali o našem řešení pro synchronizaci dvou verzí repozitářů DataHub, ale dosud jsme neoznačili důvody, proč potřebujeme dvě různé vývojové toky. V této části uvedeme rozdíly mezi veřejnou verzí DataHub a produkční verzí na serverech LinkedIn a vysvětlíme důvody těchto rozdílů.
Jedním ze zdrojů nesrovnalostí je skutečnost, že naše produkční verze závisí na kódu s ještě neotevřeným zdrojovým kódem, jako je Offspring LinkedIn (interní struktura správy závislostí LinkedIn). Offspring je široce používán ve vnitřní kódové základně, protože je preferovanou metodou řízení dynamické konfigurace. Ale to není s otevřeným zdrojovým kódem; proto jsme museli najít alternativy s otevřeným zdrojovým kódem pro DataHub s otevřeným zdrojovým kódem.
Existují i další důvody. Jak vytváříme rozšíření modelu metadat pro potřeby LinkedIn, tato rozšíření jsou obvykle velmi specifická pro LinkedIn a nemohou být přímo aplikována na jiné prostředí. Například máme velmi specifické štítky pro identifikátory účastníků a další typy metadat odpovídající. V současné době jsme tato rozšíření vyloučili z modelu metadat DataHub s otevřeným zdrojovým kódem. Jak budeme komunikovat s komunitou a chápat jejich potřeby, budeme pracovat na společných verzích těchto rozšíření s otevřeným zdrojovým kódem, kde to bude nutné.
Jednoduchost použití a snazší přizpůsobení pro komunitu otevřeného zdroje také inspirovaly některé rozdíly mezi oběma verzemi DataHub. Rozdíly v infrastruktuře streamování jsou dobrým příkladem. Zatímco naše interní verze používá infrastrukturu spravovaného streamování, rozhodli jsme se pro verzi s otevřeným zdrojovým kódem použít vestavěné (autonomní) streamování, protože to umožňuje vyhnout se vytváření další závislosti na infrastruktuře.
Další příklad rozdílu — existence jednoho GMS (Generální úložiště metadat) v implementaci s otevřeným zdrojovým kódem, místo několika GMS. GMA (Generální architektura metadat) je název interní architektury pro DataHub, zatímco GMS je úložiště metadat v kontextu GMA. GMA je velmi flexibilní architektura, která vám umožňuje distribuovat každou konstrukci dat (např. datové sady, uživatele atd.) do vlastního úložiště metadat nebo uchovávat několik konstrukcí dat v jednom úložišti metadat, dokud je registr, který obsahuje mapování struktury dat v GMS, aktualizován. Pro jednodušší použití jsme zvolili jednu instanci GMS, která uchovává všechny různé konstrukce dat v DataHubu s otevřeným zdrojovým kódem.
Úplný seznam rozdílů mezi dvěma implementacemi je uveden v tabulce níže.
Funkce produktu
LinkedIn DataHub
Open Source DataHub
Podporované datové konstrukce
1) Datové sady 2) Uživatelé 3) Metodiky 4) ML funkce 5) Grafy 6) Dashboardy
1) Datové sady 2) Uživatelé
Podporované zdroje metadat pro datové sady
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Zpracování streamů
Managed
Embedded (samostatné)
Vkládání závislostí a dynamická konfigurace
LinkedIn Offspring
Nástroje pro sestavení
Ligradle (interní Gradle wrapper LinkedInu)
CI/CD
CRT (interní CI/CD LinkedInu)
and
Úložiště metadat
Distribuované více GMS: 1) Dataset GMS 2) User GMS 3) Metric GMS 4) Feature GMS 5) Chart/Dashboard GMS
Jednotlivé GMS pro: 1) Datové sady 2) Uživatelé
Mikroslužby v kontejnerech Docker
usnadňují nasazení a distribuci aplikací pomocí Každá část služby v DataHubu s otevřeným zdrojovým kódem, včetně komponent infrastrukturní, jako je Kafka, , a , má svůj vlastní obraz Docker. Pro orchestraci kontejnerů Docker jsme použili .
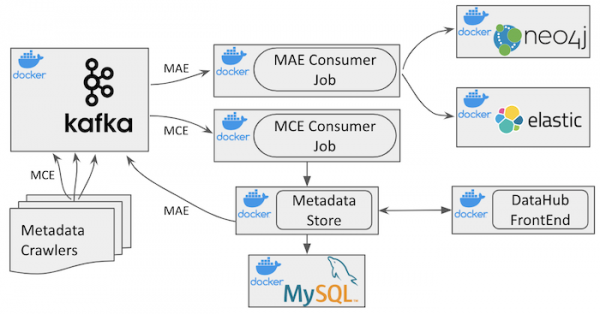
Obrázek 2: Architektura DataHub *s otevřeným zdrojovým kódem*
Můžete vidět vysoce úrovňovou architekturu DataHubu na obrázku výše. Kromě komponent infrastruktury má čtyři různé kontejnery Docker:
datahub-gms: služba úložiště metadat
datahub-frontend: aplikace , která poskytuje rozhraní DataHub.
datahub-mce-consumer: aplikace , která používá proud událostí změny metadat (MCE) a aktualizuje úložiště metadat.
datahub-mae-consumer: aplikace , která používá proud událostí auditu metadat (MAE) a vytváří databázi vyhledávacího indexu a grafu.
Dokumentace k repozitáři s otevřeným zdrojovým kódem a obsahují podrobnější informace o funkcích různých služeb.
CI / CD v DataHub s otevřeným zdrojovým kódem
Repozitář DataHub s otevřeným zdrojovým kódem využívá pro kontinuální integraci a pro kontinuální nasazení. Obě mají dobrou integraci s GitHubem a jsou snadno konfigurovatelné. Většina infrastruktury s otevřeným zdrojovým kódem, kterou vyvinuli komunity nebo soukromé společnosti (např., ), vytvořila obrazy Docker, které jsou nasazovány na Docker Hub pro usnadnění používání komunitou. Jakýkoliv obraz Docker nalezený na Docker Hub lze snadno použít prostřednictvím jednoduchého příkazu .
Při každém commitu v repozitáři s otevřeným zdrojovým kódem DataHub jsou všechny obrazy Docker automaticky vytvářeny a nasazovány na Docker Hub s tagem „latest“. Pokud je na Docker Hub nastavena nějaká , budou všechny tagy v repozitáři s otevřeným zdrojovým kódem také vydávány s odpovídajícími názvy tagů na Docker Hub.
Použití DataHub
je velmi jednoduché a skládá se ze tří jednoduchých kroků:
- Naklonujte repozitář s otevřeným zdrojovým kódem a spusťte všechny kontejnery Docker pomocí docker-compose podle poskytnutého skriptu docker-compose pro rychlý start.
- Stáhněte si vzorky dat uvedené v repozitáři pomocí nástroje příkazového řádku, který je také k dispozici.
- Prohlédněte si DataHub v prohlížeči.
Aktivně sledovaný je také nastaven pro rychlé dotazy. Uživatelé mohou také vytvářet problémy přímo v repozitáři GitHub. A co je nejdůležitější, vítáme a ceníme si veškeré zpětné vazby a návrhů!
Plány do budoucna
V současné době je každá infrastruktura nebo mikroslužba pro DataHub s otevřeným zdrojovým kódem postavena jako kontejner Docker a celý systém je orchestrace pomocí . Vzhledem k oblibě a širokému rozšíření , bychom také chtěli poskytnout řešení založené na Kubernetes v blízké budoucnosti.
Také plánujeme poskytnout hotové řešení pro nasazení DataHub v veřejné cloudové službě, jako je , nebo . Vzhledem k nedávnému oznámení o migraci LinkedIn na Azure, to bude odpovídat interním prioritám skupiny metadat.
A nakonec, ale ne méně důležité: děkujeme všem prvním uživatelům DataHub v komunitě s otevřeným zdrojovým kódem, kteří ocenili alfa verze DataHub a pomohli nám odhalit problémy a zlepšit dokumentaci.
Zdroj: habr.com
