

Při složitém zpracování velkých datových sad (různých : importy, konverze a synchronizace s externím zdrojem) často nastává potřeba dočasně "zapamatovat" a ihned rychle zpracovat něco objemného.
Typická úloha podobného druhu obvykle zní takto: "Tady poslední přijaté platby, musíme je rychle nahrát na web a přiřadit k účtům"
Ale když objem tohoto „něčeho“ začíná být měřitelný v desítkách megabajtů a služba musí zároveň pracovat s databází v režimu 24 × 7, objevuje se mnoho vedlejších efektů, které vám mohou znesnadnit život.
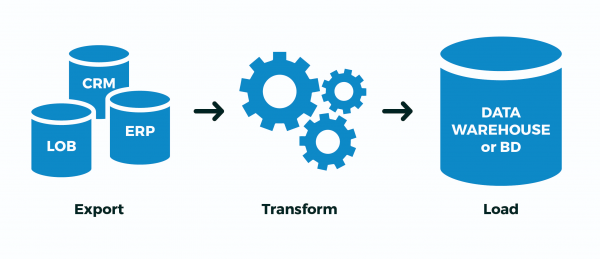
Abychom se s nimi vypořádali v PostgreSQL (a nejen v něm), můžeme využít některé možnosti optimalizace, které umožní zpracovat vše rychleji a s menšími nároky na zdroje.
1. Kam nahrávat?
Nejprve si ujasněme, kam můžeme nahrát data, která chceme „zpracovat“.
1.1. Dočasné tabulky (TEMPORARY TABLE)
V zásadě jsou dočasné tabulky v PostgreSQL stejné jako jakékoli jiné. Proto jsou nepřesné pověry jako "tam se všechno ukládá jen do paměti, a ta může dojít". Ale existuje i několik zásadních rozdílů.
Svůj „namespace“ pro každé připojení k DB
Pokud se dva spojení pokusí současně provést CREATE TABLE x, pak někdo určitě obdrží chybovou zprávu o nejedinečnosti objektů DB.
Pokud však oba provedou příkaz VYTVOŘIT DOČASNOU TABULKU x, pak to oba úspěšně udělají a každý obdrží svůj vlastní exemplář tabulky. A mezi nimi nebude nic společného.
"Sebevražda" při odpojení
Při uzavření připojení se všechny dočasné tabulky automaticky odstraní, takže nemá smysl provádět DROP TABLE x , kromě…
Pokud pracujete přes pgbouncer v režimu transakce, databáze stále považuje toto spojení za aktivní, a v něm tato dočasná tabulka stále existuje.
Pokud se tedy pokusíte vytvořit ji znovu již z jiného připojení k pgbouncer, dojde k chybě. Ale lze to obejít pomocí VYTVOŘTE DOČASNOU TABULKU POKUD NEEXISTUJE x.
Je pravda, že je lepší to tak nedělat, protože pak můžete "náhodně" objevit data, která zanechal "předchozí majitel". Místo toho je mnohem lepší si přečíst manuál a zjistit, že při vytváření tabulky máte možnost přidat PO PŘIHLÁŠENÍ DROP — to znamená, že po dokončení transakce bude tabulka automaticky odstraněna.
Nereplikace
Z důvodu příslušnosti pouze k určitému spojení, dočasné tabulky se nereplikují. Nicméně to zbavuje nutnosti duplicitního zápisu dat v heap + WAL, takže INSERT/UPDATE/DELETE do ní je výrazně rychlejší.
Ale protože dočasná tabulka je přece jen "téměř běžná" tabulka, tak ji nelze vytvořit ani na replikaci. Minimálně zatím, ačkoli příslušný patch už dávno existuje.
1.2. Nježurnálované tabulky (UNLOGGED TABLE)
Ale co dělat, pokud máte nějaký obsáhlý ETL proces, který nelze realizovat v rámci jedné transakce, a přitom máte pgbouncer v režimu transakce?..
Nebo je tok dat tak velký, že nedostatečná propustnost jednoho spojení s DB (čti, jednoho procesu na CPU)?..
Nebo část operací probíhá asynchronně v různých připojeních?..
Tady je jen jedna možnost — dočasně vytvořit ne-dočasnou tabulku. Hra se slovy, že? To znamená:
- vytvořil "své" tabulky s maximálně náhodnými názvy, abych se s nikým nesetkal
- Extract: nahrál do nich data z externího zdroje
- Transform: transformoval, vyplnil klíčové vazebné pole
- Načtení: přelil hotová data do cílových tabulek
- smazal "své" tabulky
A teď — lžíce dehtu. V podstatě, každý zápis v PostgreSQL probíhá dvakrát — , poté již do těl tabulek/indexů. To vše bylo uděláno pro podporu ACID a správné viditelnosti dat mezi COMMITvnitřními a ROLLBACKvnitřními transakcemi.
Ale my to nepotřebujeme! Náš celý proces buď úspěšně proběhl, nebo ne.. Není důležité, kolik v něm bude mezitímních transakcí — nezajímá nás "pokračovat v procesu ze středu", obzvlášť když není jasné, kde byl.
K tomu vývojáři PostgreSQL už v verzi 9.1 zavedli něco, jako :
S tímto označením se tabulka vytváří jako nežurnálová. Data zapisovaná do nežurnálovaných tabulek neprocházejí skrze předzáznamový deník (viz Kapitola 29), v důsledku čehož takové tabulky pracují mnohem rychleji než obvyklé.Nicméně, nejsou chráněny před selháním; při selhání nebo havarijním vypnutí serveru se nežurnálovaná tabulka automaticky zruší.Kromě toho obsah nežurnálované tabulky se nereplikuje. na řízené servery. Jakékoli indexy vytvořené pro nezapisované tabulky se automaticky stávají nezapisovanými.
Zkrátka, bude to výrazně rychlejší, ale pokud server DB „spadne“ — bude to nepříjemné. Ale jak často se to stává a dokáže váš ETL proces to správně zpracovat „od půlky“ po „obnovení“ DB?..
Pokud ne, a váš případ výše je podobný — použijte UNLOGGED, ale nikdy nezapínejte tento atribut u skutečných tabulek, jejichž data jsou pro vás cenná.
1.3. ON COMMIT { DELETE ROWS | DROP }
Tato konstrukce umožňuje při vytváření tabulky určit automatické chování při dokončení transakce.
O PO PŘIHLÁŠENÍ DROP už jsem zmínil výše, generuje to DROP TABLE, ale situace s PO PŘIHLÁŠENÍ SMAZAT ŘÁDKY je zajímavější — zde se generuje TRUNCATE TABLE.
Jelikož celá infrastruktura ukládání meta popisu do dočasné tabulky je stejná jako u běžné, činí neustálé vytváření a odstraňování dočasných tabulek výrazné „nabobtnání“ systémových tabulek pg_class, pg_attribute, pg_attrdef, pg_depend,…
Nyní si představte, že máte worker na přímém spojení s DB, který každou sekundu otevírá novou transakci, vytváří, naplní, zpracovává a odstraňuje dočasnou tabulku… Odpad v systémových tabulkách se hromadí, což způsobuje zbytečné zpomalení při každé operaci.
Celkově to tak nedělejte! V tomto případě je mnohem efektivnější VYTVÁŘENÍ DOČASNÉ TABULKY x ... ON COMMIT DELETE ROWS vytáhnout mimo cyklus transakcí — pak na začátku každé nové transakce tabulky již existovat budou (šetříme výzvu VYTVOŘIT), ale bude prázdná, díky TRUNCATE (jeho výzvu jsme také ušetřili) při dokončení předchozí transakce.
1.4. LIKE… INCLUDING …
Zmínil jsem na začátku, že jedním z typických případů použití dočasných tabulek jsou různé importy — a vývojář unaveně kopíruje seznam polí cílové tabulky do deklarace své dočasné…
Ale lenost je hybatelem pokroku! Proto vytvořit novou tabulku "podle vzoru" je mnohem jednodušší:
VYTVOŘENÍ DOČASNÉ TABULKY import_table(
  LIKE target_table
);
Jelikož lze do této tabulky generovat poměrně velké množství dat, hledání v ní nebude zrovna rychlé. Ale proti tomu existuje tradiční řešení — indexy! A ano, i dočasná tabulka může mít indexy.
Protože se často potřebné indexy shodují s indexy cílové tabulky, lze jednoduše napsat JAKO target_table VČETNĚ INDEXŮ.
Pokud potřebujete také DEFAULT- hodnoty (například k vyplnění hodnot primárního klíče) můžete využít JAKO target_table ZAPNOUT MEZINÁRODNÍ VARIANTY. Nebo jednoduše — JAKO target_table VČETNĚ VŠEHO — zkopíruje výchozí hodnoty, indexy, omezení,…
Ale tady už musíte pochopit, že pokud jste vytvářeli importní tabulku rovnou s indexy, budou se data nahrávat déle, než když je nejprve všechny nahrajete a poté naindexujete — podívejte se jako příklad, jak to dělá .
Obecně, !
2. Jak psát?
Řeknu jednoduše — používejte - proud místo „partií“ INSERT, . Můžete dokonce přímo z předem připraveného souboru.
3. Jak zpracovávat?
Takže, naše vstupní data vypadají přibližně takto:
- máte v databázi tabulku s klientskými daty na 1M záznamů
- každý den vám klient posílá nový úplný „obraz“
- podle zkušeností víte, že od případu k případu se mění maximálně 10K záznamů
Klasickým příkladem takové situace je — je sice hodně adres, ale v každém týdenním výstupu změn (přejmenování obcí, slučování ulic, objevování nových domů) je jich velmi málo i v celostátním měřítku.
3.1. Algoritmus úplné synchronizace
Pro zjednodušení předpokládejme, že nemusíte data restrukturovat — stačí tabulku přivést do potřebného stavu, tedy:
- odstranit všechno, co už neexistuje
- aktualizovat všechno, co už bylo a je třeba aktualizovat
- vložit všechno, co ještě nebylo
Proč by se měly operace provádět právě v tomto pořadí? Protože tak se velikost tabulky zvýší minimálně ().
DELETE FROM dst
Ne, samozřejmě je možné se obejít s pouhými dvěma operacemi:
- odstranit (
DELETE) úplně všechno - vložit vše z nového obrazu
Ale s pomocí MVCC, se velikost tabulky zvýší přesně dvakrát! Získat +1M obrazů záznamů v tabulce z aktualizace 10K — to je dost zbytečné…
TRUNCATE dst
Zkušenější vývojář ví, že celou tabulku lze relativně levně vymazat:
- vymazat (
TRUNCATE) celou tabulku - vložit vše z nového obrazu
Metoda je efektivní, , ale je tu problém... Nahrávat 1M záznamů bude trvat pří-í-íliš dlouho, a proto si nemůžeme dovolit nechat tabulku prázdnou po celou tuto dobu (jak by se stalo bez obalení do jediné transakce).
To znamená:
- začínáme dlouhou transakci
TRUNCATEaplikuje AccessExclusive-zámku- dlouho provádíme vložení, zatímco všichni ostatní v tuto dobu vůbec nemohou
nebude prováděn při nepravdivosti první podmínky. Opravy pomocí
Něco nevypadá dobře…
ALTER TABLE… RENAME… / DROP TABLE …
Jednou z možností je nahrát vše do nové tabulky a poté ji jednoduše přejmenovat za starou. Existuje několik nepříjemných drobností:
- také AccessExclusive, i když to trvá výrazně méně času
- všechny plány dotazů/statistiky této tabulky se resetují,
- všechny externí klíče se porušují (FK) na tabulku
Existoval WIP patch od Simona Riggse, který navrhoval provést ALTER-operaci pro výměnu těla tabulky na úrovni souborů, aniž by se dotklo statistik a FK, ale nezískal potřebný počet hlasů.
DELETE, UPDATE, INSERT
Takže se zastavujeme na neblokující variantě ze tří operací. Téměř tří… Jak to udělat co nejefektivněji?
-- vše provádíme v rámci transakce, aby nikdo neviděl "mezistavy"
BEGIN;

-- vytváříme dočasnou tabulku s importovanými daty
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- podle vzoru i spolu s indexy
) ON COMMIT DROP; -- za rámcem transakce ji nepotřebujeme

-- rychle nahráváme nový obraz přes COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- odstraňujeme chybějící
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- pole primárního klíče
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "antijoin"

-- aktualizujeme zbylé
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- není nutné aktualizovat shodné

-- vkládáme chybějící
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Postprocessing importu
Ve stejném KLADe je třeba všechny změněné záznamy dále zpracovat — normalizovat, vyčlenit klíčová slova, převést do požadovaných struktur. Ale jak zjistit — co přesně se měnilo, aniž bychom tím zkomplikovali synchronizační kód, ideálně ho vůbec nezasahovat?
Pokud má váš proces v okamžiku synchronizace pouze zápisová oprávnění, můžeme využít spouštěč, který shromáždí všechny změny:
-- cílové tabulky
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabulky s historií změn
CREATE TABLE kladr$log(
  ro kladr, -- zde leží celé obrazy záznamů starý/nový
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- obecná funkce logování změn
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- kontrolujeme potřebu logování při aktualizaci záznamu
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- vytváříme záznam logu
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Nyní můžeme před začátkem synchronizace spustit (nebo aktivovat přes ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
A poté můžeme v klidě z tabulek logu extrahovat všechny potřebné změny a poslat je dalším zpracovatelům.
3.3. Import souvisejících sad
Výše jsme probírali případy, kdy se struktury dat zdroje a příjemce shodují. Co však dělat, pokud export z externího systému má formát odlišný od struktury, kterou uchováváme v naší databázi?
Představme si příklad uchovávání klientů a jejich faktur, klasický případ „mnoho-k-jednomu“:
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
A zde přichází export z externího zdroje v podobě „všechno v jednom“:
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Je zřejmé, že údaje o klientech se v tomto případě mohou duplikovat, a hlavní záznam je „faktura“:
0123456789;Václav;A-01;2020-03-16;1000.00
9876543210;Petr;A-02;2020-03-16;666.00
0123456789;Václav;B-03;2020-03-16;9999.00
Pro model jednoduše vložíme naše testovací údaje, ale pamatujeme — COPY efektivněji!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Václav', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petr', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Václav', 'B-03', '2020-03-16', 9999.00);
Nejprve vymezíme ty „řezy“, na které naše „faktury“ odkazují. V našem případě faktury odkazují na klienty:
VYTVOŘTE DOČASNOU TABULKU client_import AS
SELECT DISTINCT ON(client_inn)
-- můžete použít pouze SELECT DISTINCT, pokud jsou data zjevně nekonzistentní
  client_inn inn
, client_name "name"
FROM
  invoice_import;
Abychom správně spojili účty s ID klientů, musíme tyto identifikátory nejprve zjistit nebo vygenerovat. Přidáme pro ně pole:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Využijeme výše popsaný způsob synchronizace tabulek s malou úpravou — nebudeme nic aktualizovat a mazat v cílové tabulce, protože import klientů je u nás „append-only“:
-- přiřazujeme do tabulky importu ID již existujících záznamů
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- unikátní klíč

-- vkládáme chybějící záznamy a přiřazujeme jejich ID
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id IS NULL -- pokud ID nebylo přiřazeno
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- unikátní klíč

-- přiřazujeme ID klientů u záznamů účtů
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- aplikační klíč
Vlastně vše — v invoice_import nyní máme vyplněné pole vazby client_id, se kterým vložíme účet.
Zdroj: habr.com
