

Přepis zprávy z roku 2015 od Alexeje Lesovského "Podrobný pohled na interní statistiky PostgreSQL"
Zřeknutí se odpovědnosti od autora zprávy: Rád bych poznamenal, že tato zpráva je datována listopadem 2015 — od té doby uplynulo více než 4 roky a hodně se změnilo. Verze 9.4, kterou zpráva zmiňuje, již není podporována. Během těchto 4 let bylo vydáno 5 nových verzí, které přinesly řadu novinek, vylepšení a změn ohledně statistik, a část materiálu se stala zastaralou a neaktuální. Během revize jsem se snažil označit tato místa, abych neuváděl čtenáře v omyl. Rozhodl jsem se však tato místa nepřepracovávat, je jich příliš mnoho a výsledkem by byla úplně jiná zpráva.
Systém správy databází PostgreSQL je obrovský mechanismus, který se skládá z mnoha subsystémů, jejichž hladké fungování přímo ovlivňuje výkon systému. Během provozu se shromažďují statistiky a informace o činnosti komponentů, což umožňuje zhodnotit efektivitu PostgreSQL a přijmout opatření pro zlepšení výkonu. Nicméně je této informaci opravdu hodně a je prezentována v dost zjednodušené podobě. Zpracování těchto informací a jejich interpretace může být občas velmi složitý úkol, a "zoo" nástrojů a utilit může snadno zmást i zkušeného DBA.
Dobrý den! Jmenuji se Alexej. Jak říkal Ilja, budu mluvit o statistikách PostgreSQL.
Statistika aktivity PostgreSQL. PostgreSQL má dvě statistiky. Statistika aktivity, o které bude řeč, a statistiku plánovače o rozložení dat. Budu mluvit konkrétně o statistice aktivity PostgreSQL, která nám umožňuje posuzovat výkon a přicházet s možnostmi pro jeho zlepšení.
Povím, jak efektivně využívat statistiky k řešení různých problémů, které máte nebo mohou nastat.
Co v přednášce nebude? V přednášce se nebudu zabývat statistikou plánovače, protože to je samostatné téma na jinou přednášku o tom, jak jsou data ukládána v databázi a jak plánovač dotazů získává představu o kvalitativních a kvantitativních charakteristikách těchto dat.
A nebudou žádné přehledy nástrojů, nebudu srovnávat jeden produkt s druhým. Nebude žádná reklama. ODBOČME OD TOHO.
Chci vám ukázat, že používání statistik je užitečné. Je to nezbytné. Používat je není nic děsivého. Budeme potřebovat jen obyčejný SQL a základní znalosti o SQL.
A také si povíme, jakou statistiku zvolit pro řešení problémů.
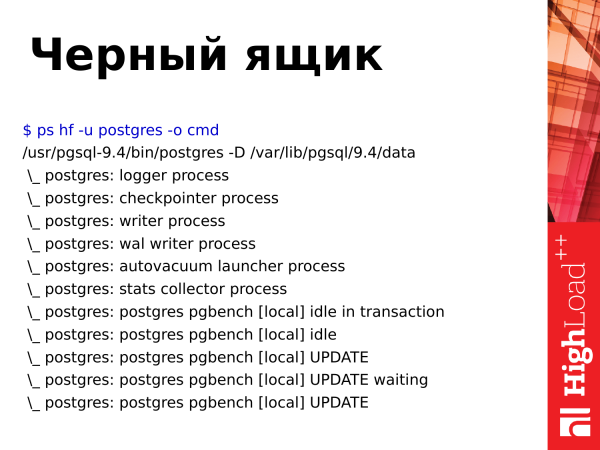
Pokud se podíváme na PostgreSQL a v operačním systému spustíme příkaz pro zobrazení procesů, uvidíme "černou skříňku". Uvidíme nějaké procesy, které něco dělají, a podle názvu si můžeme přibližně představit, co tam dělají a čím se zabývají. Ale v podstatě je to černá skříňka, dovnitř nahlédnout nemůžeme.
Můžeme se podívat na zátěž procesoru v top, můžeme se podívat na využití paměti pomocí nějakých systémových utilit, ale dovnitř PostgreSQL se nedostaneme. K tomu potřebujeme jiné nástroje.
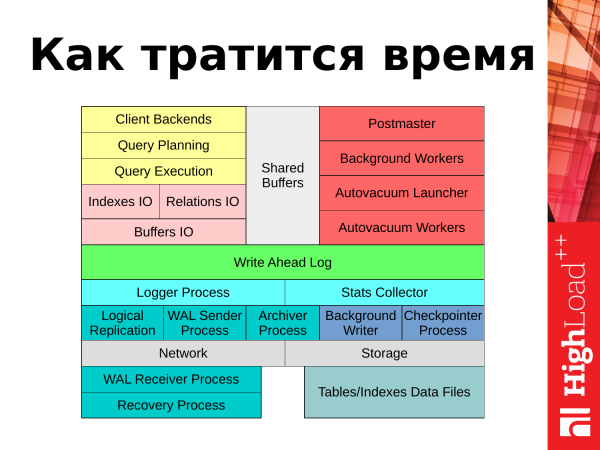
A pokud budeme pokračovat dál, povím vám, kam se ztrácí čas. Pokud si představíme PostgreSQL jako takový diagram, bude možné odpovědět, kam se ztrácí čas. Jsou to dvě věci: zpracování klientských dotazů z aplikací a pozadí úkoly, které PostgreSQL vykonává, aby udrželo svou funkčnost.
Pokud začneme z levého horního rohu, můžeme sledovat, jak se zpracovávají klientské dotazy. Dotaz přichází z aplikace a pro další práci se otevře klientská relace. Dotaz je předán plánovači. Plánovač sestaví plán dotazu. Odesílá ho dál k vykonání. Probíhá nějaký blokový vstup-výstup dat související s tabulkami a indexy. Potřebná data se čtou z disků do paměti do speciální oblasti "shared buffers". Výsledky dotazu, pokud se jedná o aktualizace nebo odstranění, se zaznamenávají do protokolu transakcí v WAL. Některé statistické informace se dostanou do logu nebo do sběrače statistik. A výsledek dotazu je vrácen klientovi. Po něm může klient všechno zopakovat s novým dotazem.
Co máme s pozadím úkoly a pozadím procesy? Máme několik procesů, které zajišťují funkčnost a udržují databázi v normálním pracovním režimu. Tyto procesy budou také zmíněny v přednášce: to jsou autovacuum, checkpointer, procesy spojené s replikací, background writer. Každého z nich budu zmiňovat v průběhu přednášky.
Jaké problémy existují se statistikou?
- Informací je mnoho. PostgreSQL 9.4 poskytuje 109 metrik pro zobrazení statistických dat. Pokud však databáze obsahuje mnoho tabulek, schémat a databází, musíte tyto metriky vynásobit odpovídajícím počtem tabulek a databází. Jinými slovy, informací se stává ještě více a snadno se v ní ztratit.
- Dalším problémem je, že statistika je prezentována pomocí čítačů. Pokud se na tuto statistiku podíváme, uvidíme neustále rostoucí čítače. A pokud od posledního vynulování statistiky uplynulo hodně času, uvidíme miliardové hodnoty. Ty nám však nic neříkají.
- Chybí historie. Pokud dojde k nějakému selhání, něco spadne 15-30 minut zpět, není možné využít statistiku a zjistit, co se dělo před 15-30 minutami. To je problém.
- Absence nástroje integrovaného v PostgreSQL je problém. Vývojáři jádra neposkytují žádný nástroj. Nemají nic takového. Jen dávají statistiku v databázi. Používejte, dělejte k ní dotazy, co chcete, to si dělejte.
- Jelikož neexistuje žádný integrovaný nástroj v PostgreSQL, to je příčinou jiného problému. Mnoho externích nástrojů. Každá firma, která má alespoň trochu zručné lidi, se snaží napsat svůj program. A nakonec existuje v komunitě mnoho nástrojů, které lze použít pro práci se statistikou. Některé nástroje mají určité funkce, jiné je nemají, nebo mají nějaké nové možnosti. A situace se vyvine tak, že musíte používat dva, tři nebo čtyři nástroje, které si vzájemně překrývají funkce a disponují různými vlastnostmi. To je velmi nepříjemné.
Co z toho vyplývá? Je důležité umět získávat statistiky přímo, aby se člověk nespoléhal na programy, nebo nějakým způsobem tyto programy vylepšit: přidat určité funkce, aby se získal užitek.
A potřebujete základní znalosti SQL. Abyste získali určitá data ze statistiky, musíte sestavit SQL dotazy, tedy musíte vědět, jak se skládají select a join.
Statistika nám nabízí několik věcí. Lze je rozdělit do kategorií.
- První kategorie zahrnuje události, které se odehrávají v databázi. Když v databázi dojde k nějaké události: dotazu, přístupu k tabulce, autovakuu, commitu, pak jde o události. K nim se příslušné počitadla zvyšují. Můžeme tyto události sledovat.
- Druhá kategorie jsou vlastnosti objektů, jako jsou tabulky a databáze. Ty mají své vlastnosti. To zahrnuje velikost tabulek. Můžeme sledovat růst tabulek a indexů. Můžeme se podívat na změny v dynamice.
- Třetí kategorie je doba strávená na události. Dotaz je událostí. Má svou konkrétní míru trvání. Zde se spustil, zde skončil. Můžeme to sledovat. Také se sleduje čas čtení bloku z disku nebo zápisu. Takové věci se rovněž sledují.
Zdroje statistiky jsou prezentovány následujícím způsobem:
- Ve sdílené paměti (shared buffers) je segment pro umístění statických dat, kde jsou také tyto počitadla, která se neustále zvyšují, když dochází k těmto či jiným událostem, nebo když nastává nějaký moment v práci databáze.
- Všechna tato počitadla nejsou dostupná uživatelům ani ani administrátorům. Jsou to nízkoúrovňové záležitosti. Aby bylo možné k nim přistupovat, PostgreSQL poskytuje rozhraní ve formě SQL funkcí. Můžeme provádět výběry pomocí těchto funkcí a získat nějakou metriku (nebo soubor metrik).
- I když není vždy pohodlné tyto funkce používat, tyto funkce slouží jako základ pro pohledy (VIEWs). Jsou to virtuální tabulky, které poskytují statistiku pro konkrétní podsystém nebo pro určitou sadu událostí v databázi.
- Tyto integrované pohledy (VIEWs) jsou hlavním rozhraním uživatele pro práci se statistikou. Jsou k dispozici ve výchozím nastavení bez jakékoli další konfigurace, můžete je okamžitě začít používat, prohlížet, čerpat z nich informace. Dále existují contrib moduly. Existují oficiální contrib moduly. Můžete nainstalovat balíček postgresql-contrib (například postgresql94-contrib), načíst potřebný modul v konfiguraci, nastavit pro něj parametry, restartovat PostgreSQL a můžete je používat. (Poznámka. V závislosti na distribuci je v posledních verzích contrib balíček součástí hlavního balíčku.).
- A existují neoficiální contrib. Ty nejsou součástí standardní distribuce PostgreSQL. Je nutné je buď zkompilovat, nebo nainstalovat jako knihovnu. Možnosti mohou být velmi různé, v závislosti na tom, co vymyslel vývojář tohoto neoficiálního contribu.
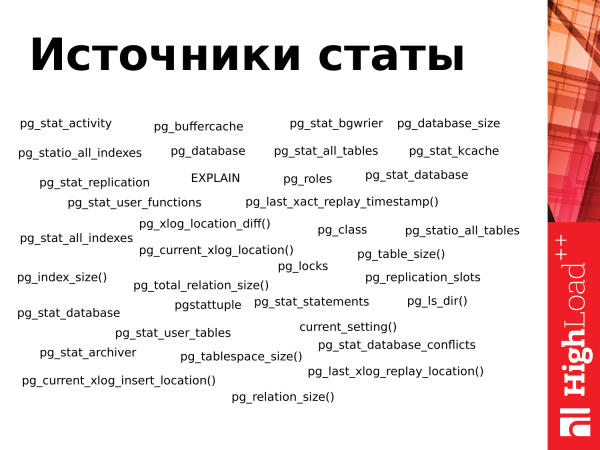
Na tomto snímku jsou uvedeny všechny tyto pohledy (VIEWs) a část funkcí, které jsou dostupné v PostgreSQL 9.4. Jak vidíme, je jich opravdu hodně. A může být docela snadné se zmást, pokud se s tím setkáváte poprvé.
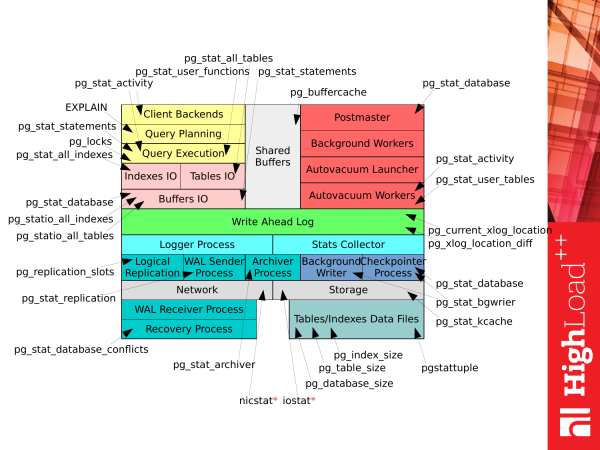
Pokud však vezmeme předchozí obrázek, Jak se čas strávený v PostgreSQL měří a porovnáme to s tímto seznamem, dostaneme takový obrázek. Každý pohled (VIEWs) nebo funkci můžeme používat k různým účelům pro získání odpovídající statistiky, když PostgreSQL běží. A můžeme již získat nějaké informace o práci pod systému.
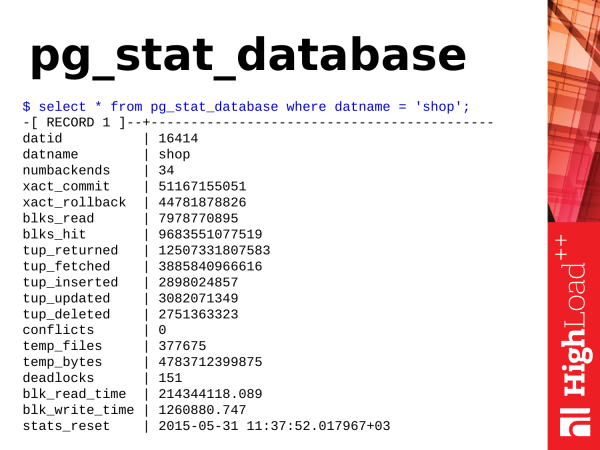
První, co si prohlédneme, je pg_stat_database. Jak vidíme, je to pohled. Obsahuje spoustu informací. Nejrozmanitější informace. A poskytuje velmi užitečné znalosti o tom, co se děje v databázi.
Co užitečného si odtud můžeme vzít? Začneme od těch nejjednodušších věcí.
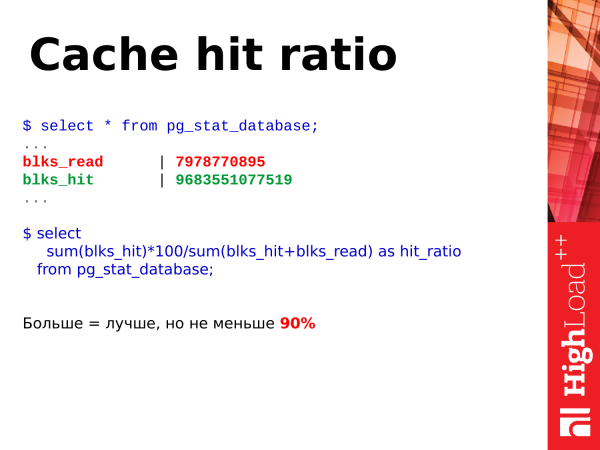
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
První, co můžeme zkontrolovat – je procento zásahu do cache. Procento zásahu do cache – to je užitečná metrika. Umožňuje posoudit, jaký objem dat se bere z cache shared buffers a jaký objem se čte z disku.
Je jasné, že čím vyšší máme zásah do cache, tím lépe. Tuto metriku posuzujeme jako procento. A pokud je například procento tohoto zásahu do cache vyšší než 90 %, je to dobré. Pokud klesne pod 90 %, znamená to, že nemáme dostatek paměti na to, abychom udrželi "žhavou hlavu" dat v paměti. A aby PostgreSQL mohla tato data použít, musí se obracet na disk, což je pomalejší než kdyby data byla přečtena z paměti. Už je potřeba uvažovat o zvýšení paměti: buď zvýšit shared buffers, nebo rozšířit fyzickou paměť (RAM).
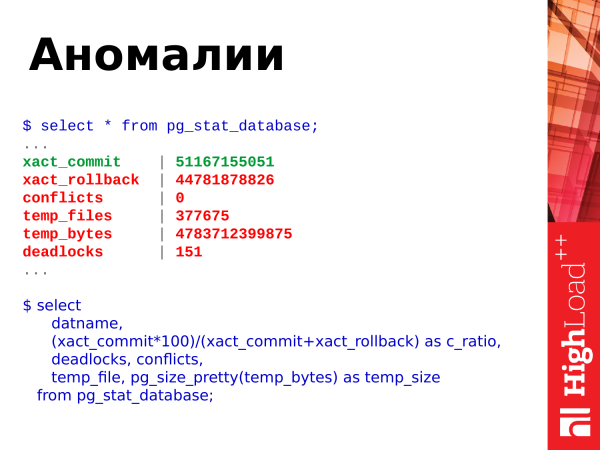
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Co dalšího si můžeme vzít z tohoto pohledu? Můžeme se podívat na anomálie, které se v databázi dějí. Co je zde zobrazeno? Jsou zde commits, rollbacks, vytváření dočasných souborů, jejich objem, deadlocks a konflikty.
Můžeme využít tento dotaz. Tento SQL je poměrně jednoduchý. A můžeme si prohlédnout tato data.
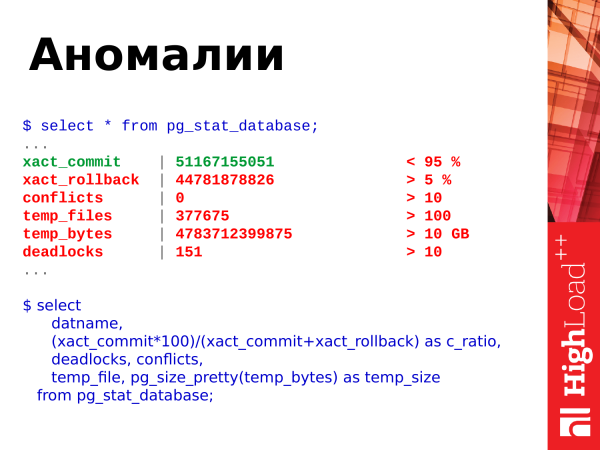
A zde máme ihned prahové hodnoty. Sledujeme poměr commits a rollbacks. Commits – to je úspěšné potvrzení transakce. Rollbacks – to je vrácení zpět, t.j. transakce vykonala nějakou práci, zatěžovala databázi, něco počítala, ale pak došlo k chybě a výsledky transakce jsou zahozeny. T.j. počet rollbacks, který se neustále zvyšuje, je špatně. A měly by se nějak vyvarovat a upravovat kód, aby se tomu zabránilo.
Konflikty (conflicts) souvisejí s replikací. A těm se také vyvarujte. Pokud máte nějaké dotazy, které se provádějí na replikách a vznikají konflikty, je třeba tyto konflikty rozebrat a zjistit, co se děje. Podrobnosti lze najít v logech. A odstranit konfliktní situace, aby dotazy aplikace fungovaly bez chyb.
Deadlocky – to je také špatná situace. Když dotazy bojují o zdroje, jeden dotaz získal zámek na jednom zdroji, druhý dotaz získal zámek na druhém zdroji a pak se oba dotazy snažily získat zámky na zdrojích navzájem a zablokovaly se v očekávání, kdy soused uvolní zámek. To je také problematická situace. Tyto situace je třeba řešit na úrovni přepisování aplikací a serializace přístupu k prostředkům. A pokud vidíte, že se deadlocky neustále zvyšují, je třeba prozkoumat podrobnosti v logech, analyzovat vzniklé situace a zjistit, v čem je problém.
Dočasné soubory (temp_files) – to je také špatně. Když uživatelskému dotazu chybí paměť na umístění dočasných dat, vytvoří soubor na disku. A všechny operace, které by mohl provádět v dočasném bufferu v paměti, začíná provádět již na disku. To je pomalé. To zvyšuje dobu provádění dotazu. A klient, který odeslal dotaz k PostgreSQL, obdrží odpověď o něco později. Pokud se všechny tyto operace vykonávají v paměti, Postgres odpoví mnohem rychleji a klient bude méně čekat.
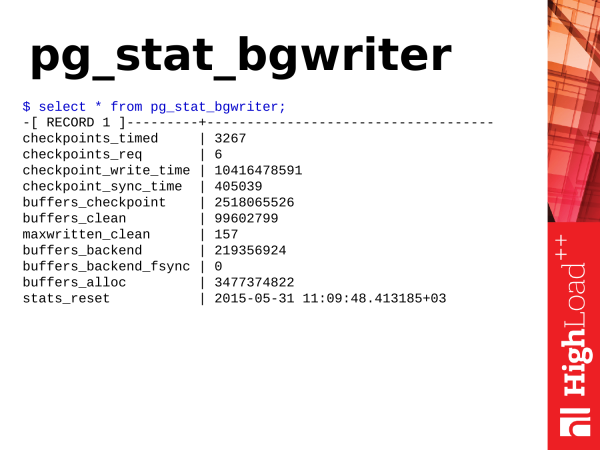
Pg_stat_bgwriter – to je zobrazení, které popisuje práci dvou systémů na pozadí PostgreSQL: to jsou checkpointer a background writer.
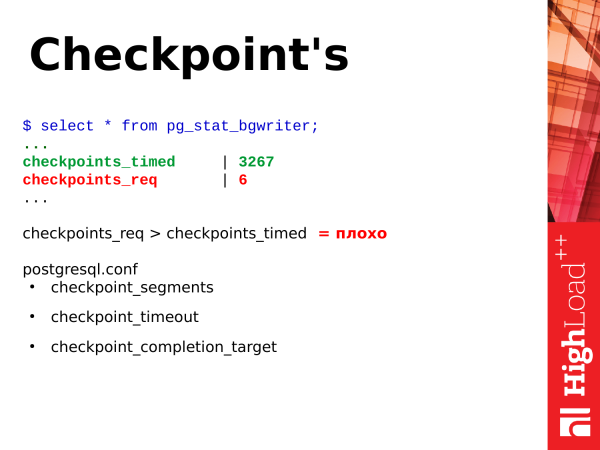
Nejprve se podíváme na kontrolní body, tzv. checkpoints. Co jsou to kontrolní body? Kontrolní bod je pozice v žurnálu transakcí, která informuje, že všechny změny dat zaznamenané v žurnálu byly úspěšně synchronizovány s daty na disku. Proces může trvat v závislosti na zatížení a nastavení a většinou spočívá v synchronizaci „špinavých“ stránek v sdílených bufferech s datovými soubory na disku. Proč je to potřeba? Kdyby PostgreSQL neustále přistupoval k disku a bral data a zapisoval je při každém přístupu, bylo by to pomalé. Proto má PostgreSQL segment paměti, jehož velikost závisí na konfiguraci. Postgres umisťuje do této paměti operativní data pro další zpracování nebo vydání na požadavek. Při požadavcích na změnu dat dochází k jejich změně. A máme dvě verze dat. Jedna je v paměti, druhá na disku. A čas od času je potřeba tyto data synchronizovat. Potřebujeme to, co bylo změněno v paměti, synchronizovat na disk. Pro to jsou potřeba checkpointy.
Checkpoint prochází sdílenými buffery, označuje špinavé stránky, že jsou potřeba pro checkpoint. Poté spouští druhý průchod po sdílených bufferech. A stránky, které byly označeny pro checkpoint, už synchronizuje. Takto probíhá synchronizace dat s diskem.
Existují dva typy kontrolních bodů. Jeden checkpoint se vykonává podle časového limitu. Tento checkpoint je užitečný a dobrý – checkpoint_timed. A existují checkpointy na vyžádání – checkpoint_required. Tento kontrolní bod nastává, když máme velmi velký zápis dat. Zapsali jsme velmi mnoho žurnálů transakcí. A PostgreSQL považuje za nutné vše toto co nejrychleji synchronizovat, udělat kontrolní bod a pokračovat dále.
A pokud se podíváte na statistiky pg_stat_bgwriter a uvidíte, že máte checkpoint_req mnohem více než checkpoint_timed, pak je to špatně. Proč je to špatně? To znamená, že PostgreSQL se nachází v neustálém stresovém stavu, kdy potřebuje zapisovat data na disk. Checkpoint podle časového limitu je méně stresující a provádí se podle interního rozvrhu a je jakoby rozložen v čase. PostgreSQL má možnost dělat pauzy v práci a nezatěžovat diskový subsystém. To je pro PostgreSQL užitečné. A požadavky, které se provádějí během checkpointu, nebudou pociťovat stres z toho, že diskový subsystém je zaneprázdněn.
A pro nastavení checkpointu existují tři parametry:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Tyto parametry umožňují regulovat fungování kontrolních bodů. Ale nebudu na něm dlouho zastavovat. Jejich vliv – to je samostatné téma.
Pozor: Verze 9.4, která je v této zprávě zmiňována, již není aktuální. V modernějších verzích PostgreSQL byl parametr checkpoint_segments nahrazen parametry min_wal_size a max_wal_size.
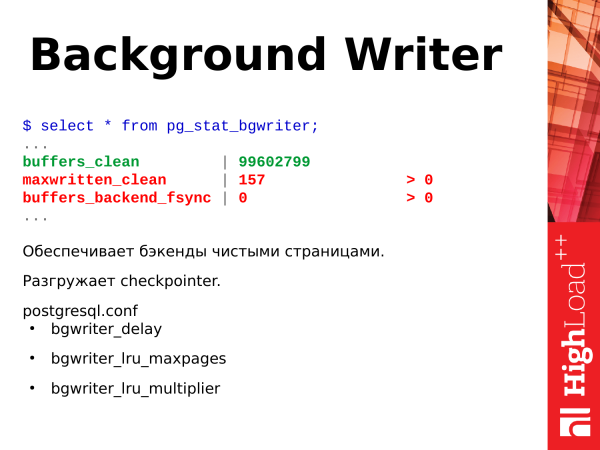
Další podsystemou je background writer – background writer. Co dělá? Pracuje neustále v nekonečné smyčce. Skenuje stránky ve sdílených bufferech a špinavé stránky, které najde, ukládá na disk. Takže pomáhá checkpointerovi, aby měl méně práce během provádění kontrolních bodů.
K čemu je ještě potřebný? Zajišťuje potřebu čistých stránek ve sdílených bufferech, pokud by byly potřebné (ve velkém množství a najednou) pro umístění dat. Představte si situaci, kdy pro provedení dotazu byly potřebné čisté stránky, a ty již existují ve sdílených bufferech. PostgreSQL backend je prostě vezme a použije, nemusí nic čistit. Ale pokud takové stránky náhle chybí, backend pozastaví práci a začne hledat stránky, aby je uložit na disk a vzít pro své potřeby – což negativně ovlivňuje dobu trvání právě probíhajícího dotazu. Pokud vidíte, že váš parametr maxwritten_clean je vysoký, znamená to, že background writer nezvládá svou práci a je třeba zvýšit parametry bgwriter_lru_maxpages, aby mohl za jeden cyklus vykonat více práce, více vyčistit stránek.
A další velmi užitečný ukazatel – to je buffers_backend_fsync. Backendy nedělají fsync, protože je to pomalé. Předávají fsync výše do IO stacku checkpointerovi. Checkpointer má svou frontu, tu občas zpracovává a synchronizuje stránky v paměti se soubory na disku. Pokud je fronta checkpointera velká a zaplněná, backend je nucen sám provádět fsync a to zpomaluje jeho práci,tj. klient dostane odpověď později, než by mohl. Pokud vidíte, že je tato hodnota větší než nula, je to již problém a je třeba věnovat pozornost nastavení background writera a také zhodnotit výkon diskového subsystému.
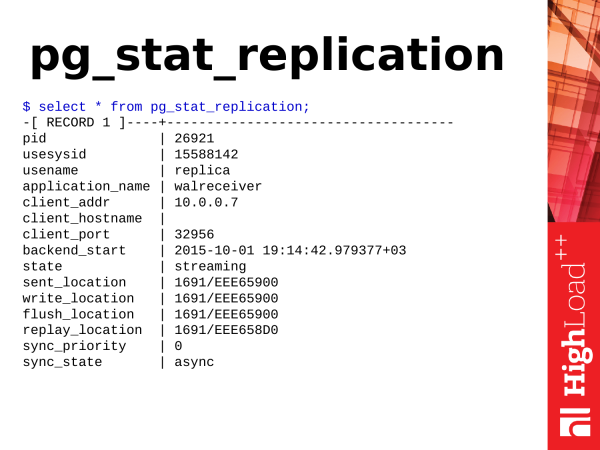
Pozor: _Následující text popisuje statistické reprezentace spojené s replikací. Většina názvů reprezentací a funkcí byla přejmenována v Postgres 10. Podstata přejmenování spočívala v nahrazení xlog na wal a location na lsn v názvech funkcí/reprezentací atd. Konkrétní příklad, funkce pg_xlog_location_diff() byla přejmenována na pg_wal_lsn_diff()._
Tady máme také spoustu věcí. Ale potřebujeme pouze body související s location.
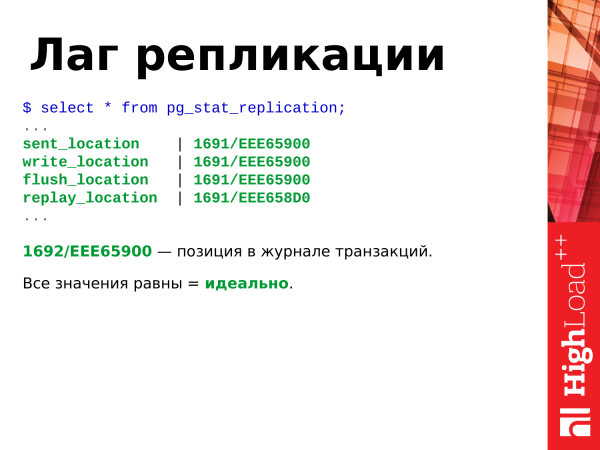
Pokud vidíme, že všechny hodnoty jsou rovny, je to ideální situace a replikace nedochází k zpoždění vůči masteru.
Tato šestnáctková pozice – to je pozice v deníku transakcí. Neustále se zvyšuje, pokud je v databázi nějaká aktivita: vkládání, mazání atd.
kolik bylo zapsáno xlog v bajtech
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
zpoždění replikace v bajtech
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
zpoždění replikace v sekundách
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Pokud se tyto věci liší, znamená to, že existuje nějaké zpoždění. Zpoždění – to je odstup repliky od masteru, tedy data se liší mezi servery.
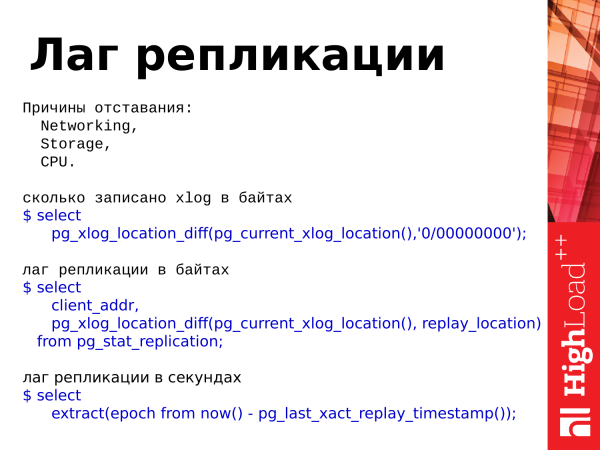
Existují tři důvody pro zpoždění:
- To je diskový subsystém, který nedokáže zvládnout zápis synchronizace souborů.
- To jsou možné chyby v síti nebo přetížení sítě, kdy data nestíhají docházet k replikaci a nemůže je reprodukovat.
- A procesor. Procesor je velmi vzácný případ. Viděl jsem to asi dvakrát nebo třikrát, ale může se to stát také.
A zde jsou tři dotazy, které nám umožňují používat statistiku. Můžeme vyhodnotit, kolik bylo zapsáno do našeho deníku transakcí. Existuje taková funkce pg_xlog_location_diff a můžeme vyhodnotit zpoždění replikace v bajtech a sekundách. To taky používáme hodnotu z této reprezentace (VIEWs).
Poznámka: _Místo pg_xlog_locationdiff() funkce lze použít operátor odčítání a odečíst jednu location od druhé. Je to pohodlné.
Se zpožděním, které je v sekundách, je jedna věc. Pokud na masteru nedochází k žádné aktivitě, transakce byla někde před 15 minutami a žádná aktivita není, a pokud se na replikaci podíváme na toto zpoždění, uvidíme zpoždění 15 minut. Na to je dobré pamatovat. A to může být matoucí, když se na toto zpoždění podíváte.
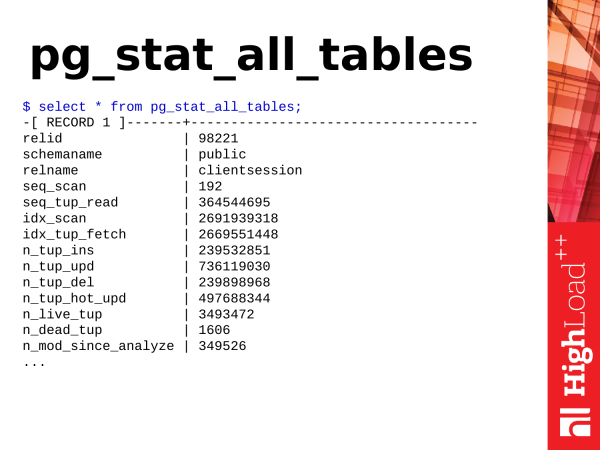
Pg_stat_all_tables – další užitečný pohled. Ukazuje statistiky o tabulkách. Když máme v databázi tabulky a nějaká aktivita, nějaké akce, můžeme tyto informace získat z tohoto pohledu.
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
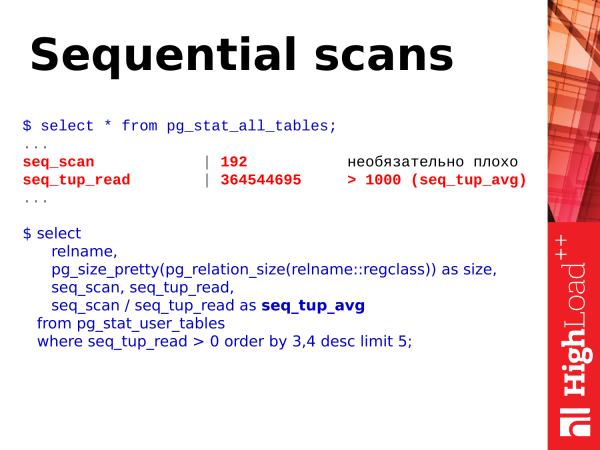
První, co můžeme zkontrolovat, jsou sekvenční skenování tabulky. Samotné číslo po těchto průchodech nemusí být nutně špatné a neznamená, že musíme něco podniknout.
Existuje však druhá metrika – seq_tup_read. To je počet řádků vrácených v důsledku sekvenčního skenování. Pokud průměrné číslo překročí 1 000, 10 000, 50 000, 100 000, je to ukazatel, že je možná třeba někde vytvořit index, aby byly přístupy prováděny podle indexu, nebo je potřeba optimalizovat dotazy, které používají taková sekvenční skenování, aby k tomu nedocházelo.
Jednoduchý příklad – řekněme, že dotaz s velkým OFFSET a LIMIT je vykonáván. Například je skenováno 100 000 řádků v tabulce a poté je vybráno 50 000 potřebných řádků, zatímco předchozí skenované řádky jsou ignorovány. To je také špatný případ. Takové dotazy je potřeba optimalizovat. A zde je jednoduchý SQL dotaz, na kterém to lze zkontrolovat a posoudit získaná čísla.
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
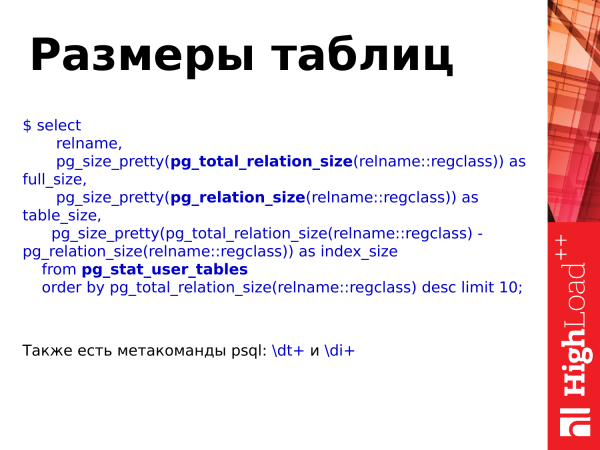
Velikosti tabulek lze také získat pomocí této tabulky a dalších funkcí pg_total_relation_size(), pg_relation_size().
Obecně existují metakómy dt a di, které lze použít v PSQL a také se podívat na velikosti tabulek a indexů.
Použití funkcí nám však pomáhá sledovat velikosti tabulek včetně indexů, nebo bez ohledu na indexy, a poté provádět nějaké hodnocení na základě růstu databáze, tj. jak roste, s jakou intenzitou a dospět k závěrům o optimalizaci velikostí.
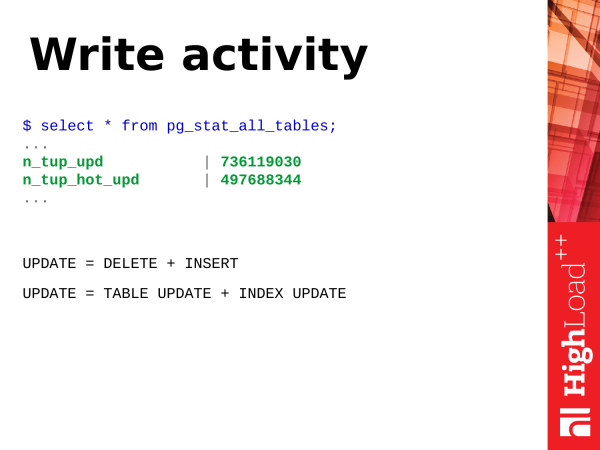
Aktivita při zápisu. Co to je zápis? Podívejme se na operaci AKTUALIZACE – operace aktualizace řádků v tabulce. V podstatě je update dvě operace (nebo i více). To zahrnuje vložení nové verze řádku a označení staré verze řádku jako zastaralé. Později přijde autovakuum a tyto zastaralé verze řádků vyčistí a označí toto místo jako dostupné k opětovnému použití.
Kromě toho update není jen aktualizací tabulky. Je to také aktualizace indexů. Pokud má váš tabulka mnoho indexů, při update je třeba aktualizovat všechny indexy, kterých se účastní pole aktualizovaná v dotazu. V těchto indexech také budou zastaralé verze řádků, které je třeba vyčistit.
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
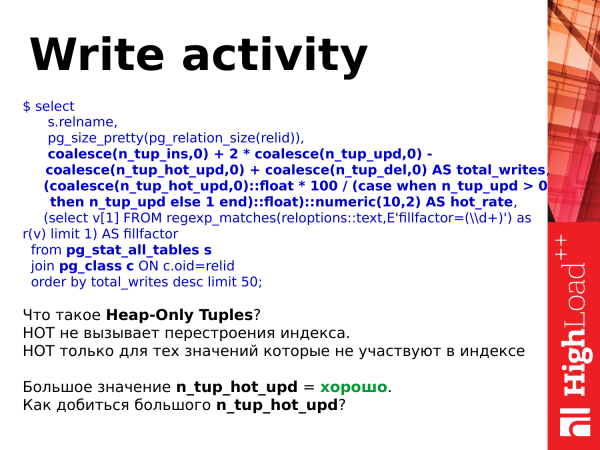
A díky svému designu, UPDATE – to jsou těžké operace. Ale lze je zjednodušit. Existují hot updates. Ty se objevily v PostgreSQL verzi 8.3. A co to je? Je to lehký update, který nezpůsobuje přestavbu indexů. Tzn. aktualizovali jsme záznam, ale při tom se aktualizoval pouze záznam na stránce (která patří tabulce), zatímco indexy stále ukazují na ten samý záznam na stránce. Je tam trochu zajímavá logika práce, když přijde vakuum, tak tyto řetězce hot přestavuje a všechno pokračuje bez aktualizace indexů, a to se děje s menší spotřebou zdrojů.
A když máte n_tup_hot_upd velké, je to velmi dobré. To znamená, že lehké updates převládají a z pohledu zdrojů je to pro nás levnější a všechno funguje perfektně.
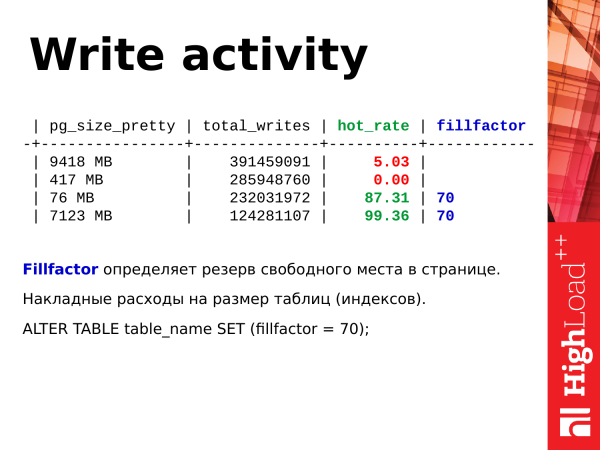
ALTER TABLE table_name SET (fillfactor = 70);Jak zvýšit objem hot updateů? Můžeme použít fillfactor. Určuje velikost rezervovaného volného místa při vyplňování stránky v tabulce pomocí INSERTů. Když do tabulky přicházejí inserts, plně vyplní stránku, nezanechají v ní prázdné místo. Poté se vyhradí nová stránka. Znovu se data vyplní. A toto chování je ve výchozím nastavení, fillfactor = 100%.
Můžeme nastavit fillfactor na 70 %. T.j. při vložení záznamu se vytvoří nová stránka, ale vyplní se pouze 70 % stránky. A 30 % nám zůstává jako rezerva. Když bude potřeba udělat aktualizaci, s vysokou pravděpodobností dojde k ní ve stejné stránce, a nová verze záznamu se umístí do té samé stránky. A proběhne hot_update. Takto se usnadňuje zápis do tabulek.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
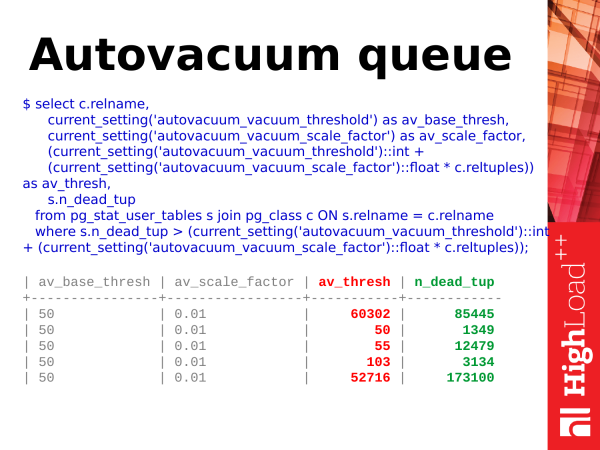
Fronta autovakuumu. Autovakuum je takový podsystém, o kterém je v PostgreSQL velmi málo statistik. V tabulkách můžeme pouze v pg_stat_activity vidět, kolik máme aktuálně probíhajících vakuum procesů. Ale pochopit, kolik tabulek je v jeho frontě, je velmi obtížné.
Poznámka: _Od verze Postgres 10 se situace s sledováním autovakuumu značně zlepšila — vzniklo zobrazení pg_stat_progressvacuum, které značně usnadňuje problematiku monitorování autovakuumu.
Můžeme použít takto zjednodušený dotaz. A můžeme se podívat, kdy by měl být proveden vakuum. Ale jak a kdy by měl být vakuum spuštěn? Tyto zastaralé verze záznamů, o kterých jsem mluvil dříve. Proběhla aktualizace, nová verze záznamu byla vložena. Objevila se zastaralá verze záznamu. V tabulce pg_stat_user_tables existuje takový parametr n_dead_tup. Ukazuje počet "mrtvých" záznamů. A jakmile počet mrtvých záznamů překročí stanovený práh, k tabulce přijde autovakuum.
A jak se tento práh počítá? Je to velmi konkrétní procentní podíl od celkového počtu záznamů v tabulce. Existuje parametr autovacuum_vacuum_scale_factor. Ten určuje procentní podíl. Řekněme 10 % + tam základní práh 50 záznamů. A co se stane? Když máme mrtvé záznamy větší než "10 % + 50" ze všech záznamů v tabulce, dáme tabulku na autovakuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
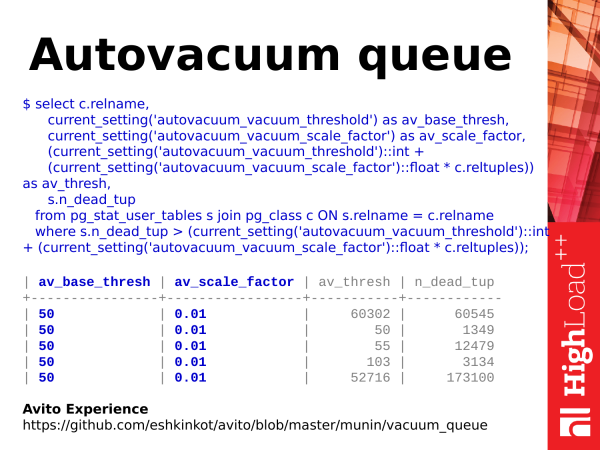
Ale zde je jeden faktor. Základní prahy parametrů av_base_thresh a av_scale_factor mohou být určeny individuálně. A tudíž, práh nebude globální, ale individuální pro tabulku. Abychom to spočítali, musíme použít úskoky a triky. A pokud vás to zajímá, můžete se podívat na zkušenosti našich kolegů z Avito (odkaz na slidu je neplatný a byl aktualizován v textu).
Napsali pro , který tyto věci zohledňuje. Je to rozsáhlý dokument na dva listy. Ale počítá správně a docela efektivně umožňuje vyhodnotit, kde potřebujeme hodně vakuového prostoru pro tabulky, a kde málo.
Co s tím můžeme udělat? Pokud máme velkou frontu a automatický vakuum není dostatečný, můžeme zvýšit počet vakuových pracovníků, nebo můžeme jednoduše udělat vakuum agresivnější, aby se spouštělo dříve a zpracovávalo tabulku po malých kusech. A tím se fronta zmenší. — Hlavní je sledovat zátěž na discích, protože vakuum není bezplatná záležitost, i když s příchodem SSD/NVMe zařízení se problém stal méně výrazným.
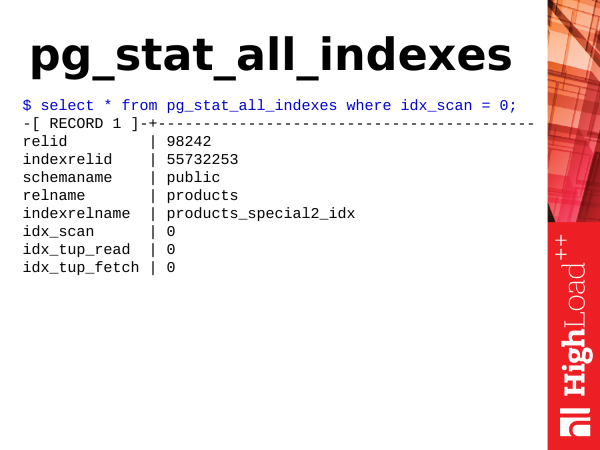
Pg_stat_all_indexes – to jsou statistiky o indexech. Jsou malé. A my podle nich můžeme získat informace o využití indexů. A například můžeme určit, které indexy máme nadbytečné.
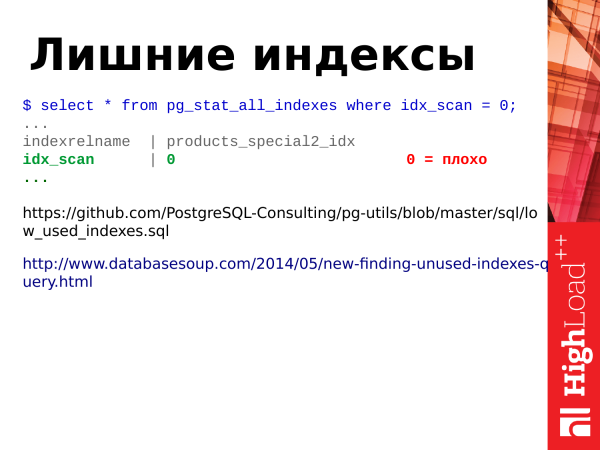
Jak už jsem říkal, update – to není jen aktualizace tabulek, ale také aktualizace indexů. Proto pokud máme v tabulce mnoho indexů, při aktualizaci řádků v tabulce je potřeba také aktualizovat indexy indexovaných polí, a pokud máme nevyužívané indexy, pro které nejsou žádná indexová skenování, visí nám jako balast. A těch se musíme zbavit. K tomu potřebujeme pole idx_scan. Prostě se díváme na počet indexových skenování. Pokud mají indexy nula skenování za relativně dlouhé období uchovávání statistik (nejméně 2-3 týdny), je pravděpodobně že se jedná o špatné indexy, musíme se jich zbavit.
Poznámka: Při hledání nevyužívaných indexů v případě clusterů streamové replikace je potřeba zkontrolovat všechny uzly clustru, protože statistiky nejsou globální, a pokud index není využíván na hlavním uzlu, může být využíván na replikách (pokud tam je zátěž).
Dva odkazy:
Jsou to pokročilejší příklady dotazů, jak hledat nevyužívané indexy.
Druhý odkaz je poměrně zajímavý dotaz. Obsahuje velmi netriviální logiku. Doporučuji ho k prostudování.
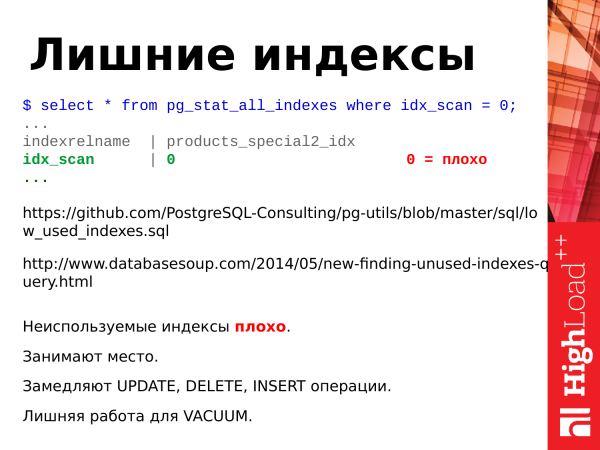
Co dalšího stojí za shrnutí ohledně indexů?
Nepoužívané indexy jsou špatné.
Zabírají místo.
Zpomalují aktualizační operace.
Zbytečná práce pro vakuum.
Pokud odstraníme nepoužívané indexy, pro naši databázi to bude jen k lepšímu.
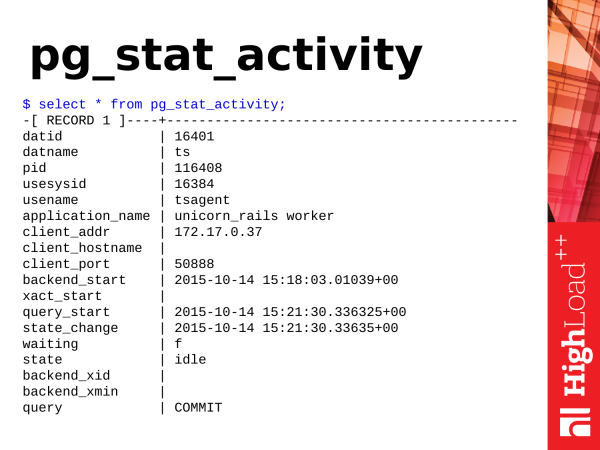
Další reprezentace je pg_stat_activity. Je to ekvivalent nástroje ps, pouze v PostgreSQL. Pokud psse díváte na procesy v operačním systému, pg_stat_activity ukáže vám aktivitu uvnitř PostgreSQL.
Co užitečného si z toho můžeme vzít?
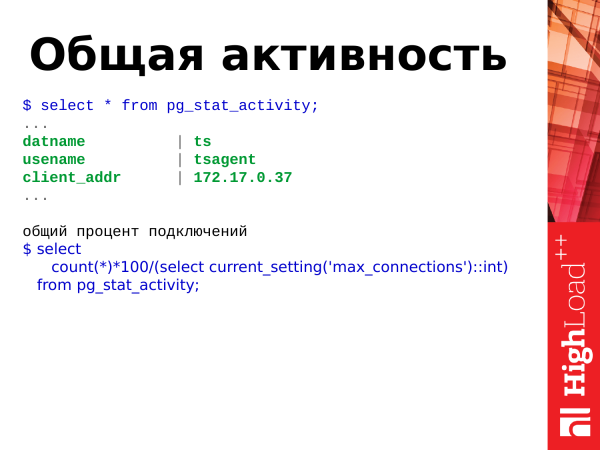
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Můžeme se podívat na celkovou aktivitu, co se v databázi děje. Můžeme provést nasazení. Všechno nám tam vybuchlo, nové spojení nejsou přijímána, v aplikaci se sypou chyby.
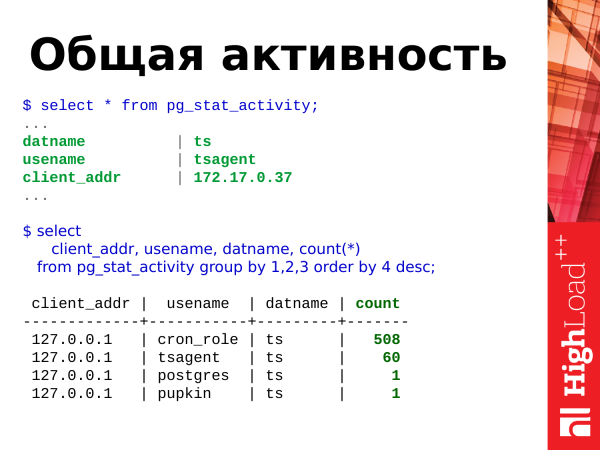
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Můžeme provést takový dotaz a podívat se na procento připojení vzhledem k maximálnímu limitu připojení a zjistit, kdo má nejvíce spojení. V tomto případě vidíme, že uživatel cron_role otevřel 508 spojení. A něco se s ním stalo. Je třeba se tím zabývat a podívat se na to. Je velmi pravděpodobné, že to je nějaké anomální číslo připojení.
Pokud máme OLTP zátěž, dotazy by měly být prováděny rychle, velmi rychle a neměly by existovat dlouhé dotazy. Pokud se však objeví dlouhé dotazy, krátkodobě to není tragické, ale z dlouhodobého hlediska dlouhé dotazy škodí databázi, zvyšují bloat efekt tabulek, když dochází k fragmentaci tabulek. Z bloatu a dlouhých dotazů je třeba se zbavit.
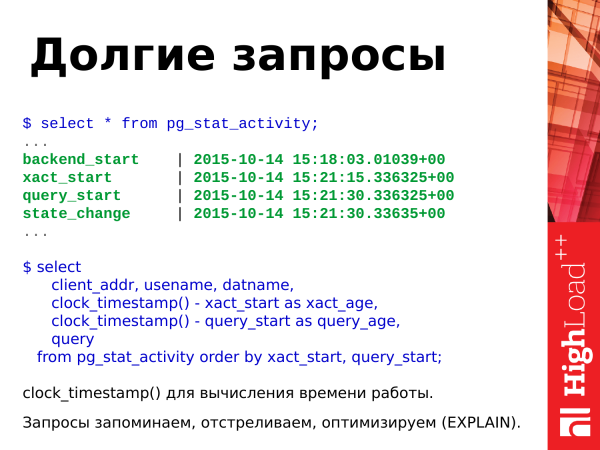
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Všimněte si: tímto dotazem můžeme určovat dlouhé dotazy a transakce. Používáme funkci clock_timestamp() k určení doby trvání. Dlouhé dotazy, které jsme našli, si můžeme zapamatovat, provést explain, podívat se na plány a nějak to optimalizovat. Současné dlouhé dotazy zablokujeme a žijeme dál.
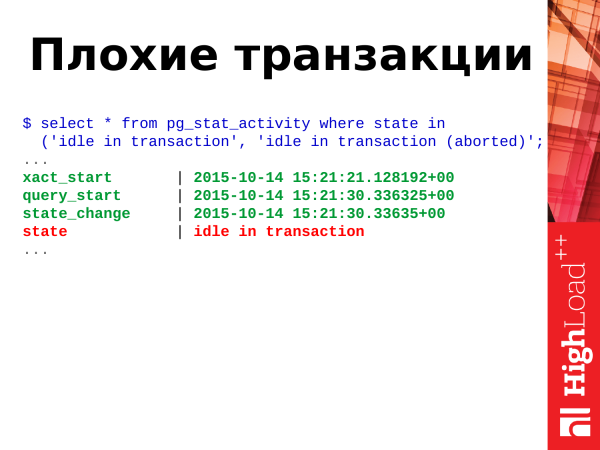
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Špatné transakce jsou transakce ve stavu idle in transaction a idle in transaction (aborted).
Co to znamená? Transakce mají několik stavů. A jeden z těchto stavů může být v jakémkoli okamžiku. Pro určení stavů máme pole stav v této představě. A my ho používáme k určení stavu.
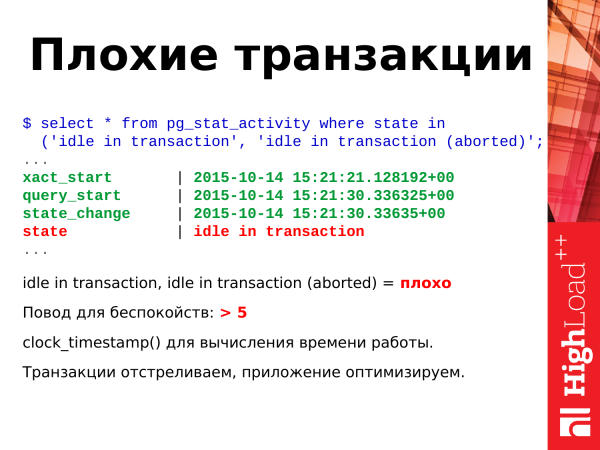
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
A jak už jsem řekl výše, tyto dva stavy idle in transaction a idle in transaction (aborted) – to je špatně. Co to znamená? To je situace, kdy aplikace otevřela transakci, provedla nějaké akce a pak šla dál. Transakce zůstala otevřená. Visí, nic se v ní neděje, zabírá spojení, zámky na změněné řádky a potenciálně ještě zvyšuje bloat dalších tabulek, kvůli architektuře transakčního enginu Postgresu. A takové transakce by měly být ukončeny, protože jsou obecně škodlivé, za jakýchkoli okolností.
Pokud vidíte, že jich máte v databázi více než 5-10-20, už byste se měli znepokojit a začít s nimi něco dělat.
Zde také používáme pro výpočet času clock_timestamp(). Transakce ukončujeme, aplikaci optimalizujeme.
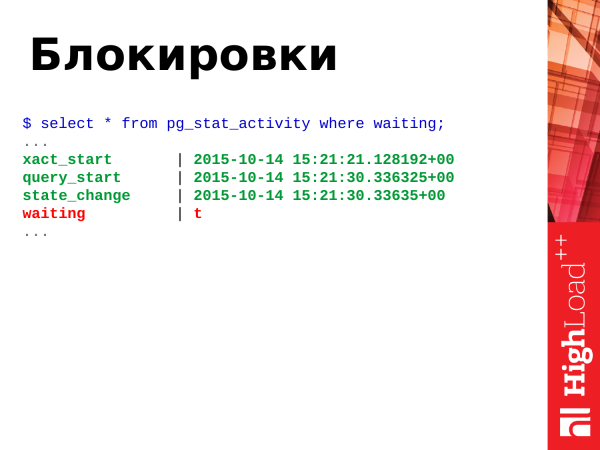
Jak jsem již zmínil, zámky – to je, když se dvě nebo více transakcí perou o jeden nebo skupinu zdrojů. K tomu máme pole waiting s logickou hodnotou true nebo false.
True – to znamená, že proces čeká, je potřeba něco udělat. Když proces čeká, znamená to, že klient, který tento proces inicioval, také čeká. Klient v prohlížeči sedí a také čeká.
Pozor: _Od verze Postgres 9.6 bylo pole waiting odstraněno a místo něj byla přidána dvě informativnější pole wait_event_type a wait_event._
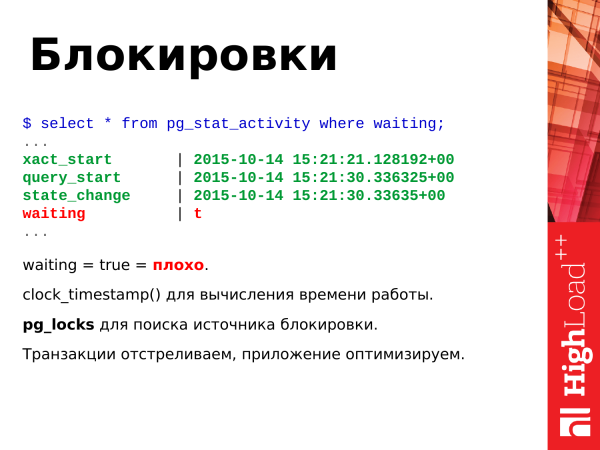
Co dělat? Pokud vidíte true po dlouhou dobu, znamená to, že je potřeba se zbavit takových požadavků. My jednoduše ukončíme takové transakce. Vývojářům říkáme, že je potřeba nějak optimalizovat, aby nedocházelo k závodění o zdroje. A dále vývojáři optimalizují aplikaci, aby se takové situace nevyskytovaly.
A poslední, ale potenciálně ne fatální případ – to je vznik deadlocků. Dvě transakce aktualizovaly dva zdroje, pak se k nim znovu obracejí, již k opačným zdrojům. PostgreSQL v takovém případě vezme a ukončí transakci, aby druhá mohla pokračovat. Je to bezvýchodná situace, která se sama nevyřeší. Proto je PostgreSQL nuceno přijmout krajní opatření.
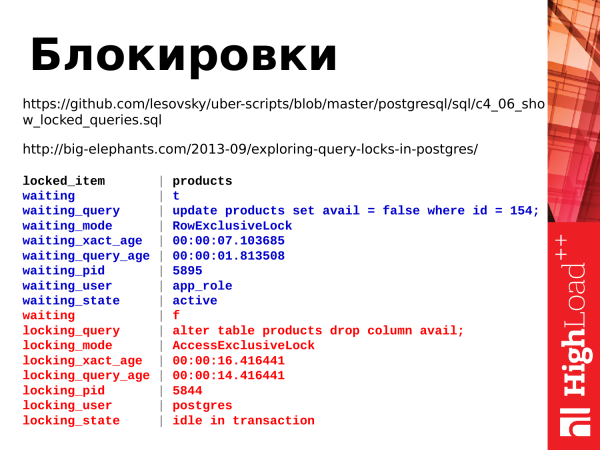
A zde jsou dva dotazy, které umožňují sledovat zámky. Používáme představu pg_locks, která umožňuje sledovat těžké blokace.
A první odkaz – to je samotný text dotazu. Je poměrně dlouhý.
A druhý odkaz – to je článek o blokacích. Je užitečné si ho přečíst, je velmi zajímavý.
Tak co vidíme? Vidíme dva dotazy. Transakci s ALTER TABLE – to je blokující transakce. Byla spuštěna, ale nebyla dokončena a aplikace, která tuto transakci spustila, se mezitím zabývá jinými věcmi. A druhý dotaz – update. Ten čeká, až se dokončí alter table, aby mohla pokračovat v práci.
Takto můžeme zjistit, kdo koho zablokoval, drží a můžeme s tím dále pracovat.
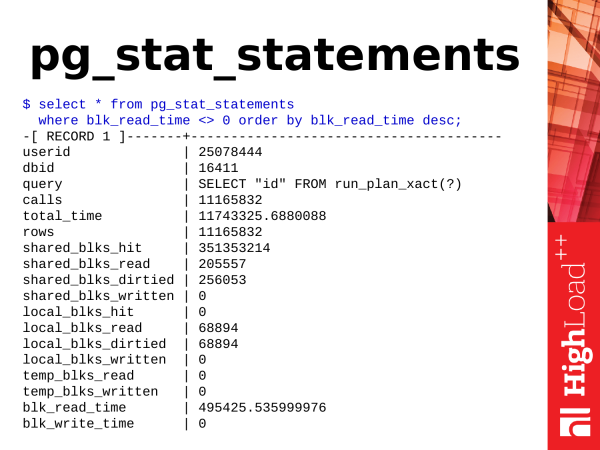
Další modul – to je pg_stat_statements. Jak jsem již řekl, to je modul. Abychom ho využili, musíme načíst jeho knihovnu do konfigurace, restartovat PostgreSQL, nainstalovat modul (jedním příkazem) a poté budeme mít nový pohled.
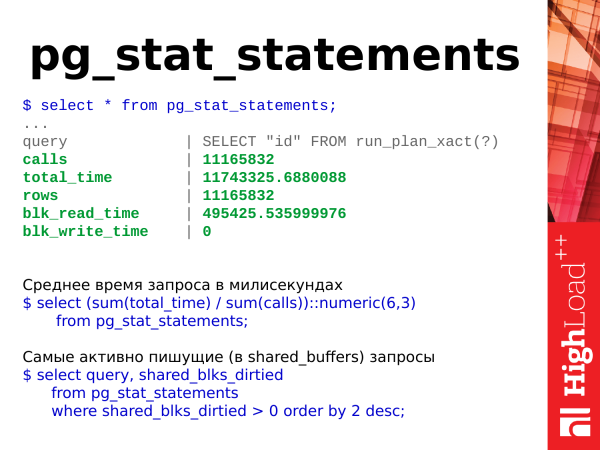
Průměrná doba dotazu v milisekundách
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Nejaktivnější zapisující dotazy (ve shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Co si můžeme odtud vzít? Pokud mluvíme o jednoduchých věcech, můžeme vzít průměrnou dobu provádění dotazu. Čas roste, znamená to, že PostgreSQL odpovídá pomalu a je třeba něco podniknout.
Můžeme se podívat na nejaktivnější zapisující transakce v databázi, které mění data ve shared buffers. Podívat se, kdo u nás aktualizuje nebo maže data.
A můžeme se jednoduše podívat na různé statistiky těchto dotazů.
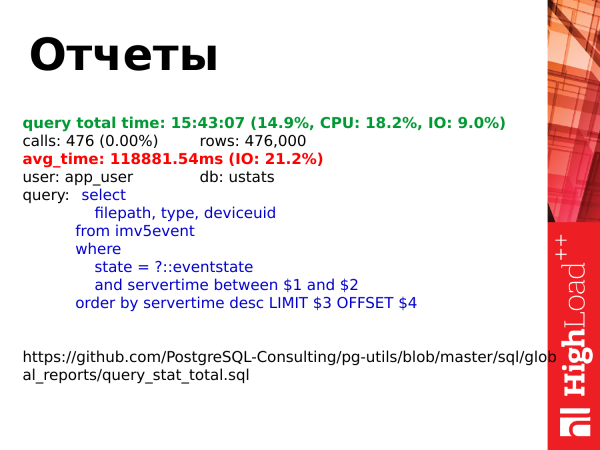
Jsme pg_stat_statements používáme pro vytváření zpráv. Jednou za den resetujeme statistiku. Hromadíme ji. Před resetováním statistiky příště vytváříme zprávu. Tady je odkaz na zprávu. Můžete si ji prohlédnout.
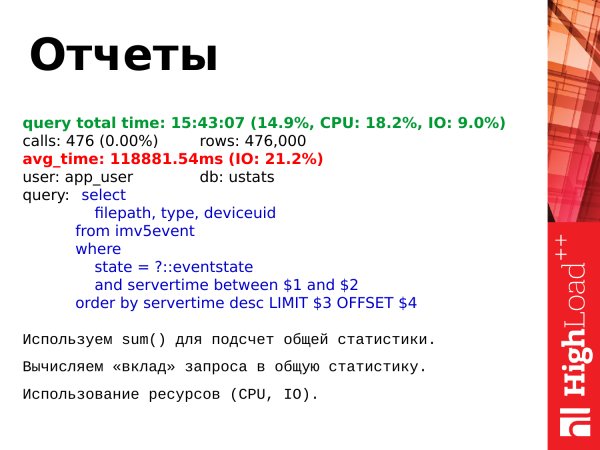
Co děláme? Počítáme celkovou statistiku pro všechny dotazy. Poté pro každý dotaz počítáme jeho individuální příspěvek k této celkové statistice.
A co můžeme sledovat? Můžeme sledovat celkovou dobu provádění všech dotazů konkrétního typu na pozadí všech ostatních dotazů. Můžeme se podívat na využití procesoru a vstupů/výstupů ve vztahu k celkovému obrazu. A již můžeme optimalizovat tyto dotazy. Vytváříme top dotazy podle této zprávy a již dostáváme podněty k zamyšlení, co optimalizovat.
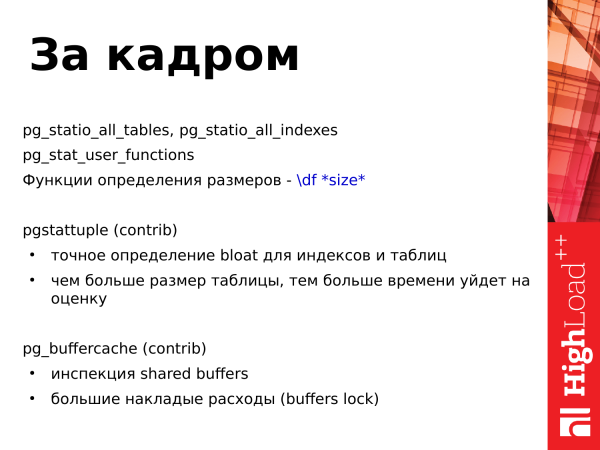
Co nám zůstalo za oponou? Zůstalo ještě několik prezentací, které jsem neprošel, protože je čas omezený.
Existuje pgstattuple – je také další modul z běžného balíčku contribs. Umožňuje vyhodnotit bloat tabulek, tzv. fragmentaci tabulky. A pokud je fragmentace vysoká, je třeba ji odstranit, použít různé nástroje. A funkce pgstattuple trvá dlouho. A čím více tabulek, tím déle to bude trvat.
Další contrib – to je pg_buffercache. Umožňuje provádět inspekci sdílených bufferů: jak intenzivně a pro jaké tabulky jsou stránky bufferu využívány. A jednoduše umožňuje nahlédnout do sdílených bufferů a posoudit, co se tam děje.
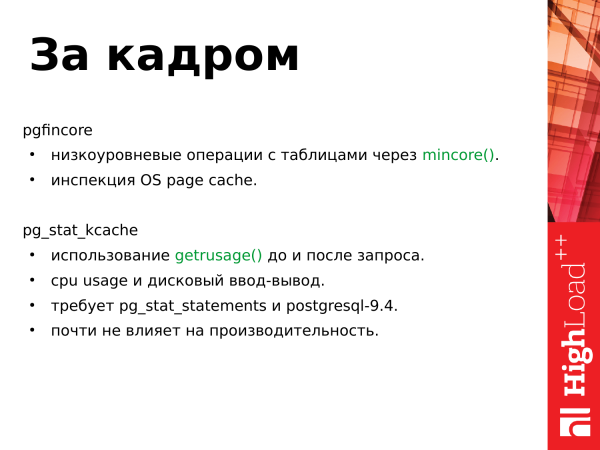
Další modul – to je pgfincore. Umožňuje provádět nízkoúrovňové operace s tabulkami prostřednictvím systémového volání mincore(), tj. umožňuje načíst tabulku do sdílených bufferů nebo ji vyjmout. A umožňuje mimo jiné provádět inspekci stránkového cache operačního systému, tj. jak velkou část tabulka zabírá v page cache, ve sdílených bufferech a prostě posoudit zátěž tabulky.
Další modul – pg_stat_kcache. Také využívá systémové volání getrusage(). A provádí ho před a po vykonání dotazu. A v získané statistice umožňuje posoudit, kolik času dotaz strávil vykonáváním diskového vstupu a výstupu, tj. operacemi se souborovým systémem a sleduje využití procesoru. Nicméně modul je mladý (ehm ehm) a pro svou činnost vyžaduje PostgreSQL 9.4 a pg_stat_statements, o kterém jsem hovořil dříve.
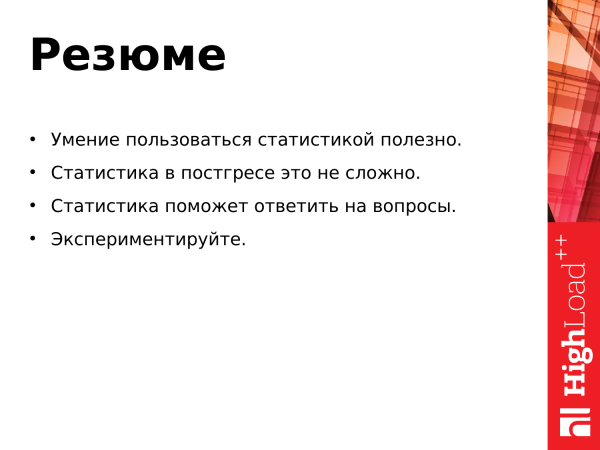
Umět používat statistiku – je užitečné. Nejsou vám potřeba třetí strany. Můžete se sami podívat, udělat něco, vykonat.
Používání statistiky není složité, je to obyčejný SQL. Sestavili jste dotaz, vytvořili, poslali, podívali se.
Statistika pomáhá odpovědět na otázky. Pokud máte otázky, obrátíte se na statistiku – podíváte se, děláte závěry, analyzujete výsledky.
A experimentujte. Dotazů je mnoho, dat je mnoho. Vždy je možné optimalizovat nějaký již existující dotaz. Můžete vytvořit svou verzi dotazu, která vám více vyhovuje než originál, a použít ji.
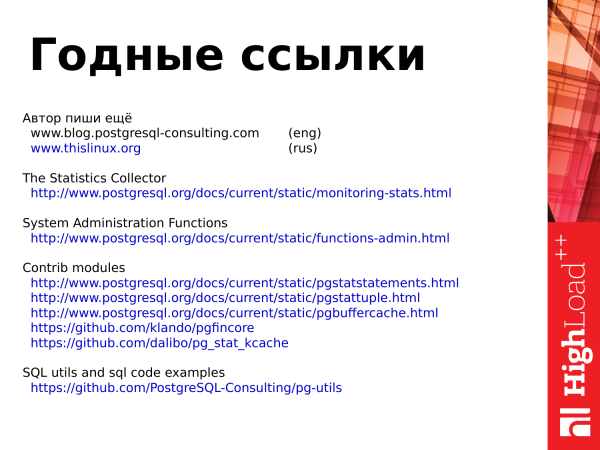
Odkazy
Užitečné odkazy, které se objevily ve článku, na jehož podkladech byla přednáška.
Autor ještě píše
(eng)
Sběr Statistik
Funkce Správy Systému
Contrib moduly
SQL utils a příklady sql kódu
Všem děkuji za pozornost!
Zdroj: habr.com
