

V předvečer spuštění nového cyklu kurzu připravili jsme překlad zajímavého materiálu.
Přehled
Budeme mluvit o poměrně populárním vzoru, který aplikace používají k práci s několika úložišti dat, kde každé úložiště slouží svým účelům, například pro uložení kanonické podoby dat (MySQL atd.), zajištění rozšířených možností vyhledávání (ElasticSearch atd.), cache (Memcached atd.) a dalších. Obvykle, při použití několika úložišť dat, jedno z nich funguje jako primární úložiště a ostatní jako derivátní úložiště. Jediným problémem je, jak synchronizovat tato úložiště dat.
Prozkoumali jsme řadu různých vzorů, které se snažily vyřešit problém synchronizace několika úložišť, jako jsou dvojité zápisy, distribuované transakce atd. Nicméně tyto přístupy mají zásadní omezení z hlediska reálného využití, spolehlivosti a údržby. Kromě synchronizace dat potřebují některé aplikace také obohacovat data, což zahrnuje volání externích služeb.
Pro řešení těchto problémů byl navržen Delta. Delta představuje konečnou konzistentní, událostmi řízenou platformu pro synchronizaci a obohacování dat.
Existující řešení
Dvojitý zápis
Pro synchronizaci dvou úložišť dat lze použít dvojitý zápis, který provede zápis do jednoho úložiště a ihned poté provede zápis do druhého. První zápis lze opakovat a druhý přerušit, pokud první skončí neúspěchem po vyčerpání počtu pokusů. Nicméně, dvě úložiště dat mohou přestat být synchronizována, pokud zápis do druhého úložiště selže. Tento problém se obvykle řeší vytvořením obnovovací procedury, která periodicky znovu přenáší data z prvního úložiště do druhého nebo to dělá pouze v případě, že se zjistí rozdíly v datech.
Problémy:
Provádění obnovovací procedury je specifický úkol, který nelze opakovaně používat. Kromě toho zůstávají data mezi úložišti desynchronizována, dokud neproběhne proces obnovy. Řešení se komplikuje, pokud je použito více než dvě datová úložiště. A konečně, proces obnovy může přidat zátěž na původní zdroj dat.
Tabulka změnových protokolů
Když dochází ke změnám v sadě tabulek (například při vkládání, aktualizaci a mazání záznamu), záznamy o změnách jsou přidány do tabulky logů jako součást téže transakce. Jiný proud nebo proces neustále žádá o události z tabulky logů a zapisuje je do jednoho nebo více datových úložišť, přičemž odstraňuje události z tabulky logů po potvrzení zápisu všemi úložišti.
Problémy:
Tento vzor by měl být implementován jako knihovna a ideálně bez změny kódu aplikace, která ji používá. V polyglotním prostředí by měla tato knihovna existovat v jakémkoliv potřebném jazyce, ale zajistit konzistenci fungování funkcí a chování mezi jazyky je velmi obtížné.
Další problém spočívá v získávání změn schématu v těch systémech, které nepodporují transakční změny schématu [1][2], jako například MySQL. Proto vzor provádění změn (například změn schématu) a transakčního zápisu do tabulky změnových protokolů nebude vždy fungovat.
Distribuované transakce
Distribuované transakce lze použít k rozdělení transakce mezi několika různými datovými úložišti tak, aby operace buď byla potvrzena ve všech použitých úložištích, nebo nebyla potvrzena v žádném z nich.
Problémy:
Distribuované transakce jsou velmi velkým problémem pro heterogenní úložiště dat. Z podstaty se mohou spoléhat pouze na nejnižší společný jmenovatel zúčastněných systémů. Například, XA-transakce blokují provádění, pokud dojde k chybě aplikace ve fázi přípravy. Dále, XA nezajišťuje detekci mrtvých zámků a nepodporuje optimistické schémata řízení paralelismu. Kromě toho některé systémy jako ElasticSearch nepodporují XA nebo jakýkoli jiný heterogenní model transakcí. Zajištění atomárnosti zápisu v různých technologiích úložiště dat zůstává pro aplikace velmi složitým úkolem [3].
Delta
Delta byla vyvinuta k odstranění omezení stávajících řešení pro synchronizaci dat a také umožňuje obohacovat data za chodu. Naším cílem bylo abstraktně vyřešit všechny tyto složité aspekty pro vývojáře aplikací, aby se mohli plně soustředit na implementaci obchodní funkčnosti. Nyní popíšeme 'Movie Search', reálný případ použití Delta od Netflixu.
Netflix široce používá mikroslužbovou architekturu a každá mikroslužba obvykle zpracovává jeden typ dat. Základní informace o filmech jsou umístěny v mikroslužbě s názvem Movie Service, zatímco související data, jako jsou informace o producentích, hercích, dodavatelích atd., jsou řízena několika dalšími mikroslužbami (zejména Deal Service, Talent Service a Vendor Service).
Obchodní uživatelé ve Netflix Studios často potřebují vyhledávat filmy podle různých kritérií, a proto je pro ně velmi důležité mít možnost prohledávat všechna data spojená s filmy.
Před příchodem Delta musela tým pro vyhledávání filmů získávat data z několika mikroslužeb, než indexoval data o filmech. Kromě toho tým musel vyvinout systém, který by pravidelně aktualizoval vyhledávací index dotazováním na změny od jiných mikroslužeb, i když žádné změny nebyly. Tento systém se velmi rychle stal složitým a bylo jej obtížné udržovat.
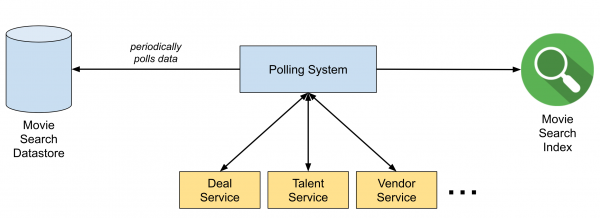
Obrázek 1. Systém pollingů před Delta
Po zahájení používání Delta byla systém zjednodušena na systém řízený událostmi, jak ukazuje následující obrázek. Události CDC (Change-Data-Capture) jsou zasílány do témat Keystone Kafka pomocí Delta-Connectoru. Aplikace Delta, postavená na základě Delta Stream Processing Framework (opírající se o Flink), přijímá CDC události z tématu, obohacuje je přístupem k dalším mikroslužbám a nakonec předává obohacené údaje do vyhledávacího indexu v Elasticsearch. Celý proces probíhá téměř v reálném čase, to znamená, že jakmile jsou změny zaznamenány ve skladovacím systému, vyhledávací indexy se aktualizují.
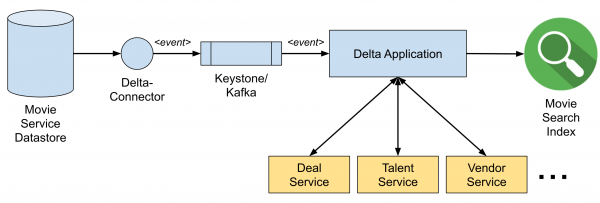
Obrázek 2. Datový pipeline při použití Delta
V následujících sekcích popíšeme fungování Delta-Connectoru, který se připojuje ke skladovacímu systému a publikuje CDC události na přenosové úrovni, což představuje infrastrukturu pro přenos dat v reálném čase, která směřuje CDC události do témat Kafka. A na závěr se budeme věnovat struktuře zpracování proudů Delta, kterou mohou vývojáři aplikací využít pro logiku zpracování a obohacování dat.
CDC (Change-Data-Capture)
Vyvinuli jsme CDC službu nazvanou Delta-Connector, která dokáže v reálném čase zaznamenávat potvrzené změny ze skladovacího systému a zapisovat je do proudu. Změny v reálném čase jsou získávány z transakčního logu a dumpů skladu. Dumpy jsou používány, protože transakční logy obvykle neuchovávají celou historii změn. Změny jsou obvykle serializovány jako události Delta, takže příjemce se nemusí obávat, odkud změna pochází.
Delta-Connector podporuje několik dalších funkcí, jako jsou:
- Možnost psát do vlastních výstupů mimo Kafka.
- Možnost aktivovat manuální dumpy kdykoli pro všechny tabulky, určitou tabulku nebo pro určité primární klíče.
- Dumpy mohou být vybírány po částech, takže není nutné začínat vše znovu v případě selhání.
- Není nutné nastavovat zámky na tabulkách, což je velmi důležité pro to, aby databázový zápisový provoz nikdy nebyl blokován naší službou.
- Vysoká dostupnost díky záložním instancím v dostupnostních zónách AWS.
V současnosti podporujeme MySQL a Postgres, včetně nasazení v AWS RDS a Aurora. Také podporujeme Cassandru (multi-master). Více informací o Delta Connectoru naleznete v tomto .
Kafka a transportní úroveň
Transportní úroveň událostí Delta je postavena na službě výměny zpráv platformy .
Historicky bylo publikování zpráv v Netflix optimalizováno pro zvýšení dostupnosti, nikoli trvanlivosti (viz ). Kompromisem byla potenciální nesouladnost dat brokera v různých okrajových scénářích. Například, unclean leader election zodpovídá za to, že příjemce potenciálně duplikuje nebo ztrácí události.
S Delta jsme chtěli získat silnější záruky trvanlivosti, abychom zajistili dodávku CDC událostí do odvodených úložišť. Za tímto účelem jsme navrhli speciálně navržený cluster Kafka jako objekt prvotní třídy. Můžete se podívat na některá nastavení brokera v tabulce níže:
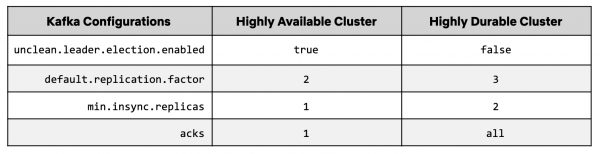
Ve clusterech Keystone Kafka, unclean leader election je obvykle povolen pro zajištění dostupnosti vydavatele. To může vést ke ztrátě zpráv, pokud je nesynchronizovaná replika zvolena jako lídr. Pro nový vysoce spolehlivý cluster Kafka je parametr unclean leader election vypnut, aby se zabránilo ztrátě zpráv.
Také jsme zvýšili replication factor z 2 na 3 a minimum insync replicas z 1 na 2. Vydavatelé, kteří zapisují do tohoto clusteru, vyžadují acks od všech ostatních, což zajišťuje, že 2 z 3 replik budou mít nejaktuálnější zprávy odeslané vydavatelem.
Když instance brokera skončí, nová instance nahradí starou. Novému brokerovi však potrvá, než dohoní nesynchronizované repliky, což může zabrat několik hodin. Abychom zkrátili dobu obnovy tohoto scénáře, začali jsme používat blokové úložiště dat (Amazon Elastic Block Store) namísto místních disků brokerů. Když nová instance nahradí skončenou instanci brokera, připojí EBS svazek, který měl skončený broker, a začne dohánět nové zprávy. Tento proces zkracuje dobu odstraňování zpoždění z několika hodin na několik minut, protože nové instanci již není třeba replikovat z prázdného stavu. Celkově jednotlivé životní cykly úložiště a brokera výrazně snižují dopad efektu změny brokera.
Abychom ještě více zvýšili záruku doručení dat, použili jsme k detekci jakékoli ztráty zpráv v extrémních podmínkách (například desynchronizace hodin v lídrovi rozdělení).
Stream Processing Framework
Úroveň zpracování v Delta je postavena na platformě Netflix SPaaS, která zajišťuje integraci Apache Flink s ekosystémem Netflix. Platforma poskytuje uživatelské rozhraní, které spravuje nasazení úloh Flink a orchestraci Flink clusterů na naší platformě pro správu kontejnerů Titus. Rozhraní také spravuje konfigurace úloh a umožňuje uživatelům dynamicky měnit konfiguraci bez nutnosti znovu kompilovat úlohy Flink.
Delta poskytuje rámec pro zpracování dat v reálném čase (stream processing framework) založený na Flinku a SPaaS, který používá na anotacích založené DSL (Doménově specifický jazyk), aby bylo možné abstraktně zpracovávat technické detaily. Například pro určení kroku, kterým budou události obohacovány voláním externích služeb, musí uživatel napsat následující DSL, a rámec na jeho základě vytvoří model, který bude proveden Flinkem.
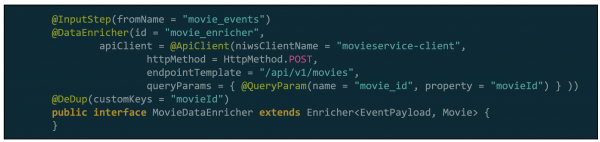
Obrázek 3. Příklad obohacení pomocí DSL v Delta
Rámec pro zpracování nejenže zkracuje křivku učení, ale také poskytuje obecné funkce zpracování toku, jako je deduplikace, schématizace, stejně jako flexibilitu a odolnost proti chybám pro řešení běžných problémů v operacích.
Delta Stream Processing Framework se skládá ze dvou klíčových modulů, modulu DSL & API a modulu Runtime. Modul DSL & API poskytuje DSL a UDF (User-Defined Function) API, aby uživatelé mohli napsat vlastní logiku zpracování (například filtrování nebo transformace). Modul Runtime poskytuje implementaci parsovacího DSL, která vytváří vnitřní reprezentaci kroků zpracování v modelech DAG. Komponent Execution interpretuje DAG modely, aby inicializoval skutečné operátory Flink a nakonec spustil aplikaci Flink. Architektura frameworku je znázorněna na následujícím obrázku.
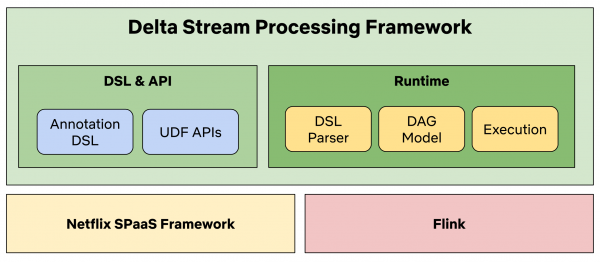
Obrázek 4. Architektura Delta Stream Processing Framework
Tento přístup má několik výhod:
- Uživatelé se mohou soustředit na svou obchodní logiku, aniž by se museli ponořit do specifik Flink nebo struktury SPaaS.
- Optimalizace může probíhat pro uživatele transparentním způsobem a chyby mohou být opraveny bez nutnosti měnit jakýkoli uživatelský kód (UDF).
- Práce aplikací Delta je pro uživatele zjednodušená, protože platforma poskytuje flexibilitu a odolnost proti chybám již v základu a shromažďuje množství podrobných metrik, které lze použít pro upozornění.
Použití v produkci
Delta funguje v produkčním prostředí již více než rok a hraje klíčovou roli v mnoha aplikacích Netflix Studio. Pomohla týmům realizovat takové případy použití jako je indexování vyhledávání, ukládání dat a událostmi řízené pracovní postupy. Níže je uveden přehled architektury platformy Delta na vysoké úrovni.
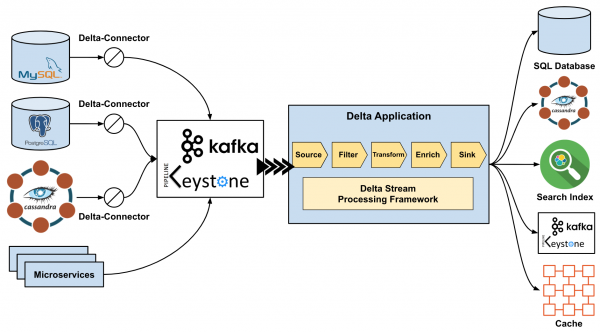
Obrázek 5. Architektura Delta na vysoké úrovni.
Poděkování
Rádi bychom poděkovali následujícím lidem, kteří se podíleli na vzniku a rozvoji Delta v Netflixu: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang a Zhenzhong Xu.
Zdroje
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online event processing. Commun. ACM 62(5): 43–49 (2019). DOI:
: „Data Build Tool pro úložiště Amazon Redshift“.
Zdroj: habr.com
