

Ahoj všichni! Jmenuji se Pavel Agaletsky. Pracuji jako týmový lídr v týmu, který vyvíjí doručovací systém Lamoda. V roce 2018 jsem vystoupil na konferenci HighLoad++, a dnes vám chci představit přepis svého vystoupení.
Mé téma se zabývá zkušeností naší společnosti s nasazením systémů a služeb do různých prostředí. Začínáme od našich pravěkých časů, kdy jsme nasazovali všechny systémy na běžné virtuální servery, a končíme postupným přechodem od Nomadu k nasazení do Kubernetes. Řeknu vám, proč jsme to udělali a jaké problémy jsme v procesu měli.

Nasazení aplikací na VM
Začneme tím, že před 3 lety byly všechny systémy a služby společnosti nasazovány na běžné virtuální servery. Technicky bylo uspořádáno tak, že celý kód našich systémů byl shromažďován prostřednictvím automatické kompilace s pomocí Jenkins. Pomocí Ansible se pak rozšiřoval z našeho systému správy verzí na virtuální servery. Přičemž každý systém, který byl v naší společnosti, byl nasazen minimálně na 2 servery: jedna z nich byla head a druhá tail. Tyto dva systémy byly mezi sebou absolutně identické ve všech svých nastaveních, výkonu, konfiguraci a dalším. Rozdíl mezi nimi byl jen ten, že head dostával uživatelský provoz, zatímco tail nikdy žádný uživatelský provoz nedostával.
Proč bylo toto opatření zavedeno?
Když jsme nasazovali nové verze naší aplikace, chtěli jsme zajistit možnost bezproblémového výstupu, tedy bez viditelných důsledků pro uživatele. Toho bylo dosaženo tím, že nová sestavená verze byla pomocí Ansible nasazena na tail. Tam lidé, kteří se zabývali nasazením, mohli zkontrolovat a ujistit se, že vše funguje; všechny metriky, sekce a aplikace fungují; spouští se potřebné skripty. Až poté, co se ujistili, že je vše v pořádku, došlo k přepnutí provozu. Ten začal směřovat na server, který do té doby byl tail. A server, který byl až dosud head, zůstal bez uživatelského provozu, přičemž měl na sobě předchozí verzi naší aplikace.
Tímto způsobem pro uživatele bylo vše bezproblémové. Přepnutí je okamžité, protože se jedná pouze o přepnutí zatížení. Velmi snadno se dá vrátit k předchozí verzi pouhým přepnutím zpět. Měli jsme také možnost ověřit schopnosti aplikace v produkci ještě před tím, než na ni začne proudit uživatelský provoz, což bylo velmi pohodlné.
Jaké výhody jsme v tom všem viděli?
- V první řadě je to dost jednoduché. Každému je jasné, jak takový způsob nasazení funguje, protože většina lidí někdy nasazovala na běžné virtuální servery.
- Je to dost spolehlivé, protože technologie nasazení je jednoduchá, osvědčená tisíci společností. Miliony serverů jsou nasazovány právě tímto způsobem. Těžko se to dá rozbít.
- A konečně, mohli jsme získat atomové nasazení. Nasazení, které pro uživatele probíhá okamžitě, bez zjevného přepínání mezi starou a novou verzí.
Ale v tom všem jsme také viděli několik nevýhod:
- Kromě produkčního prostředí, vývojového prostředí, existují i další prostředí. Například QA a předprodukce. V tu chvíli jsme měli hodně serverů a kolem 60 služeb. Z tohoto důvodu bylo nutné udržovat aktuální verzi virtuálního stroje pro každou službu. A pokud chcete aktualizovat knihovny nebo nainstalovat nové závislosti, musíte to udělat ve všech prostředích. Také bylo potřeba synchronizovat čas, kdy chcete nasadit další novou verzi vaší aplikace, s časem, kdy devops provede potřebná nastavení prostředí. V takovém případě je snadné dostat se do situace, kdy se naše prostředí bude v několika okamžicích lišit ve všech prostředích. Například v QA prostředí budou jedny verze knihoven, zatímco v produkčním budou jiné, což povede k problémům. Složitost při aktualizaci závislostí
- vaší aplikace. To nezávisí na vás, ale na jiném týmu. A to konkrétně na týmu devops, který udržuje servery. Musíte pro ně stanovit odpovídající úkol a poskytnout popis toho, co chcete udělat. вашего приложения. Это зависит не от вас, а от другой команды. А именно, от команды devops, которая поддерживает сервера. Вы должны поставить для них соответствующую задачу и дать описание того, что хотите сделать.
- V té době jsme také chtěli rozdělit naše velké monolity na jednotlivé malé služby, jelikož jsme chápali, že jich bude stále přibývat. Už jsme jich měli více než 100. Bylo třeba pro každou novou službu vytvořit novou virtuální stroj, který je potřeba spravovat a nasazovat. K tomu všemu je potřeba nejen jedna mašina, ale minimálně dvě. Na to se ještě vztahuje QA prostředí. To způsobuje problémy a činí pro vás vytváření a spouštění nových systémů složitějším, nákladnějším a časově náročnějším procesem. Složitějším, nákladnějším a časově náročnějším procesem.
Proto jsme se rozhodli, že bude pohodlnější přejít od nasazování obyčejných virtuálních strojů k nasazování našich aplikací v kontejnerech Docker. Když máte Docker, potřebujete systém, který dokáže spustit aplikaci v klastru, protože nemůžete jen tak zvednout kontejner. Obvykle je potřeba sledovat, kolik kontejnerů je aktivních, aby se spouštěly automaticky. Z tohoto důvodu bylo potřeba vybrat systém správy.
Dlouho jsme přemýšleli nad tím, který z nich bychom mohli zvolit. Faktem je, že v té době byl náš nasazovací stack na obyčejné virtuální servery poněkud zastaralý, neboť tam byly verze operačních systémů, které nebyly zrovna nejnovější. V určitý moment tam dokonce běžel FreeBSD, které se nebylo příliš pohodlné spravovat. Chápali jsme, že je potřeba co nejrychleji migrovat na Docker. Naši devops se podívali na své dosavadní zkušenosti s různými řešeními a vybrali si systém jako je Nomad.
Přechod na Nomad
Nomad je produkt společnosti HashiCorp. Jsou známí také svými dalšími řešeními:
„Consul“ — nástroj pro objavování služeb.
„Terraform“ — systém pro správu serverů, který vám umožňuje je konfigurovat prostřednictvím konfigurace, tzv. infrastruktura jako kód.
„Vagrant“ umožňuje rozšiřovat virtuální stroje lokálně nebo v cloudu pomocí specifických konfiguračních souborů.
Nomad se tehdy jevil jako dostatečně jednoduché řešení, na které lze rychle přejít bez změny celé infrastruktury. Navíc je dost snadno ovladatelný. Proto jsme ho vybrali jako systém filtrace našeho kontejneru.
Co potřebujete k tomu, abyste vůbec mohli nasadit svůj systém v Nomadu?
- Především potřebujete docker image aplikace. Je nutné ji zkompilovat a umístit do úložiště obrazů docker. V našem případě je to artifactory – systém, který umožňuje nahrávat do něj různé artefakty různých typů. Umí uchovávat archivy, docker obrazy, PHP composer balíčky, NPM balíčky a tak dále.
- Dále je potřeba konfigurační soubor, který řekne Nomadu, co, kam a v jakém množství chcete nasadit.
Když mluvíme o Nomadu, jako formát informačního souboru využívá jazyk HCL, což je zkratka pro HashiCorp Configuration Language. Je to takové nadmnožství nad Yaml, které vám umožňuje popsat vaši službu v termínech Nomadu.
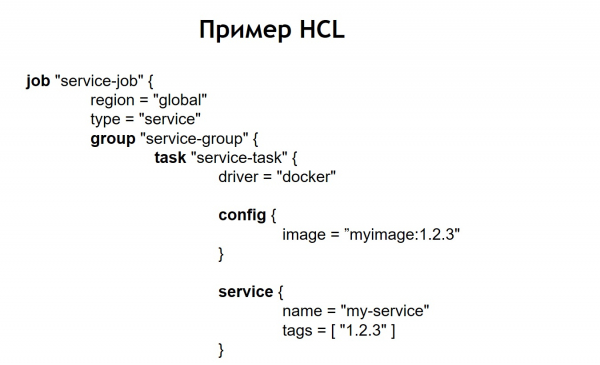
Umožňuje specifikovat, kolik kontejnerů chcete nasadit, z jakých obrazů jim předat různé parametry při nasazení. Takto tento soubor předáte Nomadu a on podle něj spouští kontejnery v produkčním prostředí.
V našem případě jsme zjistili, že psát naprosto stejné, identické HCL soubory pro každou službu by nebylo moc pohodlné, protože služeb je hodně a občas je chceme aktualizovat. Někdy je jeden servis nasazen v několika exemplářích, například jeden z našich systémů v produkci má více než 100 instancí. Spouští se ze stejných obrazů, ale liší se konfiguračními nastaveními a konfiguračními soubory.
Proto jsme se rozhodli, že bude pohodlné ukládat všechny naše konfigurační soubory pro nasazení v jednom společném repozitáři. Takto byly přehledné: bylo snadné je udržovat a vidět, jaké systémy máme. V případě potřeby také nebylo složité něco aktualizovat nebo změnit. Přidat nový systém není také těžké – stačí vytvořit konfigurační soubor uvnitř nové složky. Uvnitř ní leží soubory: service.hcl, který obsahuje popis naší služby, a některé env soubory, které umožňují tuto službu, když je nasazena v produkci, nastavit.
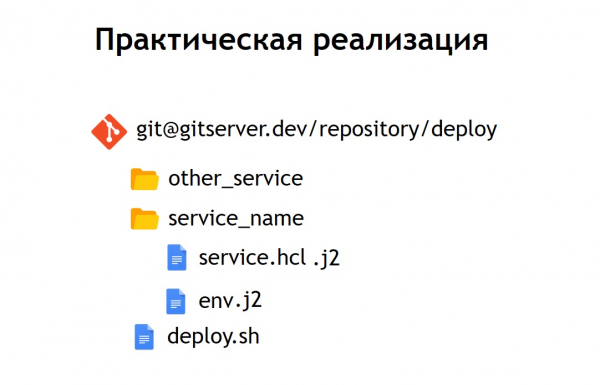
Nicméně některé naše systémy nejsou nasazeny v produkci jen v jednom exempláři, ale v několika najednou. Proto jsme se rozhodli, že bude pohodlné uchovávat ne čisté konfigurace, ale jejich šablonizovanou podobu. A jako jazyk šablonizace jsme zvolili jinja 2V tomto formátu uchováváme jak konfigurace samotné služby, tak i env soubory potřebné pro její provoz.
Kromě toho jsme do repozitáře umístili skript pro nasazení, který je společný pro všechny projekty a který umožňuje spustit a nasadit vaši službu do produkčního prostředí, do požadovaného prostředí a cíle. V případě, že jsme náš HCL konfiguraci převedli na šablonu, tak HCL soubor, který byl dříve obyčejnou konfigurací Nomad, nyní vypadá trochu jinak.
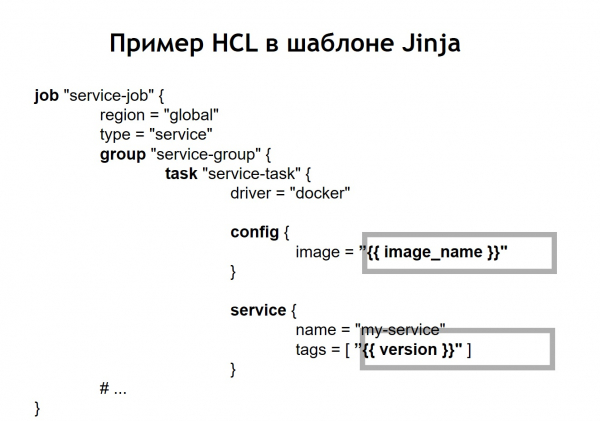
To znamená, že jsme nahradili některé proměnné v konfiguraci proměnnými, které se berou z env souborů nebo z jiných zdrojů. Kromě toho jsme získali možnost dynamicky sestavovat HCL soubory, tedy můžeme použít nejen obyčejné proměnné. Vzhledem k tomu, že jinja podporuje smyčky a podmínky, lze do toho také zahrnout konfigurační soubory, které se mění v závislosti na tom, kam přesně nasazujete své aplikace.
Například chcete nasadit svou službu do předprodukčního a produkčního prostředí. A například v předprodukčním prostředí nechcete spouštět cron skripty, ale chcete jen vidět službu na samostatné doméně, abyste se ujistili, že funguje. Pro každého, kdo nasazuje službu, je proces velmi jednoduchý a přehledný. Stačí spustit soubor deploy.sh, uvést, kterou službu chcete nasadit a do jakého cíle. Například chcete nasadit nějaký systém do Ruska, do Běloruska nebo Kazachstánu. K tomu stačí změnit jeden z parametrů a správný konfigurační soubor se automaticky vygeneruje.
Po nasazení služby Nomad do vašeho clusteru vypadá následujícím způsobem.
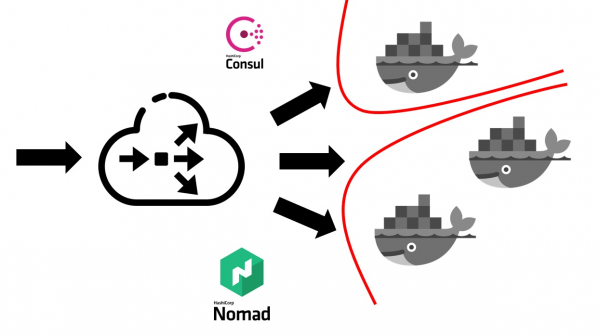
Nejprve potřebujete nějaký externí vyvažovač zatížení, který přijme veškerý uživatelský provoz. Bude spolupracovat s Consul a zeptá se ho, kde, na které uzlu, na jakém IP adresu se nachází konkrétní služba, která odpovídá danému doménovému jménu. Služby v Consul se objevují přímo z Nomad. Jelikož jsou to produkty téže společnosti, jsou mezi sebou dobře propojeny. Dá se říci, že Nomad nativně umí registrovat všechny služby, které v něm běží, uvnitř Consul.
Jakmile váš externí vyvážeč zatížení zjistí, kterému servisu má poslat provoz, přesměruje ho na odpovídající kontejner nebo na několik kontejnerů odpovídajících vaší aplikaci. Samozřejmě je nutné myslet také na bezpečnost. I když se všechny služby spouštějí na stejných virtuálních strojích v kontejnerech, obvykle je potřeba zakázat volný přístup jakékoli službě k jakékoli jiné. Toho jsme dosahovali segmentací. Každá služba byla spuštěna ve své vlastní virtuální síti, na které byla nastavena pravidla směrování a pravidla povolení/zákazu přístupu k dalším systémům a službám. Ty mohly být jak uvnitř tohoto clusteru, tak i mimo něj. Například pokud chcete zakázat službě připojit se k určité databázi, lze to udělat pomocí segmentace na úrovni sítě. To znamená, že ani omylem se nemůžete náhodně připojit z testovacího prostředí k vaší produkční databázi.
Kolik nám proces přechodu přinesl v oblasti lidských zdrojů?
Přechod celé společnosti na Nomad trval přibližně 5-6 měsíců. Přecházeli jsme po jednotlivých službách, ale dost rychlým tempem. Každý tým měl vytvořit vlastní kontejnery pro služby.
Máme přijatý přístup, že každý tým se sám stará o docker obrazce svých systémů. DevOps poskytují společnou infrastrukturu potřebnou pro nasazení, tedy podporu samotného clusteru, podporu CI systému a tak dále. V té době se k nám více než 60 systémů přestěhovalo na Nomad, což zahrnovalo přibližně 2000 kontejnerů.
DevOps odpovídají za celkovou infrastrukturu všeho, co souvisí s nasazením a servery. A každý vývojový tým na druhé straně odpovídá za implementaci kontejnerů pro svůj konkrétní systém, protože to je právě tým, který ví, co potřebuje v tom kterém kontejneru.
Důvody pro opuštění Nomad
Jaké výhody jsme získali přechodem na nasazení pomocí Nomad a Dockeru?
- Jsme zajistili jsme stejné podmínky pro všechny prostředí. V developmente, QA prostředí, preprodukci a produkci se používají stejné obrazy kontejnerů se stejnými závislostmi. Tím pádem prakticky nemáte šanci, že do produkce půjde něco, co jste předtím netestovali lokálně nebo na testovacím prostředí.
- Také jsme zjistili, že stačí snadno přidat novou službu. Jakékoli nové systémy z pohledu nasazení se spouští velmi jednoduše. Stačí jít do repozitáře, který obsahuje konfigurace, přidat tam další konfiguraci pro váš systém a máte vše připravené. Můžete nasadit svůj systém do produkce bez dodatečného úsilí od DevOps.
- Vše konfigurační soubory v jednom společném repozitáři se ukázaly jako přehledné. V okamžiku, kdy jsme nasazovali naše systémy pomocí virtuálních serverů, používali jsme Ansible, ve kterém byly konfigurace uloženy ve stejném repozitáři. Nicméně pro většinu vývojářů bylo s tímto pracovat o něco složitější. Objem konfigurací a kódu, které musíte přidat, abyste nasadili službu, se výrazně snížil. Plus pro DevOps je velmi snadné to opravit nebo změnit. Při přechodech, například na novou verzi Nomad, mohou hromadně aktualizovat všechny operační soubory, které jsou na stejném místě.
Ale zároveň jsme se setkali i s několika nevýhodami:
Ukázalo se, že jsme nedokázali dosáhnout bezproblémového nasazení v případě Nomad. Při nasazování kontejnerů z různých podmínek se mohlo stát, že byl spuštěn a Nomad ho vnímal jako kontejner připravený k přijetí provozu. K tomu došlo ještě předtím, než se aplikace uvnitř něho stačila spustit. Z tohoto důvodu systém na krátkou dobu začal vykazovat chyby 500, protože provoz začal směřovat na kontejner, který ještě nebyl připraven ho přijmout.
Setkali jsme se s některými chybami. Největší problém spočívá v tom, že Nomad nepracuje dobře s velkým klastrem, pokud máte spoustu systémů a kontejnerů. Když chcete odebrat jeden ze serverů ze správy, který je součástí klastru Nomad, je pravděpodobné, že se klastr začne chovat nestabilně a rozpadne se. Některé kontejnery mohou například spadnout a neobnovit se, což vám později velmi podraží, pokud všechny vaše systémy produkce běží právě v klastru řízeném Nomadem.
Proto jsme se rozhodli zvážit, kam jít dál. V té době jsme už lépe chápali, čeho chceme dosáhnout. A sice: chceme spolehlivost, trochu více funkcí, než nabízí Nomad, a zralejší, stabilnější systém.
V tomto ohledu jsme se rozhodli pro Kubernetes jako nejpopulárnější platformu pro spuštění klastrů. Obzvláště vzhledem k tomu, že velikost a počet našich kontejnerů byl dostatečně velký. Pro tyto účely se Kubernetes jevil jako nejvhodnější systém z těch, které jsme mohli zvažovat.
Přechod na Kubernetes
Trochu vám představím základní pojmy Kubernetes a čím se liší od Nomadu.
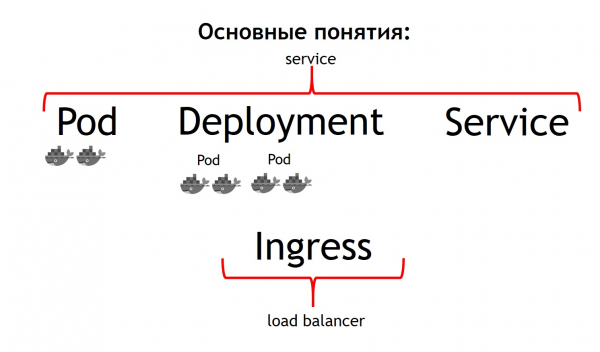
V první řadě je nejzákladnějším pojmem v Kubernetes pojem pod. Pod — to je skupina jednoho nebo více kontejnerů, které vždy běží společně. A fungují, jako by byly vždy na jedné virtuální mašině. Jsou si navzájem dostupné přes IP adresu 127.0.0.1 na různých portech.
Představte si, že máte PHP aplikaci, která se skládá z nginx a php-fpm – klasická schéma. Pravděpodobně byste chtěli, aby kontejnery nginx a php-fpm byly vždy spolu. Kubernetes to umožňuje tím, že je popíšete jako jeden společný pod. Toho jsme ale nebyli schopni dosáhnout s Nomadem.
Druhým pojmem je deployment. Pod je totiž sám o sobě efemérní záležitostí, spouští se a mizí. Chcete-li nejprve zlikvidovat všechny vaše předchozí kontejnery a poté spustit nové verze, nebo zda je chcete nasazovat postupně – přesně za tento proces odpovídá pojem deployment. Ten popisuje, jak nasazujete své pody, v jakém množství a jak je aktualizovat.
Třetím pojmem je serviceVáš service je v podstatě váš systém, který přijímá určitý provoz a poté jej směruje na jeden nebo více podů odpovídajících vašemu servisu. To znamená, že umožňuje říci, že veškerý příchozí provoz na tento konkrétní servis s tímto názvem musí být poslán na tyto konkrétní pody. A přitom zajišťuje vyvažování provozu. Můžete spustit dva pody vaší aplikace a veškerý příchozí provoz bude rovnoměrně vyvážen mezi pody souvisejícími s tímto servisem.
A čtvrtý základní pojem — Ingressje to služba, která se spouští v klastru Kubernetes. Působí jako externí vyvažovač zátěže, který přebírá všechny požadavky. Díky API Kubernetes Ingress může určovat, kam tyto požadavky poslat. A dělá to velmi flexibilně. Můžete říci, že všechny požadavky na tento host a takovou URL posieláme na tuto službu. A tyto požadavky, které přicházejí na tento host a na jinou URL, posíláme na jinou službu.
Nejlepší na tom, kdo vyvíjí aplikaci, je to, že můžete všemu řídit sami. Nastavením konfigurace Ingress můžete veškerý provoz, který přichází na tuto API, posílat na jednotlivé kontejnery, například ty napsané v Go. A tento provoz, který přichází na stejnou doménu, ale na jinou URL, poslat na kontejnery napsané v PHP, kde je hodně logiky, ale nejsou příliš rychlé.
Pokud porovnáme všechny tyto pojmy s Nomad, lze říci, že prvních tři pojmy jsou dohromady Servis. A poslední pojem v samotném Nomadu chybí. My jako jeho náhradu použili externí vyvažovač: může to být haproxy, nginx, nginx+ a tak dále. V případě kubernetes nemusíte zavádět tento dodatečný pojem zvlášť. Nicméně, pokud se podíváte na Ingress uvnitř, je to buď nginx, nebo haproxy, nebo traefik, ale jakoby zabudované v Kubernetes.
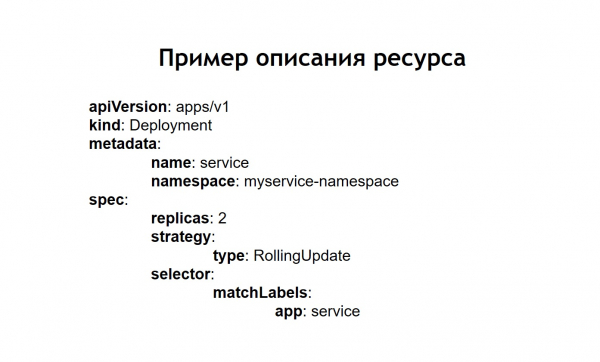
Všechny pojmy, které jsem popsal, jsou v podstatě zdroje, které existují uvnitř klastru Kubernetes. Pro jejich popis se v kubernetes používá yaml formát, který je čitelnější a známější než HCL soubory v případě Nomad. Ale strukturálně popisují například pod stejně. Říkají – chci nasadit takovéto pody tam, s takovými imidži, v takovém množství.
Kromě toho jsme pochopili, že nechceme ručně vytvářet každý jednotlivý zdroj: nasazení, služby, Ingress a další. Místo toho jsme chtěli při nasazení popisovat každou naši systémovou instanci pomocí termínů Kubernetes, abychom nemuseli ručně znovu vytvářet všechny potřebné závislosti zdrojů ve správném pořadí. Jako takový systém, který nám to umožnil, byl vybrán Helm.
Základní pojmy v Helmu
Helm je balíčkový manažer pro Kubernetes. Velmi připomíná způsob, jakým fungují správci balíčků v programovacích jazycích. Umožňuje vám uchovávat službu, která se skládá například z nasazení nginx, nasazení php-fpm, konfigurace pro Ingress, configmaps (to je entita, která vám umožňuje nastavit env a další parametry pro váš systém), ve formě takzvaných chartů. Helm pracuje nad Kubernetes.. To znamená, že to není nějaký systém stojící stranou, ale prostě další služba spuštěná uvnitř klastru. Komunikujete s ním prostřednictvím jeho API pomocí příkazového řádku. Jeho pohodlí a kouzlo spočívá v tom, že i když helm selže nebo jej odstraníte z klastru, vaše služby nezmizí, protože helm slouží v podstatě pouze k spuštění systému. Za funkčnost a stav služeb následně odpovídá samotný Kubernetes.
Také jsme pochopili, že šablonování, které jsme do té doby museli provádět sami prostřednictvím integrace jinja do našich konfigurací, je jednou z hlavních funkcí helmu. Všechny konfigurace, které vytváříte pro své systémy, jsou v helm uloženy ve formě šablon, které se trochu podobaly jinja, ale ve skutečnosti používají šablonování jazyka Go, ve kterém je helm napsán, stejně jako Kubernetes.
Helm nám přidává ještě několik dalších pojmů.
Chart — to je popis vaší služby. V jiných správcích balíčků by tomu říkali balíček, bundle nebo něco podobného. Tady se tomu říká chart.
Values – to jsou proměnné, které chcete použít k sestavení svých konfigurací z šablon.
ReleaseKaždý jednotlivý servis, který je nasazován pomocí helm, získává inkrementální verzi vydání. Helm si pamatuje, jaká byla konfigurace servisu při předchozím, předpředchozím vydání a tak dále. Proto stačí provést příkaz helm callback a uvést mu předchozí verzi vydání, pokud je třeba se vrátit zpět. I když při návratu nebude příslušná konfigurace dostupná ve vašem repozitáři, helm si stále pamatuje, jaká byla, a vrátí váš systém do stavu, ve kterém byl při předchozím vydání.
V případě, kdy používáme helm, se běžné konfigurace pro Kubernetes také proměňují na šablony, ve kterých je možné použít proměnné, funkce a aplikovat podmínkové operátory. Tímto způsobem můžete sestavit konfiguraci vašeho servisu v závislosti na prostředí.
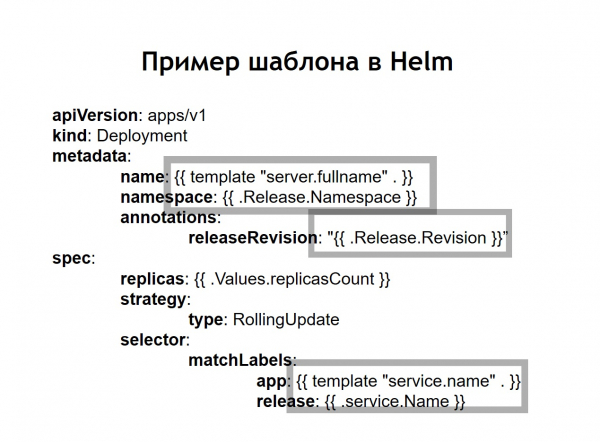
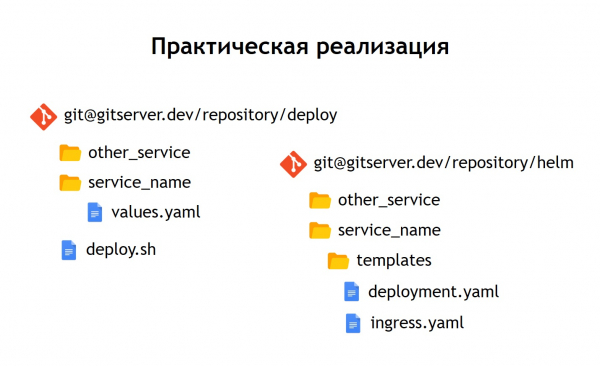
V praxi jsme se rozhodli postupovat trochu jinak, než jsme to dělali v případě s Nomad. Pokud v Nomad byly v jednom repozitáři uchovány jak konfigurace pro nasazení, tak i proměnné n, které jsou potřeba k nasazení našeho servisu, zde jsme se rozhodli je rozdělit na dva samostatné repozitáře. V repozitáři „deploy“ jsou uchovávány pouze proměnné n potřebné pro nasazení, zatímco v repozitáři „helm“ jsou uchovávány konfigurace nebo chart.
Co nám to dalo?
Ačkoliv v samotných konfiguračních souborech neuchováváme žádné skutečně citlivé údaje, například hesla k databázím. Ta jsou uchovávána ve formě tajemství v Kubernetes, přesto stále existují určité věci, k nimž nechceme poskytovat přístup všem. Proto je přístup k repozitáři „deploy“ omezenější, zatímco repozitář „helm“ obsahuje pouze popis servisu. Z tohoto důvodu do něj můžeme bezpečně poskytnout přístup širšímu okruhu osob.
Protože máme nejen produkci, ale i jiná prostředí, tak díky takovému rozdělení můžeme znovu použít naše helm chart pro nasazení servisů nejen v produkci, ale i například v QA prostředí. Dokonce i pro to, abychom je nasadili lokálně, používáme Minikube — to je nástroj pro lokální spuštění Kubernetes.
V každém repozitáři jsme ponechali rozdělení na jednotlivé adresáře pro každou službu. To znamená, že uvnitř každého adresáře se nacházejí šablony, které se vztahují k příslušnému chartu a popisují zdroje, které je třeba nasadit pro spuštění našeho systému. V repozitáři „deploy“ jsme ponechali pouze env. V tomto případě jsme se nerozhodli použít šablonování pomocí jinja, protože helm sám poskytuje šablonování již z krabice – to je jedna z jeho hlavních funkcí.
Zanechali jsme skript pro nasazení – deploy.sh, který zjednodušuje a standardizuje spuštění pro nasazení pomocí helm. Tímto způsobem, pro každého, kdo chce nasadit, vypadá rozhraní nasazení přesně stejně, jako to bylo v případě nasazení přes Nomad. Stejný deploy.sh, název vaší služby a místo, kam chcete službu nasadit. To vede k tomu, že v pozadí se spouští helm. Ten pak shromažďuje konfigurace ze šablon, nahrazuje potřebné values soubory a poté provádí nasazení do Kubernetes.
Závěry
Služba Kubernetes vypadá složitěji než Nomad.
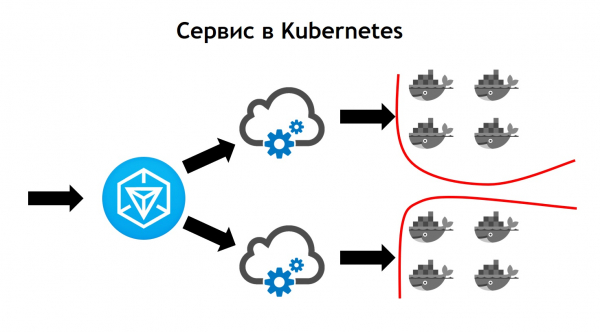
Zde odchozí provoz přichází do Ingress. To je právě frontový kontrolér, který přijímá všechny požadavky a následně je posílá do odpovídajících služeb podle dat požadavku. Tyto služby jsou určeny na základě konfigurací, které jsou součástí popisu vaší aplikace v helm a které si vývojáři sami nastavují. Služba pak posílá požadavky na své pody, tedy konkrétní kontejnery, vyvažující přicházející provoz mezi všemi kontejnery, které se k dané službě vztahují. A samozřejmě, nesmíme zapomínat na to, že na úrovni sítě musíme zajistit bezpečnost. Proto v Kubernetes clusteru funguje segmentace, která je založena na tagování. Všechny služby mají určité tagy, ke kterým jsou přiřazena práva přístupu služeb k různým externím/vnitřním zdrojům uvnitř či vně clusteru.
Během přechodu jsme zjistili, že Kubernetes má všechny funkce, které měl Nomad, který jsme dříve používali, a navíc přidává mnoho nového. Lze ho rozšiřovat pomocí pluginů, a to skutečně pomocí vlastních typů zdrojů. To znamená, že máte možnost ne pouze používat to, co je v Kubernetes k dispozici standardně, ale také vytvořit svůj vlastní zdroj a službu, která bude tento zdroj číst. To poskytuje další možnosti rozšiřování vašeho systému bez potřeby přeinstalace Kubernetes a bez nutnosti jakýchkoliv změn.
Příkladem takového použití je Prometheus, který běží u nás uvnitř Kubernetes clusteru. Aby začal sbírat metriky z nějaké služby, musíme do popisu služby přidat další typ zdroje, takzvaný service monitor. Prometheus má schopnost číst vlastní typy zdrojů, když je spuštěn v Kubernetes, takže automaticky začíná sbírat metriky z nového systému. To je velmi praktické.
První nasazení, které jsme provedli v Kubernetes, proběhlo v březnu 2018. A za tu dobu jsme nikdy neměli žádné problémy. Funguje dostatečně stabilně bez podstatných chyb. Navíc ho můžeme dále rozšiřovat. V současnosti nám stačí funkce, které v něm jsou, a tempo vývoje Kubernetes se nám velmi líbí. V tuto chvíli je v Kubernetes více než 3000 kontejnerů. Cluster se skládá z několika uzlů. Je přitom spravovaný, stabilní a velmi kontrolovatelný.
Zdroj: habr.com
