

Kubernetes je vynikající nástroj pro nasazení kontejnerů Docker v produkčním prostředí s přehledností. Nicméně existují úkoly, které Kubernetes nedokáže vyřešit. Při častém nasazení v pracovním prostředí potřebujeme plně automatizované nasazení Blue/Green, abychom se vyhnuli prostojům v tomto procesu, přičemž je také nutné zpracovávat externí HTTP požadavky a provádět ukončení SSL. To vyžaduje integraci s vyrovnávačem zátěže, jako je ha-proxy. Dalším úkolem je poloautomatické škálování samotného klastru Kubernetes při provozu v cloudovém prostředí, například částečné zmenšení klastru v nočních hodinách.
I když Kubernetes nemá tyto funkce přímo „z krabice“, poskytuje API, které lze využít k vyřešení podobných úloh. Nástroje pro automatizované nasazení Blue/Green a škálování klastru Kubernetes byly vyvinuty v rámci projektu Cloud RTI, který byl vytvořen na základě open-source.
V tomto článku, transkriptu videa, se dozvíte, jak nastavit Kubernetes spolu s dalšími komponentami otevřeného kódu pro vytvoření produkčního prostředí, které bez prostojů v produkci zpracovává kód z git commit.
Takže poté, co získáte přístup k vašim aplikacím z vnějšího světa, můžete přejít na plné nastavení automatizace, tedy dostat ji do stavu, kdy můžete provést git commit a ujistit se, že tento git commit končí v produkci. Je jasné, že při implementaci těchto kroků, při provádění nasazení, se nechceme setkat s prostojem. Takže jakákoliv automatizace v Kubernetes začíná API.
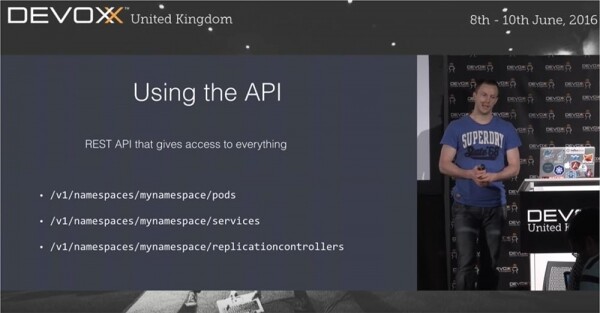
Kubernetes není nástroj, který by bylo možné efektivně použít „přímo z krabice“. Samozřejmě, že to můžete dělat, používat kubectl a tak dále, ale API je tou nejzajímavější a nejvíce užitečnou součástí této platformy. Používáním API jako sady funkcí můžete získat přístup k téměř všemu, co chcete v Kubernetes udělat. Samotný kubectl také využívá REST API.
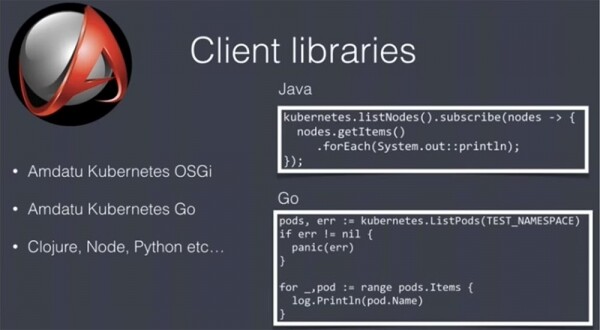
Jedná se o REST, takže můžete použít jakékoli jazyky a nástroje pro práci s tímto API, ale vaše životy značně usnadní uživatelské knihovny. Můj tým napsal 2 takové knihovny: jednu pro Java / OSGi a jednu pro Go. Druhá se příliš často nepoužívá, ale v každém případě máte k dispozici tyto užitečné věci. Jsou to částečně licencované open-source projekty. Existuje mnoho takových knihoven pro různé jazyky, takže si můžete vybrat ty nejvhodnější.
Takže než se pustíme do automatizace nasazení, je nutné zajistit, že tento proces nebude vystaven žádným prostojům. Například náš tým provádí produkční nasazení během dne, kdy lidé maximálně využívají aplikace, takže je velmi důležité vyhnout se zpožděním v tomto procesu. Abychom se vyhnuli prostoji, používají se 2 metody: blue/green nasazení nebo rolling update. V druhém případě, pokud máte 5 replik aplikace, postupně se aktualizují jedna po druhé. Tento způsob skvěle funguje, ale nehodí se, pokud během nasazení běží různé verze aplikace současně. V takovém případě můžete aktualizovat uživatelské rozhraní, zatímco backend bude pracovat se starou verzí, a činnost aplikace se přeruší. Proto je z pohledu programování práce v takových podmínkách poměrně obtížná.
To je jeden z důvodů, proč dáváme přednost použití blue/green nasazení pro automatizaci nasazení našich aplikací. Při tomto způsobu musíte zajistit, aby v určitém okamžiku byla aktivní pouze jedna verze aplikace.
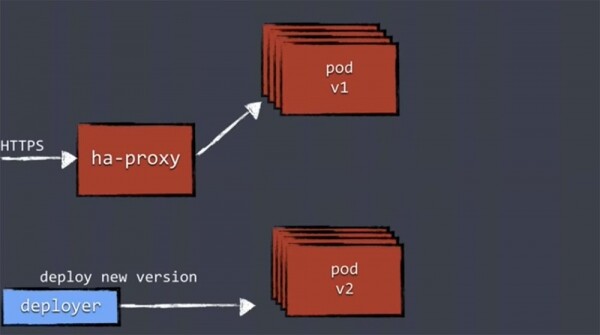
Mechanismus blue/green nasazení vypadá takto. Získáváme provoz pro naše aplikace přes ha-proxy, který ho směruje k běžícím replikám aplikace stejné verze.
Při novém nasazení používáme Deployer, kterému jsou poskytnuty nové komponenty a ten provádí nasazení nové verze. Nasazení nové verze aplikace znamená, že se „spouští“ nová sada replik, po čemž jsou tyto repliky nové verze spuštěny ve zcela novém podu. Nicméně ha-proxy o nich zatím neví a zatím neposílá žádnou pracovní zátěž.
Proto je v první řadě nutné provést kontrolu funkčnosti nových verzí pomocí health checking, abychom se ujistili, že repliky jsou připraveny obsluhovat zátěž.
Všechny nasazované komponenty musí podporovat nějakou formu health checku. Může to být zcela jednoduchá HTTP kontrola, kdy obdržíte kód s odpovědí 200, nebo hlubší kontrola, při které ověřujete spojení replik s databází a dalšími službami, stabilitu spojení dynamického prostředí, zda se vše spouští a funguje správně. Tento proces může být poměrně složitý.
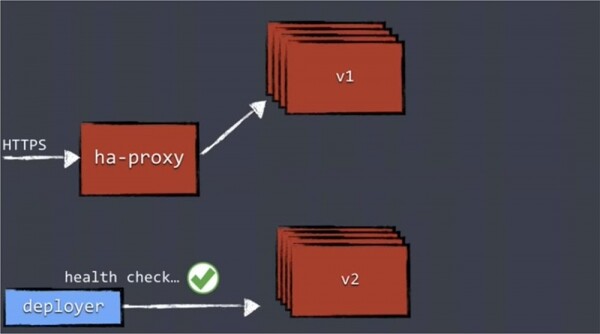
Jakmile systém ověří funkčnost všech aktualizovaných replik, Deployer aktualizuje konfiguraci a předá správný confd, který přeprogramuje ha-proxy.
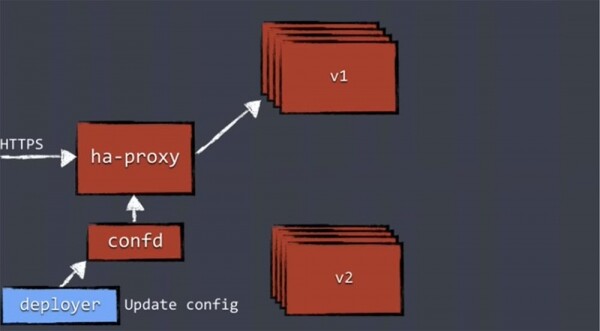
Teprve poté bude provoz směrován do podu s replikami nové verze, zatímco starý pod zmizí.
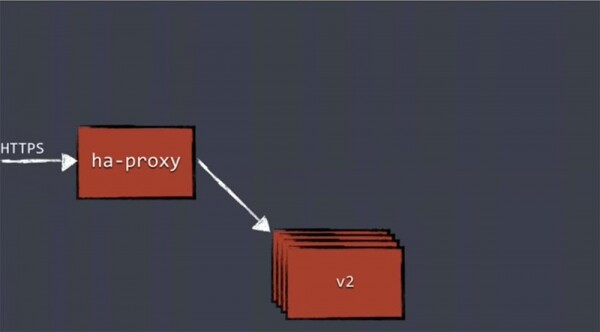
Tento mechanismus není specifický pro Kubernetes. Koncept Blue/green deployment existuje už poměrně dlouho a vždy používal vyvažovač zátěže. Nejprve směrujete veškerý provoz na starou verzi aplikace a po aktualizaci ho plně přesměrujete na novou verzi. Tento princip se používá nejen v Kubernetes.
Nyní vám představím nový nasazovací komponent – Deployer, který provádí kontrolu funkčnosti, rekonfiguruje proxy a podobně. To je koncept, který se netýká vnějšího světa a existuje uvnitř Kubernetes. Ukážu vám, jak vytvořit svůj vlastní koncept Deployer pomocí open-source nástrojů.
První věc, kterou Deployer dělá, je vytvoření replikace kontroleru RC pomocí Kubernetes API. Toto API vytváří pody a služby pro další nasazení, tedy plně nový klastr pro naše aplikace. Jakmile si RC ověří, že repliky byly spuštěny, provede kontrolu jejich funkčnosti pomocí Health check. K tomu Deployer používá příkaz GET /health. Ten spustí příslušné kontrolní komponenty a zkontroluje všechny prvky zajišťující funkci klastru.
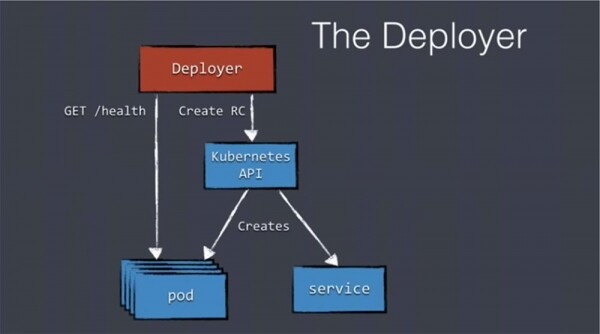
Jakmile všechny pody potvrdí svou „zdravotní“ situaci, Deployer vytvoří nový konfigurační prvek – distribuované úložiště etcd, které se používá uvnitř Kubernetes, včetně uchovávání konfigurace vyvažovače zátěže. Zapisujeme data do etcd a malý nástroj confd sleduje etcd na nové údaje.
Pokud odhalí nějaké změny původní konfigurace, vygeneruje nový konfigurační soubor a předá ho ha-proxy. V tomto případě se ha-proxy restartuje bez ztráty jakýchkoliv spojení a směřuje zátěž na nové služby, které zajišťují fungování nové verze našich aplikací.
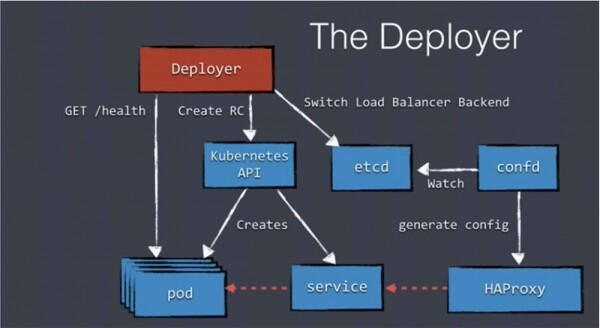
Jak vidíte, přes bohatství komponent není nic složitého. Stačí věnovat více pozornosti API a etcd. Chci vám povědět o open-source deployeru, který sami používáme – Amdatu Kubernetes Deployer.
Je to nástroj pro orchestraci nasazení Kubernetes, který má funkce:
- nasazení Blue/Green;
- nastavení externího vyvažovače zátěže;
- správa deskriptorů nasazení;
- správa aktuálního nasazení;
- kontrola funkčnosti Health checks během nasazení;
- vkládání proměnných prostředí do podů.
Tento Deployer je vytvořen na vrcholu Kubernetes API a představuje REST API pro správu deskriptorů a nasazení, a také Websocket API pro streamování logů během nasazení.
Umísťuje data konfigurace vyvažovače zátěže do etcd, takže nemusíte používat ha-proxy s podporou „přímo z krabice“, ale můžete snadno použít svůj vlastní konfigurační soubor vyvažovače. Amdatu Deployer je napsán v Go, stejně jako Kubernetes, a je licencován Apache.
Před tím, než začnu používat tuto verzi deployera, využil jsem následující deskriptor nasazení, ve kterém jsou uvedeny potřebné parametry.
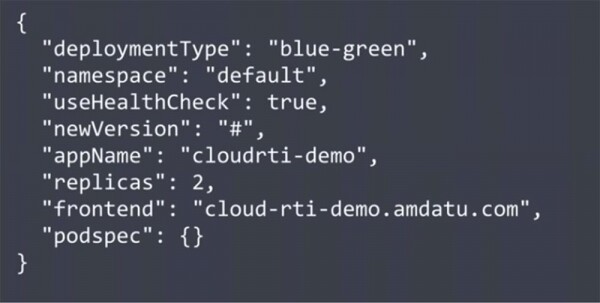
Jedním z důležitých parametrů tohoto kódu je zapnutí příznaku „useHealthCheck“. Musíme uvést, že během nasazení by měla probíhat kontrola funkčnosti. Tento parametr lze vypnout, když se v nasazení používají kontejnery třetích stran, které není potřeba kontrolovat. V tomto deskriptoru je také uveden počet replik a URL frontendu, který potřebuje ha-proxy. Na konci je uveden příznak specifikace podu „podspec“, který se dotazuje Kubernetes na informace o konfiguraci portů, obrazu atd. Je to poměrně jednoduchý deskriptor ve formátu JSON.
Dalším nástrojem, který je součástí open-source projektu Amdatu, je Deploymentctl. Má uživatelské rozhraní UI pro konfiguraci nasazení, uchovává historii nasazení a obsahuje webhooks pro zpětné volání od třetích stran a vývojářů. Můžete UI nepoužívat, protože Amdatu Deployer je REST API, ale toto rozhraní vám může výrazně usnadnit nasazení bez zapojení jakéhokoli API. Deploymentctl je napsán v OSGi/Vertx s využitím Angular 2.
Nyní předvedu výše uvedené na obrazovce pomocí předem učiněného záznamu, takže nebudete muset čekat. Budeme nasazovat jednoduchou aplikaci na Go. Nebojte se, pokud jste se s Go dosud nesetkali, je to velmi jednoduchá aplikace, takže vám bude vše jasné.
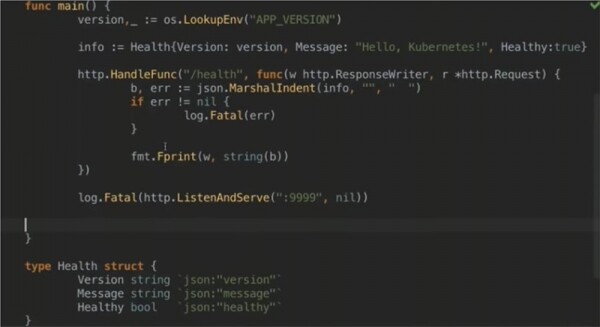
Zde vytváříme HTTP server, který odpovídá pouze na /health, takže tato aplikace kontroluje pouze funkčnost health check a nic víc. Pokud test proběhne, aktivuje se JSON struktura uvedená níže. Obsahuje verzi aplikace, která bude nasazena deployerem, message, kterou vidíte v horní části souboru, a logický typ dat boolean — zda je naše aplikace funkční nebo ne.
S posledním řádkem jsem trochu podváděl, protože jsem na začátek souboru umístil pevnou hodnotu boolean, která mi později pomůže nasadit i „nefunkční“ aplikaci. Později se s tímto vypořádáme.
Tak, pojďme na to. Nejprve zkontrolujeme, zda jsou spuštěny nějaké pody pomocí příkazu ~ kubectl get pods a podle absence odpovědi URL frontendu se ujistíme, že v tuto chvíli není žádné nasazení.
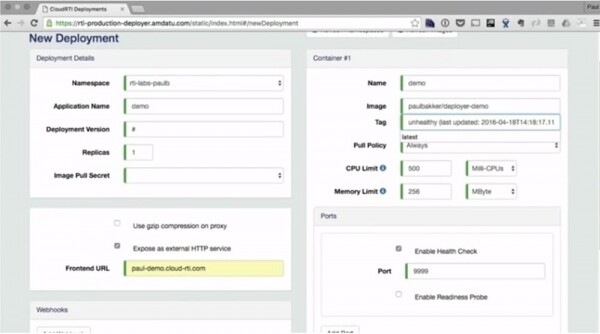
Na obrazovce vidíte rozhraní Deploymentctl, které jsem zmínil, kde se nastavují parametry nasazení: prostor názvů, název aplikace, verze nasazení, počet replik, frontend-URL, název kontejneru, obraz, limity zdrojů, číslo portu pro kontrolu zdraví atd. Limity zdrojů jsou velmi důležité, protože umožňují co nejlépe využít dostupný hardware. Zde lze také zobrazit záznam nasazení Deployment log.
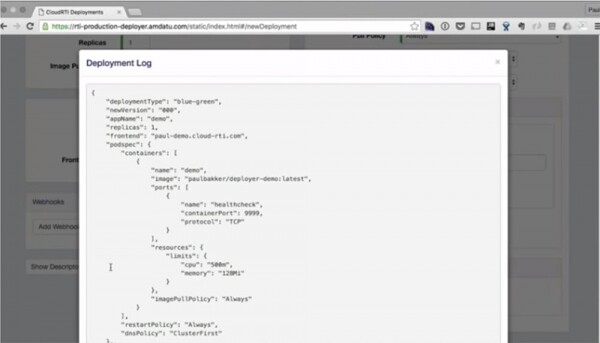
Pokud nyní znovu spustíme příkaz ~ kubectl get pods, uvidíme, že systém "zamrzne" na 20 sekund, během kterých probíhá rekonfigurace ha-proxy. Poté se pod spustí a naši repliku můžeme vidět v záznamu nasazení.
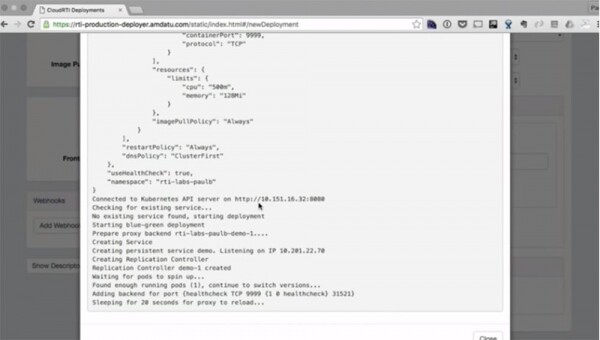
Vyřadil jsem z videa 20 sekundové čekání a nyní vidíte na obrazovce, že první verze aplikace byla nasazena. To vše bylo provedeno pouze pomocí UI.
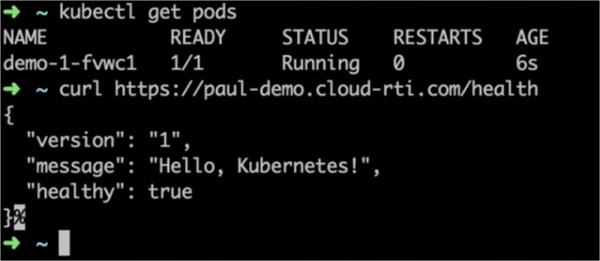
Nyní zkusíme druhou verzi. K tomu změním zprávu aplikace z "Hello, Kubernetes!" na "Hello, Deployer!", systém vytvoří tento obraz a umístí ho do registru Docker, poté znovu stiskneme tlačítko "Deploy" v okně Deploymentctl. Tímto se automaticky spustí záznam nasazení stejně, jako tomu bylo při nasazení první verze aplikace.
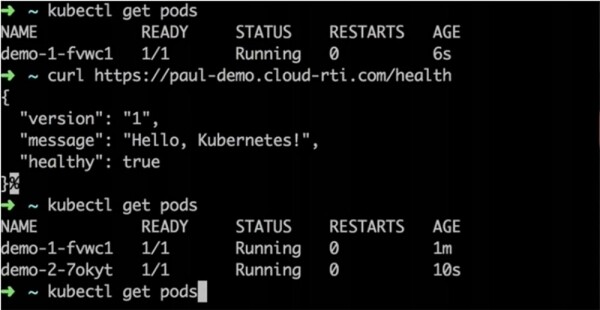
Příkaz ~ kubectl get pods ukazuje, že v tuto chvíli jsou spuštěny 2 verze aplikace, nicméně frontend ukazuje, že stále běží verze 1.
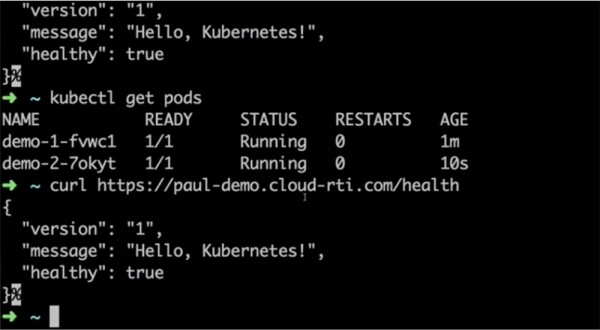
Vyvažovač zátěže čeká, dokud proběhne kontrola zdraví, po níž přesměruje provoz na novou verzi. Po 20 s se přepneme na curl a vidíme, že nyní je nasazena verze 2 aplikace, zatímco verze 1 byla odstraněna.
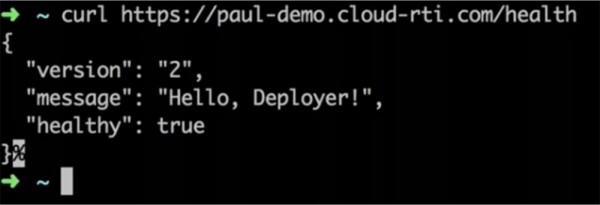
Bylo to nasazení "zdravé" — healthy — aplikace. Podívejme se, co se stane, když pro novou verzi aplikace změním hodnotu parametru Healthy z true na false, tedy zkusím nasadit nezdravou aplikaci, která neprošla kontrolou funkčnosti. K tomu může dojít, pokud byly v průběhu vývoje v aplikaci udělány nějaké chyby v konfiguraci a takto byla odeslána do produkce.
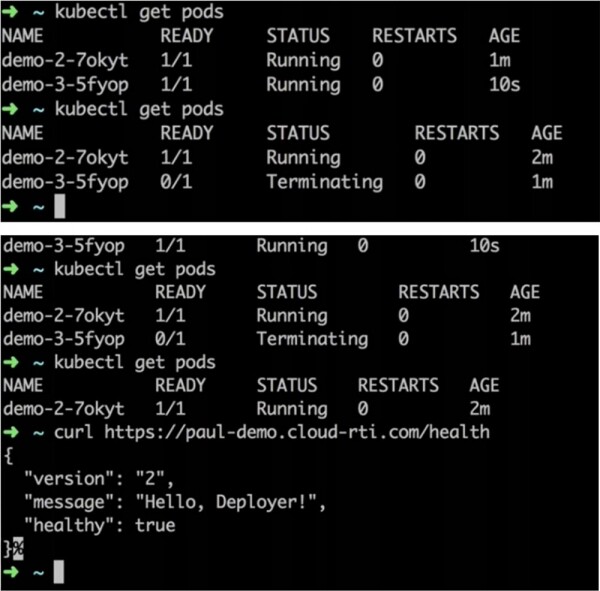
Jak vidíte, nasazení prochází všemi výše uvedenými fázemi a ~ kubectl get pods ukazuje, že běží oba pody. Ale na rozdíl od předchozího nasazení log ukazuje stav timeout. To znamená, že kvůli tomu, že health check neprošel, nová verze aplikace nemůže být nasazena. Výsledkem je, že vidíte, že systém se vrátil k použití staré verze aplikace a nová verze byla prostě odstraněna.
Dobré na tom je, že i když máte obrovské množství současných požadavků, které přicházejí do aplikace, uživatelé si ani nevšimnou prostojů během provádění nasazení. Pokud tuto aplikaci otestujete pomocí frameworku Gatling, který jí posílá maximální možné množství požadavků, ani jeden z těchto požadavků nebude odmítnut. To znamená, že naši uživatelé si ani nevšimnou aktualizací verzí v reálném čase. Pokud bude aktualizace neúspěšná, práce bude pokračovat na staré verzi, a pokud bude úspěšná – uživatelé přejdou na novou verzi.
Existuje pouze jedna věc, která může vést k neúspěchu – pokud health check proběhl úspěšně a aplikace selhala, jakmile obdržela pracovní zátěž, tedy kolaps nastane až po dokončení nasazení. V takovém případě se budete muset ručně vrátit na starou verzi. Takže jsme se podívali, jak používat Kubernetes s určenými open-source nástroji. Proces nasazení bude mnohem jednodušší, pokud tyto nástroje začleníte do Build/Deploy pipelines. Přitom k zahájení nasazení můžete použít jak uživatelské rozhraní, tak plně automatizovat tento proces pomocí například commit to master.
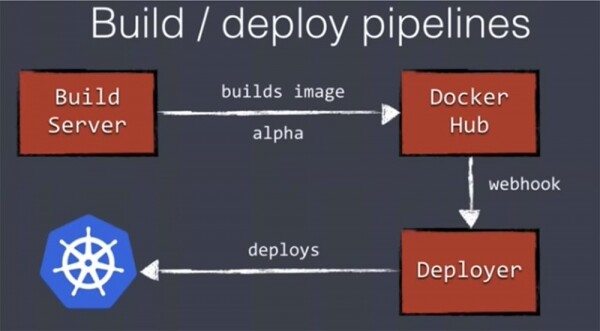
Náš build server vytvoří Docker image, vloží ho do Docker Hubu nebo jiného registru, který používáte. Docker Hub podporuje webhook, takže můžeme spustit vzdálené nasazení prostřednictvím Deployer, jak bylo uvedeno výše. Tímto způsobem lze plně automatizovat nasazení aplikace do potenciálního produkčního prostředí.
Přejdeme k dalšímu tématu – škálování Kubernetes кластерu. Ráda bych poznamenala, že příkaz kubectl je příkaz pro škálování. Pomocí něj můžeme snadno zvýšit počet replik v našem existujícím klastru. V praxi však obvykle chceme zvyšovat počet nikoli podů, ale nodů.
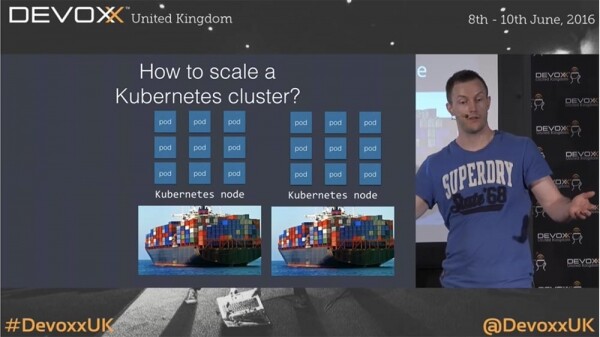
Během pracovní doby může být potřeba zvýšení, zatímco v noci, pro snížení nákladů na služby Amazon, snížení počtu spuštěných instancí aplikace. To neznamená, že bude stačit škálovat pouze počet podů, protože i když bude jeden z nodů nečinný, stále za něj budete muset platit Amazonu. To znamená, že kromě škálování podů bude třeba také škálovat počet používaných strojů.
To může způsobit potíže, protože bez ohledu na to, zda používáme Amazon nebo jinou cloudovou službu, Kubernetes nic neví o počtu používaných strojů. Postrádá nástroj pro škálování systému na úrovni nodů.
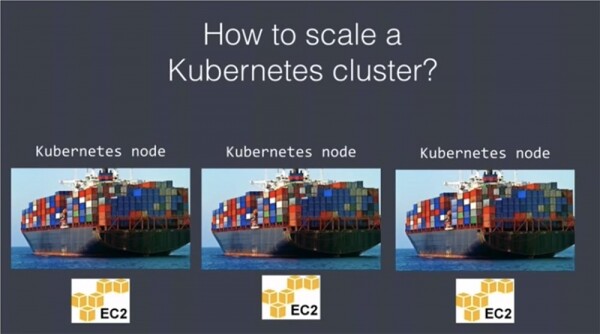
Takže se budeme muset postarat jak o nody, tak o pody. Nové nody můžeme snadno škálovat pomocí AWS API a skupiny strojů pro škálování pro nastavení počtu pracovních uzlů Kubernetes. Můžeme také použít cloud-init nebo podobný skript k registraci nodů v klastru Kubernetes.
Nový server se spouští ve skupině pro škálování, inicializuje se jako uzel, registruje se v hlavním registru a začíná pracovat. Po tomto kroku je možné zvýšit počet replik, které využijí vzniklé uzly. Zmenšení škály vyžaduje větší úsilí, protože je třeba zajistit, že tento krok neohrozí již běžící aplikace po vypnutí "nepotřebných" serverů. Aby se tomuto scénáři předešlo, je nutné přivést uzly do stavu "neschedulable". To znamená, že výchozí plánovač při plánování podů DaemonSet tyto uzly ignoruje. Plánovač nic na těchto serverech neodstraní, ale nebude tam ani spouštět žádné nové kontejnery. Dalším krokem je vyprázdnění uzlu drain node, což znamená přesun pracovních podů na jiný server, nebo na jiné uzly, které mají dostatečnou kapacitu. Poté, co se zajistíte, že na těchto uzlech již žádné kontejnery nejsou, můžete je odstranit z Kubernetes. Po tomto odstranění pro Kubernetes jednoduše přestanou existovat. Poté je třeba použít AWS API k deaktivaci nepotřebných uzlů nebo serverů.
Můžete použít Amdatu Scalerd — další open-source nástroj pro škálování, který je podobný AWS API. Poskytuje CLI pro přidání nebo odstranění uzlů ve clusteru. Jeho zajímavou vlastností je možnost nastavit plánovač pomocí následujícího json souboru.
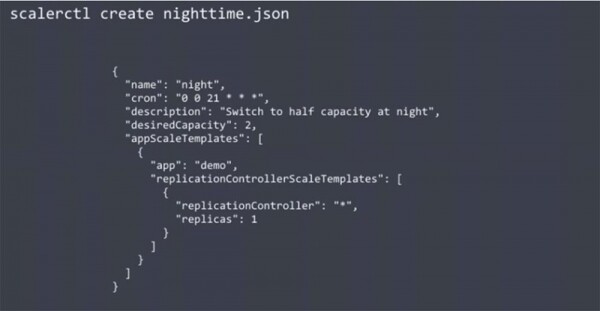
Zobrazený kód napůl snižuje kapacitu clusteru během nočního období. Je v něm nastavena jak stávající, tak požadovaná kapacita cloudu Amazon. Použití tohoto plánovače automaticky sníží počet uzlů v noci a zvýší je ráno, což umožní ušetřit náklady na používání uzlů takové cloudové služby, jako je Amazon. Tato funkce není integrována v Kubernetes, ale použití Scalerd vám umožní škálovat tuto platformu jakkoliv.
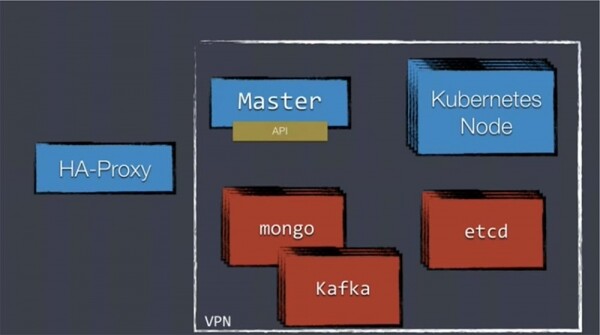
Chtěl bych vás upozornit na to, že mi mnozí lidé říkají: „To vše je v pořádku, ale co má databáze, která obvykle zůstává v statickém stavu?“ Jak lze něco podobného spustit v tak dynamickém prostředí, jako je Kubernetes? Podle mého názoru byste to dělat neměli, neměli byste se snažit organizovat práci datového úložiště v Kubernetes. Technicky je to možné a na internetu jsou návody na toto téma, ale značně vám to zkomplikuje život.
Ano, v Kubernetes existuje pojem trvalých úložišť a můžete se pokusit spouštět taková datová úložiště jako Mongo nebo MySQL, ale je to dost pracné. To souvisí s tím, že datová úložiště plně nepodporují interakci s dynamickým prostředím. Většina databází vyžaduje značné nastavení, včetně ručního nastavení clusteru, nemají rády automatické škálování a podobné věci.
Proto si nekomplikuje život snažením se spustit datové úložiště v Kubernetes. Organizujte jejich práci tradičním způsobem s využitím známých služeb a jednoduše poskytněte Kubernetes možnost je využívat.
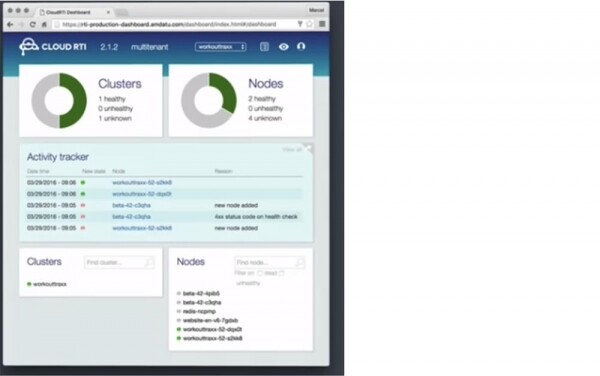
Na závěr této tématiky bych vás chtěl seznámit s platformou Cloud RTI založenou na Kubernetes, na které pracuje můj tým. Ta zajišťuje centralizovanou správu logů, monitoring aplikací a clusterů a má mnoho dalších užitečných funkcí, které se vám hodí. Využívá různé open-source nástroje, jako je Grafana pro zobrazení monitoringu.
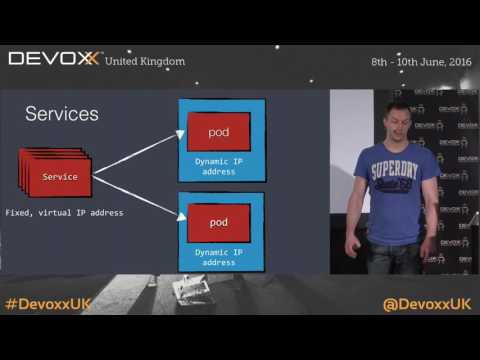
Položil se dotaz, proč používat s Kubernetes vyvažovač zátěže ha-proxy. Dobrý dotaz, protože v současnosti existují 2 úrovně vyvažování zátěže. Služby Kubernetes jsou stále na virtuálních IP adresách. Nemůžete je použít pro porty externích hostitelských strojů, protože pokud Amazon převede svůj cloudový host, adresa se změní. Proto umisťujeme ha-proxy před služby — abychom vytvořili stabilnější strukturu pro bezproblémovou interakci provozu s Kubernetes.
Další dobrá otázka – jak lze zajistit změnu schématu databáze při provádění blue/green deployment? Vzhledem k tomu, že nezáleží na tom, zda používáte Kubernetes, změna schématu databáze je složitý úkol. Musíte zajistit kompatibilitu starého a nového schématu, po čemž budete moci aktualizovat databázi a poté aktualizovat samotné aplikace. Můžete provést „horkou výměnu“ databáze, a pak aktualizovat aplikace. Známe lidi, kteří načítali zcela nový cluster databáze s novým schématem, což je možnost, pokud máte databázi bez schématu, jako je Mongo, ale v každém případě to není jednoduchý úkol. Pokud nejsou žádné další otázky, děkuji za pozornost!
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
