

Ahoj všichni! Jmenuji se Oleg Sidorenkov a pracuji ve společnosti DomClick jako vedoucí týmu infrastruktury. Už více než tři roky provozujeme "Kubík" v produkci a během této doby jsme zažili spoustu zajímavých momentů. Dnes vám povím, jak při správném přístupu můžete z "vanilkového" Kubernetes vyždímat ještě více výkonu pro váš cluster. Jdeme na to!
Jak dobře víte, Kubernetes je škálovatelný systém s otevřeným zdrojovým kódem pro orchestraci kontejnerů; tedy, nebo pět binárek, které kouzlí, spravují životní cyklus vašich mikroservis v serverovém prostředí. Kromě toho je to docela flexibilní nástroj, který můžete sestavit jako stavebnici Lego pro maximální přizpůsobení různým úlohám.
A všechno vypadá skvěle: přidávejte servery do clusteru, jako byste přihazovali dříví do ohně, a žádné starosti. Ale pokud vám záleží na ekologii, zamyslíte se: "Jak mohu udržet oheň v peci a neškodit lesu?" Jinými slovy, jak najít způsoby, jak zlepšit infrastrukturu a snížit náklady.
1. Sledujte zdroje týmů a aplikací
Jedna z nejbanálnějších, ale účinných metod je zavedení requests/limits. Rozdělte aplikace podle namespace a namespace podle vývojových týmů. Nastavte aplikacím před nasazením hodnoty pro spotřebu procesorového času, paměti a efemérního úložiště.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Zkušeností jsme dospěli k závěru, že není dobré zvyšovat požadavky nad limity více než dvakrát. Objem clusteru se počítá na základě požadavků, a pokud nastavíte aplikacím rozdíl ve zdrojích, například 5-10krát, představte si, co se stane s vaší uzlovou, když se zaplní podům a náhle dostane zátěž. Nic dobrého. Minimálně dojde k throttlingu, maximálně se rozloučíte s pracovníkem a dostanete cyklickou zátěž na ostatní uzly poté, co začnou podi migrovat.
Kromě toho, s pomocí limitranges můžete při spuštění nastavit pro kontejner hodnoty pro zdroje — minimální, maximální a výchozí:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Nezapomeňte omezit zdroje namespace, aby jeden tým nezískal všechny zdroje klastru:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Jak je vidět z popisu resourcequotas, pokud se tým ops pokusí nasadit pody, které by spotřebovaly dalších 10 cpu, plánovač to nedovolí a vydá chybu:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Pro řešení takového úkolu je možné napsat nástroj, například jako , který umí ukládat a commitovat stav zdrojů týmů.
2. Vybírejte optimální úložiště dat
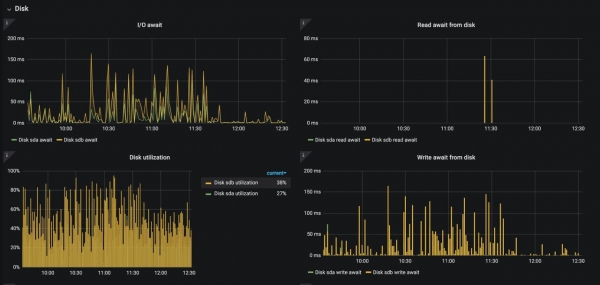
Zde bych chtěl probrat téma persistentních svazků a diskové subsystémy worker-nod Kubernetes. Doufám, že nikdo nepoužívá "Kub" na HDD v produkci, ale někdy už i běžné SSD nestačí. Narazili jsme na problém, kdy logy zaplavily disk operacemi vstupu a výstupu, a zde není mnoho možností řešení:
Použít vysoce výkonné SSD nebo přejít na NVMe (pokud sami spravujete svůj hardware).
Snižte úroveň žurnálování.
Provádějte "inteligentní" vyvažování podů, které zatěžují disk (
podAntiAffinity).
Snímek výše ukazuje, co se děje pod nginx-ingress-controller na disku, když je zapnuto žurnálování access_logs (~12 tisíc žurnálů/s.). Tento stav může samozřejmě vést k degradaci všech aplikací na této nodě.
Co se týče PV, bohužel jsem nevyzkoušel všechny Trvalé svazky. Využijte nejlepší možnost, která vám vyhovuje. Historicky jsme měli situaci, že malá část služeb potřebuje RWX svazky, a už dávno jsme začali používat NFS úložiště. Bylo to levné a... postačovalo to. Samozřejmě, že jsme si jím prošli horšími časy — ale naučili jsme se ho ladit, a už nás to netrápí. A pokud je to možné, přejděte na objektové úložiště S3.
3. Sbírejte optimalizované obrazy
Nejlépe je používat obrazy optimalizované pro kontejnery, aby je Kubernetes mohl rychleji načítat a efektivněji provádět.
Optimalizace znamená, že obrazy:
obsahují pouze jednu aplikaci nebo vykonávají pouze jednu funkci;
jsou malé velikosti, protože velké obrazy se obtížněji přenášejí v síti;
mají koncové body pro kontrolu provozuschopnosti a připravenosti, pomocí kterých může Kubernetes podniknout nějaké kroky v případě výpadků;
používají operační systémy příznivé pro kontejnery (jako Alpine nebo CoreOS), které jsou odolnější vůči chybám konfigurace;
používají vícestupňové sestavení, abyste mohli nasazovat pouze zkompilované aplikace, nikoli související zdrojové kódy.
Existuje mnoho nástrojů a služeb, které umožňují kontrolovat a optimalizovat obrazy za běhu. Je důležité je vždy udržovat aktuální a zabezpečené. Nakonec získáte:
Snížení síťové zátěže na celý klastr.
Zkrácení času spuštění kontejneru.
Menší objem vašeho Docker registru.
4. Používejte DNS cache
Pokud mluvíme o vysokých zátěžích, bez ladění DNS systému klastru se žije docela špatně. Dávno tomu, kdy vývojáři Kubernetes podporovali své řešení kube-dns. To jsme implementovali i my, ale tento software se moc neladil a nedával požadovaný výkon, přestože se to zdálo jako jednoduchý úkol. Potom se objevil coredns, na který jsme přešli a už jsme se nemuseli trápit, později se stal výchozím DNS službou v K8s. V určitém okamžiku jsme dosáhli 40 tisíc rps k DNS systému, a tohle řešení také přestalo stačit. Naštěstí vyšel Nodelocaldns, také známý jako node local cache, také .
Proč to používáme? V jádře Linuxu je chyba, která při vícečetném přístupu přes conntrack NAT pomocí UDP způsobuje závodní podmínku při zápisu do tabulek conntrack, což vede ke ztrátě části provozu přes NAT (každý požadavek přes Service je NAT). Nodelocaldns tento problém řeší tím, že se zbavuje NAT a upgradováním připojení na TCP k upstreamovým DNS a také místním kešováním DNS dotazů k upstreamům (včetně krátkého 5sekundového negativního keše).
5. Automaticky škálujte pody horizontálně a vertikálně
Můžete si být jisti, že všechny vaše mikroservisy jsou připraveny na růst zátěže dvakrát až třikrát? Jak správně přidělovat zdroje svým aplikacím? Mít naživu pár podů nad pracovní zátěž může být nadbytečné, zatímco mít je na hranici — riskujete výpadek kvůli náhlému nárůstu provozu na službu. Zlatou střední cestu pomáhají najít služby jako a .
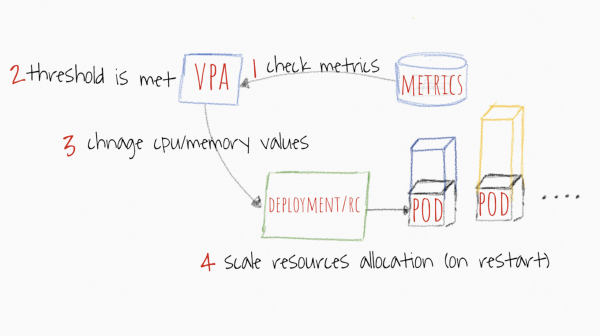
VPA umožňuje automaticky zvyšovat requests/limits vašich kontejnerů v podu na základě skutečné spotřeby. Jak může být užitečný? Pokud máte pody, které není možné z nějakého důvodu horizontálně škálovat (což není zcela spolehlivé), můžete zkusit svěřit změnu jeho zdrojů VPA. Jeho kouzlo spočívá v systému doporučení na základě historických a aktuálních dat z metric-server, takže pokud nechcete automaticky měnit requests/limits, můžete jen sledovat doporučené zdroje pro vaše kontejnery a optimalizovat nastavení pro úsporu CPU a paměti v klastru.
 Obrázek je převzat z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Plánovač v Kubernetes vždy vychází z requests. Jakoukoli hodnotu tam zadáte, plánovač bude hledat vhodný uzel na jejím základě. Hodnoty limits jsou potřebné kubeletovi, aby chápal, kdy omezit nebo zabít pod. A protože jediným důležitým parametrem je hodnota requests, VPA s tím pracuje. Každý čas, když určujete vertikální škálování aplikace, definujete, jaké by měly být requests. A co pak bude s limits? Tento parametr bude také proporcionálně upraven.
Například, zde jsou běžná nastavení podu:
zdroje:
   požadavky:
     paměť: 250Mi
     cpu: 200m
   limity:
     paměť: 500Mi
     cpu: 350m
Systém doporučení určuje, že vaše aplikace potřebuje k normálnímu fungování 300m CPU a 500Mi. Obdržíte takto nastavené hodnoty:
zdroje:
   požadavky:
     paměť: 500Mi
     cpu: 300m
   limity:
     paměť: 1000Mi
     cpu: 525m
Jak bylo zmíněno výše, jedná se o proporciální škálování podle poměru requests/limits v manifestu:
CPU: 200m → 300m: poměr 1:1.75;
Paměť: 250Mi → 500Mi: poměr 1:2.
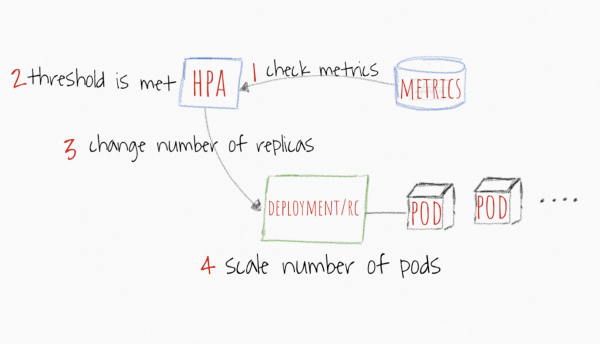
Co se týče HPA, zde je mechanismus práce transparentnější. Stanovují se prahové hodnoty metrik, například CPU a paměti, a pokud průměrná hodnota všech replik přesáhne prahovou hodnotu, aplikace se škáluje o +1 pod, dokud hodnota neklesne pod prahovou hodnotu nebo dokud není dosaženo maximálního počtu replik.
 Obrázek je převzat z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Kromě běžných metrik, jako je CPU a paměť, můžete nastavit prahy pro své vlastní metriky z Prometheus a pracovat s nimi, pokud považujete to za nejpřesnější určení, kdy byste měli škálovat svou aplikaci. Jakmile se aplikace stabilizuje pod stanovenou hranicí metriky, HPA začne snižovat pods až na minimální počet replik nebo do stavu, kdy zatížení splňuje stanovený práh.
6. Nezapomínejte na Node Affinity a Pod Affinity
Ne všechny uzly běží na stejném hardwaru, ne všechny pody potřebují provádět aplikace, které vyžadují intenzivní výpočty. Kubernetes umožňuje definovat specializaci uzlů a podů pomocí Node Affinity a Pod Affinity.
Pokud máte uzly vhodné pro operace s intenzivními výpočty, je pro maximální efektivitu lepší přiřadit aplikace k odpovídajícím uzlům. K tomu použijte nodeSelector s označením uzlu.
Představte si, že máte dva uzly: jeden s CPUType=HIGHFREQ a velkým počtem rychlých jader, druhý s MemoryType=HIGHMEMORY velkým množstvím paměti a vyšší propustností. Nejjednodušší je přiřadit nasazení podu uzlu HIGHFREQ, přidáním do sekce spec takového výběru:
…
nodeSelector:
	CPUType: HIGHFREQ
Nákladnější a specifický způsob, jak to provést, je použít nodeAffinity v poli affinity sekci spec. Existují dvě možnosti:
requiredDuringSchedulingIgnoredDuringExecution: pevné nastavení (plánovač nasadí pody pouze na konkrétních uzlech (a nikde jinde));preferredDuringSchedulingIgnoredDuringExecution: jemná konfigurace (plánovač se pokusí nasadit na konkrétních uzlech, a pokud to nebude možné, pokusí se nasadit na dalším dostupném uzlu).
Můžete nastavit určitý syntax pro správu štítků uzlů, například, In, NotIn, Exists, DoesNotExist, Gt nebo Lt. Mějte však na paměti, že složité metody v dlouhých seznamech štítků zpomalí rozhodování v kritických situacích. Jinými slovy, nekomplikujte to.
Jak bylo zmíněno výše, Kubernetes umožňuje nastavit vazbu aktuálních podů. To znamená, že můžete zajistit, aby určité pody pracovaly spolu s jinými pody ve stejné zóně dostupnosti (platí pro cloudy) nebo uzlech.
V podAffinity pole affinity sekci spec jsou dostupná stejná pole jako v případě nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution a preferredDuringSchedulingIgnoredDuringExecution. Jediný rozdíl spočívá v tom, že matchExpressions připojí pody k uzlu, na kterém již běží pod s takovým štítkem.
Kubernetes také nabízí pole podAntiAffinity, které naopak nepřipojuje pod k uzlu s určitými pody.
Pokud jde o výrazy, nodeAffinity můžete dát stejnou radu: snažte se udržet jednoduchost a logiku pravidel, není potřeba se pokoušet přeplnit specifikaci podů složitým souborem pravidel. Je velmi snadné vytvořit pravidlo, které nebude splňovat podmínky clusteru, čímž způsobíte zbytečné zatížení plánovače a snížíte celkový výkon.
7. Taints & Tolerations
Existuje ještě jeden způsob, jak řídit plánovač. Pokud máte velký cluster se stovkami uzlů a tisíci mikroslužeb, je velmi obtížné zabránit určitým podům umisťovat se na určité uzly.
V tom pomáhá mechanismus taints — zakazovacích pravidel. Například v určitých scénářích můžete zabránit některým uzlům spouštět na sobě pody. Pro použití taint na konkrétním uzlu je třeba použít možnost taint v kubectl. Uveďte klíč a hodnotu a poté taint jako NoSchedule nebo NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleTaké stojí za zmínku, že mechanismus taint podporuje tři hlavní efekty: NoSchedule, NoExecute a PreferNoSchedule.
NoScheduleznamená, že pokud v specifikaci podu nebude odpovídající záznamtolerations, nebude možné jej nasadit na uzlu (v tomto příkladunode10).PreferNoSchedule— zjednodušená verzeNoSchedule. V tomto případě se plánovač pokusí nerozdělovat pody, které nemají odpovídající záznamtolerationsna uzlu, ale to není přísné omezení. Pokud v clusteru nebudou k dispozici prostředky, začnou se pody nasazovat na tento uzel.NoExecute— tento efekt spustí okamžitou evakuaci podů, které nemají odpovídající záznamtolerations.
Zajímavé je, že takové chování lze zrušit pomocí mechanismu tolerancí. To je užitečné, když existuje „zakázaný“ uzel a potřebujete tam umístit pouze infrastrukturní služby. Jak to udělat? Povolit pouze ty pody, pro které existuje odpovídající tolerování.
Takhle bude vypadat specifikace podu:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
To neznamená, že při dalším redeployi pod skončí právě na tomto uzlu, to není mechanismus Node Affinity a nodeSelector. Ale kombinováním několika funkcí můžete dosáhnout velmi flexibilního nastavení plánovače.
8. Nastavte prioritu nasazování podů
To, že jste nastavili vazbu podů k uzlům, neznamená, že všechny pody by měly být zpracovávány se stejnou prioritou. Například můžete chtít nasadit některé pody dříve než ostatní.
Kubernetes nabízí různé způsoby nastavení priorit podů (Pod Priority and Preemption). Nastavení se skládá z několika částí: objektu PriorityClass a popisu pole priorityClassName ve specifikaci podu. Podívejme se na příklad:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Tato priorita by měla být používána pouze pro velmi důležité pody"
Vytváříme PriorityClass, dáváme mu název, popis a hodnotu. Čím vyšší value, tím vyšší priorita. Hodnota může být libovolné 32-bitové celé číslo, menší nebo rovno 1 000 000 000. Vyšší hodnoty jsou rezervovány pro kriticky důležité systémové pody, které obvykle nelze vytěsnit. Vytěsnění se bude konat pouze pokud vysokopríjmovému podu nebude možné se rozvinout, pak část podů z určitého uzlu bude evakuována. Pokud je tento mechanismus pro vás příliš přísný, můžete přidat volbu preemptionPolicy: Never, a pak nedojde k vytěsnění, pod bude stát první v řadě a čekat, až plánovač najde pro něj volné prostředky.
Dále vytváříme pod, ve kterém uvádíme název priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Můžete vytvořit libovolný počet prioritních tříd, i když se doporučuje to přehánět (říkám, omezit se na nízkou, střední a vysokou prioritu).
Tímto způsobem budete moci v případě potřeby zvýšit efektivitu nasazení kritických služeb, jako jsou nginx-ingress-controller, coredns atd.
9. Optimalizujte klastr ETCD
ETCD může být nazýván mozkem celého klastru. Je velmi důležité udržovat tuto databázi na vysoké úrovni, protože právě na ní závisí rychlost operací v „Kubu“. Dostatečně standardním a zároveň dobrým řešením je udržovat klastr ETCD na hlavních uzlech, abyste měli minimální zpoždění k kube-apiserver. Pokud to není možné, umístěte ETCD co nejblíže, s dobrou šířkou pásma mezi účastníky. Také věnujte pozornost tomu, kolik uzlů ETCD může vypadnout bez poškození klastru.
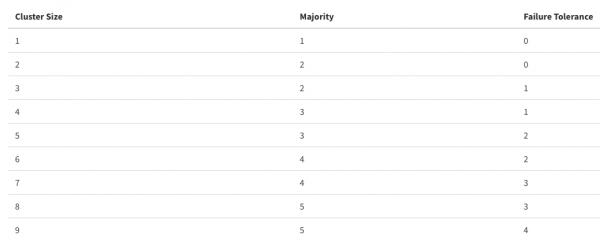
Mějte na paměti, že nadměrné zvyšování počtu účastníků v klastru může zvýšit odolnost vůči poruchám na úkor výkonu, všechno musí být v umírněnosti.
Pokud jde o nastavení služby, doporučení je málo:
Mít dobrý hardware na základě velikosti klastru (můžete si přečíst ).
Upravit několik parametrů, pokud jste rozprostřeli klastr mezi několik datových center nebo vaše síť a disky zanechávají hodně přání (můžete si přečíst ).
Závěr
V tomto článku jsou popsány body, kterých se naše tým snaží držet. Není to krok za krokem popis činností, ale možnosti, které mohou být užitečné pro optimalizaci nákladů na klastr. Je jasné, že každý klastr je jedinečný a řešení pro nastavení se mohou výrazně lišit, a proto by bylo zajímavé získat od vás zpětnou vazbu: jak sledujete svůj klastr Kubernetes, čím zlepšujete jeho výkon. Podělte se o své zkušenosti v komentářích, bude zajímavé je poznat.
Zdroj: habr.com
