

Ahoj všichni! Máme skvělé zprávy, v červnu OTUS znovu spouští kurz , a proto s vámi tradičně sdílíme užitečný materiál.
Pokud jste se setkali s těmito mikroservisy bez jakéhokoli kontextu, může se vám zdát trochu podivné. Rozdělení aplikace na fragmenty navzájem spojené sítí vždy znamená přidání složitých režimů odolnosti vůči výpadkům do výsledného distribuovaného systému.
I když tento přístup zahrnuje rozdělení na mnoho nezávislých služeb, konečným cílem je mnohem více než jen fungování těchto služeb na různých strojích. Jde o interakci s okolním světem, který je sám o sobě také distribuovaný. Ne v technickém smyslu, ale spíše jako ekosystém skládající se z mnoha lidí, týmů, programů, a každá z těchto částí by měla vykonávat svou práci.
Společnosti, například, představují soubor distribuovaných systémů, které dohromady přispívají k dosažení určitého cíle. Tento fakt jsme ignorovali po desetiletí, snažíc se dosáhnout integrace, posíláním souborů přes FTP nebo používáním nástrojů pro podnikové integrace, přičemž jsme se soustředili na své osobní izolované cíle. Ale s příchodem služeb se všechno změnilo. Služby nám pomohly nahlédnout za horizont a vidět svět vzájemně závislých programů, které spolupracují. Abychom však uspěli, musíme si uvědomit a navrhnout dva zásadně odlišné světy: vnější svět, kde žijeme v ekosystému mnoha dalších služeb, a náš osobní, vnitřní svět, kde vládneme osamoceně.
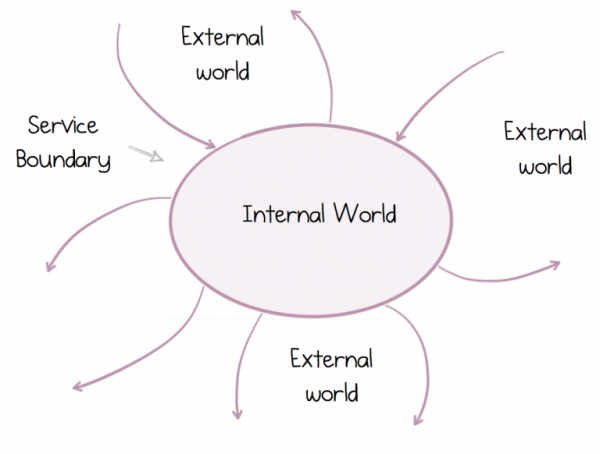
Takový distribuovaný svět se liší od toho, ve kterém jsme vyrostli a na který jsme zvyklí. Principy konstrukce tradiční monolitické architektury nevydrží žádnou kritiku. Proto je správné pochopení takových systémů něčím víc než jen vytvoření skvělého schématu na bílé tabuli nebo úžasného důkazu konceptu. Jde o to, aby takový systém úspěšně fungoval po dlouhou dobu. Naštěstí služby existují již docela dlouho, i když vypadají různě. jsou stále relevantní, i když jsou obohaceny o Docker, Kubernetes a lehce umouněné hipsterskými vousy.
Dnes se tedy podíváme na to, jak se pravidla změnila, proč musíme přehodnotit náš přístup k službám a datům, která si vzájemně předávají, a proč budeme potřebovat zcela jinou sadu nástrojů.
Inkapsulace vám nebude vždy spojencem.
Mikroslužby mohou fungovat nezávisle jedna na druhé. Tento aspekt jim dává největší hodnotu. Tento vlastnost také umožňuje službám škálovat a růst. Ne tolik ve smyslu škálování na kvadriliony uživatelů nebo petabajty dat (i když i zde mohou pomoci), ale ve smyslu škálování z pohledu lidí, jelikož týmy a organizace neustále rostou.
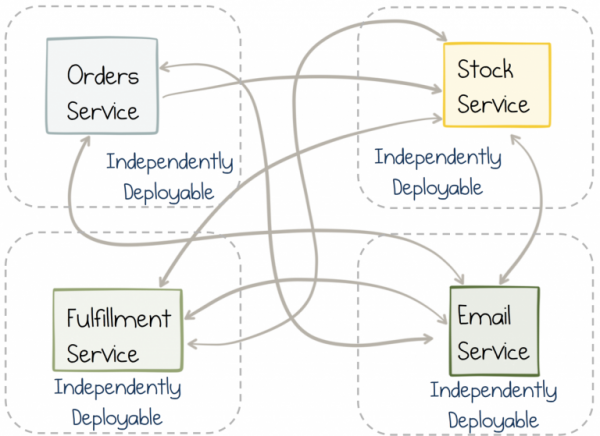
Nezávislost je však dvousečná zbraň. To znamená, že služba sama o sobě může fungovat snadno a uvolněně. Ale pokud je uvnitř služby implementována funkce, která vyžaduje zapojení jiné služby, nakonec musíme provést změny v obou službách téměř současně. V monolitu je to snadné; prostě provedete změnu a nasadíte ji. Ale v případě synchronizace nezávislých služeb nastává více problémů. Koordinace mezi týmy a cykly vydání narušuje flexibilitu.
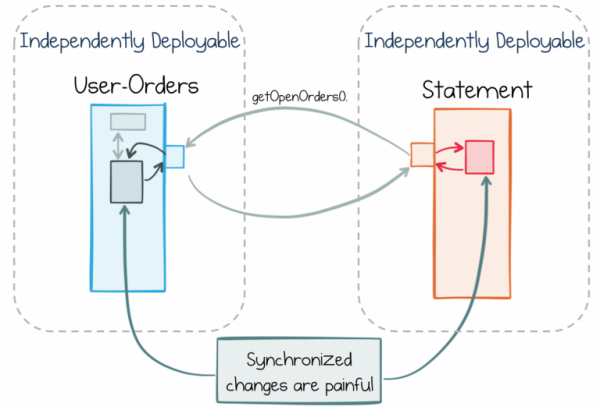
V rámci standardního přístupu se vyhýbáme nepříjemným průnikovým změnám tím, že jasně oddělujeme funkce mezi službami. Služba pro jednotný vstup do systému může být dobrým příkladem. Má jasně definovanou roli, která ji odlišuje od ostatních služeb. Toto jasné rozdělení znamená, že ve světě rychle se měnících požadavků na ostatní služby, služba pro jednotný vstup do systému se pravděpodobně nebude měnit. Existuje v rámci striktně omezeného kontextu.
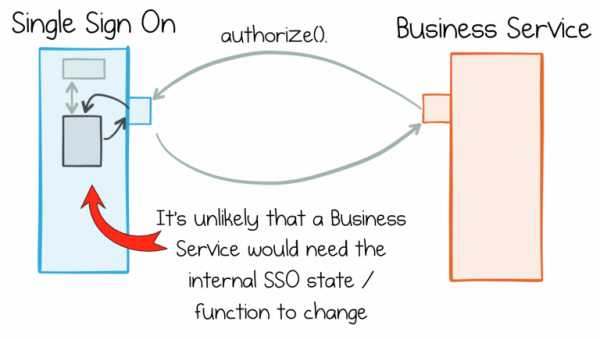
Problém je v tom, že v reálném světě obchodní služby nemohou neustále udržovat stejné čisté oddělení rolí. Například uvedené obchodní služby většinou pracují s daty přicházejícími od jiných podobných služeb. Pokud se zabýváte online maloobchodem, pak zpracování toku objednávek, katalogu produktů nebo informací o uživatelích se stane požadavkem pro mnoho vašich služeb. Každá z těchto služeb potřebuje přístup k těmto datům k tomu, aby mohla fungovat.
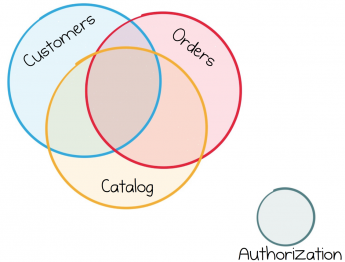
Většina obchodních služeb používá stejný datový tok, a proto se jejich činnost neustále proplétá.
Tak jsme se dostali k důležitému bodu, o kterém je třeba mluvit. Zatímco služby fungují dobře pro infrastrukturní komponenty, které pracují spíše odděleně, většina obchodních služeb se ukazuje být mnohem úžeji propojena.
Dichotomie dat
Přístupy zaměřené na služby možná už existují, ale stále je v nich málo informací o tom, jak vyměňovat velké objemy dat mezi službami.
Hlavní problém spočívá v tom, že data a služby jsou nerozlučné. Na jedné straně inkapsulace nás vyzývá, abychom skrývali data, aby se služby mohly oddělit a usnadnit jejich růst a budoucí změny. Na druhé straně potřebujeme mít možnost svobodně sdílet a spravovat společná data, stejně jako jakákoli jiná data. Jde o to mít možnost začít pracovat okamžitě, stejně volně, jako v jakémkoli jiném informačním systému.
Avšak informační systémy mají málo společného s inkapsulací. Ve skutečnosti je to dokonce naopak. Databáze dělají vše, co mohou, aby poskytly přístup k uchovávaným datům. Dodávají se s mocným deklarativním rozhraním, které umožňuje upravovat data podle potřeby. Tato funkce je důležitá ve fázi předběžného výzkumu, ale ne pro řízení rostoucí složitosti neustále se vyvíjejícího servisu.
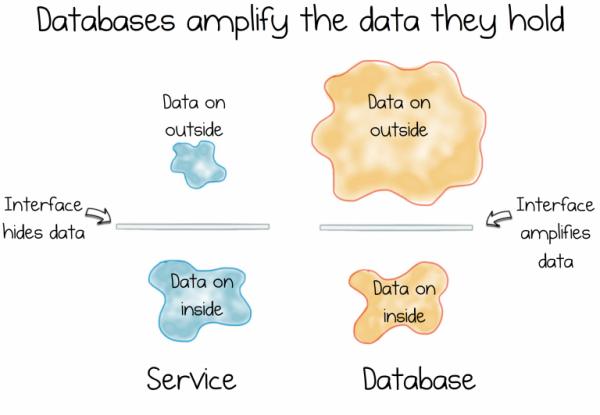
A tady vzniká dilema. Rozpor. Dichotomie. Vždyť informační systémy se týkají poskytování dat, zatímco služby se týkají skrývání.
Tyto dvě síly jsou zásadní. Leží v základech většiny naší práce, neustále bojující o převahu v systémech, které vytváříme.
Jak systémy služeb rostou a vyvíjejí se, vidíme různé projevy důsledků datové dichotomie. Buď se rozhraní služby rozroste a začne vypadat jako velmi podivná domácí databáze, nebo zažijeme zklamání a implementujeme nějaký způsob, jak extrahovat nebo hromadně přesouvat celé datové sady mezi službami.
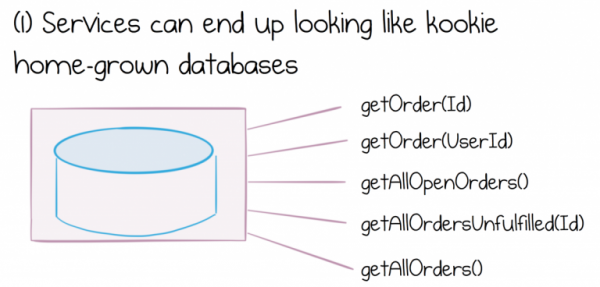
Na druhou stranu vytvoření něčeho, co vypadá jako podivná domácí databáze, přinese celou řadu problémů. Nebudeme se zabývat podrobnostmi nebezpečnosti shared database, prostě řekneme, že to představuje značné nákladné inženýrské a operační pro společnost, která se ji snaží použít.
Hůře to bude s objemy dat, které zhoršují problémy s hranicemi služeb. Čím více společných dat se nachází uvnitř služby, tím složitější se rozhraní stane a tím těžší bude spojit datové sady pocházející z různých služeb.
Alternativní přístup k extrakci a přesouvání celých datových sad má také své problémy. Běžný přístup k této otázce vypadá jako jednoduchá extrakce a skladování datové sady jako celku, a poté její lokální uchování v každé službě-využivateli.
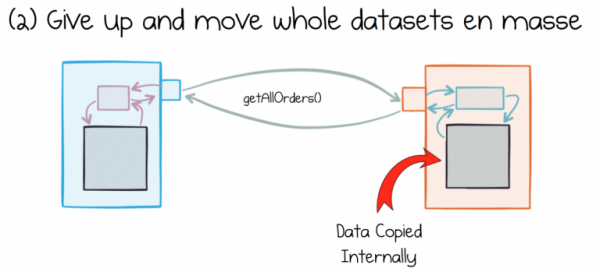
Problém spočívá v tom, že různé služby interpretují data, která konzumují, různými způsoby. Tato data jsou vždy po ruce. Mění se a zpracovávají lokálně. Poměrně brzy přestanou mít cokoliv společného s daty ve zdroji.
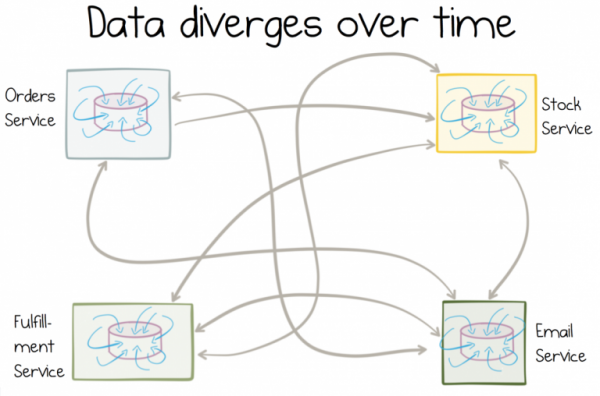
Čím více jsou kopie mutabilní, tím více se data budou lišit v čase.
Co je ještě horší, taková data se těžko opravují zpětně ( tu skutečně může přijít na pomoc). Ve skutečnosti některé z těžko řešitelných technologických problémů, se kterými se podniky potýkají, vznikají z heterogenních dat, která se množí z aplikace na aplikaci.
Abychom našli řešení tohoto problému s běžnými daty, musíme myslet jinak. Musí se stát objekty první třídy v architekturách, které budujeme. nazývá taková data „externími“, a to je velmi důležitá vlastnost. Potřebujeme enkapsulaci, abychom nezveřejnili vnitřní strukturu služby, ale musíme usnadnit službám přístup ke společným datům, aby správně vykonávaly svou práci.
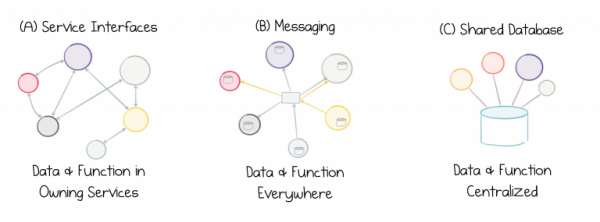
Problém spočívá v tom, že žádný z přístupů dnes již není aktuální, protože ani rozhraní služeb, ani výměna zpráv, ani Sdílená databáze nenabízí dobré řešení pro práci s externími daty. Rozhraní služeb se špatně hodí pro výměnu dat v jakémkoli měřítku. Výměna zpráv přesouvá data, ale neuchovává jejich historii, takže s časem se data poškozují. Sdílené databáze jsou příliš silně zaměřeny na jedno místo, což brání pokroku. Nevyhnutelně se zasekneme v cyklu neplatnosti dat:
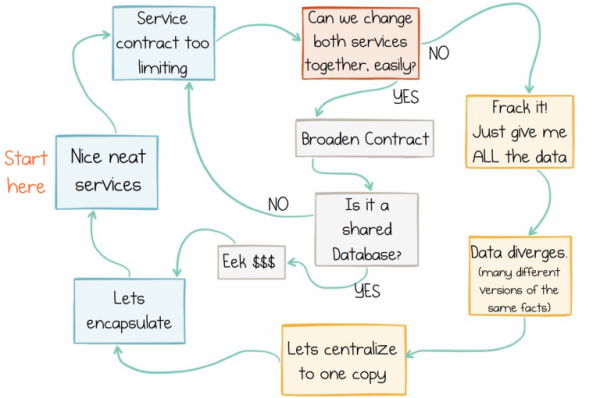
cyklus neplatnosti dat
toky: decentralizovaný přístup k datům a službám
Ideálně bychom měli změnit přístup k tomu, jak služby pracují se společnými daty. V současné době jakýkoli přístup naráží na výše zmíněnou dichotomii, protože neexistuje žádný kouzelný prášek, kterým bychom ji mohli štědře posypat a nechat zmizet. Můžeme však problém přeformulovat a dospět k kompromisu.
Tento kompromis předpokládá určitou míru centralizace. Můžeme využít mechanismu distribuovaných logů, protože poskytuje spolehlivé a škálovatelné toky. Nyní je potřeba, aby se služby mohly připojit a pracovat s těmito společnými toky, přičemž chceme vyhnout složitým centralizovaným službám (God Service), které tuto zpracování vykonávají. Nejlepším řešením je tedy zabudovat streamovací zpracování do každé spotřebitelské služby. Takto budou služby moci kombinovat soubory dat z různých zdrojů a pracovat s nimi tak, jak potřebují.
Jedním ze způsobů, jak dosáhnout takového přístupu, je využití streamovací platformy. Existuje mnoho možností, ale dnes se zaměříme právě na Kafka, protože její zpracování Stateful Stream Processing umožňuje efektivně řešit předložený problém.
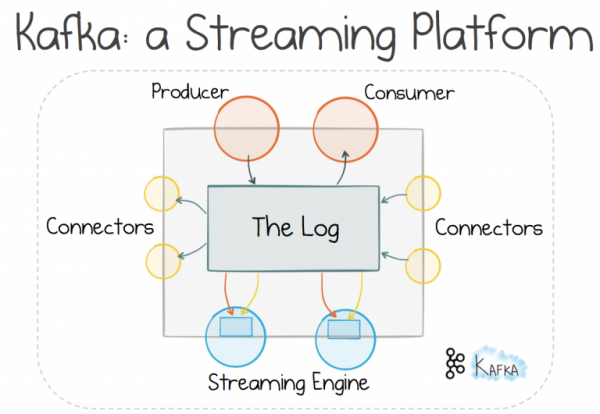
Použití mechanismu distribuovaného logování nám umožňuje jít po vyšlapané cestě a používat výměnu zpráv, abychom pracovali s . Tento přístup se považuje za lepší pro škálování a odlučování než mechanismus "dotaz-odpověď", protože předává kontrolu nad tokem příjemci, nikoli odesílateli. Ale za vše se v životě platí, a v tomto případě budete potřebovat brokera. Nicméně pro velké systémy toto vyvážení stojí za to (což se nedá říct o vašich průměrných webových aplikacích).
Pokud za distribuované logování odpovídá broker, a ne tradiční systém výměny zpráv, můžete využít dodatečné funkce. Transport lze lineárně škálovat téměř stejně dobře jako distribuovaný souborový systém. Data mohou být uložena v logech dostatečně dlouho, takže získáváme nejen výměnu zpráv, ale i úložiště informací. Škálovatelné úložiště bez obav z rozmaru sdíleného stavu.
Pak lze použít mechanismus zpracování streamů se zachováním stavu (stateful stream processing) pro přidání deklarativních nástrojů databáze do služeb spotřebitelů. Toto je velmi důležitá myšlenka. Dokud jsou data uchovávána ve sdílených streamech, ke kterým mají přístup všechny služby, spojení a zpracování, které služba provádí, jsou soukromé. Jsou izolovány v rámci přesně vymezeného kontextu.
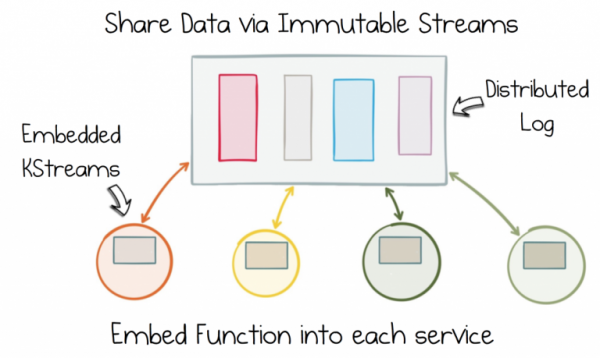
Zbavte se dichotomie dat tím, že oddělíte neměnný stream stavů. Poté přidejte tuto funkci do každé služby pomocí zpracování streamů se zachováním stavu.
Takže pokud vaše služba musí pracovat s objednávkami, katalogem produktů, skladem, má plný přístup: jen vy rozhodujete, které data spojit, kde je zpracovávat a jak se s časem mění. Přestože jsou data sdílená, práce s nimi je zcela decentralizovaná. Probíhá uvnitř každé služby, v světě, kde vše běží podle vašich pravidel.
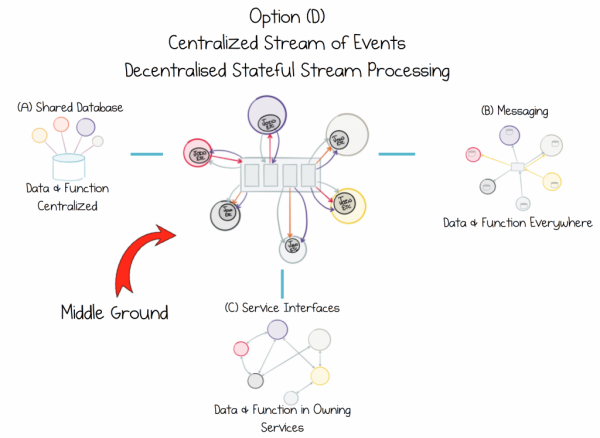
Sdílejte data tak, aby jejich integrita nebyla narušena. Integrování funkce, nikoli zdroje, v každé službě, která ji potřebuje.
Někdy se stává, že je potřeba hromadně přesunout data. Někdy služba vyžaduje lokální historickou sadu dat v vybraném databázovém motoru. Klíčové je, že lze zaručit, že v případě potřeby může být kopie obnovena ze zdroje pomocí dotazu na mechanismus distribuovaného logování. Konektory v Kafka si s tímto úkolem výborně poradí.
Tento přístup má tedy několik výhod:
- Data jsou používána jako obecné toky, které mohou být dlouho uchovávány v logách, a samotný mechanismus práce s obecnými daty je integrován v každém jednotlivém kontextu, což umožňuje službám fungovat snadno a rychle. Tímto způsobem lze vyvážit dichotomii dat.
- Data pocházející z různých služeb se mohou snadno spojovat do sad. Tak se zjednodušuje interakce s obecnými daty a mizí potřeba udržovat lokální sady dat v databázi.
- Stateful Stream Processing pouze cacheuje data, zatímco zdrojem pravdy zůstávají obecné logy, takže problém poškození dat v průběhu času není tak akutní.
- V zásadě jsou služby řízeny daty, což znamená, že i přes neustálý nárůst objemu dat mohou služby stále rychle reagovat na obchodní události.
- Problémy se škálovatelností spadají na brokery, nikoli na služby. Tím se výrazně snižuje složitost psaní služeb, protože není třeba přemýšlet o škálovatelnosti.
- Přidání nových služeb nevyžaduje změnu starých, což usnadňuje připojení nových služeb.
Jak vidíte, je to víc než jen REST. Dostali jsme sadu nástrojů, která umožňuje decentralizovanou práci s obecnými daty.
V dnešním článku byly odhaleny daleko ne všechny aspekty. Ještě se musíme rozhodnout, jak vyvážit mezi paradigmatem 'dotaz-odpověď' a událostně orientovaným paradigmatem. Ale s tím se vypořádáme příště. Existují témata, se kterými se musíme lépe seznámit, například, co je na Stateful Stream Processing tak dobrého. O tom budeme mluvit ve třetím článku. A existují také další mocné konstrukce, které můžeme využít, pokud se k nim uchýlíme, například, . S jej pomocí se mění pravidla hry pro distribuované obchodní systémy, protože tato konstrukce poskytuje transakční záruky pro ve škálovatelné podobě. O tom bude řeč v čtvrtém článku. A nakonec se musíme projít detaily implementace těchto principů.
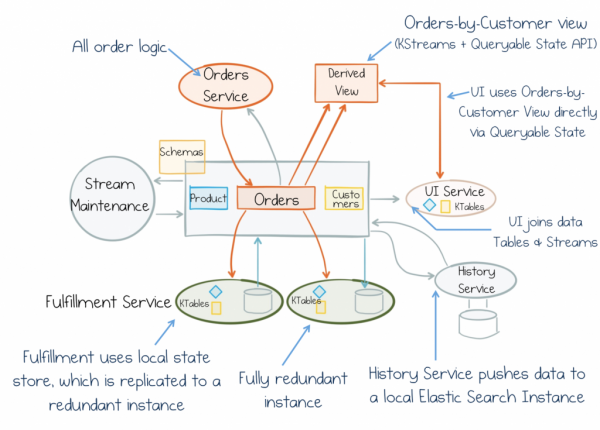
Ale zatím si jen zapamatujte následující: dichotomie dat je ta síla, se kterou se setkáváme při vytváření obchodních služeb. A měli bychom na to myslet. Zaměření spočívá v tom, převrátit všechny hodnoty na hlavu a začít počítat sdílená data jako objekty první třídy. Stateful Stream Processing nabízí unikátní kompromis. Vyhýbá se centralizovaným „Božím komponentům“, které brzdí pokrok. Navíc zajišťuje operativnost, škálovatelnost a odolnost toků streamovaných dat a přidává je do každé služby. Díky tomu se můžeme soustředit na celkový tok myšlenek, ke kterému se může připojit každá služba a pracovat s jejími daty. Takto jsou služby lépe škálovatelné, zaměnitelné a autonomní. To znamená, že budou nejen vypadat skvěle na tabulích a při ověřování hypotéz, ale také fungovat a vyvíjet se po desetiletí.
Zdroj: habr.com
