

Vážené komunito, tento článek bude věnován efektivnímu ukládání a vydávání stovek milionů malých souborů. V této fázi představujeme konečné řešení pro souborové systémy kompatibilní s POSIX, s plnou podporou zámků, včetně clusterových, a podle všeho už i bez nucených řešení.
Proto jsem k tomuto účelu napsal svůj vlastní specializovaný server.
Během realizace této úlohy se podařilo vyřešit hlavní problém a zároveň dosáhnout úspory diskového prostoru a operační paměti, kterou neúprosně vyžadoval náš clusterový souborový systém. Takové množství souborů je zkrátka škodlivé pro jakýkoli clusterový souborový systém.
Idea je taková:
Jednoduše řečeno, skrze server se nahrávají malé soubory, ty se ukládají přímo do archivu a taktéž se z něj čtou, zatímco velké soubory se ukládají vedle. Schéma: 1 složka = 1 archiv, takže máme několik milionů archivů s malými soubory, a ne několik stovek milionů souborů. A to vše je plně realizováno, bez jakýchkoli skriptů a rozkládání souborů do tar/zip archívů.
Pokouším se to shrnout, předem se omlouvám, pokud bude příspěvek obsáhlý.
Vše začalo tím, že jsem nedokázal najít vhodný server na světě, který by mohl ukládat data získaná přes HTTP protokol přímo do archivů, aby se předešlo nedostatkům typickým pro běžné archivy a objektová úložiště. Důvodem pro hledání byl rozrostlý Origin cluster o 10 serverech, ve kterém se již nashromáždilo 250 000 000 malých souborů a trend růstu nebyl ochoten se zastavit.
Těm, kdo nemají rádi čtení článků, a drobná dokumentace je jednodušší:
a .
A docker zároveň, teď je k dispozici pouze s nginx uvnitř pro jistotu:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage \n-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzdDalší:
Pokud je souborů velmi mnoho, jsou potřebné značné zdroje, a co je nejhorší, část z nich zbytečně mizí. Například při použití clusterového souborového systému (v tomto případě MooseFS) soubor, bez ohledu na skutečnou velikost, vždy zabírá minimálně 64 KB. To znamená, že pro soubory o velikosti 3, 10 nebo 30 KB je na disku potřeba 64 KB. Pokud máme čtvrt miliardy souborů, ztrácíme 2 až 10 terabajtů. Nové soubory nelze vytvářet do nekonečna, protože v MooseFS existuje omezení: maximálně 1 miliarda při jedné replikaci každého souboru.
S růstem počtu souborů je potřeba hodně paměti RAM pro metadata. Také časté velké dumpy metadat přispívají k opotřebení SSD úložišť.
Server wZD. Uklízíme na discích.
Server je napsán v jazyce Go. Především jsem potřeboval snížit počet souborů. Jak toho dosáhnout? Archivací, ale v tomto případě bez komprese, protože moje soubory jsou pouze zkomprimované obrázky. Na pomoc přišla BoltDB, kterou bylo třeba zbavit nedostatků, což je uvedeno v dokumentaci.
Celkem místo čtvrt miliardy souborů mi zůstalo jen 10 milionů Bolt archivů. Kdybych měl možnost změnit aktuální strukturu naplňování adresářů soubory, bylo by možné ji možná zkrátit na přibližně 1 milion souborů.
Všechny malé soubory jsou baleny do Bolt archivů, které automaticky získávají názvy adresářů, ve kterých se nacházejí, a všechny velké soubory zůstávají blízko archivů, nemá smysl je balit, to je nastavitelné. Malé – archivujeme, velké – necháváme beze změn. Server funguje transparentně s oběma typy.
Architektura a vlastnosti serveru wZD.
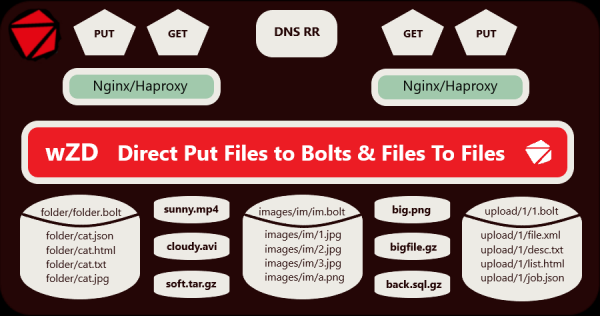
Server funguje pod operačními systémy Linux, BSD, Solaris a OSX. Testoval jsem pouze pro architekturu AMD64 pod Linuxem, ale měl by vyhovovat i pro ARM64, PPC64, MIPS64.
Hlavní funkce:
- Vícevláknovost;
- Mnoho-serverovost, zajišťující vysokou dostupnost a vyvážení zátěže;
- Maximální transparentnost pro uživatele nebo vývojáře;
- Podporované HTTP metody: GET, HEAD, PUT a DELETE;
- Správa chování při čtení a zápisu pomocí klientských hlaviček;
- Podpora flexibilně nastavitelných virtuálních hostitelů;
- Podpora CRC integrity dat při zápisu/čtení;
- Polodynamické bufferování pro minimální spotřebu paměti a optimální nastavení síťového výkonu;
- Odložená kompaktace dat;
- K dispozici je také vícerozměrný archivační nástroj wZA pro migraci souborů bez přerušení služby.
Skutečné zkušenosti:
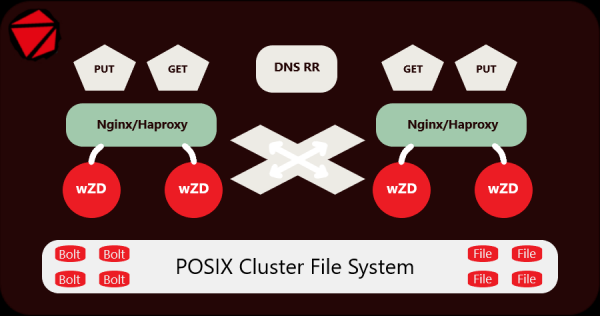
Dlouhou dobu jsem vyvíjel a testoval server a archivační nástroj na živých datech, nyní úspěšně funguje na clusteru obsahujícím 250 000 000 malých souborů (obrázků) umístěných ve 15 000 000 adresářích na oddělených SATA discích. Cluster ze 10 serverů slouží jako Origin server umístěný za CDN sítí. Pro jeho údržbu jsou použity 2 servery Nginx + 2 servery wZD.
Ti, kteří se rozhodnou použít tento server, by měli před použitím naplánovat strukturu adresářů, pokud je to možné. Okamžitě dodávám, že server není určen k tomu, aby všechno bylo uloženo do 1 Bolt archivu.
Testování výkonu:
Čím menší je velikost archivovaného souboru, tím rychleji se provádějí operace GET a PUT. Porovnáme celkový čas zápisu HTTP klientem do obyčejných souborů a do Bolt archivů, stejně jako čtení. Porovná se práce se soubory velikosti 32 KB, 256 KB, 1024 KB, 4096 KB a 32768 KB.
Při práci s Bolt archivy je kontrolována integrita dat každého souboru (používá se CRC), před zápisem a také po zápisu se provádí čtení za chodu a přepočet, což samozřejmě přináší zpoždění, ale hlavně — bezpečnost dat.
Testy výkonu jsem prováděl na SSD úložištích, protože na SATA discích testy neukazují jasný rozdíl.
Grafy podle výsledků testování:
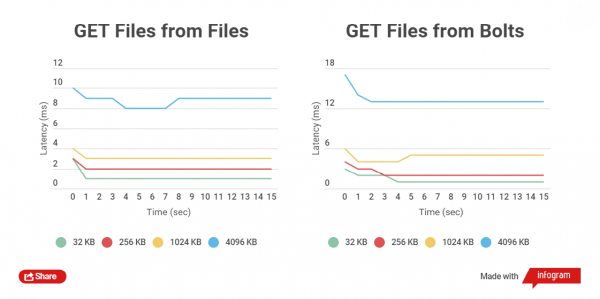
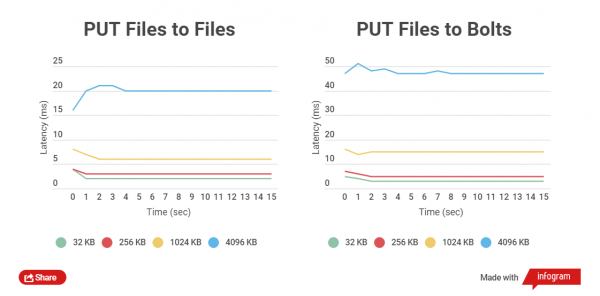
Jak vidno, pro malé soubory je rozdíl v čase čtení a zápisu mezi archivovanými a nearchivovanými soubory minimální.
U testu čtení a zápisu souborů o velikosti 32 MB získáme zcela jiný obraz:
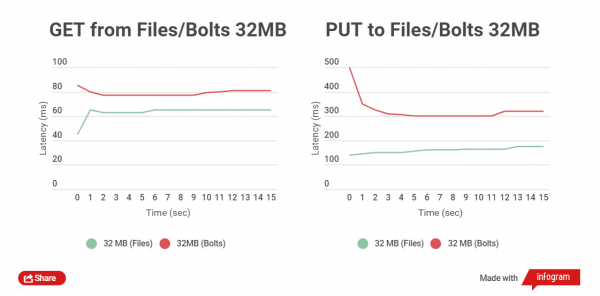
Rozdíl v čase mezi čtením souborů je v rozmezí 5-25 ms. Se zápisem je situace horší, rozdíl činí přibližně 150 ms. V tomto případě však není potřeba nahrávat velké soubory, v tom prostě není smysl, mohou existovat odděleně od archivů.
*Technicky lze tento server používat i pro úkoly vyžadující NoSQL.
Hlavní metody práce se serverem wZD:
Nahrání obyčejného souboru:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgNahrání souboru do Bolt archivu (pokud nebyl překročen serverový parametr fmaxsize, určuje maximální velikost souboru, který může být zahrnut do archivu; pokud je překročen, soubor se nahrává normálně vedle archivu):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgStahování souboru (pokud jsou na disku a v archivu soubory se stejnými názvy, při stahování má přednost přístupný soubor):
curl -o test.jpg http://localhost/test/test.jpgStahování souboru z Bolt archivu (násilně):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgPopis dalších metod je v dokumentaci.
Server zatím podporuje pouze protokol HTTP, s HTTPS zatím nefunguje. Také není podporována metoda POST (ještě není rozhodnuto, zda je potřebná nebo ne).
Kdo se podívá do zdrojového kódu, najde tam bonbón, ne každý ho má rád, ale já jsem základní kód nenavázal na funkce webového frameworku kromě obsluhy přerušení, takže později mohu rychle přepsat téměř na jakýkoli engine.
ToDo:
- Vývoj vlastního replikátoru a distributora + geo pro možnost použití ve velkých systémech bez clusterových FS (Vše vážně)
- Možnost úplného reverzního obnovení metadat při jejich úplné ztrátě (v případě použití distributora)
- Nativní protokol pro možnost použití trvalých síťových připojení a ovladače pro různé programovací jazyky
- Rozšířené možnosti využití složky NoSQL
- Komprese různých typů (gzip, zstd, snappy) pro soubory nebo hodnoty uvnitř Bolt archivů a pro běžné soubory
- Šifrování různých typů pro soubory nebo hodnoty uvnitř Bolt archivů a pro běžné soubory
- Oložená serverová video konverze, včetně GPU
To je vše, doufám, že tento server někomu přijde k užitku, licence BSD-3, dvoustupňový copyright, protože kdyby nebylo firmy, kde pracuji, nenapsal bych ani server. Jsem vývojář v jednotném čísle. Budu vděčný za nalezené chyby a žádosti o funkce.
Zdroj: habr.com
