

Hledání funkčních závislostí v datech se uplatňuje v různých oblastech analýzy dat: správě databází, čištění dat, reverzním inženýrství databází a exploraci dat. O samotných závislostech jsme již publikovali. Anastasii Birillo a Nikitu Bobrova. Tentokrát Anastasie – absolventka Computer Science Center letošního roku – sdílí pokrok této práce v rámci výzkumného projektu, který obhájila v centru.
Výběr úkolu
Během studia v CS centru jsem začala podrobně zkoumat databáze, konkrétně hledání funkčních a diferenčních závislostí. Tato téma byla spojena s tématem mé bakalářské práce na univerzitě, takže během práce na bakalářské jsem začala číst články o různých závislostech v databázích. Napsala jsem přehled této oblasti – jedno ze svých prvních. v anglickém jazyce a předložila ho na konferenci SEIM-2017. Byla jsem velmi ráda, když jsem zjistila, že byla stále přijata, a rozhodla jsem se téma podrobně prozkoumat. Samotná koncepce není nová – začali ji používat už v 90. letech, ale i dnes nachází uplatnění v mnoha oblastech.
Ve druhém semestru studia v centru jsem zahájila vědecko-výzkumný projekt zaměřený na zlepšení algoritmů pro hledání funkčních závislostí. Pracovala jsem na něm společně s postgraduálním studentem SPbGU Nikitou Bobrovem v JetBrains Research.
Výpočetní složitost hledání funkčních závislostí
Hlavním problémem je výpočetní složitost. Počet možných minimálních a netriviálních závislostí je omezen zeshora hodnotou  , kde
 – počet atributů tabulky. Doba běhu algoritmů závisí nejen na počtu atributů, ale i na počtu řádků. V 90. letech mohly algoritmy pro hledání FT na běžném stolním PC zpracovávat datové soubory obsahující až 20 atributů a desítky tisíc řádků po dobu několika hodin. Moderní algoritmy, které běží na vícejádrových procesorech, objevují závislosti pro datové sady složené ze stovek atributů (až 200) a stovek tisíc řádků přibližně za stejnou dobu. Přesto je to nedostačující: takový čas je pro většinu reálných aplikací nepřijatelný. Proto jsme vyvíjeli přístupy k urychlení existujících algoritmů.
Cache mechanismy pro překrývání partií
V první části práce jsme vyvinuli schémata cache pro třídu algoritmů využívajících metodu průniku partičních sad. Partice pro atribut představuje sadu seznamů, kde každý seznam obsahuje čísla řádků se stejnými hodnotami pro daný atribut. Každý takový seznam se nazývá klastr. Mnoho moderních algoritmů využívá partice k určení, zda je závislost zachována či nikoli, a to podle lemma: Závislost  je zachována, pokud
 . Zde
 je označena partice a používá se pojem velikost partice — počet klastrů v ní. Algoritmy využívající partice, při porušení závislosti, přidávají další atributy do levé části závislosti, po čemž ji přepočítávají provedením operace průniku partičních sad. Tato operace se v článcích nazývá specializace. Všimli jsme si však, že partice pro závislosti, které budou zachovány až po několika kolech specializace, mohou být aktivně znovu využívány, což může výrazně zkrátit čas běhu algoritmů, jelikož operace průniku je nákladná.
Proto jsme navrhli heuristiku založenou na Shannonově entropii a Genieho neurčitosti, stejně jako na naší metrice, kterou jsme nazvali Inverzní Entropie. Ta je nevýznamnou modifikací Shannonovy entropie a roste, jak rostla jedinečnost datové sady. Navrhovaná heuristika vypadá následovně:

Zde  — míra jedinečnosti nedávno vypočítané partice
 , a
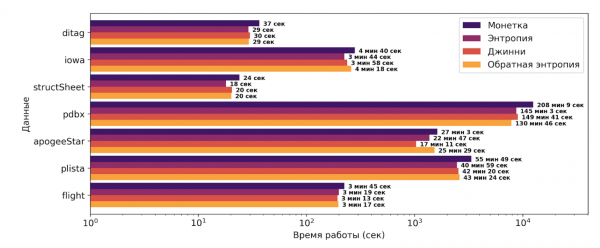
 je mediánová míra jedinečnosti pro jednotlivé atributy. V rámci metrik jedinečnosti byly vyzkoušeny všechny tři metriky, jak bylo popsáno výše. Také lze poznamenat, že heuristika obsahuje dva modifikátory. První určuje, jak blízko je aktuální partition k primárnímu klíči a umožňuje více cachovat ty partitions, které jsou daleko od potenciálního klíče. Druhý modifikátor sleduje obsazenost cache a tím podněcuje k přidání většího počtu partitions do cache, když je k dispozici volné místo. Úspěšné vyřešení této úlohy umožnilo zrychlit algoritmus PYRO o 10-40 % v závislosti na datasetu. Je třeba poznamenat, že algoritmus PYRO je v této oblasti nejúspěšnější.
Na obrázku níže můžete vidět výsledky aplikace navržené heuristiky v porovnání se základním přístupem k cachování založeným na náhodném výběru. Osa X je logaritmická.
Alternativní způsob ukládání partitions
Poté jsme navrhli alternativní způsob ukládání partitions. Partitions představují sadu clusterů, ve kterých jsou uloženy čísla záznamů s identickými hodnotami podle určitých atributů. Tyto clustery mohou obsahovat dlouhé sekvence čísel záznamů, například pokud jsou data v tabulce uspořádána. Proto jsme navrhli kompresní schéma pro ukládání partitions, a to konkrétně intervalové ukládání hodnot v clusterech partitions:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{První~interval}, underbrace{7, 8}_{Druhý~interval}, 10}}\ downarrow{Kompresní~proces}\ pi(X) = {{underbrace{$, 1, 5}_{První~interval}, underbrace{7, 8}_{Druhý~interval}, 10}}$$display$$
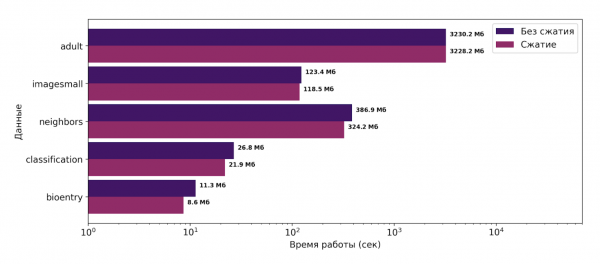
Tato metoda dokázala snížit spotřebu paměti během běhu algoritmu TANE o 1 až 25 %. Algoritmus TANE je klasický algoritmus pro vyhledávání FD, využívá partitions během své činnosti. V rámci praxe byl vybrán právě algoritmus TANE, protože bylo daleko jednodušší implementovat do něj intervalové ukládání než například do PYRO, aby se mohla posoudit funkčnost navrženého přístupu. Výsledky jsou zobrazeny na obrázku níže. Osa X je logaritmická.
Konference ADBIS-2019
Na základě výzkumu v září 2019 jsem vystoupila se článkem Na konferenci 23. evropské konference o pokrocích v databázích a informačních systémech (ADBIS-2019). Během prezentace práci ocenil Bernhard Thalheim, významná osobnost v oblasti databází. Výsledky výzkumu tvořily základ mé diplomové práce na matematicko-fyzikální fakultě SPbGU, během níž byly oba navržené přístupy (cacheování a komprese) implementovány do obou algoritmů: TANE a PYRO. Přitom výsledky ukázaly, že navržené přístupy jsou univerzální, protože u obou algoritmů při obou přístupech došlo k významnému snížení spotřeby paměti a také k významnému zkrácení doby běhu algoritmů.
Zdroj: habr.com
