

Pokračující téma zápisu velkých datových proudů, které bylo vzneseno , se zde zaměříme na způsoby, jakými lze snížit "fyzickou" velikost uloženého v PostgreSQL a jejich vliv na výkonnost serveru.
Bude řeč o nastavení TOAST a zarovnání dat. "V průměru" tyto metody umožní ušetřit ne příliš mnoho zdrojů, ale — vůbec bez modifikace kódu aplikace.
Nicméně, naše zkušenost byla v tomto ohledu velmi produktivní, protože úložiště téměř jakéhokoli monitorování je ze své podstaty většinou append-only pokud jde o zapisovaná data. A pokud vás zajímá, jak můžete naučit databázi zapisovat na disk místo 200MB/s o polovinu méně — prosím pod kat.
Malé tajemství velkých dat
Podle profilu práce , přicházejí mu pravidelně z logů textové balíčky.
A jelikož , jehož databáze monitorujeme, je mnohokomponentní produkt se složitými datovými strukturami, tak i dotazy pro dosažení maximální výkonnosti se stávají docela "mnogotominovými" s komplikovanou algoritmickou logikou. Podívejme se na strukturu jedné z tabulek, do které zapisujeme "syrová" data — tedy přesně původní text ze zápisu logu:
CREATE TABLE rawdata_orig( pack -- PK uuid NOT NULL , recno -- PK smallint NOT NULL , dt -- klíč sekce date , data -- to nejdůležitější text , PRIMARY KEY(pack, recno) );
Typická tabulka (již partitionovaná, samozřejmě, proto je to — šablona sekce), kde to nejdůležitější — je text. Někdy dost objemný.Připomeňme si, že "fyzická" velikost jednoho záznamu v PG nemůže zabírat více než jednu stránku dat, ale "logická" velikost — to je úplně jiná věc. Pro uložení objemné hodnoty do pole (varchar/text/bytea) se používá
technologie TOAST :
PostgreSQL používá pevnou velikost stránky (obvykle 8 KB) a nedovoluje, aby tuplíky zabíraly více stran. Proto není možné přímo ukládat velmi velké hodnoty polí. Abychom překonali toto omezení, jsou velké hodnoty polí komprimovány a/nebo rozděleny na několik fyzických řádků. To se děje nepozorovaně pro uživatele a ovlivňuje většinu kódu serveru nevýznamně. Tato metoda je známá jako TOAST …
Ve skutečnosti je pro každou tabulku s "potenciálně velkými" poli automaticky každého "velkého" záznamu segmenty po 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
To znamená, že pokud musíme zapisovat řádek s "velkou" hodnotou data, skutečný záznam se provede nejen do hlavní tabulky a jejího PK, ale také do TOASTu a jeho PK.
Snižujeme vliv TOASTu
Ale většina záznamů zdaleka není tak velká, měly by se vejít do 8KB — jak na tom ušetřit?..
Zde nám pomáhá atribut u sloupce tabulky:
- EXTENDED umožňuje jak kompresi, tak oddělené ukládání. To je standardní možnost pro většinu typů dat kompatibilních s TOAST. Nejprve se pokouší o kompresi, poté - o uložení mimo tabulku, pokud je řádek stále příliš velký.
- MAIN umožňuje kompresi, ale ne oddělené ukládání. (Ve skutečnosti se oddělené ukládání přesto provede pro takové sloupce, ale pouze jako krajní řešení, když není jiná možnost, jak zmenšit řádek tak, aby se vešel na stránku.)
Ve skutečnosti je to přesně to, co potřebujeme pro text — maximálně komprimovat, a pokud se to stále nevejde — přesunout do TOAST.Lze to provést přímo „za chodu“, jedním příkazem:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Jak posoudit efekt
Protože každý den se tok dat mění, nemůžeme porovnávat absolutní čísla, ale v relativních měřítkách čím menší podíl jsme zapsali do TOASTu — tím lépe. Ale zde je nebezpečí — čím větší je náš „fyzický“ objem každého jednotlivého záznamu, tím „širší“ se stává index, protože musí pokrýt větší množství datových stran.
Sekce před změnami:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sekce po změnách:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Ve skutečnosti jsme začali jsme psát do TOAST dvakrát méně, což uvolnilo nejen disk, ale i CPU:
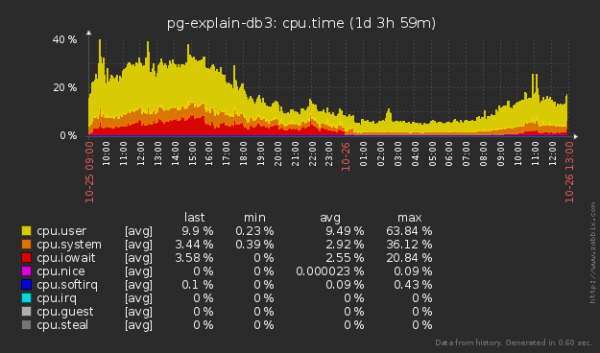
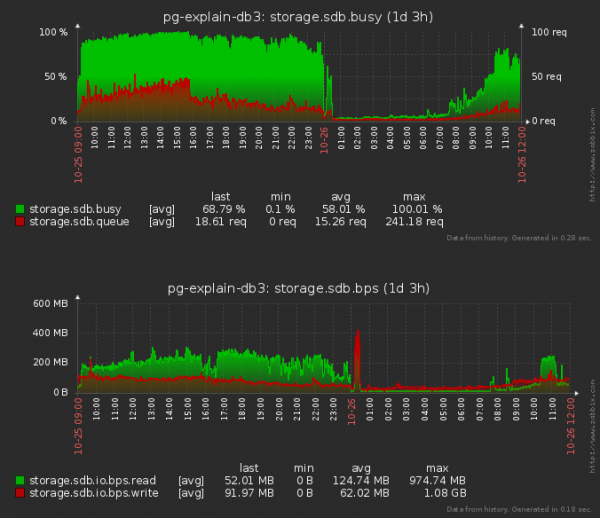
Rád bych poznamenal, že také "číst" disk jsme začali méně, nejen "psát", protože při vložení záznamu do nějaké tabulky je třeba "přečíst" i část stromu každého z indexů, abychom určili její budoucí pozici v nich.
Komu se dobře žije na PostgreSQL 11
Po aktualizaci na PG11 jsme se rozhodli pokračovat v "ladění" TOAST a všimli jsme si, že od této verze je k dispozici pro nastavení parametr :
Kód zpracování TOAST se spouští pouze tehdy, když velikost řetězce, který má být uložen v tabulce, překročí TOAST_TUPLE_THRESHOLD bajtů (obvykle je to 2 kB). Kód TOAST bude komprimovat a/nebo přesouvat hodnoty pole mimo tabulku, dokud velikost řetězce není menší než TOAST_TUPLE_TARGET bajtů (proměnná velikost, obvykle také 2 kB) nebo dokud není možné objem zmenšit.
Rozhodli jsme se, že data máme obvykle buď "zcela krátká", nebo hned "velmi dlouhá", a proto jsme se rozhodli omezit na minimálně možné hodnoty:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Podívejme se, jak nové nastavení ovlivnilo zatížení disku po přenastavení:
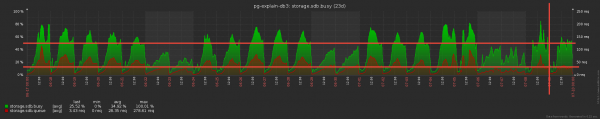
Dobře! Průměrná fronta na disk se snížila asi o 1,5 krát, a "využití" disku — o 20%! Ale možná to nějak ovlivnilo CPU?
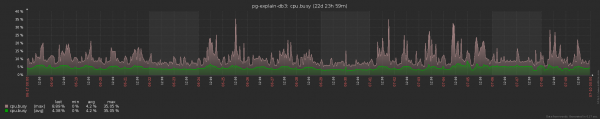
Minimálně to určitě nebylo horší. Ačkoli, těžko říct, pokud i takové objemy stejně nemohou zvýšit průměrné zatížení CPU nad 5%.
Změna pořadí sčítanců… mění součet!
Jak je známo, haléř šetří rubl, a při našich objemech úložiště kolem 10TB/měsíc i drobná optimalizace může přinést slušný zisk. Proto jsme se zaměřili na fyzickou strukturu svých dat — jak konkrétně "uložena" pole uvnitř záznamu každé z tabulek.
Protože kvůli to přímo :
Mnoho architektur počítá s zarovnáním dat na hranicích strojních slov. Například na 32bitovém systému x86 budou celočíselné hodnoty (typ integer, zabírá 4 bajty) zarovnány na hranici 4-bajtových slov, stejně jako čísla s plovoucí desetinnou čárkou dvojité přesnosti (typ double precision, 8 bajtů). A na 64bitovém systému budou hodnoty typu double zarovnány na hranici 8-bajtových slov. Toto je další důvod nekompatibility.
Vzhledem k zarovnání velikost tabulky závisí na pořadí umístění polí. Obvykle není tento efekt příliš znatelný, ale v některých případech může vést k výraznému zvýšení velikosti. Například pokud se smíchají pole typu char(1) a integer, obvykle mezi nimi zbytečně zmizí 3 bajty.
Začněme se syntetickými modely:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bajtů

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bajtů
Odkud se vzala pár zbytečných bajtů v prvním případě? Je to jednoduché — 2-bajtový smallint se zarovná na 4-bajtovou hranici před dalším polem, a když je poslední — není co zarovnávat a není důvod.
V teorii — je vše v pořádku a pole lze přesouvat jak se vám zlíbí. Ověřme to na reálných datech na příkladu jedné z tabulek, jejíž denní sekce zabírá 10-15GB.
Původní struktura:
CREATE TABLE public.plan_20190220
(
-- Děděno z tabulky plan:  pack uuid NOT NULL,
-- Děděno z tabulky plan:  recno smallint NOT NULL,
-- Děděno z tabulky plan:  host uuid,
-- Děděno z tabulky plan:  ts timestamp with time zone,
-- Děděno z tabulky plan:  exectime numeric(32,3),
-- Děděno z tabulky plan:  duration numeric(32,3),
-- Děděno z tabulky plan:  bufint bigint,
-- Děděno z tabulky plan:  bufmem bigint,
-- Děděno z tabulky plan:  bufdsk bigint,
-- Děděno z tabulky plan:  apn uuid,
-- Děděno z tabulky plan:  ptr uuid,
-- Děděno z tabulky plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sekce po změně pořadí sloupců — přesně stejné pole, jen jiný pořádek:
CREATE TABLE public.plan_20190221
(
-- Děděno z tabulky plan:  dt date NOT NULL,
-- Děděno z tabulky plan:  ts timestamp with time zone,
-- Děděno z tabulky plan:  pack uuid NOT NULL,
-- Děděno z tabulky plan:  recno smallint NOT NULL,
-- Děděno z tabulky plan:  host uuid,
-- Děděno z tabulky plan:  apn uuid,
-- Děděno z tabulky plan:  ptr uuid,
-- Děděno z tabulky plan:  bufint bigint,
-- Děděno z tabulky plan:  bufmem bigint,
-- Děděno z tabulky plan:  bufdsk bigint,
-- Děděno z tabulky plan:  exectime numeric(32,3),
-- Děděno z tabulky plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Celkový objem sekce se určuje počtem „faktů“ a závisí pouze na vnějších procesech, proto si podělíme velikost heap (pg_relation_size) na počet záznamů v ní — tedy získáme průměrnou velikost skutečně uloženého záznamu:
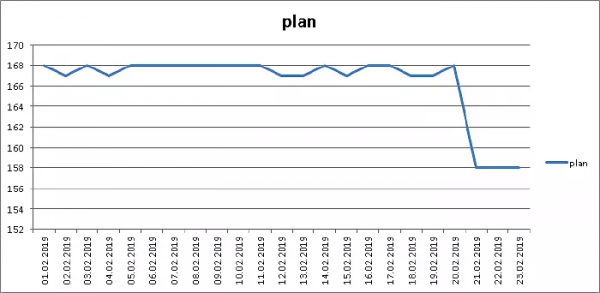
Minus 6% objemu, výborně!
Ale samozřejmě to není tak růžové — protože v indexech pořadí polí změnit nemůžeme, a proto „celkově“ (pg_total_relation_size)…
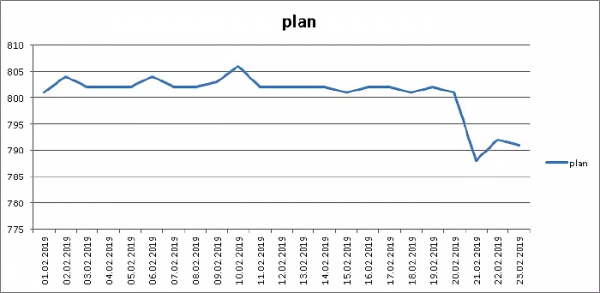
… přece jen i tady ušetřili 1.5%, aniž bychom změnili jediný řádek kódu. Takže ano!
Rád bych poznamenal, že výše uvedená varianta uspořádání polí — není jisté, že je ta nejoptimálnější. Protože některé bloky polí nechceme „roztrhat“ už z estetických důvodů — například pár (pack, recno), která je PK pro tuto tabulku.
Celkově však definice „minimálního“ uspořádání polí je poměrně jednoduchý „probranka“ úkol. Proto můžete na svých datech dosáhnout výsledků ještě lepších než my — zkuste!
Zdroj: habr.com
