

Když mluvíme o steganografii, lidé si představují teroristy, pedofily, špehy, a v lepším případě kryptoanarchisty a další vědce. A opravdu, kdo jiný by mohl potřebovat skrývat něco skrýt před vnějšími zraky? Jaký vůbec může z toho mít prospěch obyčejný člověk?
Odpověď zní, že nějaký prospěch z toho existuje. A právě proto dnes budeme komprimovat data pomocí metod steganografie. Na konci si dokonce čtenář bude moci využít své cenné fotoarchivy ve formátu JPEG k navýšení volného místa na souborovém systému.
Co?
Pokud si čtenář pamatuje, steganografie jsou podivné algoritmy, které umožňují skrýt přítomnost jedné informace uvnitř jiné. Jednoduše řečeno: obrázek + soubor == téměř stejný obrázek, ale ne zcela (může to být cokoliv, ale na obrázcích je to obvykle jasnější). A přitom neexistuje jednoduchý způsob, jak zjistit, zda je uvnitř něco nebo ne.
Ale pokud nelze rozlišit jedno od druhého, má to vůbec nějaký rozdíl? Z pohledu spotřebitele, uživatele nezajímá matematická přesnost (reflektovaná konkrétním souborem bitů), ale pouze to, co vnímá.
Například se podívejme na tři obrázky roztomilého psa:
Pozor, JPEG!
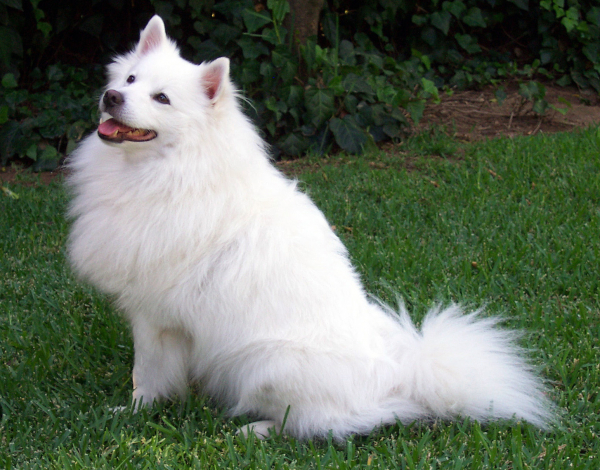
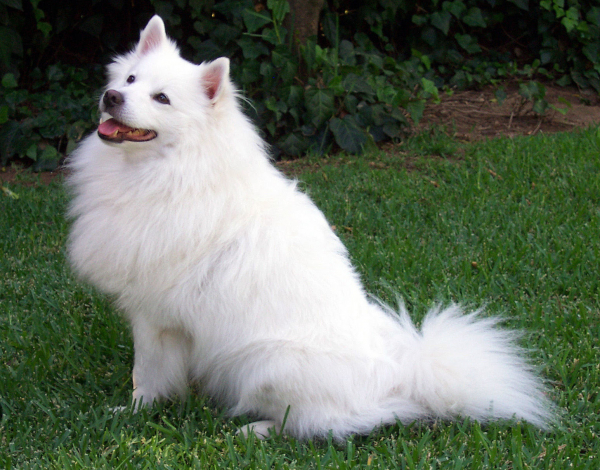
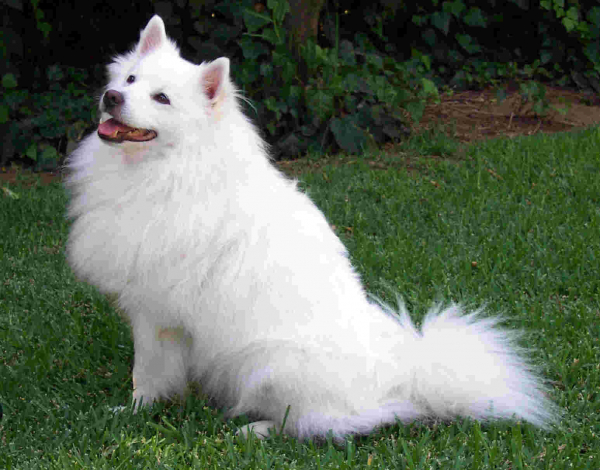
I přes obrovský rozdíl ve velikosti, málokdo si vybere třetí verzi. Na druhé straně, rozdíl mezi prvními dvěma fotografiemi není tak patrný a množství informací v nich (z mého pohledu) lze považovat za ekvivalentní.
Tento princip je sám o sobě starý a léta se aktivně využívá metodami komprese informací s ztrátou. Ale bourat není stavět, zajímá nás pokročilejší stránka otázky. Je možné vložit dodatečné informace velikosti N do souboru tak, aby jeho velikost vzrostla o M < N, a změny nebyly uživateli patrné?
Samozřejmě, že je to možné. Ale hned je třeba udělat pár poznámek:
- Za prvé, metoda by měla být univerzální a přinášet pozitivní výsledky na většině vstupních dat. To znamená, že průměrně by mělo docházet k skutečnému snížení množství uchovávaných informací. 'Průměrně' znamená, že opačné případy se mohou vyskytnout, ale neměly by převažovat.
- Za druhé, velikost komprimovaného kontejneru před vložením informací musí být větší než komprimovaný obdobným způsobem jeho modifikace. Pouhé vložení do obrázku BMP metodou LSB hromady bitů není steganografické komprimování, protože po zpracování nějakým DEFLATE bude původní obraz pravděpodobně výrazně menší.
- Za třetí, výsledky je třeba provádět a srovnávat v rámci již klasickými metodami komprimovaných dat. To umožní eliminovat pravděpodobnostní účinek rozdílu jejich přebytečnosti a provést efektivnější komprimaci v obecném případě.
Kde?
Použití steganografie znamená, že kromě komprimovaných informací budeme potřebovat kontejnery, do kterých budou vložena. Maximální množství vkládaných informací do značné míry závisí na jednotlivých vlastnostech, ale mnohem lépe se škáluje s jejich počtem. Proto by formát kontejnerů měl být běžný, aby uživatel měl dostatečné množství pro dosažení alespoň nějakého výnosu z procesu "komprimace".
V tomto kontextu se dobrými kandidáty stávají grafické, audio a video soubory. Ale kvůli rozmanitosti různých formátů, kodeků atd., nám na praktické úrovni zůstává výběr z nijak početného množství variant.
S ohledem na to jsem se rozhodl pro JPEG. Je téměř u všech, široce se používá jak v osobní, tak v obchodní sféře a stal se téměř de facto formátem pro většinu obrázků.
K̶d̶y̶ ̶ Jak?
Dále následují technické a okrajové diagramy a popisy bez podrobných vysvětlení, takže zájemci je mohou přeskočit přejitím do sekce "Vysoce technologie".
Obecné rysy
Abychom vložili data někam, musíme nejprve určit, kam. Na souborovém systému může být jakkoli mnoho různých fotografií, z nichž si uživatel může chtít vybrat pouze některé. Toto požadované množství kontejnerů budeme nazývat knihovnou.
Vytváří se ve dvou případech: před kompresí a před dekompresí. V prvním případě lze jednoduše použít seznam jmen (nebo raději regulární výraz) souborů, ale ve druhém případě je potřeba něco spolehlivějšího: uživatel může kopírovat a přesouvat je v rámci souborového systému, což brání správnému určení. Proto je nutné uchovávat jejich hash (md5 je dostatečný) po provedení všech modifikací.
Původní vyhledávání pomocí regulárního výrazu nemá smysl provádět v celém souborovém systému, stačí uvést určitou kořenovou adresář. Do něj bude také ukládán speciální archivní soubor, ve kterém budou umístěny tyto hashe spolu s dalšími metadatami nezbytnými pro následné obnovení komprimovaných informací.
To vše platí stejně pro jakoukoliv implementaci jakéhokoli algoritmu steganografické komprese dat. Samotné procesy komprese a obnovení dat lze nazývat balením a rozbalováním.
F5
Nyní, když je jasné, co děláme a proč, zbývá popsat samotný algoritmus dosažení cíle. Připomeňme si proces kódování JPEG-souboru (děkujeme Wikipedii národní knihovny jménem Baumana):
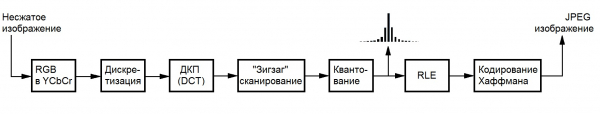
Při pohledu na to je lepší hned udělat několik poznámek:
- Velikost JPEG-souboru lze považovat za optimální, i aniž bychom se pokusili zkomprimovat pomocí nějakého WinRARu;
- Lze měnit pouze uchovávané informace (ty, které jsou na výstupu diskrétního kosinového transformace, DCT), abychom zajistili alespoň nějakou přijatelnost výkonu.
- Aby nedocházelo k výrazným ztrátám dat pro uživatele v průmyslovém měřítku, je nutno provádět minimální modifikace v každém jednotlivém obrázku;
Pod tyto podmínky vyhovuje celé rodině algoritmů, se kterými se můžete seznámit . Nejvyspělejší z nich je algoritmus od Andrease Westfelda, pracující s koeficienty DCT složky jasu (lidské oko je nejméně citlivé právě na její změny). Jeho obecná schéma při práci se stávajícím JPEG-soubor je znázorněna následující schématem:
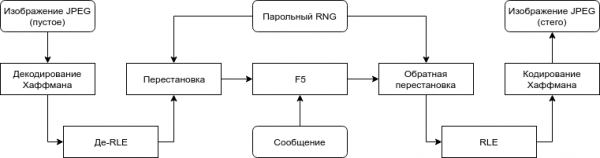
Blok F5 používá pokročilou metodu vkládání založenou na kódování matice. Více informací o ní a samotném algoritmu může čtenář nalézt v odkazu výše, nás však především zajímá ten fakt, že díky němu lze provádět tím méně změn při vkládání stejného množství informací, čím větší je velikost použitého kontejneru, a pro provedení samotného algoritmu je třeba vykonat pouze jednoduché operace (de)kódování Huffmanem a RLE.
Změny se provádějí na celočíselných koeficientech a spočívají ve snížení jejich absolutní hodnoty o jednotku, což umožňuje, aby se F5 používalo k compressi dat. Je to proto, že snížený absolutní koeficient pravděpodobně zabere méně bitů po provedení kódování Huffmanem díky statistickému rozložení hodnot v JPEG.
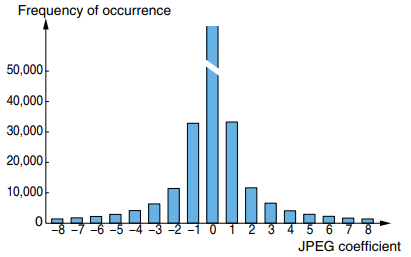
V případě vzniku nuly (tzv. zkrácení) se množství uložených informací sníží o její velikost, neboť bývalý samostatný koeficient se stane součástí zakódované RLE sekvence nul:
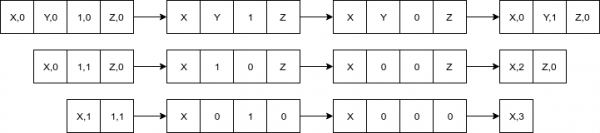
Modifikace
Ochrana dat a jejich komprese jsou ortogonální úkoly, a proto lze opomenout tajnou permutaci hesla z původního algoritmu. Navíc potřebujeme přesně vědět, jak extrahovat data, proto všechny potřebné informace (jaké kontejnery byly použity, v jakém pořadí atd.) musí být zaznamenány do samostatného souboru a být připraveny pro volné čtení archivátorem.
Původní algoritmus je navržen pro přenos tajných zpráv, a proto pracuje vždy pouze s jedním kontejnerem, předpokládaje, že uživatel sám bude toto rozdělovat na části podle potřeby, pokud vůbec nastane. Navíc při nezávislém vkládání do každého kontejneru bude potřeba předem vědět, kolik bitů dat vložit do každého z nich. Proto je vhodné sloučit koeficienty každého prvku knihovny do jednoho abstraktního velkého a pracovat s ním podle původního algoritmu.
Jelikož originální F5 umožňuje používat až 12 % velikosti kontejneru, taková modifikace také zvýší maximální kapacitu: „až 12 %“ z velikosti celé knihovny je více nebo rovno součtu „až 12 %“ z každého z jejích prvků.
Kodifikovaná obecná schéma vypadá následovně:
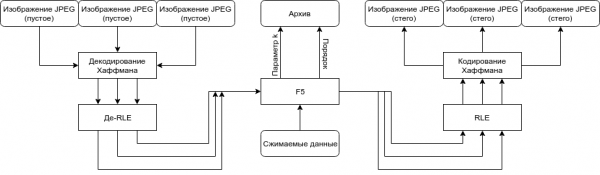
Algoritmus sám
Nyní je čas popsat samotný algoritmus od začátku do konce, aby čtenář nebyl v nevědomosti:
- Uživatel definuje binární komprimovaná data M a knihovnu L pomocí regulárního výrazu a kořenového adresáře pro hledání;
- V pořadí na FS prvky knihovny tvoří MC:
- Z datového souboru se dekóduje série koeficientů C;
- MC <- MC | C;
- Parametr k je určen na základě strašné nerovnosti:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Postupně se vezme
n = (1 << k) - 1nejmladších bitů nenulových prvků z MC a zapíše se doa:- Počítá se magická hashovací funkce
f, která mapuje n-bitové slovoana k-bitovés; - Pokud
s == 0, není třeba nic měnit a algoritmus přechází k dalším koeficientům; - Snížit absolutní hodnotu koeficientu, který odpovídá
s-ému bitu ve slověa; - Pokud v důsledku snížení došlo k zkrácení (koeficient se stal 0), pak opakujte krok od začátku;
- Počítá se magická hashovací funkce
- Všechny koeficienty jsou kódovány RLE a Huffmanem, zapisují se do zdrojových souborů;
- Do archivu se zapisuje parametr k;
- Z každého souboru L podle jejich původního umístění se počítá MD5-hash a zapisuje se do archivu.
Vysoce technologie
Naivní forma algoritmu a implementace v jiných vysoce úrovňových (zejména s garbage collection) jazycích by poskytla hrozné výkony, proto jsem všechny tyto složitosti implementoval v čistém C a provedl řadu optimalizací jak z hlediska rychlosti provedení, tak z hlediska paměti (nepředstavujete si, kolik ty obrázky váží bez komprese i do DCT). Ale i tak, zpočátku rychlost provedení zanechávala hodně přání, takže nebudu popisovat celý proces a použité metody.
Křížová platformovost byla dosažena kombinací knihoven libjpeg, pcre a tinydir, za což jim děkuji. Ve výchozím nastavení se vše kompiluje pomocí běžného make, proto by uživatelé Windows měli nainstalovat nějaký Cygwin, nebo se sami zabývat Visual Studio a knihovnami.
Realizace je k dispozici ve formě konzolové utility a knihovny. Podrobněji o používání druhé varianty se zájemci mohou seznámit v README v repozitáři na GitHubu, jehož odkaz přiložím na konci příspěvku. A nyní přejdeme k popisu a demonstraci funkce.
Jak používat?
S opatrností. Použité obrázky lze podle potřeby přesouvat, přejmenovávat a kopírovat. Je však třeba být velmi opatrný a nijak nezměnit jejich obsah. Změna jednoho bitu povede k porušení hashe a nemožnosti obnovit informace.
Představme si, že po kompilaci jsme získali spustitelný soubor f5ar. Můžeme analyzovat velikost knihovny pro výpočet možností jejího použití pomocí příznaku -a: ./f5ar -a [hledací složka] [Perl-kompatibilní regulární výraz]. Komprese se provádí příkazem ./f5ar -p [hledací složka] [Perl-kompatibilní regulární výraz] [komprimovaný soubor] [název archivu], a dekomprese pomocí ./f5ar -u [archivní soubor] [název obnoveného souboru].
Demonstrace funkce
Abych ukázal účinnost metody, nahrál jsem sbírku 225 zcela bezplatných fotografií psů z služby . Každá z nich má o něco vyšší kvalitu, než běžné uživatelské fotografie, ale přesto. Každá z nich byla překódována pomocí libjpeg, aby se neutralizovaly vlivy specifik kódování knihovny na celkovou velikost. Pro označení nejhoršího příkladu komprimovaných dat pomocí dd byl vygenerován náhodný 36MB (o něco více než 5% z celkové velikosti) rovnoměrně rozložený soubor.
Proces testování je velmi jednoduchý:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ ./f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Čtení komprimovaného souboru... ok
Inicializace archivu... ok
Analýza kapacity knihovny... hotovo za 16,8s
Zjištěná jakoby garantovaná kapacita 48439359 bytů
Zjištěná možná kapacita až 102618787 bytů
Kompresování... hotovo za 32,6s
Uložení archivu... ok

$ ./f5ar -u dogs/dogs.f5ar unpacked
Inicializace archivu... ok
Čtení archívního souboru... ok
Naplnění archivu soubory... hotovo za 1,2s
Dekompresování... hotovo za 17,5s
Zápis extrahovaných dat... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Nebo screenshot pro milovníky
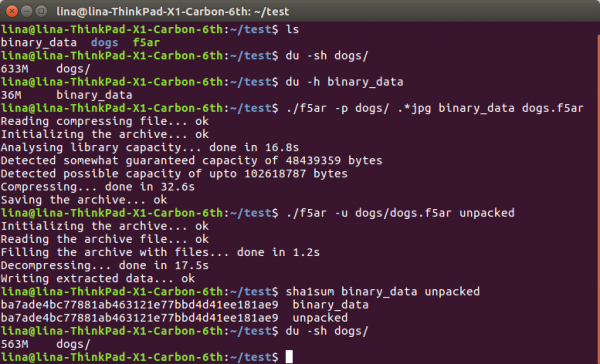
Jak je vidět, z původních 633 + 36 == 669 megabajtů dat na pevném disku jsme se dostali k příjemnějším 563, což nám dává poměr komprese ~1,188. Tak radikální rozdíl je vysvětlen velmi malými ztrátami, podobnými těm, které se objevují při optimalizaci JPEG souborů klasickými metodami (např. tinyjpg). Při použití steganografické komprese se informace jen 'nezačínají', ale jsou využívány k kódování jiných dat. Navíc, počet 'optimalizovaných' koeficientů díky použití F5 je mnohem menší než při tradiční optimalizaci.
Jakékoliv modifikace nejsou pro oko absolutně viditelné. Pod spoilerem níže si čtenář může porovnat rozdíl jak na pohled, tak získaný odečtením hodnoty změněné komponenty od originální (čím více potlačená barva, tím menší rozdíl):
Odkazy na obrázky, které se nevešly na habrastorage
Originál —
Modifikovaný —
Rozdíl —
Na závěr
Doufám, že jsem schopen čtenáře přesvědčit, že takové metody jsou možné a mají právo na existenci. Nicméně, koupě pevného disku nebo dalšího kanálu (pro síťový přenos) se může zdát mnohem jednodušším východem, než se snažit šetřit tímto způsobem. Na jedné straně je to opravdu tak, extenzivní rozvoj je často jednodušší a spolehlivější. Na druhé straně však nesmíme zapomínat na intenzivní. Vždyť neexistují žádné záruky, že zítra půjdeme do obchodu a koupíme si další pevný disk o kapacitě tisíc terabajtů, ale to, co už máme doma, můžeme použít vždy.
->
Zdroj: habr.com
