

Na základě mých vystoupení na Highload++ a DataFest Minsk 2019.
Pro mnoho lidí je dnes e-mail neodmyslitelnou součástí života na internetu. Pomocí něj vedeme obchodní korespondenci, uchováváme různé důležité informace týkající se financí, rezervací hotelů, realizace objednávek a mnohem více. V polovině roku 2018 jsme formulovali produktovou strategii rozvoje e-mailu. Jaký by měl být moderní e-mail?
E-mail musí být inteligentní, tedy pomáhat uživatelům orientovat se v rostoucím objemu informací: filtrovat, strukturovat a poskytovat je co nejpohodlnějším způsobem. Měl by být užitečný, umožňující řešit různé úkoly přímo v e-mailové schránce, například platit pokuty (funkce, kterou, bohužel, využívám). A samozřejmě, e-mail by měl zajišťovat ochranu informací, filtrovat spam a chránit před hackery, tedy být bezpečné.
Tyto směry určují řadu klíčových úkolů, z nichž mnohé mohou být efektivně řešeny pomocí strojového učení. Zde jsou příklady již existujících funkcí, vyvinutých v rámci strategie — po jednom na každou oblast.
- Smart Reply. V e-mailu je funkce chytré odpovědi. Neuronová síť analyzuje text e-mailu, chápe jeho smysl a účel, a v důsledku toho navrhuje tři nejvhodnější možnosti odpovědi: pozitivní, negativní a neutrální. To pomáhá podstatně ušetřit čas při odpovědích na e-maily a také často reagovat netradičně a zábavně.
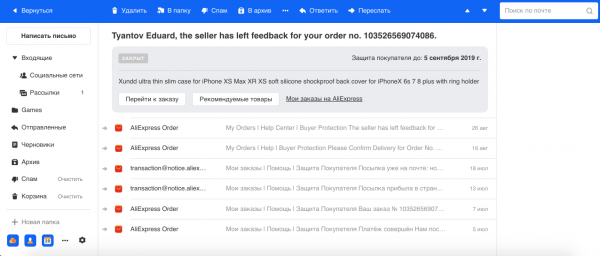
- Skupinování e-mailů, které se týkají objednávek v internetových obchodech. Často nakupujeme na internetu a obchody obvykle mohou posílat několik e-mailů na každou objednávku. Například od AliExpressu, největšího servisu, chodí velmi mnoho e-mailů k jedné objednávce, a zjistili jsme, že v krajním případě může jejich počet dosáhnout až 29. Proto pomocí modelu rozpoznávání pojmenovaných entit vyčleňujeme číslo objednávky a další informace z textu a skupinujeme všechny e-maily do jednoho vlákna. Také zobrazujeme základní informace o objednávce v samostatné liště, což usnadňuje práci s tímto typem e-mailů.

- AntiphishingPhishing je zvlášť nebezpečný typ podvodných e-mailů, pomocí kterých se zloději snaží získat finanční informace (včetně údajů o bankovních kartách uživatelů) a přihlašovací údaje. Tyto e-maily se maskují jako pravé zprávy zaslané službou, včetně vizuálního vzhledu. Proto pomocí Computer Vision rozpoznáváme loga a styl designu e-mailů velkých společností (například Mail.ru, Sber, Alfa) a zahrnujeme tyto prvky spolu s textem a dalšími charakteristikami do našich klasifikátorů spamu a phishingu.
Strojové učení
Něco málo o strojovém učení v e-mailech obecně. E-mail je vysoce zátěžový systém: našimi servery prochází průměrně 1,5 miliardy e-mailů denně pro 30 milionů uživatelů DAU. Všechny potřebné funkce a vlastnosti obsluhuje přibližně 30 systémů strojového učení.
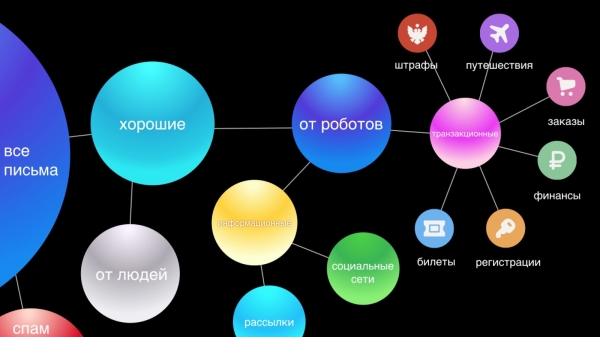
Každý e-mail prochází celým klasifikačním procesem. Nejdříve odfiltrováváme spam a necháváme pouze dobré e-maily. Uživatelé často nezaznamenávají práci antispamu, protože 95–99 % spamu se nedostane ani do příslušné složky. Rozpoznávání spamu je velmi důležitou a nejtěžší částí našeho systému, protože v oblasti antispamu probíhá neustálá adaptace mezi ochrannými a útočnými systémy, což přináší trvalou inženýrskou výzvu pro náš tým.
Dále dělíme e-maily od lidí a robotů. E-maily od lidí jsou nejdůležitější, proto pro ně nabízíme funkce jako Smart Reply. E-maily od robotů se dělí na dvě části: transakční — to jsou důležité e-maily od služeb, jako jsou potvrzení nákupů nebo rezervací hotelů, financí, a informační — což je obchodní reklama, slevy.
Domníváme se, že transakční e-maily mají stejnou důležitost jako osobní korespondence. Měly by být po ruce, protože často potřebujeme rychle najít informace o objednávce nebo rezervaci letenky, a ztrácíme čas jejich hledáním. Proto je pro usnadnění automaticky dělíme do šesti základních kategorií: cestování, objednávky, finance, jízdenky, registrace a nakonec pokuty.
Informační e-maily jsou nejpočetnější a pravděpodobně nejméně důležitou skupinou, která nevyžaduje okamžitou reakci, protože pokud uživatel takový e-mail nepřečte, v jeho životě se nic zásadního nezmění. V našem novém rozhraní je svrhujeme do dvou vláken: sociálních sítí a newsletterů, čímž vizuálně vyčistíme schránku a necháme na očích pouze důležité e-maily.
Provoz
Velké množství systémů přináší mnoho obtíží v provozu. Vždyť modely s časem degradují, stejně jako jakýkoli software: zanikají funkce, selhávají zařízení a hromadí se chybový kód. Navíc se neustále mění údaje: přidávají se nové, transformuje se vzor chování uživatelů atd., takže model bez řádné podpory bude s časem fungovat čím dál hůře.
Nesmíme zapomínat ani na to, že čím hlouběji strojové učení proniká do života uživatelů, tím větší vliv mají na ekosystém, a následně tím více finančních ztrát nebo zisků mohou hráči na trhu učinit. Proto se v čím dál větším počtu oblastí hráči adaptují na práci s ML algoritmy (klasické příklady - reklama, vyhledávání a již zmíněný antispam).
Také úkoly strojového učení mají specifikum: jakákoliv, i drobná změna v systému může vyvolat spoustu práce s modelem: práce s daty, přeškolení, nasazení, což může trvat týdny nebo měsíce. Proto čím rychleji se mění prostředí, ve kterém vaše modely operují, tím více úsilí vyžaduje jejich podpora. Tým může vytvořit celou řadu systémů a radovat se z toho, ale poté může téměř všechny zdroje utratit na jejich údržbu, aniž by měl možnost udělat něco nového. S takovou situací jsme se jednou setkali v týmu antispamu. A udělali jsme zřejmý závěr, že údržbu je třeba automatizovat.
Automatizace
Co lze automatizovat? Ve skutečnosti téměř všechno. Vyjmenoval jsem čtyři oblasti, které určují infrastrukturu strojového učení:
- sběr dat;
- dokončení školení;
- nasazení;
- testování & monitoring.
Pokud je prostředí nestabilní a neustále se mění, pak je celá infrastruktura kolem modelu mnohem důležitější než samotný model. Může to být starý dobrý lineární klasifikátor, ale pokud správně podáme znaky a nastavíme dobrou zpětnou vazbu od uživatelů, bude fungovat mnohem lépe než modely typu State-Of-The-Art se všemi vymoženostmi.
Cyklus zpětné vazby
Tento cyklus spojuje sběr dat, doladění a nasazení — v podstatě celý cyklus aktualizace modelu. Proč je to důležité? Podívejte se na graf registrace v e-mailu:
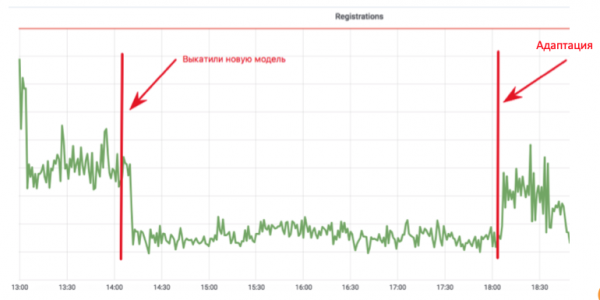
Vývojář strojového učení implementoval model antibota, který brání botům registraci v e-mailu. Graf klesá na hodnotu, kde zůstávají pouze skuteční uživatelé. Vše je skvělé! Ale po čtyřech hodinách, boti přizpůsobují své skripty, a vše se vrací do starých kolejí. V této implementaci strávil vývojář měsíc tím, že přidával znaky a doladil model, ale spammer se za čtyři hodiny dokázal adaptovat.
Aby to nebylo tak bolestivé a později se nemuselo vše předělávat, je třeba zpočátku myslet na to, jak bude cyklus zpětné vazby vypadat a co budeme dělat, pokud se prostředí změní. Začněme se sběrem dat — to je palivo pro naše algoritmy.
Sběr dat
Je jasné, že moderním neuronovým sítím platí, čím více dat, tím lépe, a ta vlastně generují uživatelé produktu. Mohou nám pomáhat uživatelé, kteří označují data, ale neměli bychom toho zneužívat, protože uživatelům se v určitém okamžiku přestane chtít dotvářet vaše modely a přejdou na jiný produkt.
Jednou z nejčastějších chyb (tady odkazují na Andrew Ng) — příliš silná orientace na metriky na testovacím datovém souboru, a nikoli na zpětnou vazbu od uživatele, což je ve skutečnosti hlavním měřítkem kvality práce, protože vytváříme produkt pro uživatele. Pokud uživateli není jasné nebo se mu nelíbí fungování modelu, znamená to, že vše je marné.
Proto by uživatel měl vždy mít možnost hlasovat, je třeba mu dát nástroj pro zpětnou vazbu. Pokud se domníváme, že do schránky přišel e-mail týkající se financí, je třeba jej označit jako „finance“ a nakreslit tlačítko, které uživatel může stisknout a říct, že to nejsou finance.
Kvalita zpětné vazby
Pojďme si promluvit o kvalitě uživatelské zpětné vazby. Za prvé, vy a uživatelé můžete mít různé představy o jednom pojmu. Například vy s produktovými manažery považujete finance za bankovní dopisy, zatímco uživatel si myslí, že dopis od babičky o důchodu také spadá do kategorie financí. Za druhé, existují uživatelé, kteří bezmyšlenkovitě klikají na tlačítka bez jakékoli logiky. Za třetí, uživatel může být hluboce na omylu ve svých závěrech. Výrazným příkladem z naší praxe je implementace klasifikátoru , velmi vtipného typu spamu, kdy se uživateli nabízí, aby si vyzvedl několik milionů dolarů od náhle nalezeného vzdáleného příbuzného v Africe. Po zavedení tohoto klasifikátoru jsme zkontrolovali kliknutí na "Není spam" u těchto e-mailů a ukázalo se, že 80 % z nich je šťavnatý nigerský spam, což naznačuje, že uživatelé mohou být extrémně důvěřiví.
A nezapomínejme, že na tlačítka mohou klepat nejen lidé, ale i různé boty, které se vydávají za prohlížeč. Takže surová zpětná vazba není vhodná pro učení. Co se s těmito informacemi dá dělat?
Používáme dva přístupy:
- Zpětná vazba ze spojeného ML. Například máme online systém proti botům, který, jak už jsem zmínil, přijímá rychlá rozhodnutí na základě omezeného množství rysů. A máme druhý, pomalejší systém, který pracuje ex post. Ten má více dat o uživateli, jeho chování atd. V důsledku toho se přijímá nejvíce uvážené rozhodnutí, takže má vyšší přesnost a úplnost. Rozdíl v činnosti těchto systémů lze použít jako data pro učení pro první. Takto se jednodušší systém vždy pokusí přiblížit výkonu složitějšího.
- Klasifikace kliků. Můžeme jednoduše klasifikovat každý klik uživatele, hodnotit jeho platnost a možnost využití. Takto pracujeme v antispamu pro e-maily, používáme znaky uživatele, jeho historii, charakteristiky odesílatele, samotný text a výsledek práce klasifikátorů. Nakonec získáváme automatický systém, který validuje zpětnou vazbu od uživatelů. A protože ho musíme přeučovat podstatně méně často, může se jeho práce stát základem pro všechny ostatní systémy. Hlavním prioritou v tomto modelu je precision, protože trénink modelu na nepřesných datech může mít závažné následky.
Zatímco čistí data a přeučujeme naše ML systémy, nesmíme zapomínat na uživatele, neboť pro nás jsou tisíce a miliony chyb na grafu statistikou, ale pro uživatele je každá chyba tragédií. Kromě toho, že uživatel musí nějak žít s vaší chybou v produktu, po zpětné vazbě očekává, že podobná situace se v budoucnu nevyskytně. Proto je vždy dobré dávat uživatelům nejen možnost hlasovat, ale také upravit chování ML systémů, například vytvářením osobních heuristik na každý klik zpětné vazby, v případě e-mailu by to mohla být možnost filtrovat podobné e-maily podle odesílatele a předmětu pro tohoto uživatele.
Také je potřeba na základě nějakých reportů nebo kontaktů se supportem polovičně automatizovaně nebo ručně vylepšovat model, aby jiní uživatelé netrpěli podobnými problémy.
Heuristiky pro učení
S těmito heuristikami a úpravami jsou dvě problémy. První spočívá v tom, že stále rostoucí počet úprav je těžké udržovat, nemluvě o jejich kvalitě a funkčnosti na delší vzdálenost. Druhý problém spočívá v tom, že chyba nemusí být častá a pár kliknutí pro přeučení modelu může být nedostatečné. Zdálo by se, že tyto dva nesouvisející jevy lze výrazně minimalizovat, pokud použijeme následující přístup.
- Vytvoříme dočasnou úpravu.
- Směřujeme údaje z ní do modelu, který se pravidelně přeučuje, včetně získaných dat. Zde je samozřejmě důležité, aby heuristika měla vysokou přesnost, aby nedocházelo ke zhoršení kvality dat v tréninkové sadě.
- Poté nastavíme monitorování na aktivaci workaroundu a pokud po nějakém čase workaround již nebude aktivován a plně bude pokryt modelem, můžeme jej bez obav odstranit. Tato problém se pravděpodobně neobjeví znovu.
Takže armáda workaroundů je velmi užitečná. Hlavní je, aby jejich použití bylo dočasné, a ne trvalé.
Další školení
Další školení je proces přidávání nových dat získaných na základě zpětné vazby od uživatelů či jiných systémů a školení stávajícího modelu na těchto datech. U dalšího školení může nastat několik problémů:
- Model může jednoduše nepodporovat další školení a učit se pouze od nuly.
- Někde v knize přírody není napsáno, že další školení nutně zlepší kvalitu práce v produkci. Často se stává pravý opak, tj. je možné pouze zhoršení.
- Změny mohou být nepředvídatelné. To je celkem jemný bod, který jsme si uvědomili. I když nová model v A/B testu vykazuje podobné výsledky jako současný, to ještě neznamená, že bude fungovat identicky. Jejich činnost se může lišit v nějakém jednom procentu, které může přinést nové chyby nebo vrátit již opravené staré. Se stávajícími chybami si jak my, tak uživatelé již umíme poradit, a když se objeví velké množství nových chyb, uživatel také nemusí chápat, co se děje, protože očekává předvídatelné chování.
Proto je nejdůležitější v dalším školení zaručeně zlepšit model, nebo alespoň nezhoršovat jej.
První, co mě napadne, když hovoříme o dalším školení, je přístup Aktivní učení. Co to znamená? Například klasifikátor určuje, zda zpráva patří do financí, a kolem jeho hranice rozhodování přidáváme vzorek označených příkladů. To dobře funguje například v reklamě, kde je zpětné vazby velmi mnoho a model lze školit v reálném čase. A pokud je zpětné vazby málo, pak dostáváme silně zkreslený vzorek ve srovnání s produkčním rozdělením dat, na základě kterého nelze posoudit chování modelu v průběhu provozu.
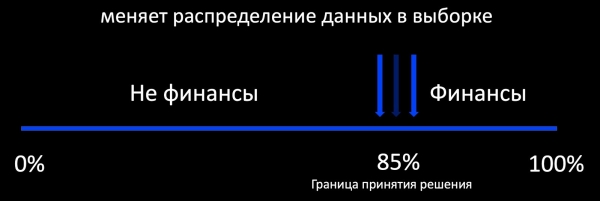
Naším skutečným cílem je zachovat staré vzory, již známé modely, a získat nové. Důležitá je kontinuita. Model, který jsme často s velkými obtížemi uvedli do provozu, už funguje, takže se můžeme orientovat na jeho výkon.
V poštovní službě se používají různé modely: stromy, lineární modely, neuronové sítě. Pro každý vytváříme svůj vlastní algoritmus pro další učení. V procesu dalšího učení získáváme nejen nové údaje, ale často také nové znaky, které zohledníme ve všech níže uvedených algoritmech.
Lineární modely
Představme si, že máme logistickou regresi. Sestavujeme ztrátu modelu z následujících komponent:
- LogLoss na nových údajích;
- pravidelně upravujeme váhy nových znaků (staré neměníme);
- učíme se i na starých údajích, abychom zachovali staré vzory;
- a, možná nejdůležitější: zavádíme Harmonic Regularization, která zaručuje, že váhy se относительно starého modelu příliš nezmění.
Jelikož má každá komponenta Loss své koeficienty, můžeme nalézt optimální hodnoty pro naši úlohu na kros-validaci nebo na základě produktových požadavků.
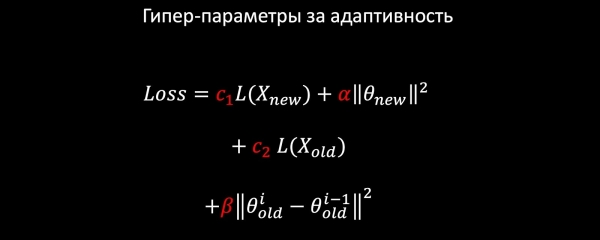
Stromy
Přejdeme k rozhodovacím stromům. Vytvořili jsme následující algoritmus pro další učení stromů:
- Na produkci pracuje les 100—300 stromů, který byl обучен na starém datovém souboru.
- Na konci odstraníme M = 5 kusů a přidáme 2M = 10 nových, které byly učené na celém datovém souboru, ale s vysokou váhou na nových údajích, což přirozeně zaručuje inkrementální změnu modelu.
Je zřejmé, že s časem se počet stromů značně zvyšuje, a je nutné je pravidelně zmenšovat, aby se vešly do časových rámců. K tomu používáme všudypřítomnou nyní Knowledge Distillation (KD). Krátce o principu jeho fungování.
- Máme aktuální „komplexní“ model. Spustíme ho na tréninkovém datovém souboru a získáme rozdělení pravděpodobností tříd na výstupu.
- Dále učíme model-žáka (model s menším počtem stromů v tomto případě), aby opakoval výsledky práce modelu, používajíc rozdělení tříd jako cílovou proměnnou.
- Je důležité poznamenat, že nikterak nevyužíváme strukturu datové sady, a proto můžeme použít libovolná data. Samozřejmě používáme vzorek dat z produkčního toku jako tréninkovou sadu pro model studenta. Tímto způsobem nám tréninková sada umožňuje zajistit přesnost modelu, zatímco vzorek toku zaručuje podobný výkon na produkčním rozdělení, kompenzujíc odchylku tréninkové sady.
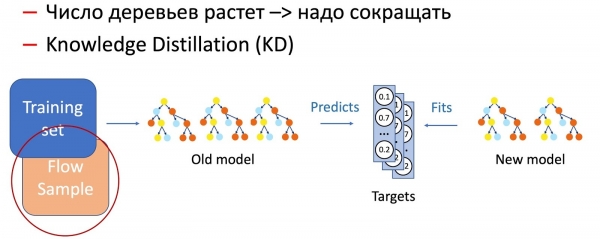
Kombinace těchto dvou metodik (přidání stromů a periodické zmenšování jejich počtu pomocí Knowledge Distillation) zajišťuje zavedení nových vzorců a plnou kontinuitu.
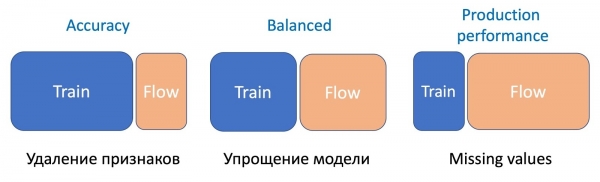
Pomocí KD také provádíme rozdílné operace s rysy modelu, například odstranění rysů a práci s chybějícími hodnotami. V našem případě máme řadu důležitých statistických rysů (podle odesílatelů, textových hashů, URL atd.), které jsou uloženy v databázi, jež má tendenci selhávat. Takovému vývoji událostí model samozřejmě není připraven, protože v tréninkové sadě nenastávají situace selhání. V podobných případech kombinujeme techniky KD a augmentace: během trénování pro část dat odstraňujeme nebo nulujeme potřebné rysy, zatímco značky (výstupy aktuálního modelu) bereme původní, model student se učí opakovat toto rozložení.
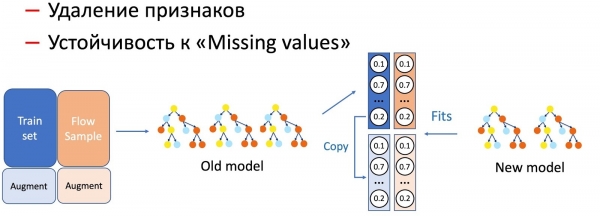
Všimli jsme si, že čím vážnější manipulace s modely probíhá, tím větší procento vzorku toku je potřeba.
Pro odstranění rysů, což je nejjednodušší operace, stačí jen malá část toku, protože se mění jen pár rysů, a současný model se učil na stejné sadě — rozdíl je minimální. Pro zjednodušení modelu (snížení počtu stromů několikrát) je už třeba 50 na 50. A na chybějící důležité statistické rysy, které vážně ovlivňují výkon modelu, je potřeba ještě více toku, aby byla vyvážena práce nového modelu odolného vůči chybějícím údajům na všech typech e-mailů.
FastText
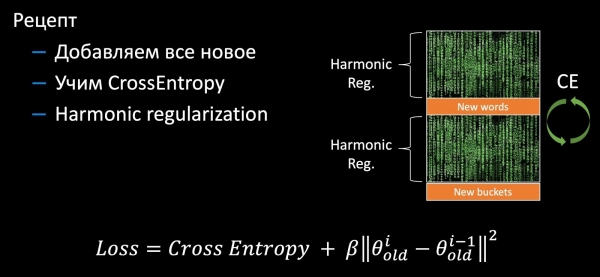
Přejděme k FastText. Připomínám, že reprezentace (Embedding) slova se skládá ze součtu embeddingu samotného slova a všech jeho písmenových N-gram, obvykle trigramů. Vzhledem k tomu, že trigramů může být poměrně hodně, používá se Bucket Hashing, tedy transformace celého prostoru do nějaké fixní hash mapy. Výsledkem je matice vah o rozměrech vnitřní vrstvy na počet slov + bucketů.
Při doladění se objevují nové rysy: slova a trigramy. V běžném doladění od Facebooku nedochází k ničemu zásadnímu. Doladí se pouze staré váhy s kros-entropií na nových datech. Nové rysy tedy nejsou využívány, tento přístup má samozřejmě všechny výše popsané nevýhody spojené s nepředvídatelností modelu v produkci. Proto jsme trochu upravili FastText. Přidáváme všechny nové váhy (slova a trigramy), doladíme celou matici s kros-entropií a přidáváme harmonickou regularizaci analogicky k lineárnímu modeli, která zajišťuje nevýznamnou změnu starých vah.
CNN
Se spletitými sítěmi je to o něco složitější. Pokud se v CNN doladí poslední vrstvy, lze samozřejmě použít harmonickou regularizaci a zajistit kontinuitu. Pokud však vyžaduje doladění celé sítě, tuto regularizaci již nelze aplikovat na všechny vrstvy. Existuje však možnost trénování komplementárních embeddingů pomocí Triplet Loss ().
Triplet Loss
Na příkladu úkolu anti-fishing rozebráme obecně Triplet Loss. Bereme naše logo a pozitivní a negativní příklady loga jiných společností. Minimalizujeme vzdálenost mezi prvními a maximalizujeme vzdálenost mezi druhými, děláme to s malým odstupem, abychom zajistili větší kompaktnost tříd.
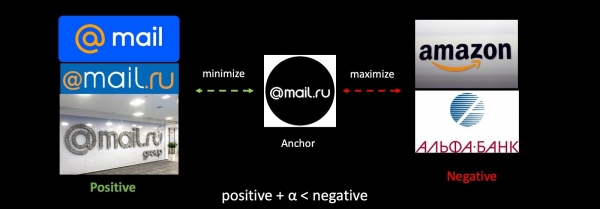
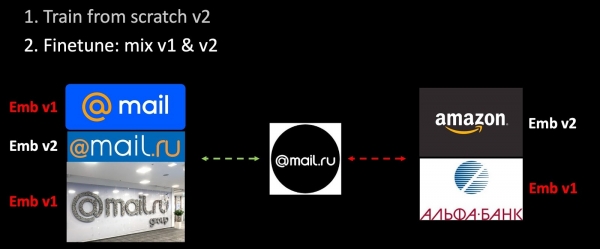
Pokud doladíme síť, mění se nám zcela metrický prostor a stává se absolutně neslučitelným s předchozím. To je vážný problém v úlohách používajících vektory. Abychom tento problém obeznuli, budeme během trénování mixovat staré embeddingy.
Přidali jsme nová data do tréninkové sady a znovu trénujeme druhou verzi modelu. V druhé fázi naši síť dotrénováváme (finetuning): nejprve se dotrénovává poslední vrstva, poté se odemyká celá síť. Při sestavování trojic počítáme pouze část embeddingů pomocí trénovatelného modelu, ostatní pomocí starého. Tímto způsobem během dotrénování zajišťujeme kompatibilitu metrických prostorů v1 a v2. Je to jakási forma harmonické regularizace.
Architektura jako celek
Pokud se podíváme na celý systém na příkladu antispamu, modely nejsou izolované, ale vzájemně do sebe zapadají. Bereme obrázky, text a další znaky, pomocí CNN a Fast Text získáváme embeddings. Následně se na embeddingy aplikují klasifikátory, které poskytují skóre pro různé třídy (typy zpráv, spam, přítomnost loga). Skóre a znaky už vstupují do lesa stromů pro konečné rozhodování. Oddělené klasifikátory v tomto schématu umožňují lépe interpretovat výsledky práce systému a cíleněji dotrénovávat komponenty v případě problémů, spíše než poskytovat všechna data do rozhodovacích stromů v surové podobě.
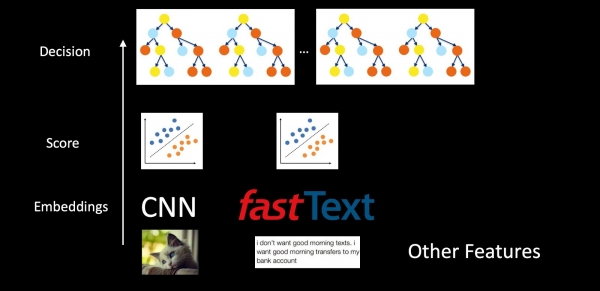
V konečném důsledku zajišťujeme kontinuitu na každé úrovni. Na dolní úrovni v CNN a Fast Text používáme harmonickou regularizaci, pro klasifikátory uprostřed také harmonickou regularizaci a kalibraci skóre pro kompatibilitu rozdělení pravděpodobnosti. No a boostování stromů se trénuje inkrementálně nebo pomocí Knowledge Distillation.
Obecně podpora takového vnořeného systému strojového učení obvykle představuje problém, protože jakákoli součást na dolní úrovni vede k aktualizaci celého systému výše. Ale protože v našem nastavení se každá součást mění jen nepatrně a je kompatibilní s předchozím, může se celý systém aktualizovat po částech, aniž by bylo nutné znovu učit celou strukturu, což umožňuje udržovat ji bez vážného překročení nákladů.
Nasazení
Rozebrali jsme shromažďování dat a dotrénovávání různých typů modelů, nyní přecházíme k jejich nasazení do produkčního prostředí.
A/B testování
Jak jsem již zmínil dříve, při shromažďování dat obvykle získáváme zkreslený vzorek, na jehož základě nelze posoudit výkon modelu v produkci. Proto je při nasazení modelu nezbytné porovnat ho s předchozí verzí, abychom viděli, jak to skutečně vypadá, tedy provádět A/B testy. Ve skutečnosti je proces zavádění a analýzy grafů poměrně rutinní a je skvěle automatizovatelný. Naše modely nasazujeme postupně na 5 %, 30 %, 50 % a nakonec na 100 % uživatelů, přičemž shromažďujeme všechny dostupné metriky týkající se odezvy modelu a zpětné vazby od uživatelů. V případě nějakých závažných výkyvů model automaticky vracíme zpět, a v ostatních případech, po získání dostatečného počtu kliknutí od uživatelů, rozhodujeme o zvýšení procenta. Nakonec dostáváme nový model až na 50 % uživatelů úplně automaticky, a schválení nasazení celé publikum provádí člověk, i když tento krok lze také automatizovat.
Avšak proces A/B testování poskytuje prostor pro optimalizaci. Skutečnost je taková, že jakýkoli A/B test je dost dlouhý (v našem případě trvá od 6 do 24 hodin v závislosti na množství zpětné vazby), což jej činí poměrně nákladným a s omezenými zdroji. Kromě toho je potřeba dostatečně vysoké procento toku pro test, aby se v podstatě urychlil celkový čas A/B testu (získání statisticky významného vzorku pro hodnocení metrik na malém procentu může zabrat velmi dlouho), což činí počet A/B slotů velmi omezeným. Je jasné, že musíme do testu zařadit pouze ty nejperspektivnější modely, kterých v průběhu doladění získáváme opravdu hodně.
Pro řešení tohoto úkolu jsme vyškolili samostatný klasifikátor, který předpovídá úspěšnost A/B testu. Jako charakteristiky používáme statistiku rozhodování, Precision, Recall a další metriky na trénovací množině, na oddělené a na vzorku z toku. Dále srovnáváme model s aktuálním modelem v produkci, s heuristikami, a zohledňujeme složitost modelu. Použitím všech těchto charakteristik klasifikátor vyškolený na historii testů hodnotí kandidátské modely, v našem případě jsou to lesy stromů, a rozhoduje, který z nich pustit do A/B testu.
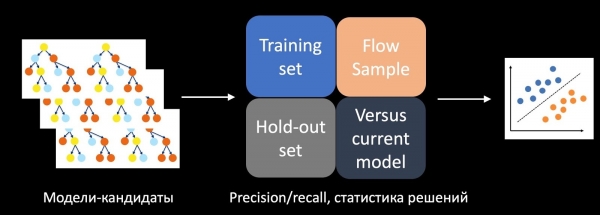
Při implementaci tento přístup výrazně zvýšil počet úspěšných A/B testů.
Testování & monitoring
Testování a monitoring, jak podivné se to může zdát, neškodí našemu zdraví, naopak, zlepšují ho a zbavují zbytečného stresu. Testování pomáhá předejít chybám, zatímco monitoring umožňuje včasné odhalení problémů, aby se minimalizoval jejich dopad na uživatele.
Je důležité si uvědomit, že dříve či později dojde k chybě ve vaší systému — je to spojeno s cyklem vývoje jakéhokoli softwaru. Na začátku vývoje systému se často vyskytuje mnoho chyb, dokud se vše neusadí a nezavršují se hlavní fáze inovací. Ale časem entropie znovu udeří a objevují se chyby — v důsledku degradace komponent a změn dat, o kterých jsem se zmínil na začátku.
Rád bych zde zdůraznil, že jakýkoli systém strojového učení je třeba posuzovat z pohledu jeho přínosu během celého životního cyklu. Níže na grafu je příklad činnosti systému, který detekuje vzácný typ spamu (na grafu čára blízko nuly). Jednou vinou špatně кешovaného znaku se systém dostal do potíží. Bohužel nebylo monitorování na anomální chování, a tak systém začal ukládat e-maily do složky „spam“ na hranici rozhodování v obrovském množství. I když byly následky napraveny, systém se již tolikrát zmýlil, že se nevyplatí ani za pět let. A to je kompletní propadák z pohledu životního cyklu modelu.
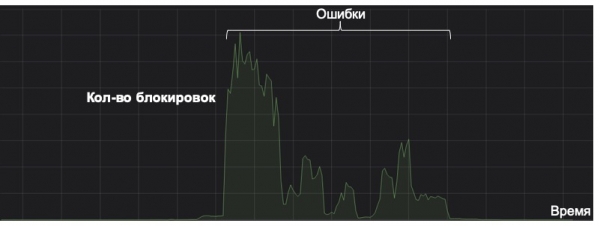
Proto může být taková jednoduchá věc jako monitoring klíčová pro život modelu. Kromě standardních a očividných metrik sledujeme rozložení odpovědí a skóre modelu, stejně jako rozložení hodnot klíčových znaků. Pomocí KL divergence můžeme porovnávat aktuální rozložení s historickým nebo hodnoty z A/B testu s ostatním proudem, což nám umožňuje odhalovat anomálie v modelu a včas vracet změny.
Většinou spouštíme naše první verze systémů pomocí jednoduchých heuristik nebo modelů, které později používáme k monitorování. Například monitorujeme NER model ve srovnání s regulárními výrazy pro konkrétní internetové obchody, a pokud pokrytí klasifikátoru klesá v porovnání s nimi, zabýváme se příčinami. Je to další užitečné využití heuristik!
Závěry
Pojďme si ještě jednou projít klíčové myšlenky článku.
- Fibdék. Vždy myslíme na uživatele: jak bude žít s našimi chybami, jak nám je může oznámit. Nezapomínejme, že uživatelé nejsou zdrojem čisté zpětné vazby pro učení modelů, a je nutné ji filtrovat pomocí pomocných ML systémů. Pokud není možné získat signál od uživatele, hledáme alternativní zdroje zpětné vazby, například související systémy.
- Další školení. Hlavní věcí je zde kontinuita, proto se opíráme o současný produkční model. Nové modely vyvíjíme tak, aby se příliš nelišily od předchozího modelu díky harmonické regularizaci a podobným trikům.
- Nasazení. Autodeploy na základě metrik výrazně zkracuje čas potřebný na nasazení modelů. Monitoring statistik a rozdělení rozhodování, počet falešných pozitiv od uživatelů je nezbytný pro váš klidný spánek a produktivní víkendy.
Doufám, že to, co jste si přečetli, vám pomůže rychleji zlepšovat vaše ML systémy, urychlit jejich uvedení na trh a učinit je spolehlivějšími, čímž snížíte stres z práce.
Zdroj: habr.com
