

Jak je známo, společnost SAP nabízí kompletní spektrum softwaru jak pro správu transakčních dat, tak pro zpracování těchto dat v analytických a reportovacích systémech. Konkrétně platforma SAP Business Warehouse (SAP BW) představuje nástroj pro ukládání a analýzu dat, disponující širokými technickými možnostmi. I přes všechny své objektivní výhody má systém SAP BW jednu výraznou nevýhodu. A to jsou vysoké náklady na ukládání a zpracování dat, které jsou obzvlášť patrné při používání cloudové služby SAP BW on Hana.
A co kdybychom jako úložiště začali používat nějaký non-SAP a ideálně OpenSource produkt? My v X5 Retail Group jsme se rozhodli pro GreenPlum. To samozřejmě vyřeší otázku nákladů, ale okamžitě se objevují otázky, které byly při používání SAP BW prakticky defaultně vyřešeny.
Konkrétně, jakým způsobem získávat data z zdrojových systémů, které jsou většinou řešeními SAP?
"HR-metriky" se stal prvním projektem, ve kterém bylo nutné tuto problematiku vyřešit. Naším cílem bylo vytvoření úložiště HR dat a sestavení analytických reportů v oblasti práce se zaměstnanci. Hlavním zdrojem dat je přitom transakční systém SAP HCM, ve kterém jsou zaznamenány veškeré personální, organizační a mzdové aktivity.
Extrakce dat
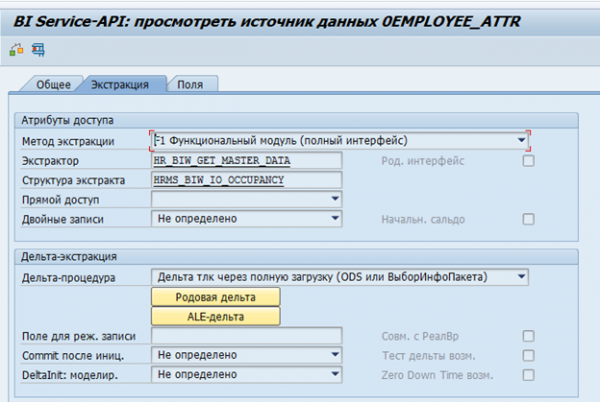
V SAP BW existují standardní extraktory dat pro SAP systémy. Tyto extraktory mohou automaticky shromažďovat potřebná data, sledovat jejich integritu a definovat delty změn. Například standardní zdroj dat pro atributy zaměstnance 0EMPLOYEE_ATTR:
Výsledek extrakce dat z něj pro jednoho zaměstnance:
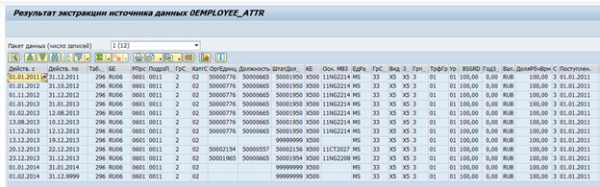
V případě potřeby může být takový extraktor modifikován podle vlastních požadavků nebo může být vytvořen vlastní extraktor.
První myšlenka byla na možnost jejich opětovného využití. Bohužel se ukázalo, že to byla nerealizovatelná úloha. Velká část logiky byla realizována na straně SAP BW a bezproblémově oddělit extraktor na zdroji od SAP BW se nepodařilo.
Stalo se zřejmým, že bude třeba vyvinout vlastní mechanismus pro extrakci dat z SAP systémů.
Struktura ukládání dat v SAP HCM
Aby porozumieć się z wymaganiami dotyczącego tego mechanizmu, najpierw musimy określić, jakie dane będą nam potrzebne.
Większość danych w SAP HCM jest przechowywana w płaskich tabelach SQL. Na podstawie tych danych aplikacje SAP wizualizują struktury organizacyjne, pracowników i inne informacje HR. Na przykład, tak wygląda struktura organizacyjna w SAP HCM:
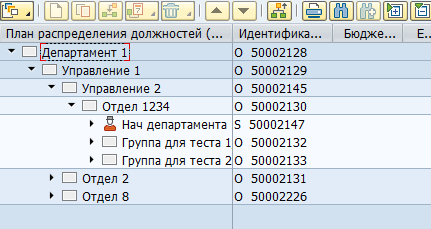
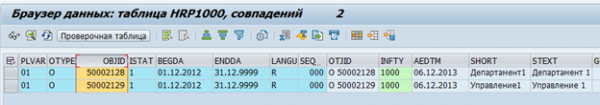
Fizycznie takie drzewo jest przechowywane w dwóch tabelach — w hrp1000 obiekty i w hrp1001 powiązania między tymi obiektami.
Obiekty „Departament 1” i „Zarząd 1”:
Powiązanie między obiektami:
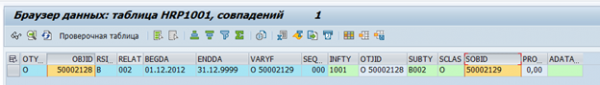
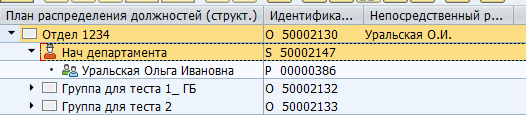
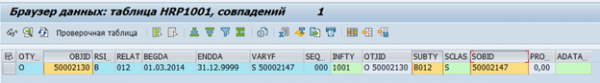
Może istnieć ogromna liczba zarówno typów obiektów, jak i typów powiązań między nimi. Istnieją standardowe powiązania między obiektami oraz dostosowane do specyficznych potrzeb. Na przykład, standardowe powiązanie B012 między jednostką organizacyjną a stanowiskiem wskazuje na kierownika działu.
Wyświetlanie kierownika w SAP:
Przechowywanie w tabeli bazy danych:
Dane o pracownikach są przechowywane w tabelach pa*. Na przykład, dane o wydarzeniach kadrowych dla pracownika są przechowywane w tabeli pa0000.
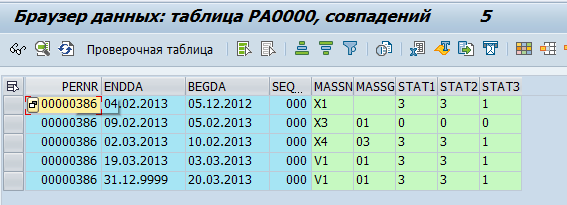
Zdecydowaliśmy, że GreenPlum będzie pobierał „surowe” dane, tzn. po prostu je kopiować z tabel SAP. Następnie w GreenPlum będą one przetwarzane i przekształcane w obiekty fizyczne (np. Dział lub Pracownik) oraz metryki (np. średnie zatrudnienie).
Określono około 70 tabel, których dane muszą zostać przekazane do GreenPlum. Po tym przystąpiliśmy do opracowania metody przesyłania tych danych.
SAP oferuje wiele mechanizmów integracji. Jednak najprostszy sposób — bezpośredni dostęp do bazy danych jest zabroniony z powodu ograniczeń licencyjnych. W związku z tym wszystkie strumienie integracyjne muszą być realizowane na poziomie serveru aplikacji.
Kolejnym problemem był brak danych o usuniętych zapisach w bazie danych SAP. Po usunięciu wiersza w bazie danych zostaje on usunięty fizycznie. Tzn. nie było możliwości utworzenia różnicy zmian w czasie zmian.
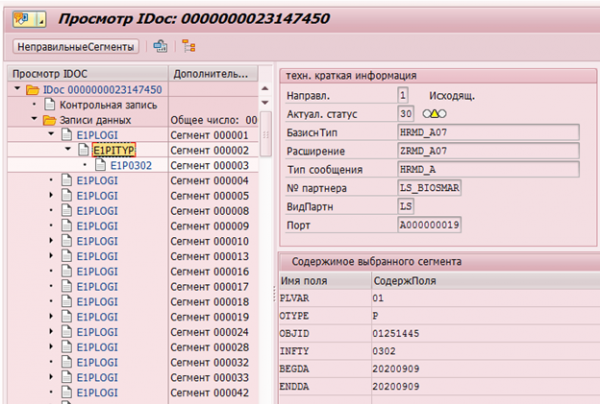
Oczywiście, w SAP HCM istnieją mechanizmy rejestracji zmian danych. Na przykład, aby móc je potem przesłać do systemów odbiorców, istnieją wskaźniki zmian (change pointer), które rejestrują wszelkie zmiany i na ich podstawie tworzone są Idoc (obiekt do przesyłania do systemów zewnętrznych).
Příklad změny infotypu 0302 u zaměstnance s evidenčním číslem 1251445:
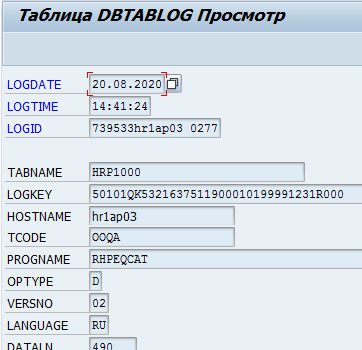
Nebo vedení logů změn dat v tabulce DBTABLOG.
Příklad logu odstranění záznamu s klíčem QK53216375 z tabulky hrp1000:
Tyto mechanismy však nejsou dostupné pro všechna potřebná data a jejich zpracování na úrovni aplikačního serveru může spotřebovat značné množství zdrojů. Hromadné zapnutí logování na všechny nezbytné tabulky může proto vést k výraznému snížení výkonu systému.
Dalším vážným problémem byly klastrové tabulky. Data ohledně odhadu času a výpočtu mezd v RDBMS verzi SAP HCM jsou uchovávána jako soubor logických tabulek pro každého zaměstnance za každé vyúčtování. Tyto logické tabulky jsou ve formě binárních dat uchovávány v tabulce pcl2.
Klastr pro výpočet mezd:
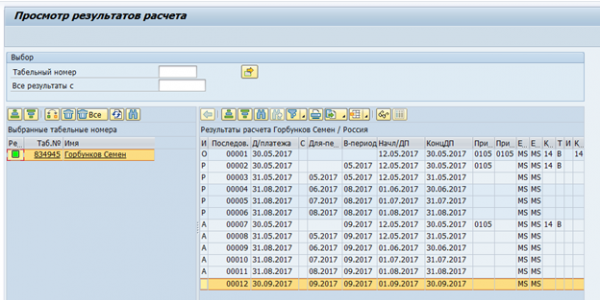
Data z klastrových tabulek nelze číst pomocí SQL příkazu, ale je potřeba použít makro příkazy SAP HCM nebo speciální funkční moduly. Odpovídajícím způsobem bude rychlost čtení těchto tabulek poměrně nízká. Na druhou stranu, v těchto klastrech jsou uchovávána data, která jsou potřebná pouze jednou za měsíc – konečný výpočet mezd a odhad času. Takže rychlost v tomto případě není tak kritická.
Při hodnocení možností s vytvořením delta změny dat jsme se rozhodli také prozkoumat možnost plného výstupu. Varianta denně předávat gigabajty neměnných dat mezi systémy není optimální. Nicméně má i řadu výhod – není třeba realizace delta na straně zdroje, ani realizace integrace této delty na straně příjemce. Tím se snižují náklady a doba realizace a zvyšuje se spolehlivost integrace. Bylo také určeno, že prakticky všechny změny v SAP HR se dějí v horizontu tří měsíců před aktuálním datem. Bylo tedy rozhodnuto zastavit se na denním plném výstupu dat z SAP HR za N měsíců do aktuálního data a na měsíčním plném výstupu. Parametr N se liší podle konkrétní tabulky.
a pohybuje se od 1 do 15.
Pro extrakci dat byla navržena následující schéma:
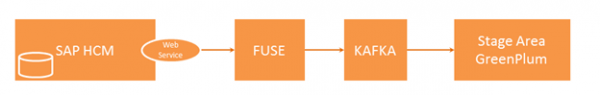
Externí systém vytváří dotaz a odesílá ho do SAP HCM, kde je tento dotaz kontrolován na úplnost dat a oprávnění pro přístup k tabulkám. V případě úspěšné kontroly v SAP HCM probíhá program, který shromažďuje potřebná data a předává je do integračního řešení Fuse. Fuse určuje potřebné téma v Kafka a předává data tam. Následně jsou data z Kafka předávána do Stage Area GP.
V této řetězci nás zajímá otázka extrakce dat z SAP HCM. Podívejme se na něj podrobněji.
Schéma interakce SAP HCM-FUSE.
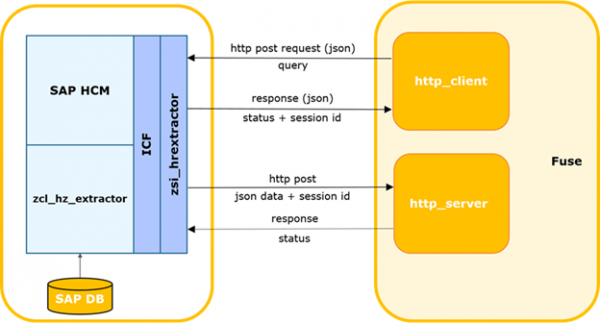
Externí systém určuje čas posledního úspěšného dotazu v SAP.
Proces může být spuštěn podle časovače nebo jiného události, včetně možnosti nastavení časového limitu pro čekání na odpověď s daty od SAP a iniciaci opakovaného dotazu. Následně vytvoří dotaz delta a odešle ho do SAP.
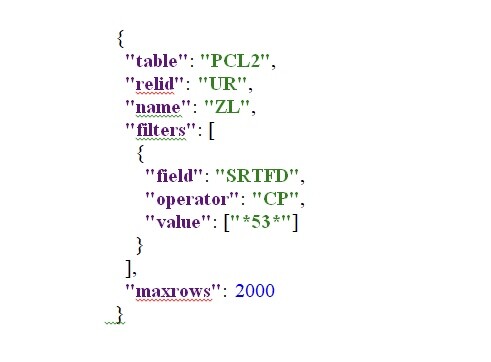
Data dotazu jsou předávána v těle ve formátu json.
Metoda http: POST.
Příklad dotazu:
Služba SAP provádí kontrolu dotazu na úplnost, shodu se současnou strukturou SAP a existenci přístupového oprávnění k požadované tabulce.
V případě chyb služba vrací odpověď s odpovídajícím kódem a popisem. V případě úspěšné kontroly vytváří pozadí proces pro formování výběru, generuje a synchronně vrací unikátní id relace.
Externí systém v případě chyby registruje tuto chybu do protokolu. V případě úspěšné odpovědi předává id relace a název tabulky, na kterou byl proveden dotaz.
Externí systém registruje aktuální relaci jako otevřenou. Pokud existují jiné relace k této tabulce, budou uzavřeny s registrací varování v protokolu.
Pozadí úkolu SAP vytváří kurzor podle zadaných parametrů a balík dat o zadané velikosti. Velikost balíku – maximální počet záznamů, které proces čte z databáze. Standardně je nastaven na 2000. Pokud je ve výběru databáze více záznamů, než je použitá velikost balíku, po předání prvního balíku se vytvoří další blok se správným offsetem a inkrementovaným číslem balíku. Čísla jsou inkrementována o 1 a odesílána striktně sekvenčně.
Dále systém SAP předává balíček do vstupu webové služby externího systému. Tento systém provádí kontroly přicházejícího balíčku. V systému musí být registrována relace s přijatým ID a musí být ve stavu otevřeno. Pokud je číslo balíčku > 1, musí v systému být registrováno úspěšné přijetí předchozího balíčku (package_id-1).
V případě úspěšné kontroly externí systém parsuje a ukládá data tabulky.
Dále, pokud je v balíčku přítomen příznak final a serializace proběhla úspěšně, dochází k upozornění integračního modulu o úspěšném dokončení zpracování relace a modul aktualizuje stav relace.
V případě chyby kontrol nebo parsování je chyba zaznamenána a balíčky pro tuto relaci budou zamítnuty externím systémem.
Také v opačném případě, kdy externí systém vrátí chybu, je tato chyba zaznamenána a přenos balíčků je zastaven.
Pro požadavek na data na straně SAP HCM byl realizován integrační servis. Servis je realizován na rámci ICF (SAP Internet Communication Framework — ). Umožňuje provádět požadavek na data ze systému SAP HCM podle konkrétních tabulek. Při formování požadavku na data je možné zadat seznam konkrétních polí a parametry filtrování s cílem získat požadovaná data. Realizace servisu nenahrazuje žádnou obchodní logiku. Algoritmy výpočtu delta, parametrů požadavku, kontroly integrity atd. jsou také realizovány na straně externího systému.
Tento mechanismus umožňuje shromažďovat a předávat všechna potřebná data během několika hodin. Tato rychlost je na hranici akceptovatelnosti, proto tuto metodu považujeme za dočasné řešení, které umožnilo uzavřít poptávku po nástroji pro extrakci v projektu.
V cílovém modelu pro řešení úkolu extrakce dat se zkoumají možnosti využití systémů CDC jako Oracle Golden Gate nebo ETL nástrojů jako SAP DS.
Zdroj: habr.com
