

Dnes většina softwarových produktů vzniká v týmech. Podmínky úspěšného týmového vývoje lze představit jako jednoduché schéma.
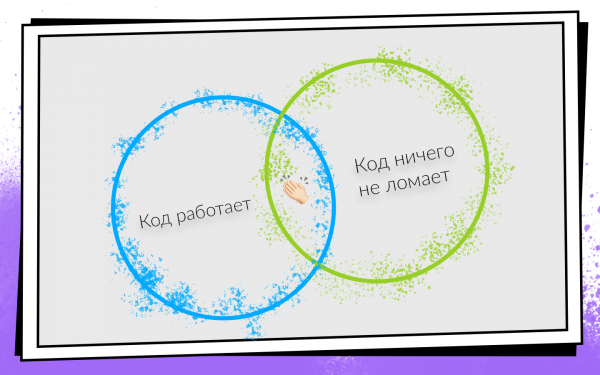
Po napsání kódu se musíte ujistit, že:
- Funguje.
- Nic neporušuje, včetně kódu, který napsali vaši kolegové.
Pokud obě podmínky platí, jste na cestě k úspěchu. Aby bylo možné tyto podmínky snadno kontrolovat a nesklouznout z výhodné cesty, vymysleli Continuous Integration.
CI je pracovní proces, při kterém co nejčastěji integrujete svůj kód do celkového kódu produktu. A nezapojujete jej jen tak, ale také neustále kontrolujete, že vše funguje. Protože je třeba kontrolovat mnoho věcí a často, stojí za to přemýšlet o automatizaci. Můžete vše kontrolovat ručně, ale to se nevyplatí, a zde je proč.
- Lidé jsou cenní. Hodina práce jakéhokoliv programátora stojí více než hodina práce jakéhokoliv serveru.
- Lidé dělají chyby. Proto mohou nastat situace, kdy byly spuštěny testy na nesprávné větvi nebo byl sestaven nesprávný commit pro testery.
- Lidé jsou líní. Občas, když dokončuji nějaký úkol, mi probleskne hlavou myšlenka: „Co tu kontrolovat? Napsal jsem dvě řádky — určitě to funguje!“ Myslím, že někteří z vás tyto myšlenky také občas mají. Ale kontrolovat je třeba vždy.
Jak implementovali a rozvíjeli Continuous Integration v týmu mobilního vývoje Avito, jak došli od 0 do 450 sestavení denně, a co buildovací stroje sestavují 200 hodin denně, popisuje Nikolaj Nesterov () — účastník všech evolučních změn CI/CD Android aplikace.
Příběh je postaven na příkladu Android týmu, ale většina přístupů je použitelná i na iOS.
Kdysi dávno v Android týmu Avito pracoval jeden člověk. Z definice nepotřeboval nic z Continuous Integration: neměl s kým se integrovat.
Ale aplikace rostla, objevovalo se stále více a více nových úkolů, a logicky rostl tým. V určitém okamžiku nastal čas formalizovat proces integrace kódu. Bylo rozhodnuto použít Git flow.
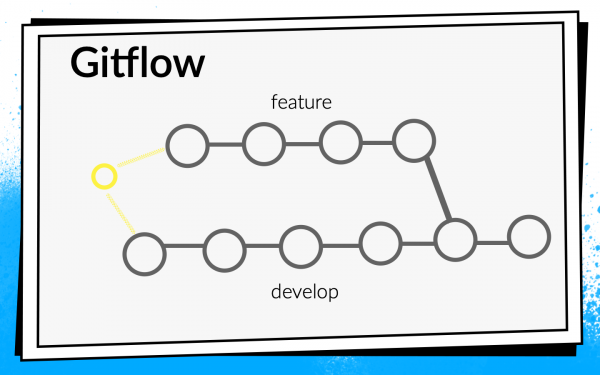
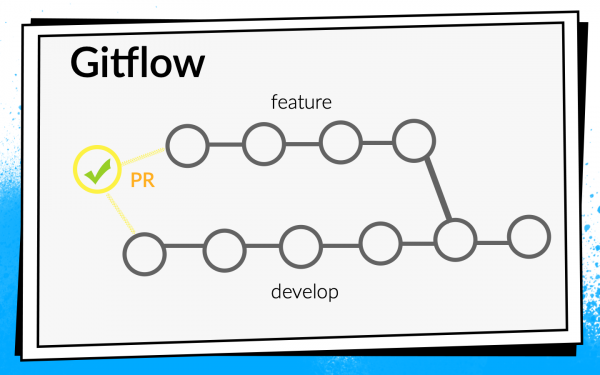
Koncept Git flow je známý: v projektu existuje jediné společné odvětví develop, a pro každou novou funkci si vývojáři odejmou samostatnou větev, do které provedou commit, push a když chtějí sloučit svůj kód do větve develop, otevřou pull request. Pro výměnu znalostí a diskusi o přístupech jsme zavedli code review, tedy kolegové musí zkontrolovat a potvrdit kód jeden druhého.
Ověření
Dívat se na kód očima je skvělé, ale nestačí to. Proto se zavádějí automatizované kontroly.
- Nejdříve ověřujeme sestavení ARC.
- Mnoho Junit testů.
- Vyhodnocujeme pokrytí kódu, když už spouštíme testy.
Abychom pochopili, jak by měly být tyto kontroly spuštěny, podíváme se na proces vývoje v Avitu.
Schématicky ho lze představit takto:
- Vývojář píše kód na svém notebooku. Kontroly integrace lze spustit přímo zde — buď commit hookem, nebo jednoduše provozovat kontroly na pozadí.
- Poté, co vývojář pushnul kód, otevře pull request. Aby se jeho kód dostal do větve develop, je nutné projít code review a získat potřebný počet potvrzení. Zde lze také zapnout kontroly a sestavení: dokud nejsou všechna sestavení úspěšná, pull request nelze sloučit.
- Jakmile je pull request sloučen a kód se dostal do developu, můžete si zvolit vhodný čas: například v noci, kdy jsou všechny servery volné, a spustit kontroly tak, jak se to hodí.
Nikdo neměl rád spouštět kontroly na svém notebooku. Když vývojář dokončil funkci, chce ji co nejrychleji pushnout a otevřít pull request. Pokud v tomto okamžiku probíhají nějaké dlouhé kontroly, není to jen nepříjemné, ale také to zpomaluje vývoj: zatímco notebook něco kontroluje, nejde na něm normálně pracovat.
Noční spouštění kontrol nám velmi vyhovovalo, protože času a serverů bylo dost, mohli jsme si užívat. Ale bohužel, když kód funkce dosáhnul developu, měl vývojář už mnohem méně motivace opravovat chyby, které našel CI. Často jsem se chytil přemýšlení, když jsem se díval do ranního reportu na všechny nalezené chyby, že je opravím někdy později, protože nyní v Jira leží skvělý nový úkol, který se tak těší na realizaci.
Pokud kontroly blokují pull request, je motivace dostatečná, protože dokud nejsou všechna sestavení úspěšná, kód se nedostane do developu, a tedy úkol nebude dokončen.
Nakonec jsme zvolili takovou strategii: v noci běžíme co nejvíce testů, a ty nejkritičtější, a co je nejdůležitější, rychlé, spouštíme na pull requestu. Ale na tom nekončíme — současně optimalizujeme rychlost spuštění testů tak, abychom je mohli převést z nočního režimu na testy na pull request.
V té době všechny naše buildy probíhaly dost rychle, takže jsme jednoduše přidali jako bloker k pull requestu build ARC, Junit testy a výpočet code coverage. Přidali jsme, zamysleli se — a vzdali jsme se code coverage, protože jsme usoudili, že ho nepotřebujeme.
Na celou konfiguraci základního CI jsme potřebovali dva dny (odtud a dále je časový odhad přibližný, potřebný pro měřítko).
Poté jsme začali přemýšlet dále — kontrolujeme správně? Spouštíme buildy na pull request správně?
Spouštěli jsme build na posledním commitu větve, ze které byl otevřen pull request. Ale kontroly tohoto commitu mohou ukázat pouze to, že kód, který napsal vývojář, funguje. Neprokazují však, že nic neporušil. Ve skutečnosti je třeba zkontrolovat stav větve develop poté, co byla funkce sloučena.
K tomu jsme napsali jednoduchý bash skript premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Zde se jednoduše načtou všechny nejnovější změny z develop a sloučí se do aktuální větve. Přidali jsme skript premerge.sh jako první krok všech buildů a začali jsme kontrolovat právě to, co chceme, tedy integraci.
Na lokalizaci problémů, hledání řešení a napsání tohoto skriptu jsme potřebovali tři dny.
Aplikace se vyvíjela, přibývalo úloh, tým rostl a premerge.sh nás občas začal zrazovat. Do develop pronikaly konfliktní změny, které porušovaly build.
Příklad toho, jak k tomu dochází:
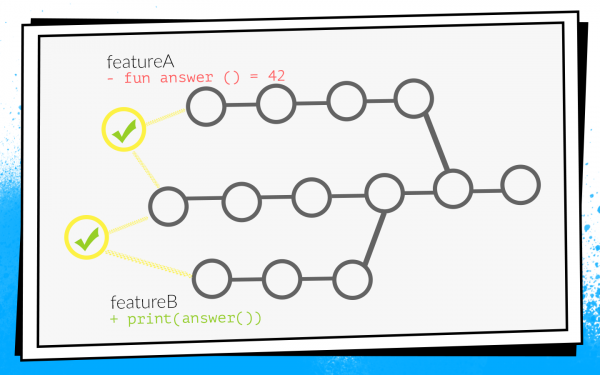
Dva vývojáři současně začnou pracovat na funkcích A a B. Vývojář funkce A objeví v projektu nepoužívanou funkci answer() a, jako dobrý skaut, ji odstraní. Přitom vývojář funkce B ve své větvi přidává nový volání této funkce.
Vývojáři dokončí práci a současně otevřou pull request. Spouští se buildy, premerge.sh kontroluje oba pull requesty vzhledem k aktuálnímu stavu develop — všechny kontroly jsou zelené. Poté se sloučí pull request funkce A, sloučí se pull request funkce B… Bum! Develop se rozbije, protože v kódu develop je volání neexistující funkce.
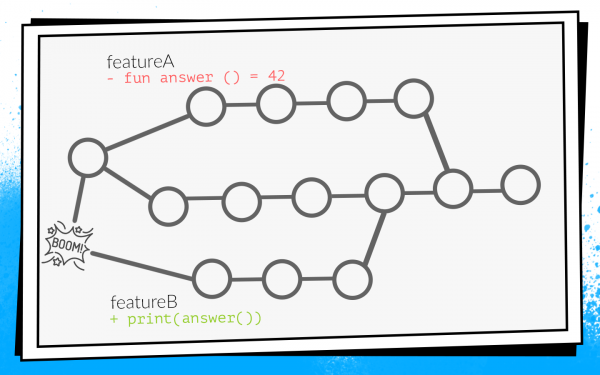
Když se develop nesloží, tohle lokální katastrofa. Celý tým nemůže nic poskládat a odeslat k testování.
Jak to tak bývá, věnoval jsem se převážně infrastrukturním úlohám: analytika, síť, databáze. To znamená, že jsem psal funkce a třídy, které používají ostatní vývojáři. Z toho důvodu jsem se velmi často ocital v podobných situacích. Dokonce jsem měl jedno období, kdy jsem měl takový obrázek.
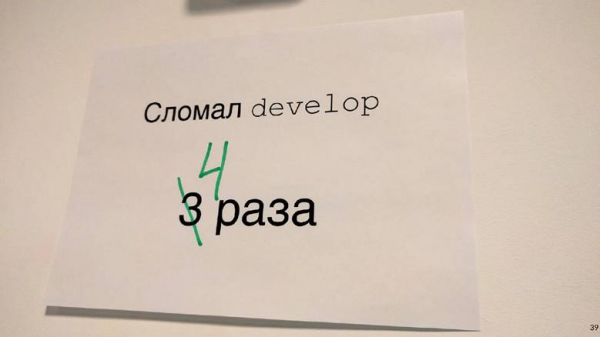
Protože nás to nevyhovovalo, začali jsme pracovat na možnostech, jak tomu zabránit.
Jak nelámat develop
První varianta: přepracovávat všechny pull requesty při aktualizaci develop. Pokud v našem příkladu bude pull request s funkcionalitou A první, který se dostane do develop, pull request funkcionality B se přepracuje a odpovídajícím způsobem zkoušky neprojdou kvůli chybě kompilace.
Abychom pochopili, kolik času to zabere, podívejme se na příklad se dvěma PR. Otevřeme dva PR: dva buildy, dvě spuštění zkoušek. Poté, co byl první PR sloučen do develop, druhý se musí přepracovat. Celkově to znamená, že na dva PR proběhne tři spuštění zkoušek: 2 + 1 = 3.
V zásadě je to v pořádku. Ale podívali jsme se na statistiky a typická situace v našem týmu byla 10 otevřených PR, a pak je počet zkoušek součet postupnosti: 10 + 9 +… + 1 = 55. To znamená, že abychom přijali 10 PR, musíme to přepracovat 55krát. A to v ideální situaci, kdy všechny zkoušky proběhnou na první pokus, kdy nikdo neotevře další pull request, zatímco se zpracovává tato desítka.
Představte si, že jste vývojář, který se snaží zmáčknout tlačítko "merge" jako první, protože pokud to udělá soused, bude se muset čekat, až proběhnou všechny nové buildy... Ne, to tak nejde, to vážně zpomalí vývoj.
Druhá možná varianta: sbírat pull requesty po code review. To znamená, že otevřete pull request, získáte potřebný počet schválení od kolegů, opravíte, co je potřeba, a poté spustíte buildy. Pokud jsou úspěšné, pull request se sloučí s develop. V tomto případě nejsou žádné dodatečné restartování, ale výrazně se zpomalí zpětná vazba. Já, jako vývojář, chci hned vidět, zda se můj pull request sestavuje. Například pokud nějaký test selhal, potřebuji ho rychle opravit. V případě odloženého buildování se zpomaluje zpětná vazba, a tím i celý vývoj. To nás také nevyhovovalo.
Nakonec zůstal pouze třetí variant — vymýšlet koloVšechna náš kód a všechny naše zdrojové kódy jsou uloženy v repozitáři na serveru Bitbucket. Proto jsme museli vyvinout plugin pro Bitbucket.
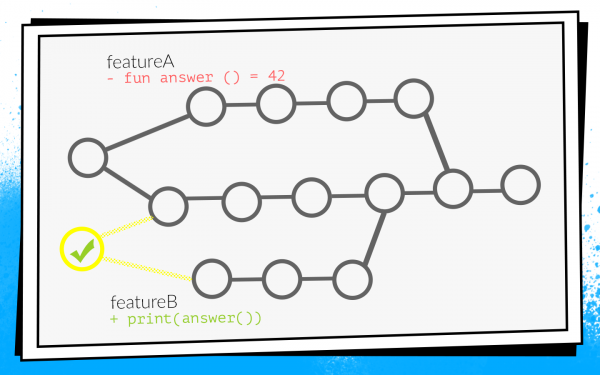
Tento plugin předefinuje mechanismus sloučení pull requestů. Začátek je standardní: otevře se PR, spustí se všechny sestavení a proběhne code review. Ale poté, co je code review schváleno a vývojář se rozhodne kliknout na „merge“, plugin zkontroluje, na základě jakého stavu develop byly testy spuštěny. Pokud se develop během sestavení aktualizoval, plugin nepovolí sloučit takový pull request do hlavní větve. Jen znovu spustí sestavení na základě aktuálního developu.
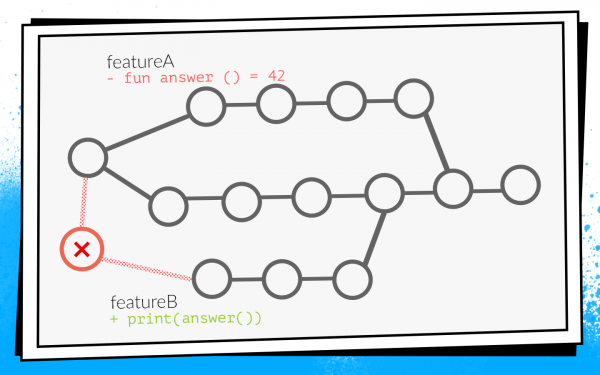
V našem příkladu s konfliktujícími změnami taková sestavení neprojdou kvůli chybě kompilace. Vývojář funkce B tak musí opravit kód a znovu spustit testy, což plugin automaticky aplikuje na pull request.
Před zavedením tohoto pluginu jsme měli průměrně 2,7 spuštění testů na jeden pull request. S pluginem to vzrostlo na 3,6 spuštění. To nám vyhovovalo.
Je třeba poznamenat, že tento plugin má nevýhodu: znovu spouští sestavení pouze jednou. Takže stále zůstává malé okno, skrze které se do developu mohou dostat konfliktující změny. Ale pravděpodobnost toho je nízká a my jsme se rozhodli pro tento kompromis mezi počtem spuštění a pravděpodobností chyby. Za poslední dva roky se to stalo jen jednou, takže asi to nebylo zbytečné.
Na napsání první verze pluginu pro Bitbucket nám trvalo dva týdny.
Nové kontroly
Mezitím náš tým pokračoval v růstu. Přidávali jsme nové kontroly.
Pomysleli jsme si: proč opravit chyby, když je můžeme předcházet? A proto jsme implementovali statický analýza kódu. Začali jsme s lint, který je součástí Android SDK. Ale ten tehdy vůbec neuměl pracovat s Kotlin kódem, a my už měli 75 % aplikace napsané v Kotlinu. Takže k lintu byly přidány vestavěné kontroly Android Studio.
Za tímto účelem jsme museli dost šíleně zkomplikovat situaci: vzít Android Studio, zabalit ji do Dockeru a spouštět na CI s virtuálním monitorem, aby si myslela, že je spuštěna na skutečném notebooku. Ale fungovalo to.
Také v té době jsme začali psát hodně instrumentačních testů a implementovali jsme screenshotové testování. To je moment, kdy je generován referenční snímek pro samostatný malý náhled, a test spočívá v tom, že se z náhledu pořídí snímek a porovná se s referenčním obrázkem pixel po pixelu. Pokud dojde k odchylce, znamená to, že došlo k chybě v rozvržení nebo ve stylu.
Ale instrumentační testy a snímkové testy je třeba spouštět na zařízeních: na emulátorech nebo na skutečných zařízeních. Vzhledem k tomu, že testů je mnoho a často se provádějí, potřebujeme celou farmu. Založit vlastní farmu je příliš pracné, proto jsme našli hotové řešení — Firebase Test Lab.
Firebase Test Lab
Byl vybrán, protože Firebase je produkt Google, což znamená, že by měl být spolehlivý a pravděpodobně nikdy nezmizí. Ceny jsou přijatelně nízké: 5 $ za hodinu provozu skutečného zařízení, 1 $ za hodinu provozu emulátoru.
Na implementaci Firebase Test Lab do našeho CI jsme potřebovali přibližně tři týdny.
Ale tým stále rostl a Firebase nás, bohužel, začal zklamávat. V té době neměl žádnou SLA. Někdy Firebase donutil čekat, dokud se neuvolní potřebný počet zařízení pro testy, a nezačal je provádět ihned, jak jsme chtěli. Čekání ve frontě trvalo až půl hodiny, což je velmi dlouho. Instrumentační testy probíhaly na každém PR, zpoždění velmi zpomalovala vývoj, a poté přišla faktura za měsíc s kulatou částkou. Celkově jsme se rozhodli vzdát se Firebase a vyvinout vlastní řešení, když už tým dost vyrostl.
Docker + Python + bash
Vzali jsme docker, nacpali do něj emulátory, napsali jednoduchý program v Pythonu, který v potřebnou chvíli spustí potřebný počet emulátorů v požadované verzi a když je potřeba, je zastaví. A samozřejmě pár bash skriptů — bez nich to nejde.
Na vytvoření vlastní testovací prostředí jsme potřebovali pět týdnů.
V důsledku toho měl každý pull request rozsáhlý, blockující seznam kontrol:
- Sestavení ARC;
- Junit testy;
- Lint;
- Kontroly Android Studio;
- Instrumentation testy;
- Screenshot testy.
To bránilo mnoha možným selháním. Technicky všechno fungovalo, ale vývojáři si stěžovali, že čekání na výsledky trvá příliš dlouho.
Jak dlouho je "příliš dlouho"? Exportovali jsme data z Bitbucket a TeamCity do analytického systému a zjistili jsme, že průměrná doba čekání je 45 minut. Takže vývojář, který otvírá pull request, v průměru čeká na výsledky sestavení 45 minut. Podle mého názoru je to velmi mnoho a takto se pracovat nedá.
Samozřejmě jsme se rozhodli urychlit všechny naše sestavy.
Zrychlujeme se
Když jsme zjistili, že se často bilduje fronta, nejdříve jsme dokoupili hardware — extenzivní rozvoj je nejjednodušší. Fronty pro buildy přestaly existovat, ale doba čekání se snížila jen o něco málo, protože některé kontroly se samy o sobě prováděly velmi dlouho.
Odstraňujeme příliš dlouhé kontroly
Náš Continuous Integration mohl zachytit takové typy chyb a problémů.
- Není zapotřebí sestavit. CI může zachytit chybu kompilace, když z důvodu konfliktních změn něco nelze sestavit. Jak jsem již zmínil, v takovém případě nikdo nic nesestaví, vývoj se zastaví a všichni nervózně čekají.
- Chyba v chování. Například, když se aplikace sestaví, ale při stisknutí tlačítka se zhroutí, nebo tlačítko vůbec nezareaguje. To je špatně, protože taková chyba se může dostat k uživateli.
- Chyba v designu. Například tlačítko reaguje, ale posunulo se o 10 pixelů vlevo.
- Zvyšování technického dluhu.
Při pohledu na tento seznam jsme pochopili, že kritickými jsou pouze první dva body. Takové problémy chceme odhalovat jako první. Chyby v designu se odhalují v průběhu design-review a lze je snadno opravit. Práce s technickým dluhem vyžaduje samostatný proces a plánování, proto jsme se rozhodli ho neprověřovat při pull requestu.
Na základě této klasifikace jsme prohlédli celý seznam kontrol. Vyškrtli jsme Lint a jeho spuštění přesunuli na noc: prostě aby vydával zprávu, kolik problémů je v projektu. S technickým dluhem jsme se dohodli pracovat odděleně, a Android Studio kontrole jsme se úplně vzdali. Android Studio na Dockeru pro spuštění inspekcí zní zajímavě, ale způsobuje spoustu problémů s údržbou. Každá aktualizace verzí Android Studio je bojem s nejasnými chybami. Také bylo složité udržovat screenshotové testy, protože knihovna nefungovala příliš stabilně, občas docházelo k falešným pozitivům. Screenshotové testy jsme odstranili ze seznamu kontrol.
Nakonec nám zůstaly:
- Sestavení ARC;
- Junit testy;
- Testy instrumentace.
Gradle vzdálená cachování
Bez těžkých kontrol se všechno zlepšilo. Ale dokonalosti není nikdy konec!
Naše aplikace byla již rozdělena na přibližně 150 gradle modulů. Obvykle v takovém případě dobře funguje Gradle vzdálená cache, a rozhodli jsme se ji vyzkoušet.
Gradle remote cache je služba, která může ukládat artefakty sestavení pro jednotlivé úkoly v jednotlivých modulech. Gradle, místo skutečné kompilace kódu, se přes HTTP dotazuje na remote cache, zda někdo již tento úkol vykonal. Pokud ano, jednoduše stáhne výsledek.
Spustit Gradle remote cache je snadné, protože Gradle poskytuje Docker obraz. Podařilo se nám to udělat za tři hodiny.
Stačilo jen spustit Docker a napsat jednu řádku do projektu. Ale ačkoliv jej lze rychle spustit, pro to, aby vše dobře fungovalo, bude potřeba dost času.
Níže je graf cache misses.
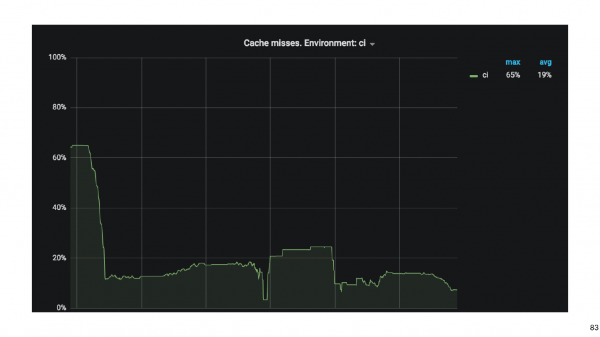
Na začátku byl procento promáchnutí mimo cache kolem 65. Po třech týdnech jsme dokázali tuto hodnotu snížit na 20%. Ukázalo se, že úkoly, které sestavuje Android aplikace, mají podivné transitivní závislosti, kvůli kterým Gradle promáchnul mimo cache.
Připojením cache jsme výrazně zrychlili sestavení. Ale kromě sestavení se také spouští instrumentační testy a ty běží dlouho. Možná není nutné spouštět všechny testy při každém pull requestu. Pro zjištění tohoto používáme analýzu dopadu.
Analýza dopadu
Při pull requestu shromažďujeme git diff a nacházíme změněné Gradle moduly.
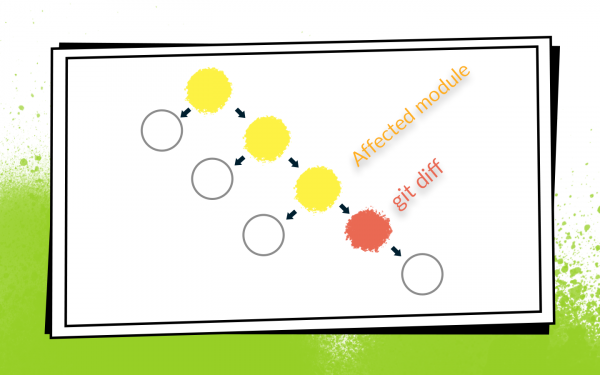
Má smysl spouštět pouze ty instrumentační testy, které kontrolují změněné moduly a všechny moduly, které od nich závisí. Testy pro sousední moduly nemají smysl spouštět: tam se kód nezměnil a nic se nemůže rozbít.
S instrumentačními testy to není tak jednoduché, protože musí být umístěny v nejvyšším úrovňovém modulu Aplikace. Použili jsme heuristiku s analýzou bytecode, abychom pochopili, k jakému modulu se každý test vztahuje.
Modernizace práce instrumentačních testů, aby kontrolovaly pouze zapojené moduly, trvala asi osm týdnů.
Opatření ke zrychlení kontrol se úspěšně vydařila. Z 45 minut jsme se dostali na přibližně 15. Čtvrt hodiny čekání na build je už v pořádku.
Ale nyní začali vývojáři stěžovat, že je pro ně nejasné, které buildy se spouštějí, kde se podívat na log, proč je build červený, který test selhal, atd.
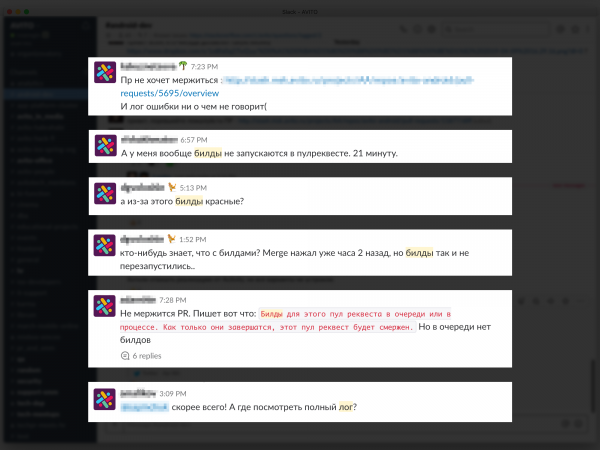
Problémy s reakcí zpomalují vývoj, proto jsme se snažili poskytnout co nejjasnější a nejpodrobnější informace o každém PR a buildu. Začali jsme s komentáři v Bitbucketu k PR, kde jsme uvedli, který build selhal a proč, psali jsme adresné zprávy do Slacku. Nakonec jsme vytvořili pro stránku PR dashboard se seznamem všech buildů, které právě běží, a jejich stavem: čeká, běží, selhal nebo skončil. Můžete kliknout na build a dostat se k jeho logu.
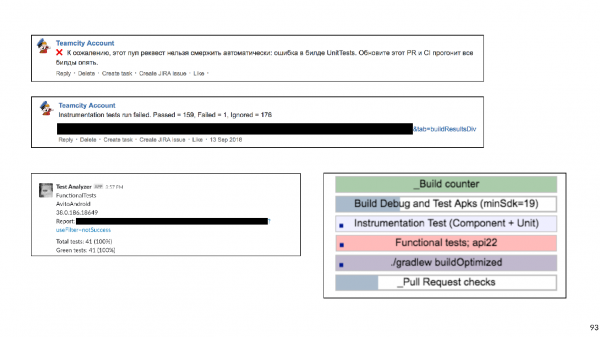
Na podrobnou zpětnou vazbu bylo vynaloženo šest týdnů.
Plány
Přejdeme k nejnovější historii. Vyřešením otázky zpětné vazby jsme se dostali na novou úroveň — rozhodli jsme se postavit naši farmu emulátorů. Když je testů a emulátorů mnoho, je s nimi obtížné manipulovat. Nakonec se všichni naši emulátoři přestěhovali do k8s clusteru s flexibilním řízením zdrojů.
Kromě toho máme i další plány.
- Vrátit Lint (a další statickou analýzu). Již na tom pracujeme.
- Spouštět na PR blokovaném všechny end-to-end testy na všech verzích SDK.
Takže jsme sledovali historii vývoje Continuous Integration v Avitu. Nyní chci dát několik rad z pohledu zkušeného.
Tipy
Kdybych mohl dát pouze jednu radu, byla by to tato:
Prosím, buďte opatrnější s shell skripty!
Bash je velmi flexibilní a mocný nástroj, na němž je velmi pohodlné a rychlé psát skripty. Ale můžete se dostat do pasti, a my, bohužel, do ní padli.
Všechno to začalo jednoduchými skripty, které se spouštěly na našich build strojích:
#!/usr/bin/env bash
./gradlew assembleDebug
Ale jak víme, vše se časem vyvíjí a komplikuje — pojďme spustit jeden skript z druhého, pojďme tam předat nějaké parametry — nakonec bylo nutné napsat funkci, která určuje, na jaké úrovni vnoření bash se právě nacházíme, abychom vložili potřebné uvozovky, aby se to všechno spustilo.
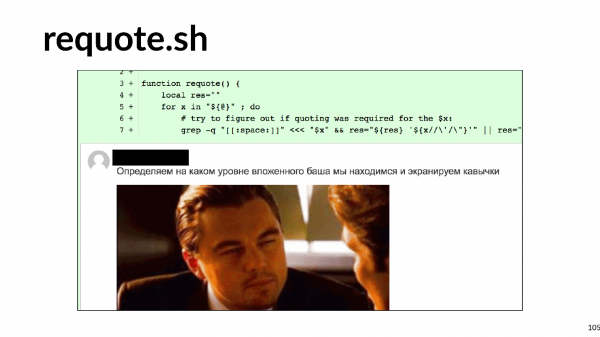
Dokážete si představit náklady na vývoj takových skriptů. Doporučuji se nedostávat do této pasti.
Čím lze nahradit?
- Jakýmkoliv skriptovacím jazykem. Psát v Pythonu nebo Kotlin Script je pohodlnější, protože to je programování, ne skripty.
- Nebo popsat celou logiku buildů ve formě Custom gradle tasks pro váš projekt.
Rozhodli jsme se zvolit druhou možnost a nyní systematicky odstraňujeme všechny bash skripty a píšeme mnoho custom gradle úloh.
Rada č. 2: uchovávejte infrastrukturu v kódu.
Je pohodlné, když je nastavení Continuous Integration uloženo ne v UI rozhraní Jenkins nebo TeamCity atd., ale ve formě textových souborů přímo v repozitáři projektu. To poskytuje verzování. Nebude obtížné se vrátit zpět nebo sestavit kód na jiné větvi.
Skripty lze uchovávat v projektu. A co dělat s prostředím?
Tip č. 3: s prostředím může pomoci Docker.
Android vývojářům určitě pomůže, iOS zatím ne, bohužel.
Toto je příklad jednoduchého dockerfile, který obsahuje jdk a android-sdk:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Stáhnout Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Nainstalovat Android Build Tool a knihovny
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Napsal jsem tento dockerfile (řeknu vám potají, že ho nemusíte psát, ale můžete stáhnout hotový z GitHubu) a po sestavení obrazu získáte virtuální stroj, na kterém můžete sestavovat aplikaci a spouštět Junit testy.
Dvě hlavní argumenty, proč to má smysl: škálovatelnost a opakovatelnost. S použitím dockeru můžete rychle spustit desítku build agentů, kteří budou mít přesně stejné prostředí jako ten předchozí. To velmi usnadňuje život CI inženýrům. Nacpat android-sdk do dockeru je docela jednoduché, s emulátory je to o něco složitější: budete muset trochu zapřemýšlet (nebo zase stáhnout hotové z GitHubu).
Tip č. 4: nezapomínejte, že kontroly se dělají ne pro kontrolu, ale pro lidi.
Vývojářům je velmi důležitá rychlá a především srozumitelná zpětná vazba: co se jim rozbilo, který test selhal, kde se podívat na build log.
Tip č. 5: buďte pragmatičtí při vývoji Continuous Integration.
Jasně pochopte, jaké typy chyb chcete zabránit, kolik jste ochotni vynaložit zdrojů, času a výpočetního času. Příliš dlouhé kontroly můžete například přesunout na noc. A od těch, které odhalují méně důležité chyby, se zcela vzdát.
Tip č. 6: používejte hotové nástroje.
V současnosti existuje mnoho společností, které poskytují cloudový CI.
Pro malé týmy je to dobré řešení. Není potřeba nic udržovat, jen zaplatíte trochu peněz, shromáždíte svou aplikaci a dokonce spustíte instrumentační testy.
Tip č. 7: ve velkém týmu jsou výhodnější in-house řešení.
Ale dříve nebo později, s růstem týmu, se stávají výhodnější in-house řešení. S těmito řešeními je jeden aspekt. V ekonomice existuje zákon klesajícího výnosu: v každém projektu každé další zlepšení je stále obtížnější a vyžaduje stále více investic.
Ekonomika popisuje celý náš život, včetně Continuous Integration. Vytvořil jsem graf pracovních nákladů na každou fázi vývoje našeho Continuous Integration.
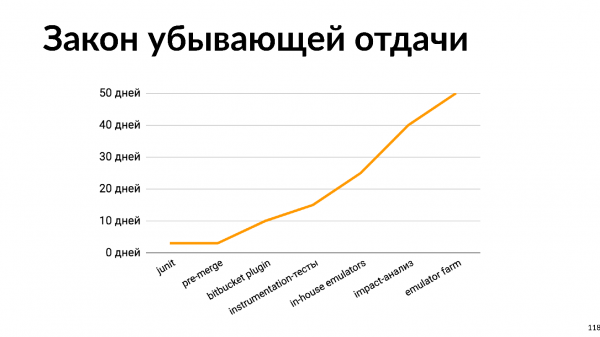
Je zřejmé, že jakékoliv zlepšení je stále obtížnější a obtížnější. Pohledem na tento graf lze pochopit, že rozvíjet Continuous Integration je potřeba v souladu s růstem velikosti týmu. Pro tým se dvěma lidmi je plýtvat 50 dní na vývoj interní farmy emulátorů dost špatný nápad. Ale na druhou stranu, pro velký tým se úplně nevěnovat Continuous Integration — také není dobrý nápad, protože na problémy s integrací, opravu komunikace atd. by bylo potřeba ještě více času.
Začali jsme tím, že automatizace je potřeba, protože lidé jsou drahí, dělají chyby a lenoši. Ale automatizaci dělají také lidé. Proto se všechny tyto problémy vztahují i na automatizaci.
- Automatizace je drahá. Vzpomeňte si na graf pracovních nákladů.
- Při automatizaci lidé dělají chyby.
- Někdy je velmi lenost automatizovat, protože to funguje i tak. Proč ještě něco zlepšovat, proč celý ten Continuous Integration?
Ale mám statistiky: u 20 % buildů se odhalují chyby. A to se neděje proto, že by naši vývojáři psali špatný kód. Děje se to, protože vývojáři jsou přesvědčeni, že pokud udělají nějakou chybu, nedostane se do developu, odhalí ji automatizované kontroly. Odpovídajícím způsobem mohou vývojáři strávit více času psaním kódu a zajímavými věcmi, místo aby lokálně něco spouštěli a kontrolovali.
Věnujte se Continuous Integration. Ale s mírou.
Mimochodem, Nikolaj Nesterov nejen dělá úžasné prezentace, ale také je součástí programového výboru a pomáhá ostatním připravit pro vás obsahové vystoupení. Úplnost a užitečnost programu nadcházející konference lze posoudit podle témat v . A pro podrobnosti přijďte 22-23. dubna do Infoprostranství.
Zdroj: habr.com
