

Doporučuji se seznámit s přepisem přednášky Romana Chavronenka "ExtendedPromQL"
Krátce o mně. Jmenuji se Roman. Pracuji v CloudFlare, žiji v Londýně. Ale také jsem udržovatel VictoriaMetrics.
A jsem autorem pro Grafanu a – to je malý proxy pro ClickHouse.
Začneme s první částí, která se jmenuje "Obtíže s překladem" a budu mluvit o tom, že každý jazyk nebo dokonce jen jazyk komunikace – je velmi důležitý. Protože to, jak předáváte své myšlenky jinému člověku nebo systému, jak formulujete svou žádost. Lidé na internetu se hádají o tom, který jazyk je lepší – java nebo nějaký jiný. Pro sebe jsem se rozhodl, že je třeba vybírat podle úkolu, protože všechno je to specifické.
Začněme od začátku. Co je to PromQL? PromQL – je to Jazyk dotazů pro Prometheus. To je způsob, jakým formulujeme dotazy v Prometheusu, abychom získali časové řady dat, časové řady.
Co jsou to časové řady dat? Pokud to bereme doslovně, tak to jsou tři parametry.
To je:
- Na co se díváme.
- Kdy se na to díváme.
- A jakou hodnotu to ukazuje.
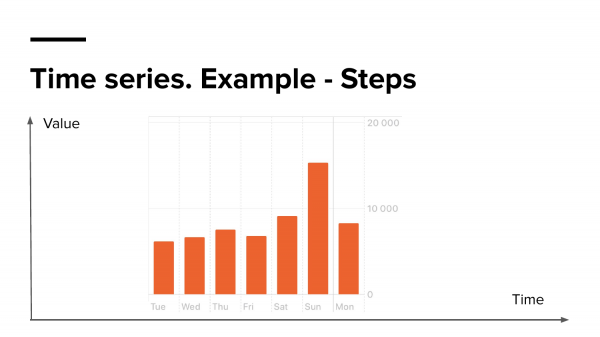
Pokud se podíváme na tento graf (tento graf z mého telefonu, který ukazuje statistiku mých kroků), tak zde můžeme rychle odpovědět na tyto otázky.
Sledujeme kroky. Vidíme hodnotu a vidíme čas, kdy se na to díváme. Tedy, kdy se díváme na tento graf, můžeme snadno říct, že jsem v neděli ušel přibližně 15 000 kroků. To jsou časové řady dat.
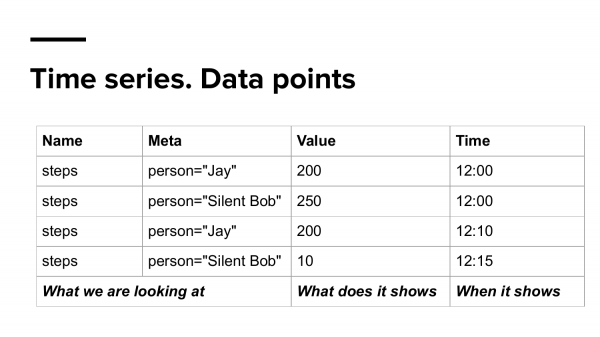
Nyní pojďme "rozbít" (transformovat) je do jiné datové modelu ve formě tabulky. Zde také máme to, na co se díváme. Trochu jsem přidal další data, která budeme nazývat metadatami, totiž to nešel já, ale dva lidé, dejme tomu Jay a Silent Bob. Toto je to, na co se díváme; co to ukazuje a kdy to ukazuje tuto hodnotu.
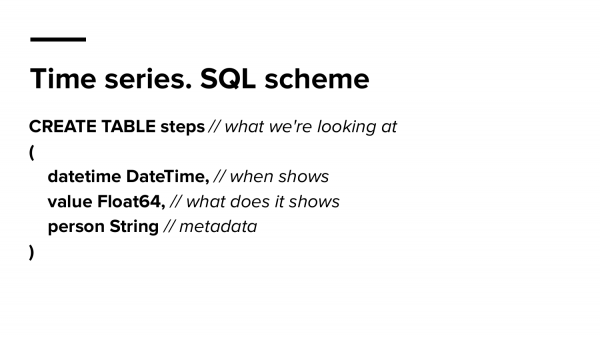
Nyní se pokusíme uložit všechny tyto údaje do databáze. Pro příklad jsem vzal syntaxi ClickHouse. A zde vytváříme jednu tabulku, která se nazývá "Kroky", tedy na co se díváme. Zde je čas, kdy se na to díváme; co to ukazuje a nějaká metadata, kde budeme uchovávat, kdo to je: Jay a Silent Bob.
A aby se pokusili to všechno vizualizovat, použijeme Grafanu, protože, za prvé, to vypadá pěkně.
Také budeme používat tento plugin. Důvodů je hned několik. První je, že jsem ho napsal. A přesně vím, jak je těžké získat časové řady z ClickHouse, abychom je mohli zobrazit v Grafana.
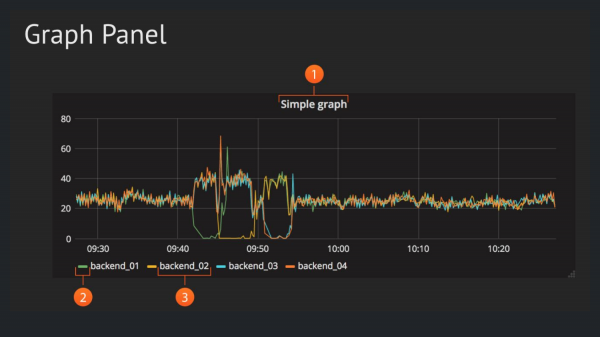
Zobrazíme je v Graph Panel. To je nejpopulárnější panel v Grafana, který ukazuje závislost hodnoty na čase, takže potřebujeme pouze dva parametry.
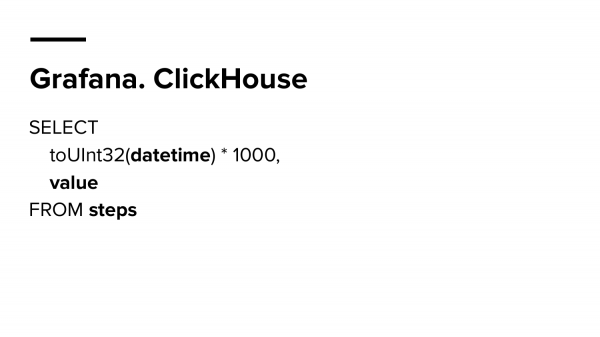
Napišme si nejjednodušší dotaz – jak zobrazit statistiku kroků v Grafana, přičemž tyto údaje ukládáme v ClickHouse, v té tabulce, kterou jsme vytvořili. Napíšeme takový jednoduchý dotaz. Vybereme z kroků. Vybereme hodnotu a vybereme čas těchto hodnot, tedy ty tři parametry, o kterých jsme hovořili.
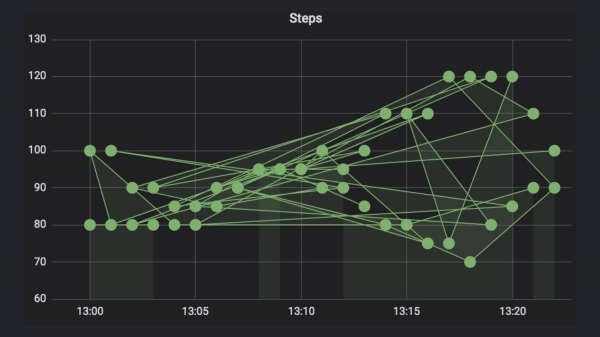
A výsledkem bude takovýto graf. Kdo ví, proč je tak podivný?
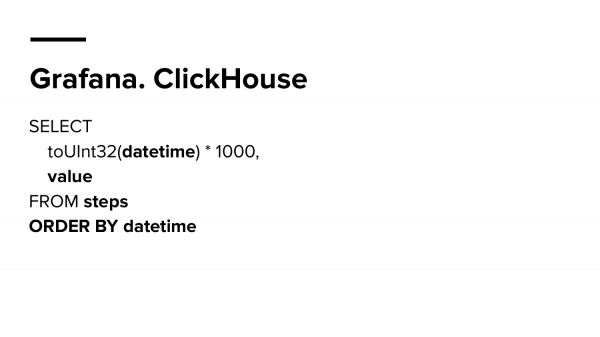
Správně, musíme seřadit podle času.
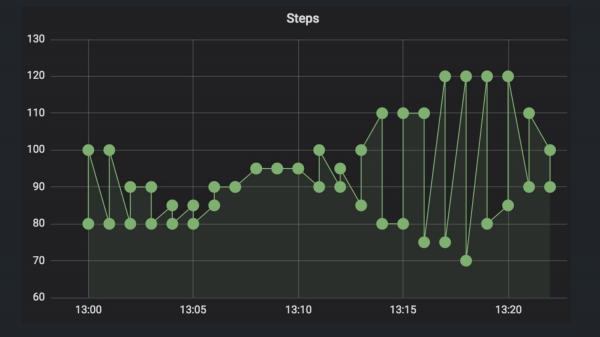
A nakonec dostaneme už lepší, ale stále podivný graf. Kdo ví, proč? Správně, jsou tam dva účastníci, a v Grafana posíláme dvě časové řady, protože pokud se podíváme na datový model znovu, každá časová řada je unikátní kombinací názvu a všech klíčových hodnot labels.
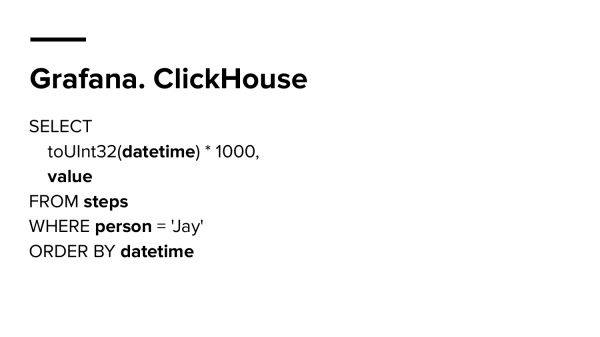
Proto musíme vybrat konkrétního člověka. Vybereme Jaye.

A nakreslíme to znovu. Nyní už graf vypadá spolehlivě. Teď to je normální graf a vše funguje dobře.
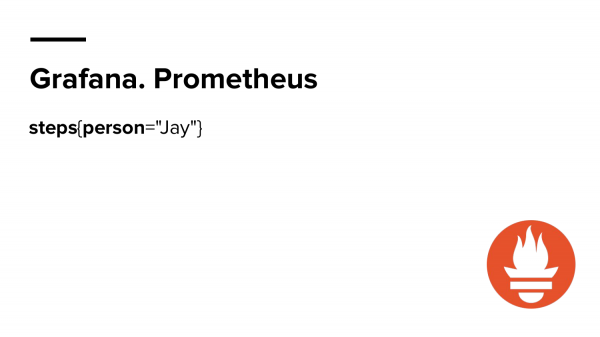
A pravděpodobně víte, jak udělat něco podobného, ale v Prometheus pomocí PromQL. Přesně takto. O něco jednodušeji. A ještě to všechno rozložíme. Brali jsme kroky a filtrujeme podle Jaye. Nebudeme uvádět, že potřebujeme získat hodnotu, a nevybíráme čas.
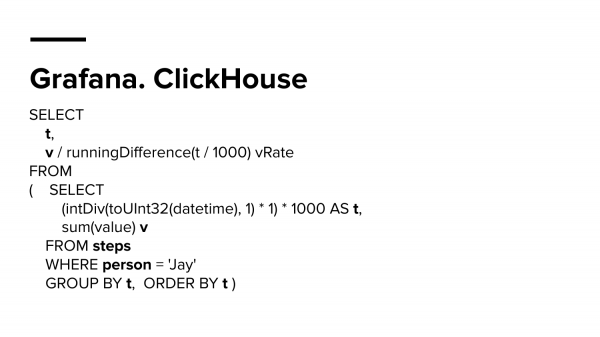
A teď zkusíme spočítat rychlost pohybu Jaye nebo Silent Boba. V ClickHouse budeme muset provést runningDifference, tedy spočítat rozdíl mezi dvojicemi bodů a vydělit je časem, abychom získali přesnou rychlost. Dotaz bude vypadat přibližně takto.
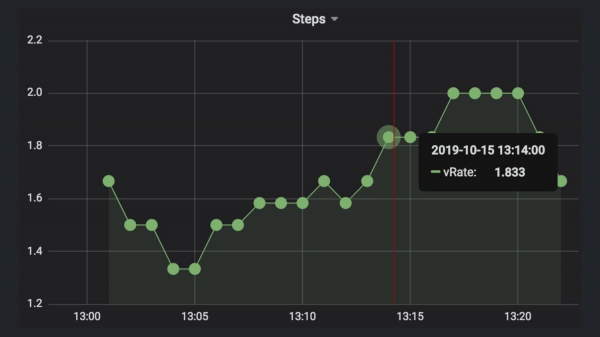
A ukáže přibližně takovéto hodnoty, tedy přibližně 1,8 kroku za sekundu dělá Silent Bob nebo Jay.
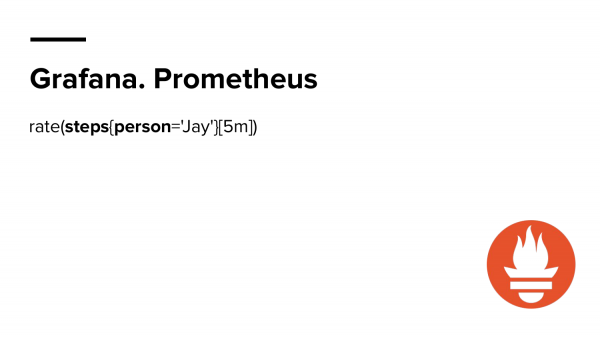
A v Prometheus víte, jak to udělat také. Mnohem jednodušeji, než to bylo předtím.
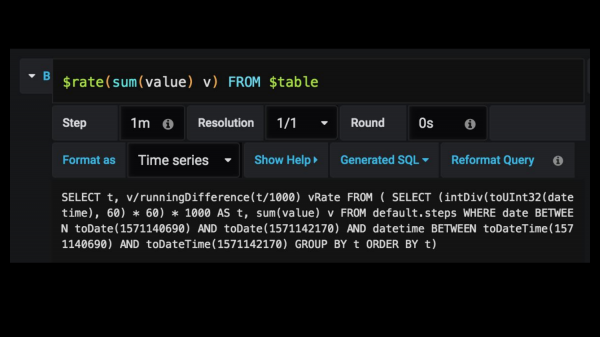 Aby to bylo stejně snadné i v Grafaně, přidal jsem tento obal, který vypadá velmi podobně jako PromQL. Nazývá se Rate Macros, nebo jak chcete. V Grafaně jednoduše napíšete „rate“, ale někde uvnitř se to transformuje do takového velkého dotazu. A na něj se nemusíte ani dívat, je tam někde, ale ušetříte spoustu času, protože psaní takových obrovských SQL dotazů je vždy nákladné. Snadno se můžete mýlit a pak dlouho netušíte, co se děje.
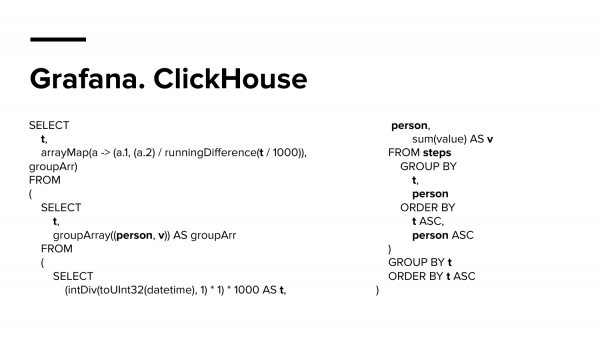
A tohle je dotaz, který se nevešel ani na jeden snímek a musel jsem ho rozdělit na dva sloupce. To je také dotaz v ClickHouse, který dělá totéž rate, ale pro obě časové řady: pro Silent Boba a pro Jaye, abychom na panelu měli dvě časové řady. A to už je, podle mého názoru, velmi složité.
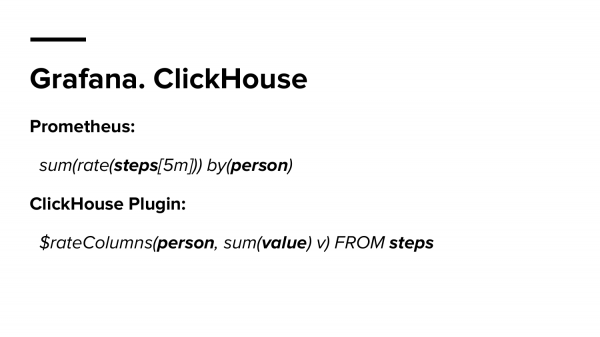
A co se týče Promethea, to bude sum (rate). Pro ClickHouse jsem udělal samostatný makro, které se nazývá RateColumns a vypadá jako dotaz v Prometheus.
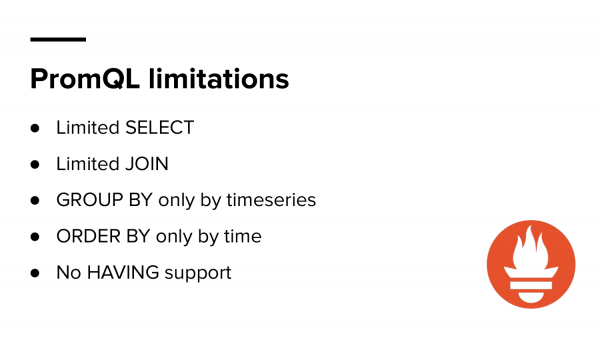
Podívali jsme se a vypadá to, že PromQL je skvělý, ale má samozřejmě svá omezení.
To je:
- Omezené SELECT.
- Omezené JOIN.
- Bez podpory HAVING.
A pokud jste s tím pracovali dlouho, víte, že někdy je velmi těžké něco udělat v PromQL, zatímco v SQL můžete dělat téměř cokoliv, protože všechny tyto varianty, o kterých jsme mluvili, by šly udělat v SQL. Ale bylo by pohodlné to používat? A to mě přivádí k myšlence, že ne vždy ten nejsilnější jazyk může být nejpohodlnější.
Proto je někdy potřeba vybírat jazyk podle úkolů. Je to jako bitva Batmana se Supermanem. Je jasné, že Superman je silnější, ale Batman ho dokázal porazit, protože byl praktičtější a přesně věděl, co dělá.
A další část – to je rozšiřování PromQL.
Ještě jednou o VictoriaMetrics. Co je VictoriaMetrics? Je to databáze časových řad, je open-source, distribujeme její single i clusterové verze. Podle našich benchmarků je to nejrychlejší, co je na trhu, a co se týče komprese, také srovnatelně, tj. živí lidé hlásí kompresi okolo 0,4 bajtu na bod, zatímco u Prometheuse je to 1,2-1,4.
Nepodporujeme pouze Prometheus. Podporujeme také InfluxDB, Graphite, OpenTSDB.
Můžete nám "psát", tj. můžete převádět stará data.
A také perfektně fungujeme s Prometheus a Grafana, tj. podporujeme motor PromQL. V Grafaně můžete jednoduše změnit koncový bod Prometheus na VictoriaMetrics a všechny vaše panely budou fungovat, jak byly nastaveny.
Ale můžete využít i další funkce, které nabízí VictoriaMetrics.
Rychle projdeme funkcemi, které jsme přidali.
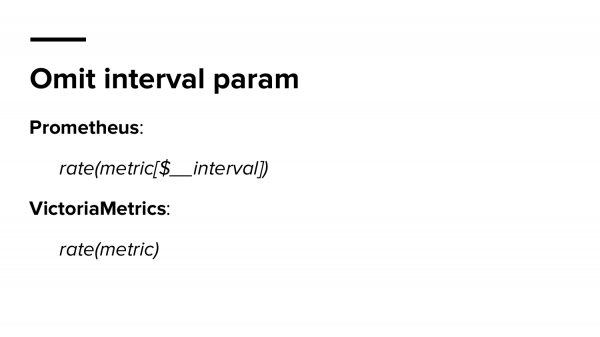
Omit interval param – můžete vynechat intervalní parametry v Grafaně. Když nechcete dostávat podivné grafy při zoomování v panelu, doporučuje se používat proměnnou {$__interval}. Tato proměnná je interní v Grafaně a ona sama vybírá rozsah dat. A VictoriaMetrics dokáže pochopit, jaký tento rozsah má být. A nemusíte aktualizovat všechny vaše dotazy. Bude to mnohem jednodušší.
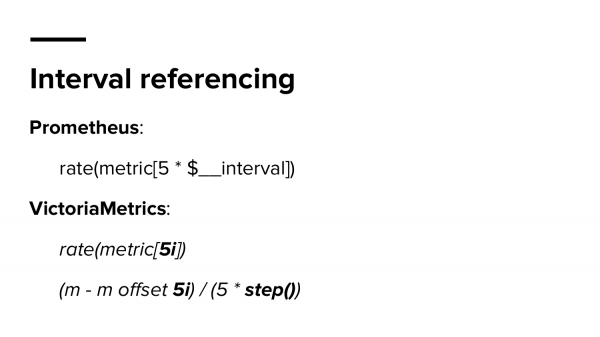
Druhá funkce – je to intervalní odkazování. Můžete tento interval používat ve svých výrazech. Můžete jej násobit, dělit, předávat, odkazovat na něj.
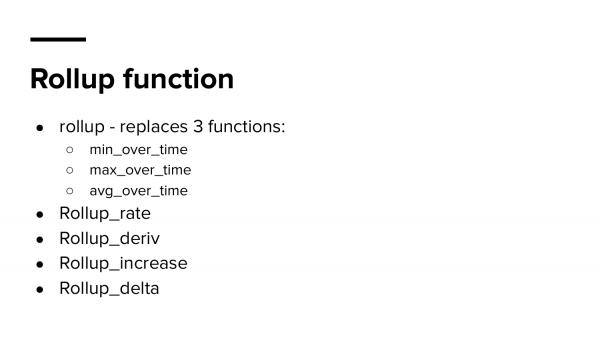
Dále rodina funkcí rollup. Rollup funkce transformují jakýkoli váš časový série do tří oddělených časových sérií. To je min, max a avg. Myslím, že je to velmi praktické, protože to občas může ukázat nějaké anomálie a nepřesnosti.
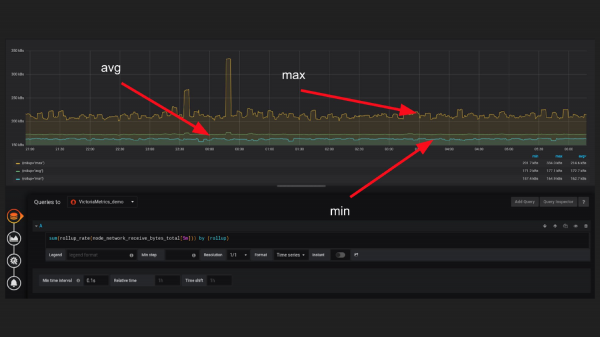
A pokud děláte irate nebo rate, pravděpodobně můžete přehlédnout některé případy, kdy časový série se chová jinak, než jste předpokládali. S touto funkcí je mnohem jednodušší vidět například, že max je velmi odlišný od avg.
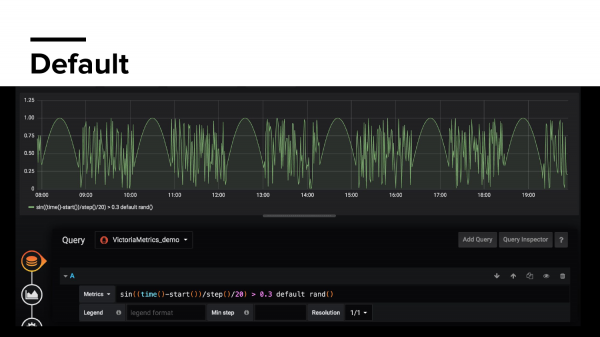
Dále proměnná default. Default – to znamená, jakou hodnotu chceme vykreslit v Grafaně, pokud nemáme časový série v danou chvíli. Kdy se to může stát? Dejme tomu, že exportujete nějakou metriku chyb. A máte tak skvělou aplikaci, že když jste začali, nemáte žádné chyby a dokonce nemáte žádné chyby ani za další tři hodiny nebo dokonce den. A máte panely, které ukazují poměr mezi úspěchy a chybami. A ty vám nebudou nic ukazovat, protože nemáte metriky chyb. A v defaultu můžete uvést cokoliv.
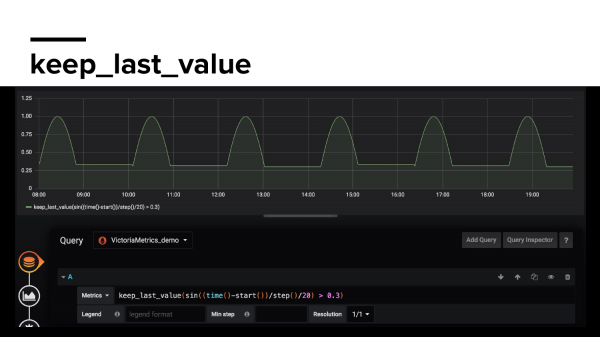
Keep_last_Value – uchovává poslední hodnotu metriky, pokud zmizela. Pokud ji Prometheus po další době shrábání nenajde po dobu 5 minut, zapamatujeme si její poslední hodnotu a vaše grafy se znovu neporouchají.
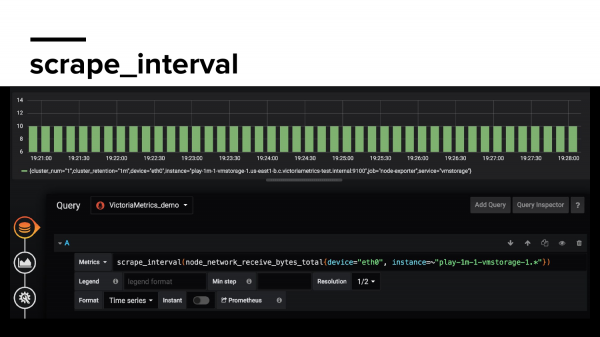
Scrape_interval – ukazuje, jak často Prometheus sbírá data ohledně vaší metriky, jakou frekvencí. Zde můžete vidět vynechání, například.
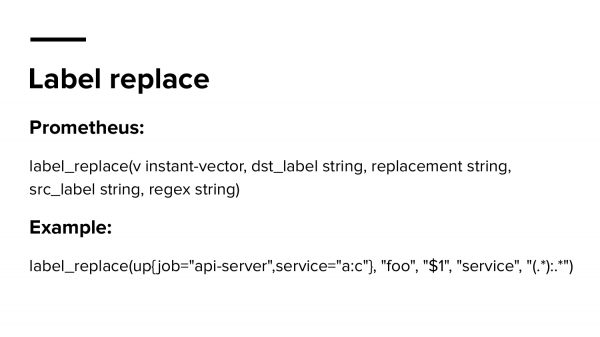
Label replace – oblíbená funkce. Ale považujeme ji za trochu složitou, protože přijímá celkem argumentů. A musíte si nejen pamatovat 5 argumentů, ale také si zapamatovat jejich pořadí.
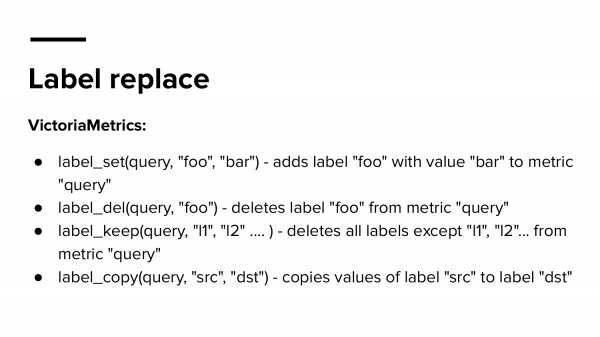
Proč je tedy neudělat jednodušší? T. j. rozdělit je na menší funkce s přehlednou syntaxi.
A teď to nejzajímavější. Proč považujeme toto za rozšířený PromQL? Protože podporujeme společné tabulkové výrazy. Můžete se podívat na QR kód (), prohlédnout si odkazy s příklady a playground, kde můžete provádět dotazy přímo ve VictoriaMetrics bez jejího nainstalování, jednoduše v prohlížeči.
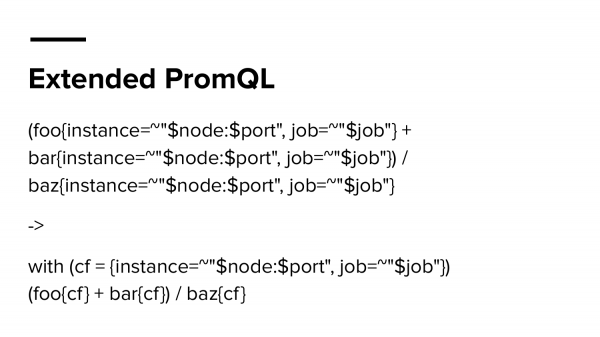
A co to vlastně je? Ten dotaz nahoře – to je docela populární dotaz. Myslím, že v každém dashboardu ve spoustě firem používáte stejný filtr pro všechno. Obvykle to tak bývá. Ale když potřebujete přidat nový filtr, musíte aktualizovat každou panelu, nebo stáhnout dashboard, otevřít ho v JSON, provést find replace, což také zabere čas. Proč si neuchovat tuto hodnotu ve proměnné a nevyužít ji znovu? To vypadá, podle mého názoru, mnohem jednodušeji a srozumitelněji.
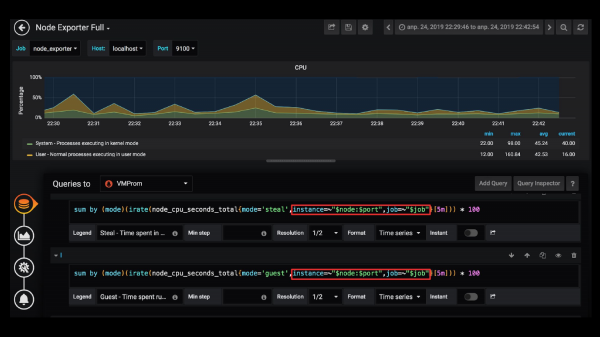
Například, když musím aktualizovat filtry v Grafaně ve všech dotazech, a dashboard může být obrovský, nebo jich může být dokonce několik. A jak bych chtěl tento problém vyřešit v Grafaně?
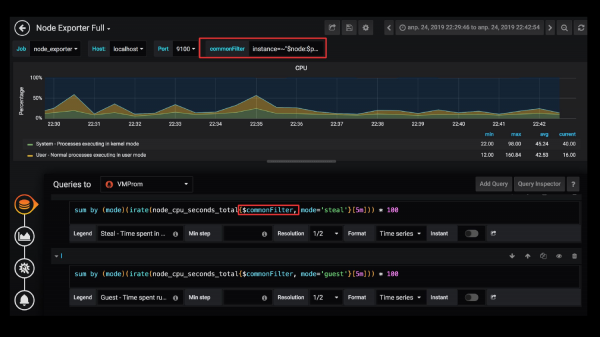
Tento problém řeším takto: vytvořím commonFilter a v něm definuji tento filtr, a pak ho pře používám v dotazech. Ale pokud uděláte nyní to samé, nebude to fungovat, protože Grafana vám neumožňuje používat proměnné uvnitř proměnných dotazů. A to je trochu divné.
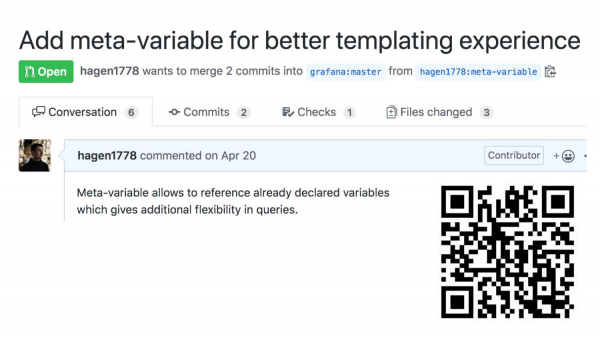
A proto jsem vytvořil takovou variantu, která to umožňuje. A pokud vás to zajímá nebo byste takovou funkci chtěli, podpořte to nebo dejte dislike, pokud se vám taková myšlenka nelíbí.
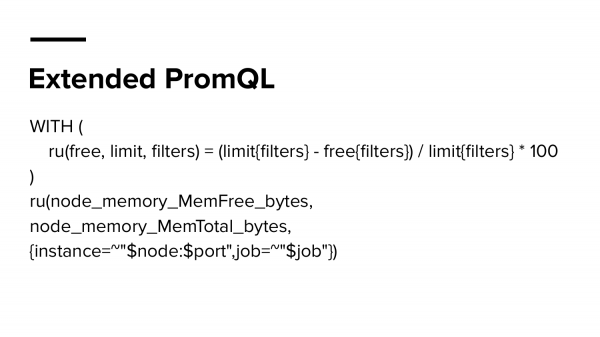
Dále o rozšířeném PromQL. Zde definujeme nejen proměnnou, ale přímo celou funkci. A nazýváme ji ru (resource usage). Tato funkce přijímá volné zdroje, omezení podle zdroje a filtr. Vypadá to, že syntaxi je celkem jednoduchá. A je velmi snadné tuto funkci použít a spočítat procento volné paměti u nás. T. j. kolik paměti máme, jaké je omezení a jak filtrovat. Vypadá to mnohem pohodlněji, pokud byste to všechno psali, přičemž byste znovu používali stejné filtry, protože by se to proměnilo v obrovský dotaz.
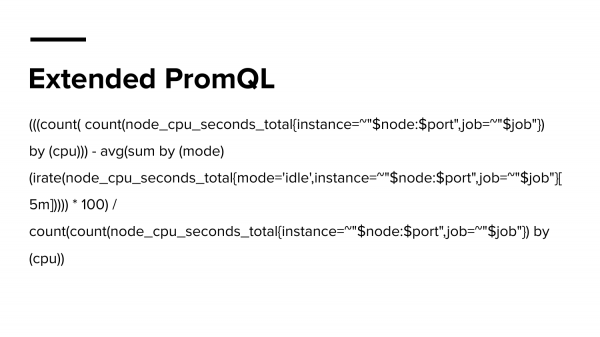
A tady je příklad takového velkého dotazu. Pochází z oficiálního dashboardu NodeExporter pro Grafana. Ale moc nerozumím tomu, co se tady děje. Tedy, samozřejmě rozumím, pokud se na to podívám blíže, ale množství závorek může okamžitě snížit motivaci rozklíčovat, co se tady děje. A proč by to nemohlo být jednodušší a přehlednější?
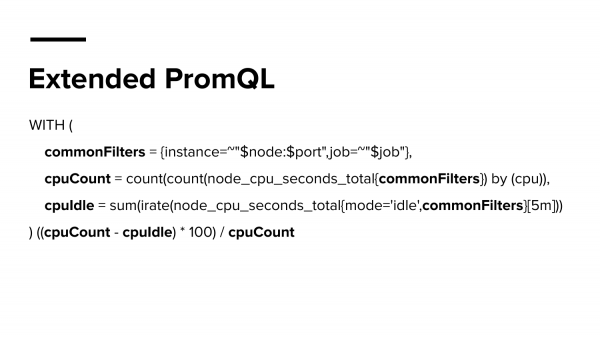
Například takto, když vyzdvihneme podstatné věci nebo části do proměnných. A pak provedeme svou základní matematiku. To už vypadá více jako programování, to je to, co bych chtěl vidět v budoucnu v Grafana.
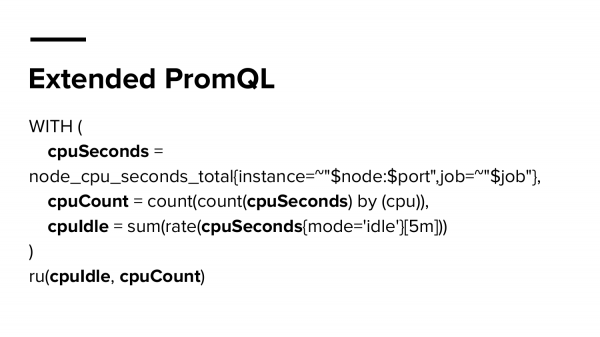
Toto je druhý příklad, jak bychom to mohli udělat ještě jednodušeji, kdybychom už měli tuto funkci ru, která už existuje přímo ve VictoriaMetrics. A pak jen předáte uloženou hodnotu, kterou jste vyhlásili v CTE.
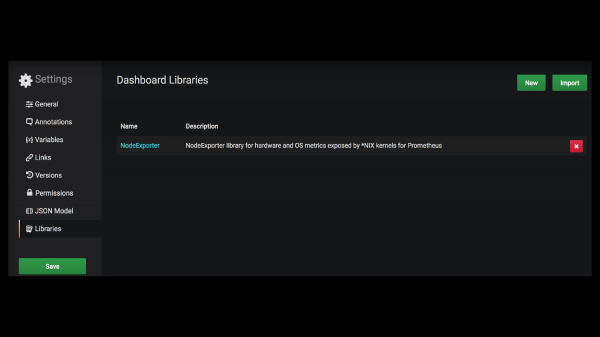
Už jsem mluvil o tom, jak důležité je používat správný programovací jazyk. A pravděpodobně v každé firmě v Grafana vzniká něco svého. A pravděpodobně také dáváte přístup k Grafana svým vývojářům, a vývojáři dělají něco svého. A všichni to dělají různě. Chtěl bych, aby to nějak odpovídalo standardu, tedy vracelo se k obecnému štandartu.
Předpokládejme, že máte nejen systémové inženýry, možná máte dokonce i experty, devopsy nebo SRE. Možná máte experty, kteří vědí, co je monitoring, vědí, co je Grafana, tedy s tím pracují léta a opravdu vědí, jak to dělat správně. A už to psali 100krát a všem vysvětlovali, ale z nějakého důvodu nikdo neposlouchá.
A co kdyby tyto znalosti mohli přímo vložit do Grafana, aby je mohli ostatní uživatelé znovu využít? A kdyby bylo třeba spočítat procento volné paměti, prostě by použili funkci. A co kdyby tvůrci exportérů spolu se svým produktem také poskytovali sadu funkcí, jak pracovat s jejich metrikami, protože přesně vědí, co jsou to za metriky a jak je správně počítat?
Toto ve skutečnosti neexistuje. Toto jsem udělal sám. To je podpora knihoven v Grafana. Představte si, že kluci, kteří vytvořili NodeExporter, udělali to, o čem mluvím. A také poskytli sadu funkcí.
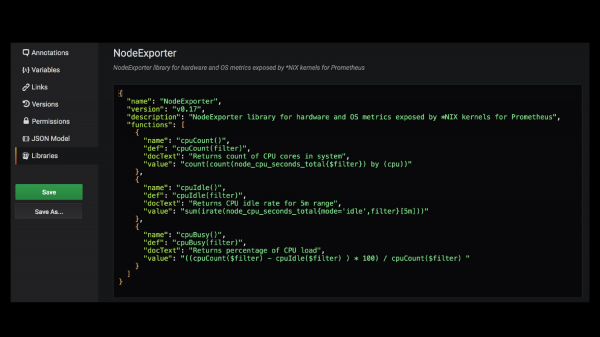
Tedy to vypadá přibližně takto. Připojíte tuto knihovnu v Grafana, přejdete do úpravy a zde je velmi jednoduše v JSON popsáno, jak pracovat s touto metrikou. Tedy nějaká sada funkcí, jejich popis a do čeho se rozvíjejí.
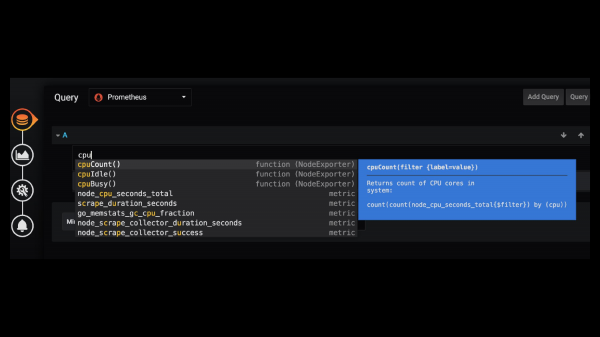
Myslím, že by to mohlo být užitečné, protože pak byste v Grafana psali jednoduše tak. A Grafana vám "říká", že je tu taková funkce z takové knihovny – pojďme ji použít. Domnívám se, že by to bylo skvělé.
Trochu o VictoriaMetrics. Děláme spoustu zajímavých věcí. Přečtěte si naše články o kompresi, o našich soutěžích s jinými aplikacemi pro časové řady, naše vysvětlení, jak pracovat s PromQL, protože zde je stále spousta nováčků, a také o vertikální škálovatelnosti a o soutěžení s Thanos.
Otázky:
Začnu svou otázku jednoduchým životním příběhem. Když jsem poprvé začal používat Grafana, napsal jsem velmi přesvědčivý dotaz dlouhý 5 řádků. Výsledkem byl velmi přesvědčivý graf. Tento graf skoro šel do produkce. Ale při bližším zkoumání se ukázalo, že tento graf ukazuje absolutní nesmysl, který nemá žádný vztah k realitě, přestože čísla spadají do rozsahu, který jsme očekávali vidět. A moje otázka. Máme knihovny, máme funkce, ale jak píšeme testy pro Grafana? Napsali jste složitý dotaz, od kterého závisí podnikové rozhodnutí – objednat skutečný kontejner serverů nebo neobjednávat. A jak víme, že funkce, která kreslí graf, vypadá jako pravda. Děkuji.
Děkuji za otázku. Tady jsou dvě části. První – mám dojem, na základě své praxe, že většina uživatelů, když se dívá na své grafy, nechápe, co jim ukazují. Z nějakého důvodu jsou lidé velmi dobří v tom, aby vymysleli omluvu pro jakoukoli anomálii, která se na grafech objevuje, i když je to chyba uvnitř funkce. A druhá část – myslím, že použití takových funkcí by mnohem lépe posloužilo k řešení vaší problému, místo toho, aby každý z vašich vývojářů dělal své plánování kapacity a chyboval s nějakou pravděpodobností.
Jak zkontrolovat?
Jak zkontrolovat? Asi nijak.
Ve formě testu v Grafana.
Co má Grafana společného? Grafana přenáší tento dotaz přímo do DataSource.
Přidáním malého množství do parametrů.
Ne, v Grafaně se nic nepřidává. Mohou zde být parametry GET, jako například step. Ten není jednoznačně uveden, ale můžete ho přepsat, můžete ho nepřepsat, ale automaticky se přidává. Zde nebudete psát testy. Myslím, že na Grafanu se jako na zdroj pravdy spoléhat nevyplatí.
Děkuji za prezentaci! Děkuji za kompresi! Zmiňovali jste mapování proměnné v grafu, že v Grafaně nelze použít proměnnou v proměnné. Rozumíte, o čem mluvím?
Ano.
To byla původně velká bolest hlavy, když jsem chtěl vytvořit upozornění v Grafaně. A tam je potřeba dělat upozornění pro každý host zvlášť. Tohle, co jste udělali, funguje pro upozornění v Grafaně?
Pokud Grafana nekaždí proměnné nějak jinak, pak – ano, bude to fungovat. Ale moje rada je vůbec nepoužívat upozorňování v Grafaně, měli byste raději použít alertmanager.
Ano, používám ho, ale v Grafaně se mi to zdálo snadnější na nastavení, ale díky za radu!
Zdroj: habr.com
