

Úvod
Dobrý den. Již půl roku u nás funguje skript (přesněji soubor skriptů), který generuje zprávy o stavu virtuálních strojů (a nejen o nich). Rozhodl jsem se podělit o zkušenosti z tvorby a samotný kód. Doufám v kritiku a v to, že tento materiál může být někomu užitečný.
Vytváření poptávky
Máme hodně virtuálních strojů (přibližně 1500 VM rozložených na 3 vCenter). Nové se často vytvářejí a staré odstraňují. Abychom udrželi pořádek, přidali jsme několik uživatelských polí do vCenter, abychom rozlišili VM na subsystémy, označili, zda jsou testovací, a také tím, kdo a kdy byly vytvořeny. Lidský faktor vedl k tomu, že více než polovina strojů zůstala s nevyplněnými poli, což ztěžovalo práci. Každých šest měsíců se někdo rozčílil a zahájil práci na aktualizaci těchto dat, ale výsledek přestal být aktuální již za týdny.
Hned upřesním, že všichni chápou, že by měly být žádosti o vytvoření strojů, proces jejich vytváření atd. atd. A přitom všichni tento proces striktně dodržují a je zde pořádek. U nás, bohužel, to tak není, ale to není předmětem článku 🙂
Celkově bylo rozhodnuto automatizovat kontrolu správnosti vyplnění polí.
Rozhodli jsme, že denní e-mail se seznamem nesprávně vyplněných strojů všem zodpovědným inženýrům a jejich nadřízeným bude dobrým začátkem.
V tomto okamžiku již jeden z kolegů implementoval skript v PowerShellu, který každý den podle plánu shromažďoval informace o všech strojích všech vCenter a vytvářel 3 csv dokumenty (každý pro své vCenter), které byly umístěny na sdílený disk. Bylo rozhodnuto vzít tento skript jako základ a doplnit ho kontrolami pomocí jazyka R, s nímž měl trochu zkušeností.
Během úprav se řešení rozrostlo o informování e-mailem, databázi s hlavní a historickou tabulkou (o tom později), a také o analýzu logů vSphere pro nalezení skutečných tvůrců vm a času jejich vytvoření.
Pro vývoj byly použity IDE RStudio Desktop a PowerShell ISE.
Skript se spouští z běžního Windows virtuálního stroje.
Popis obecné logiky.
Obecná logika skriptů se ukázala být následující.
- Shromažďujeme data o virtuálních strojích pomocí PowerShell skriptu, který spouštíme přes R, a výsledky kombinujeme do jednoho csv. Opačná interakce mezi jazyky je provedena obdobně. (bylo by možné předávat data přímo z R do PowerShell jako proměnné, ale to je obtížné, a mít mezilehlé csv usnadňuje ladění a sdílení mezivýsledků).
- Pomocí R vytváříme povolené parametry pro pole, jejichž hodnoty kontrolujeme. — Vytváříme word dokument, který bude obsahovat hodnoty těchto polí pro vložení do informačního dopisu, který bude odpovědí na otázky kolegů "Ale jak to mám vyplnit?".
- Načítáme data ze všech VM z csv pomocí R, vytváříme dataframe, odstraňujeme nepotřebná pole a vytváříme informační xlsx dokument, který bude obsahovat souhrnné informace o všech VM, který umístíme na společný zdroj.
- Na dataframe všech VM aplikujeme všechny kontroly správnosti vyplnění polí a vytváříme tabulku obsahující pouze VM s nesprávně vyplněnými poli (a pouze tato pole).
- Získaný seznam VM posíláme na jiný PowerShell skript, který prozkoumá logy vCenter na přítomnost událostí tvorby VM, což umožní uvést předpokládaný čas vzniku VM a předpokládaného tvůrce. To platí v případě, že nikdo neuznává, čí stroj to je. Tento skript nepracuje rychle, zejména pokud je hodně logů, proto sledujeme pouze poslední 2 týdny a také využíváme workflow, které umožňuje provádět vyhledávání informací pro více VM současně. V příkladu skriptu jsou podrobné komentáře k tomuto mechanismu. Výsledek ukládáme do csv, které opět načítáme do R.
- Vytváříme krásně naformátovaný xlsx dokument, ve kterém budou nesprávně vyplněná pole zvýrazněna červenou barvou, aplikovány filtry na některé sloupce, a také budou uvedeny další sloupce obsahující předpokládané tvůrce a čas vzniku VM.
- Vytváříme e-mail, do kterého vkládáme dokument popisující přípustné hodnoty polí a také tabulku s nesprávně vyplněnými VMs. V textu uvedeme celkový počet nesprávně vytvořených VMs, odkaz na společný zdroj a motivační obrázek. Pokud nejsou žádné nesprávně vyplněné VMs, odešleme jiný e-mail s radostnějším motivačním obrázkem.
- Zapisujeme data o všech VMs do SQL Serveru s ohledem na implementovaný mechanismus historických tabulek (velmi zajímavý mechanismus - o kterém se dozvíte více dále)
Skutečně skripty
Hlavní soubor s kódem v R
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Ověříme správnost vyplněných polí
full_df <- fullXslx_df %>%
mutate(
# Nejprve odstraníme všechny nadbytečné mezery a tabulátory, pak zohledníme oddělovač čárku, poté ověříme výskyt ve povolených hodnotách,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Ověříme existenci souboru se všemi VM a odstraníme, pokud existuje.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Vytvoříme xslx soubor s reportem ####
# Obecné údaje na samostatný list
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Vytvoříme xslx soubor s nesprávně vyplněnými poli ####
# Vytvoříme df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Ověříme existenci souboru se všemi VM a odstraníme, pokud existuje.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Uložíme seznam VM s nevyplněnými poli do csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtrujeme pro vložení do e-mailu
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Spočítáme počet řádků
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Ověříme existenci souboru se tvůrci a odstraníme, pokud existuje.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Spouštíme PowerShell skript, který najde tvůrce nalezených VM. Na výstupu získáme csv.
system(paste0("powershell -File ", getCreatorsPath))
# Čteme soubor s tvůrci
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtrujeme pro vložení do e-mailu, přidáváme údaje z tabulky s tvůrci
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Předpokládaný tvůrce` = CreatedBy,
`Předpokládané datum vytvoření` = CreatedOn)
# Vytvoříme tělo e-mailu
emailBody <- paste0(
'<html>
<h3>Dobrý den, vážení kolegové.</h3>
<p>Úplné aktuální informace o virtuálních strojích můžete vidět na disku H: tady:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Také v příloze je seznam VM s <strong>neplatně vyplněnými</strong> poli. Celkem jich je <strong>', numberOfRows, '</strong>.</p>
<p>V tabulce se objevily 2 další sloupce. <strong>Předpokládaný tvůrce</strong> a <strong>Předpokládané datum vytvoření</strong>, které jsou získány z logů vCenter za poslední 2 týdny</p>
<p>Žádáme tvůrce strojů, aby upřesnili údaje a správně vyplnili pole. Pravidla pro vyplnění polí jsou také v příloze.</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Kontrola existence souboru
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Tvoříme pěknou tabulku s formáty atd.
source(file = "email.R", local = T, encoding = "utf-8")
#### Tvoříme e-mail se špatně podepsanými stroji ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VM s neplatně vyplněnými poli",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Dál bude následovat blok, pokud nejsou problémy s VM ####
} else {
# Tvoříme tělo e-mailu
emailBody <- paste0(
'<html>
<h3>Dobrý den, vážení kolegové</h3>
<p>Úplné aktuální informace o virtuálních strojích můžete vidět na disku H: tady:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Také v současné době jsou všechna pole VM správně vyplněna</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Tvoříme e-mail bez špatně vyplněných VM ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Souhrnné informace",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Zapisujeme data do DB #####
source(file = "DB.R", local = T, encoding = "utf-8")
Skript pro získání seznamu vm v PowerShell
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
Skript v PowerShell, který vytahuje z logů tvůrce virtuálních strojů a datum jejich vytvoření
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Zvláštní pozornost zasluhuje knihovna , která umožnila, aby bylo příloha k e-mailu přehledně naformátovaná (jak si přeje vedení), a ne jen obyčejná csv tabulka.
Vytvoření krásného xlsx dokumentu se seznamem nesprávně vyplněných strojů
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
Výstup vypadá asi takto:
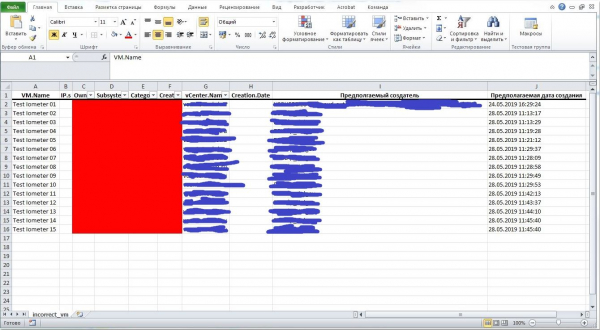
Také byl zajímavý detail při nastavování Windows scheduleru. Nepodařilo se nalézt správné parametry práv a nastavení, aby se všechno spouštělo, jak mělo. Nakonec byla nalezena knihovna R, která sama vytváří úkol pro spuštění R skriptu a dokonce nezapomíná na soubor pro logy. Poté lze úkol ručně upravit.
Kousek kódu v R s dvěma příklady, který vytváří úkol v plánovači Windows
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## spouštíme skript za 62 sekund
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## spouštíme skript každý den v 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## odstraňujeme úkoly
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Sledujeme logy (poslední 4 řádky)
tail(readLines("all_vm.log"), sep ="n", n = 4)
Zeptáme se na databázi
Po nastavení skriptu se objevily další otázky. Například bylo by fajn najít datum, kdy byla VM odstraněna, ale logy v vCenter již byly vymazány. Protože skript ukládá soubory do složky každý den a nečistí (čistíme ručně, když si vzpomeneme), lze prozkoumat staré soubory a najít první soubor, ve kterém daná VM není. Ale to není ideální.
Chtěl jsem vytvořit historickou databázi.
Na pomoc přišel funkčnost MS SQL SERVER — tabulka s časovou verzí. Obvykle se překládá jako časové (ne časově) tabulky.
Můžete si přečíst podrobnosti v .
Pokud to shrnu — vytvoříme tabulku, řekneme, že má verzi, a SQL Server vytvoří 2 dodatečné datetime sloupce v této tabulce (datum vytvoření záznamu a datum ukončení platnosti záznamu) a dodatečnou tabulku, do které budou zapisovány změny. V důsledku toho získáme aktuální informace a pomocí jednoduchých dotazů, jejichž příklady jsou uvedeny v dokumentaci, můžeme vidět buď životní cyklus konkrétní virtuální machine, nebo stav všech VM v určitém okamžiku.
Z hlediska výkonu — transakce zápisu do hlavní tabulky nebude dokončena, dokud nebude dokončena transakce zápisu do časové tabulky. Tedy u tabulek s velkým počtem zapisovacích operací je třeba tuto funkčnost implementovat s opatrností, ale v našem případě je to opravdu velmi zajímavá věc.
Aby mechanismus správně fungoval, musel jsem v R napsat malý kousek kódu, který by porovnával novou tabulku s daty o všech VM s těmi, které se ukládají do DB, a zapisoval pouze změněné řádky. Kód není příliš složitý, používá knihovnu compareDF, ale ten také uvedu níže.
Kód v R pro zápis dat do DB.
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Celkem
V důsledku zavedení skriptu byl za několik měsíců uveden do pořádku a je udržován pořádek. Někdy se objeví nesprávně vyplněné VM, ale skript slouží jako dobré připomenutí a vzácná VM se ocitne v seznamu 2 dny po sobě.
Byl vytvořen i základ pro analýzu historických dat.
Je jasné, že mnoho z tohoto lze realizovat ne "na koleně", ale pomocí specializovaného softwaru, ale úkol byl zajímavý a dá se říct, fakultativní.
R se znovu ukázal jako skvělý univerzální jazyk, který je ideální nejen pro řešení statistických úloh, ale také jako skvělá „vrstva“ mezi jinými zdroji dat.
Zdroj: habr.com
