

V létě tradičně klesá jak aktivita nakupujících, tak intenzita změn v infrastruktuře webových projektů, říká nám Kapitán Očividnost. Jen proto, že i IT odborníci, se stává, chodí na dovolenou. A CTO také. O to těžší to mají ti, kteří zůstávají na postu, ale teď o tom to není: možná právě proto je léto nejlepším obdobím na to, abychom v klidu přemýšleli o stávajícím systému zálohování a vytvořili plán na jeho zlepšení. A v tom vám bude užitečný zkušenost Egora Andrejeva z , o němž hovořil na konferenci .
Při budování záložních míst a při zálohování existuje několik pastí, do kterých se můžete dostat. A zapletat se do nich rozhodně nelze. A kazí nás na tom všem, stejně jako v mnoha jiných ohledech, perfekcionismus a… lenost. Snažíme se všechno dělat perfektně, ale není třeba dělat všechno dokonale! Je třeba udělat jen určité věci, ale udělat je správně, dotáhnout je do konce, aby normálně fungovaly.
Failover není nějaká vtipná záležitost pro zábavu; je to věc, která by měla udělat přesně jednu věc — snížit čas výpadku, aby služba a společnost ztrácely méně peněz. A ve všech metodách zálohování navrhuji přemýšlet v následujícím kontextu: kde jsou peníze?
První past: když budujeme velké spolehlivé systémy a zabýváme se zálohováním — snižujeme počet havárií. To je strašlivé mylné přesvědčení. Když se zabýváme zálohováním, pravděpodobně zvyšujeme počet havárií. A pokud všechno uděláme správně, snížíme celkově čas výpadku. Havárií bude více, ale budou se dít s menšími ztrátami. Co je zálohování? — to je ztížení systému. Jakékoli ztížení — to je špatně: přichází nám více šroubků, více ozubených kol, zkrátka více prvků — a tím pádem větší šance na poruchu. A skutečně se rozbijí. A budou se rozbíjet častěji. Jednoduchý příklad: dejme tomu, že máme nějaký web, s PHP, MySQL. A je naléhavě potřeba ho zálohovat.
Takže (c) Bereme druhou platformu, budujeme identický systém... Složitost se zdvojnásobuje — máme dvě entity. A navíc přidáváme určitou logiku přenosu dat z jedné platformy na druhou — tedy replikaci dat, kopírování statiky a tak dále. Logika replikace je obvykle velmi složitá, a proto může být celková složitost systému klidně 3, 5 nebo 10krát větší.
Druhá past: když budujeme opravdu velké složité systémy, fantazírujeme, co vlastně chceme na konci získat. Voilà: chceme superspolehlivý systém, který funguje bez jakéhokoli výpadku, přepíná se za půl sekundy (a nejlepší by bylo okamžitě), a začneme realizovat své sny. Ale tady je také nuance: čím kratší chceme dobu přepnutí, tím složitější logiku systému musíme vytvořit. Čím složitější logiku budeme muset udělat, tím častěji se systém bude porouchávat. A můžeme se dostat do velmi nepříjemné situace: snažíme se za každou cenu zkrátit dobu výpadku, ale ve skutečnosti to jenom komplikuje a když se něco nepovede, výpadek nakonec bude delší. Zde si často uvědomíte: lépe by bylo, kdybychom neprováděli zálohu. Bylo by lepší, kdyby to jedno fungovalo s jasnou dobou výpadku.
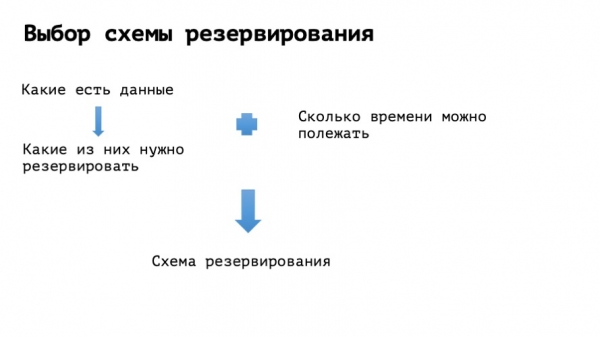
Jak se s tím dá bojovat? Musíme přestat si lhát, přestat si lichotit, že teď budeme stavět kosmickou loď, ale adekvátně pochopit, jak dlouho může projekt vydržet. A na základě této maximální doby budeme vybírat, jakými metodami zvýšíme spolehlivost našeho systému.
Je nejvyšší čas na „historie z j“... samozřejmě ze života.
Příklad číslo jedna
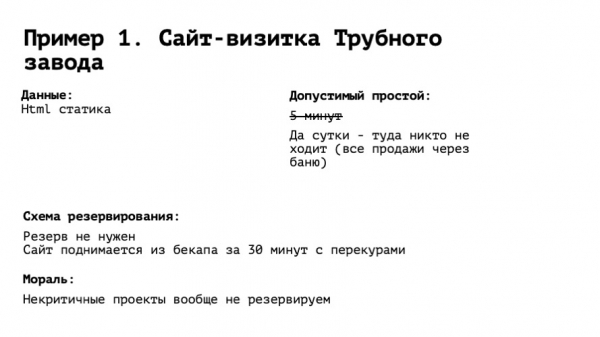
Představte si vizitkovou stránku trubkového závodu č. 1 města N. Na ní je napsáno obrovskými písmeny — TRUBKOVÝ ZÁVOD Č. 1. Trochu níže — slogan: „Naše trubky jsou nejkulatější trubky v N“. A dole je telefonní číslo generálního ředitele a jeho jméno. Chápu, že je potřeba rezervace — to je opravdu důležitá věc! Začínáme se zabývat tím, z čeho se to skládá. Html-statika — tedy pár obrázků, kde generální ředitel totiž sedí u stolu v sauně se svým partnerem a diskutují o nějakém dalším obchodu. Začínáme přemýšlet o době nečinnosti. Napadá nás: mít to tam musí být pět minut, maximálně. A tady otázka: kolik z naší stránky bylo celkově prodejů? Kolik kolik? Co znamená „nula“? A znamená to: protože všechny čtyři obchody za minulý rok generální uzavřel u stejného stolu, se stejnými lidmi, se kterými chodí do sauny a sedí za stolem. A uvědomujeme si, že i kdyby byla stránka nečinná jeden den — nic hrozného se nestane.
Na základě těchto informací máme den na realizaci této záležitosti. Začínáme přemýšlet o schématu rezervace. A vybíráme ideální schéma rezervace pro tento příklad: rezervaci nepotřebujeme. Tohle všechno se nastaví jakýmkoli administrátorem za půl hodiny s přestávkami. Nainstalovat webový server, umístit soubory — hotovo. Bude to fungovat. Na ničem není třeba dávat pozor, ničemu věnovat zvláštní pozornost. To znamená, že závěr z prvního příkladu je celkem jasný: služby, které není potřeba rezervovat — rezervovat není potřeba.
Příklad číslo dvě
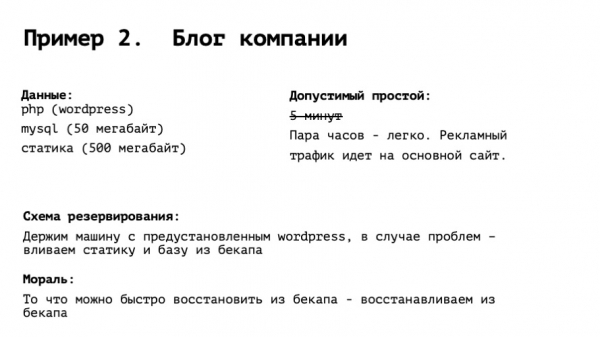
Blog společnosti: specializovaní lidé tam píší novinky, například jsme se účastnili určité výstavy, a tady jsme vydali další nový produkt a tak dále. Řekněme, že to je standardní PHP s WordPress, malá databáze a trocha statiky. Samozřejmě mě napadá, že ležet určitě nelze - „ne více než pět minut!“, to vše. Ale pojďme přemýšlet dál. Co tento blog dělá? Přicházejí na něj návštěvníci z Yandexu, z Googlu na základě nějakých dotazů, organicky. Skvělé. A jak jsou prodeje s tímto spojeny? Osvícení: moc ne. Reklamní provoz směřuje na hlavní web, který je na jiném serveru. Začínáme přemýšlet o schématu zálohování blogu. Opravu, za pár hodin by se měl znovu spustit, a k tomu by bylo dobré se připravit. Rozumné by bylo vzít stroj v jiném datovém centru, na něj nasadit prostředí, tedy webový server, PHP, WordPress, MySQL, a nechat to ležet ve spícím režimu. V okamžiku, kdy pochopíme, že se něco pokazilo, je třeba udělat dvě věci - obnovit dump mysql o 50 megabajtech, ten tam proletí za minutu, a obnovit nějaké množství obrázků z zálohy. To také nebude představovat velký problém. Takže za půl hodiny se to celé nastartuje. Žádné replikace ani, nedejbože, automatické přepínání. Závěr: to, co můžeme rychle obnovit ze zálohy, není potřeba zálohovat.
Příklad číslo tři, o něco složitější
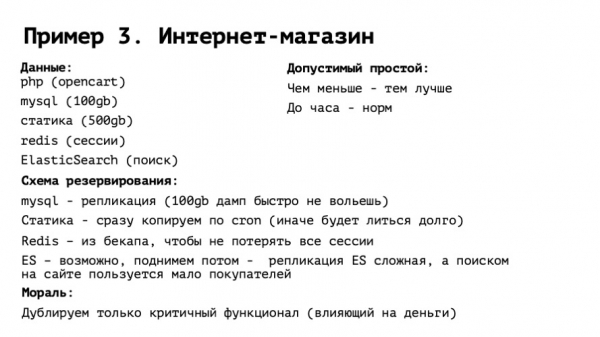
Internetový obchod. PhP s open heart trochu upravený, mysql s solidní databází. Docela hodně statiky (vždyť v internetovém obchodě jsou krásné HD obrázky a tak dále), Redis pro relace a Elasticsearch pro vyhledávání. Začínáme přemýšlet o době výpadku. A tady je samozřejmě zřejmé, že den, kdy bychom bezbolestně leželi, obchod nemůže být. Čím déle se leží, tím více peněz ztrácíme. Je třeba se urychlit. A jak moc? Předpokládám, že pokud budeme ležet hodinu, nikdo se nezblázní. Ano, něco ztratíme, ale začneme se snažit - bude to jen horší. Určujeme schéma, jak dlouho je výpadek akceptován v hodině.
Jak to vše lze rezervovat? Auto je v každém případě potřeba: hodina času — to je dost málo. Mysql: zde již potřebujeme replikaci, živou replikaci, protože za hodinu 100 GB do dumpu pravděpodobně nenaskáče. Statika, obrázky: opět, za hodinu 500 GB může nestihnout naskakovat. Takže je lepší ihned zkopírovat obrázky. Redis: tady to je zajímavější. V Redis jsou uloženy relace — prostě vzít a pohřbít ho nemůžeme. Protože to by nebylo příliš dobré: všichni uživatelé by byli odhlášeni, košíky vyprázdněny a tak dále. Lidé by museli znovu zadávat své přihlašovací údaje a mnoho z nich by se mohlo odhlásit a nákup nedokončit. Opět, konverze by klesla. Na druhou stranu, Redis je přímo aktuální, s posledními přihlášenými uživateli, asi také není potřeba. A dobrým kompromisem — vzít Redis a obnovit ho z zálohy, včerejší, nebo, pokud ji máte každou hodinu, — z hodinové. Naštěstí obnova z zálohy je kopírování jednoho souboru. A nejzajímavější příběh — to je Elasticsearch. Kdo kdy zřizoval replikaci MySQL? Kdo kdy zřizoval replikaci Elasticsearch? A u koho to potom normálně fungovalo? K čemu tím mířím: vidíme v našem systému nějakou entitu. Vypadá to jako užitečné — ale je to složité.
Je to složité v tom smyslu, že naši inženýři nemají s tímto zkušenosti. Buď mají negativní zkušenosti, nebo chápeme, že je to stále poměrně nová technologie s různými nuancemi nebo nezdary. Přemýšlíme... Sakra, elastic je taky velký, jeho obnova z backupu trvá také dlouho, co budeme dělat? Chápeme, že elastic je v našem případě použit pro vyhledávání. A jak prodává náš internetový obchod? Jdeme k marketérům, ptáme se, odkud lidé přicházejí. Odpovídají: „90 % přichází přímo z Yandex.Marketu na stránku produktu.“ A buď nakupují, nebo ne. Vyhledávání tedy potřebuje pouze 10 % uživatelů. Udržovat replikaci elasticu, zejména mezi různými datovými centry v různých zónách, má opravdu spoustu nuancí. Jaké je řešení? Vezmeme elastic na rezervované ploše a nebudeme s ním nic dělat. Pokud se to protáhne, někdy ho možná později zvedneme, ale to není jisté. Vlastně, závěr je plus mínus stejný: služby, které nemají vliv na peníze, opět nevyhrazujeme. Aby schéma zůstávalo jednodušší.
Příklad číslo čtyři, ještě složitější.
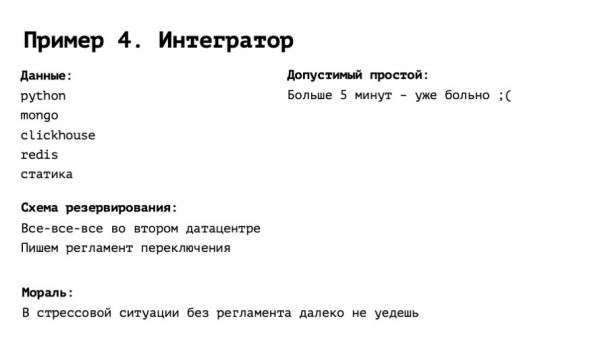
Integrator: prodej květin, volání taxislužby, prodej zboží, zkrátka cokoli. Váží záležitost, která pracuje 24/7 pro velký počet uživatelů. S plnohodnotnou zajímavou technologií, kde jsou zajímavé databáze, řešení, vysoké zatížení, a co je nejdůležitější, ležet mu více než 5 minut opravdu bolí. Nejen a nejen proto, že lidé nenakoupí, ale protože lidé uvidí, že tato věc nefunguje, zklamou a možná se už nikdy nevrátí.
Dobře. Pět minut. Co s tím budeme dělat? V tomto případě, dospělým způsobem, za všechny peníze budujeme skutečnou rezervovanou plochu, s replikací všeho a všecho, a možná dokonce automatizujeme maximálně přepnutí na tuto plochu. A k tomu nesmíme zapomenout na jednu důležitou věc: totiž napsat pravidla pro přepnutí. Pravidla, i když máte všechno a všecho automatizované, mohou být velmi jednoduchá. Například „spustit takovýto scénář ansible“, „v route 53 zaškrtnout takovou možnost“ a tak dále — ale mělo by to být nějaký přesný seznam kroků.
A zdá se, že je vše jasné. Přepnout replikaci — triviální úkol, buď se přepne sama. Přepsat doménové jméno v DNS — to samé. Problém je v tom, že když takový projekt spadne, začne panika, a i ti nejzkušenější admini jí mohou podléhat. Bez jasného návodu „otevři terminál, přejdi sem, adresa našeho serveru je stále taková“ je těžké držet pětiminutový časový limit na záchranu. A navíc, když tento předpis používáme, je snadné zafixovat nějaké změny v infrastruktuře, například — a odpovídajícím způsobem změnit předpis.
No, pokud je systém rezervace velmi složitý a v nějakém okamžiku uděláme chybu, můžeme zničit i naši záložní lokalitu, a navíc proměnit data v dýni na obou lokalitách — to bude opravdu smutné.
Příklad číslo pět, naprostý hardcore
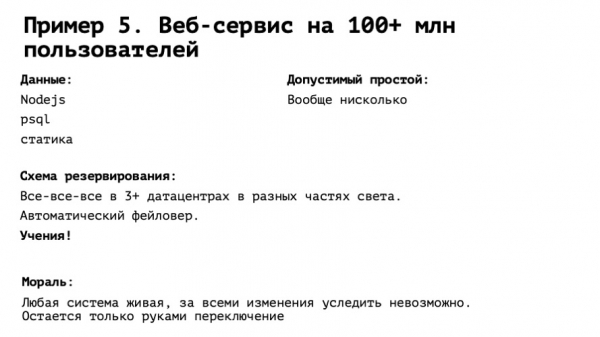
Mezinárodní služba se stovkami milionů uživatelů po celém světě. Všechny časová pásma, která existují, highload na maximum, nesmí být žádné výpadky. Minuta — a bude smutno. Co dělat? Zálohovat, opět naplno. Udělali jsme vše, co jsem říkal v předchozím příkladu, a ještě o kousek víc. Ideální svět, a naše infrastruktura — to je podle všech definic devops IaaC. To znamená, že vše je vůbec v gitu, a jen stiskni tlačítko.
Co chybí? Jedno — cvičení. Bez nich to nejde. Zdá se, že máme vše perfektní, vše je pod kontrolou. Stiskneme tlačítko, všechno se děje. I když tomu tak je — a my víme, že to tak není — náš systém interaguje s nějakými jinými systémy. Například, je to DNS od Route 53, S3 úložiště, integrace s nějakými API. Vše v tomto hypotetickém experimentu nemůžeme předvídat. A dokud reálně nevytrhneme vypínač — nezjistíme, jestli to bude fungovat nebo ne.
Na tom to asi je vše. Nezlenivěte a nepřehánějte to. A ať vás provází uptime!
Zdroj: habr.com
