

Dnes se budeme bavit o zajímavé technologii implementované v úložišti Unity/Unity XT – FAST VP. Pokud o Unity slyšíte poprvé, můžete si na odkazu na konci článku přečíst specifikace systému. V projektovém týmu Dell EMC jsem pracoval na FAST VP více než rok. Dnes vám chci podrobněji představit tuto technologii a odhalit některé detaily její realizace. Samozřejmě jen ty, které mohu sdílet. Pokud vás zajímají otázky efektivního ukládání dat, nebo pokud jste si ještě úplně nepročetli dokumentaci, tato článek bude jistě užitečný a zajímavý.
Hned na úvod řeknu, co v materiálu nebude. Nebude zde analýza konkurence a srovnání s nimi. Také neplánuji hovořit o podobných technologiích z open source, protože zvědavý čtenář už o nich ví. A samozřejmě nechci nic propagovat.
Úložné tiering. Cíle a úkoly FAST VP
FAST VP je zkratka pro Fully Automated Storage Tiering for Virtual Pool. Zní to složitě? Nic, teď si to objasníme. Tiering je způsob organizace ukládání dat, při kterém existuje několik úrovní (tiers), kde jsou tato data uložena. Každá úroveň má své vlastnosti. Nejznámější jsou: výkon, objem a cena za uložení jednotky informace. Samozřejmě mezi nimi existuje vztah.
Důležitou vlastností tieringu je, že přístup k datům je poskytován jednotně, bez ohledu na to, na které úrovni úložiště se v danou chvíli nachází, a velikost poolu se rovná součtu velikostí zdrojů, které do něj patří. Zde jsou rozdíly od cache: velikost cache se nepřičítá k celkovému objemu zdroje (v tomto případě poolu), zatímco data v cache duplikují nějaký fragment dat z primárního média (nebo jej budou duplikovat, pokud data z cache ještě nebyla zapsána). Rozdělení dat podle úrovní je uživateli skryto. To znamená, že nevidí, jaká konkrétní data jsou na každé úrovni, ačkoliv může na to nepřímo působit prostřednictvím nastavení politik (o těch později).
Nyní se podívejme na zvláštnosti implementace storage tieringu v Unity. V Unity se vyčleňují 3 úrovně neboli tiers:
- Extrémní výkon (SSD)
- Výkon (SAS HDD 10k/15k RPM)
- Kapacita (NL-SAS HDD 7200 RPM)
Jsou seřazeny podle klesajícího výkonu a ceny. V Extreme performance jsou zahrnuty výhradně pevné disky (SSD). V dalších dvou úrovních jsou to magnetické disky, které se liší rychlostí otáčení a tedy i výkonem.
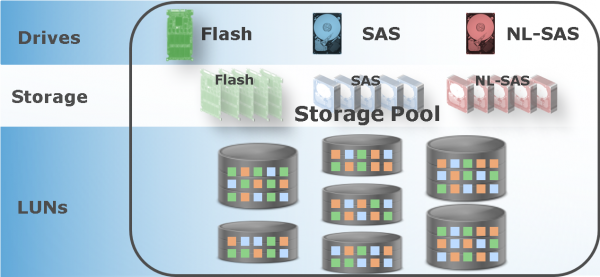
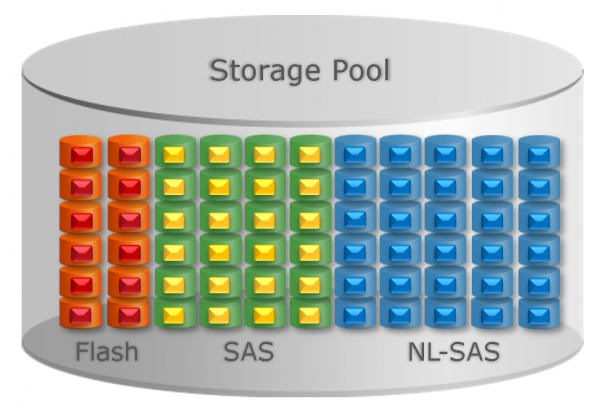
Úložné prostředky stejné úrovně a velikosti se spojují do RAID pole, čímž vzniká RAID skupina (RAID group, zkráceně – RG); o dostupných a doporučených úrovních RAID se můžete dočíst v oficiální dokumentaci. Z RAID skupin jedné nebo více úrovní se tvoří úložiště dat (Storage pool), ze kterého se potom distribuuje volné místo. A už z poolu je vyčleněno místo pro souborové systémy a LUNy.
Proč potřebuju tiering?
Krátce a abstraktně: abych dosáhl většího výsledku s minimem zdrojů. Pokud to řekneme konkrétněji, výsledkem se obvykle rozumí soubor vlastností úložných systémů – rychlost a doba přístupu, náklady na úložiště a další. Minimem zdrojů se myslí co nejnižší náklady: peněz, energie a podobně. FAST VP právě implementuje mechanismy přerozdělování dat mezi různými úrovněmi v úložném systému Unity/Unity XT. Pokud mi věříte, můžete přeskočit následující odstavec. Pro ostatní řeknu něco podrobněji.
Správné přerozdělení dat mezi úrovněmi úložiště umožňuje ušetřit na celkových nákladech úložného systému, obětováním rychlosti přístupu k některým zřídka používaným informacím a zvýšením výkonu přesunem často používaných dat na rychlejší zařízení. Někdo by mohl namítnout, že i bez tieringu normální administrátor ví, kam jaká data umístit, jaké vlastnosti úložného systému jsou žádoucí pro jeho úkol atd. To je bezpochyby pravda, ale „ruční“ přerozdělování dat má své nevýhody:
- vyžaduje čas a pozornost administrátora;
- ne vždy se podaří „přeorganizovat“ zdroje úložného systému podle změněných podmínek;
- mizí důležitá výhoda: unifikovaný přístup k prostředkům umístěným na různých úrovních úložiště.
Aby se správci storage méně obávali o jistotu zaměstnání, dodám, že efektivní plánování zdrojů je také nezbytné. Teď, když jsou úkoly tieringu stručně nastíněny, podívejme se, co můžeme očekávat od FAST VP. Je čas vrátit se k definici. První dvě slova – Fully Automated – se překládají jako „plně automatizovaný“ a znamenají, že rozdělení podle úrovní probíhá automaticky. A Virtual Pool je soubor dat, který zahrnuje zdroje z různých úrovní úložiště. Takto to vypadá:
Předem řeknu, že FAST VP přesouvá data pouze uvnitř jednoho poolu, nikoli mezi několika pooly.
Úkoly řešené FAST VP
Nejprve se podívejme na to abstraktně. Máme pool a nějaký mechanismus, který může redistribuovat data uvnitř tohoto poolu. Při paměti na to, že naším cílem je dosáhnout maximální výkon, si položme otázku: jakými způsoby jej můžeme dosáhnout? Může jich být několik, a zde má FAST VP co nabídnout uživateli, protože technologie představuje něco víc než jen storage tiering. Zde jsou způsoby, jak může FAST VP zvýšit výkon poolu:
- Rozdělení dat mezi různé typy disků, úrovně
- Rozdělení dat mezi disky jednoho typu
- Rozdělení dat při rozšíření poolu
Než budeme rozebírat, jak jsou tyto úkoly řešeny, musíme znát některé nezbytné skutečnosti o fungování FAST VP. FAST VP operuje s bloky určité velikosti – 256 megabajtů. To je minimální kontinuální „kousek“ dat, který může být přesunut. V dokumentaci se mu říká slice. Z pohledu FAST VP se všechny RAID skupiny skládají z těchto „kousků“. Odpovídajícím způsobem se všechny statistiky vstupu a výstupu shromažďují pro takové bloky dat. Proč byla zvolena právě taková velikost bloku a bude zmenšena? Blok je dostatečně velký, ale to je kompromis mezi granularitou dat (menší velikost bloku – přesnější rozdělení) a dostupnými výpočetními zdroji: při stávajících tvrdých omezeních na operační paměť a velkém počtu bloků mohou statistická data zabírat příliš mnoho místa a množství výpočtů se zvýší úměrně.
Jak FAST VP umisťuje data v poolu. Politiky
Pro správu umístění dat v rámci poolu s aktivovaným FAST VP existují tyto politiky:
- Nejvyšší dostupná úroveň
- Automatická úroveň
- Začněte na vysoké úrovni, pak automatická úroveň (výchozí)
- Nejnižší dostupná úroveň
Ovlivňují jak počáteční umístění bloku (data jsou poprvé zapsána), tak následné přealokování. Jakmile jsou data uložena na discích, přealokace bude iniciována podle plánu nebo ručně.
Nejvyšší dostupná úroveň se snaží umístit nový blok na nejvýkonnější úroveň. Pokud na ní není dostatek místa, umístí je na další výkonnější úroveň, ale později mohou být data přesunuta na výkonnější úroveň (pokud je k dispozici místo nebo pokud nahradí jiná data). Automatická úroveň umisťuje nová data na různé úrovně v závislosti na velikosti dostupného prostoru, a přealokují se podle poptávky a volného místa. Začněte na vysoké úrovni, pak automatická úroveň – politikou výchozí a také doporučená. Při počátečním umístění funguje jako nejvyšší dostupná úroveň, a pak dochází k přesunu dat v závislosti na jejich statistikách využití. Politika nejnižší dostupné úrovně se snaží umístit data na nejméně výkonnou úroveň.
Přenos dat probíhá s nízkou prioritou, aby nenarušoval užitečnou činnost SDD, nicméně existuje nastavení „Data relocation rate“, které mění prioritu. Zde je zvláštnost: ne všechny datové bloky mají stejnou pořadí přealokace. Například bloky označené jako metadata budou přesunuty na rychlejší úroveň jako první. Metadata jsou, jak se to dá říct, „data o datech“, určitá dodatečná informace, která není uživatelskými daty, ale uchovává jejich popis. Například informace v souborovém systému o tom, ve kterém bloku se nachází konkrétní soubor. Rychlost přístupu k datům tedy závisí na rychlosti přístupu k metadatům. Vzhledem k tomu, že metadata jsou obvykle mnohem menší, očekává se větší výhoda z jejich přesouvání na výkonnější disky.
Kritéria, která Fast VP používá v praxi
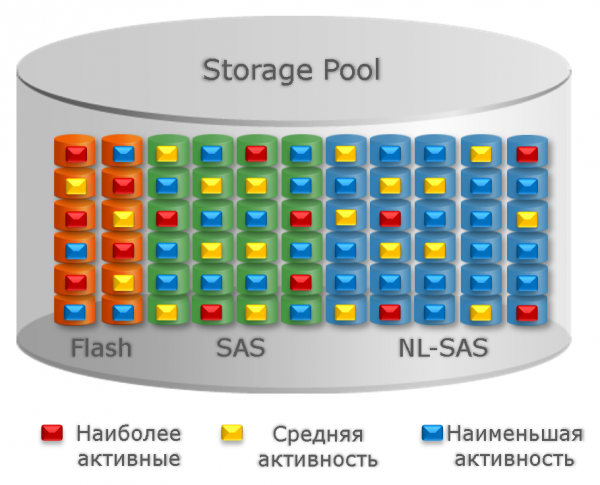
Hlavním kritériem pro každý blok, pokud to velmi zjednodušíme, je charakteristika "popularity" dat, která závisí na počtu operací čtení a zápisu daného datového fragmentu. Tato charakteristika se u nás nazývá „Teplota“. Existují populární (hot) data, která jsou "teplejší" než nepopulární. Vypočítává se pravidelně, ve výchozím nastavení v intervalu jedné hodiny.
Funkce výpočtu teploty má následující vlastnosti:
- Při absenci vstupu/výstupu data s časem "ochlazují".
- Při více méně konstantní zátěži v čase teplota nejprve roste a poté se stabilizuje v určitém rozmezí.
Dále se zohledňují politiky popsané výše a volné místo na každém tieru. Pro názornost uvedu obrázek z dokumentace. Tady jsou červeně, žlutě a modře označeny bloky s vysokou, střední a nízkou teplotou.
Ale vraťme se k úkolům. Takže můžeme začít rozebírat to, co se dělá k řešení úloh FAST VP.
A. Rozdělení dat mezi různé typy disků, úrovně
To je hlavní úkol FAST VP. Ostatní jsou v určitém smyslu odvozené od něj. V závislosti na zvolené politice budou data rozdělena mezi různé úrovně ukládání. Nejprve se zohledňuje politika umístění, poté teplota bloků a velikost/rýchlost RAID skupin.
Pro politiky Nejvyšší/Několik dostupných tierů je to dost jednoduché. Pro zbývající dvě situace je to tak. Data se rozdělují mezi různé úrovně s ohledem na velikost a výkon RAID skupin: tak, aby poměr celkové „teploty“ bloků k „podmíněné maximální výkonnosti“ každé RAID skupiny byl přibližně stejný. Tímto způsobem se zátěž rozděluje více méně rovnoměrně. Více žádaná data se přesouvají na rychlé nosiče, zřídka používaná – na pomalejší. Ideálně by rozdělení mělo vypadat přibližně takto:
B. Rozdělení dat mezi disky stejného typu
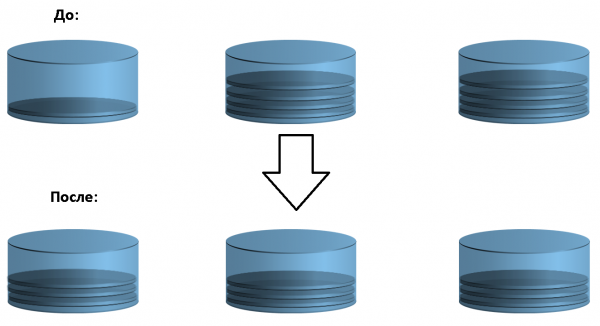
Pamatujete, na začátku jsem psal, že nosiče informací z jednoho nebo několika Jak se úrovně spojují do jednoho poolu? U jediného levelu pro FAST VP také existuje práce. Aby byla výkonnost jakékoli úrovně maximální, je vhodné rozložit data rovnoměrně mezi disky. To teoreticky umožní dosáhnout maximálního počtu IOPS. Data uvnitř RAID skupiny lze považovat za rovnoměrně rozložená mezi disky, avšak mezi RAID skupinami to rozhodně není vždy tak. V případě disbalance FAST VP přesune data mezi RAID skupinami úměrně jejich objemu a „podmíněné výkonnosti“ (v číselném vyjádření). Pro názornost ukážu schéma rebalance mezi třemi RAID skupinami:
V. Rozložení dat při rozšíření poolu
Tento úkol je zvláštním případem předchozího a provádí se, když je do poolu přidána RAID skupina. Aby nově přidaná RAID skupina nezůstala nevyužita, část dat bude přesunuta na ni, a tím bude zatížení všech RAID skupin přerozděleno.
Vyrovnávání opotřebení SSD
Pomocí vyrovnávání opotřebení může FAST VP prodloužit životnost SSD, i když tato funkce přímo nesouvisí s Storage Tiering. Vzhledem k tomu, že již existují údaje o teplotě, také se zohledňuje počet zápisových operací, my umíme přesouvat bloky dat, bylo by logické, aby FAST VP tuto úlohu také vyřešilo.
V případě, že počet zápisů do jedné RAID skupiny výrazně převyšuje počet zápisů do druhé, FAST VP přerozdělí data v souladu s počtem zapisovacích operací. Z jedné strany to snižuje zátěž a šetří zdroje některých disků, z druhé strany to přidává „práci“ pro méně zatížené, čímž zvyšuje celkovou výkonnost.
FAST VP si tak bere na sebe tradiční úkoly Storage Tiering a dělá ještě o něco více. To vše umožňuje efektivně ukládat data v úložištích rodiny Unity.
Několik rad
- Nedopusťte, abyste opomněli číst dokumentaci. Existují nejlepší praktiky, které fungují poměrně dobře. Pokud se jimi budete řídit, obvykle nevznikají závažné problémy. Ostatní rady většinou opakují nebo doplňují tyto.
- Pokud jste nastavili a aktivovali FAST VP, je lepší ho nechat zapnutý. Nechte ho rozdělovat data v přiděleném čase a postupně, místo toho, aby se to dělalo jednou za rok a vážně ovlivnilo výkon jiných úloh. V takových případech může redistribution dat trvat dlouho.
- Pečlivě zvažte výběr okna pro relokaci. Ačkoliv je to zřejmé, pokuste se vybrat čas s nejmenším zatížením pro Unity a vyčleňte dostatečné časové okno.
- Plánujte rozšíření úložiště, dělejte to včas. To je obecné doporučení, které platí i pro FAST VP. Pokud je objem volného místa velmi malý, může se přesun dat zpomalit nebo stát nemožným. Zvlášť, pokud jste ignorovali bod 2.
- Při rozšiřování poolu se zapnutým FAST VP byste neměli začínat s nejpomalejšími disky. To znamená, buď přidělujte všechny plánované RAID skupiny najednou, nebo nejprve přidejte nejrychlejší disky. V tomto případě přenos dat na nové "rychlé" disky zvýší celkovou rychlost poolu. Naopak, pokud začnete s "pomalejšími" disky, můžete se dostat do velmi nepříjemné situace. Nejprve dojde k přenosu dat na nové, relativně pomalé disky a potom, při přidání rychlejších, opačným směrem. Zde jsou nuance spojené s různými politikami FAST VP, ale v obecném případě je taková situace možná.
Pokud se díváte na tento produkt, můžete vyzkoušet Unity v akci zdarma stažením Unity VSA virtuálního zařízení.
Na závěr materiálu sdílím několik užitečných odkazů:
- Stránka
- – stručný popis funkce
- , formát pdf
Závěr
Rád bych napsal o mnoha věcech, ale chápu, že ne všechny detaily budou čtenáře zajímat. Například bych mohl podrobněji hovořit o kritériích, podle kterých FAST VP rozhoduje o přenosu dat, o procesech analýzy statistiky vstupu a výstupu. Také jsem se vůbec nezmínil o tématu spolupráce s , což by si zasloužilo samostatný článek. Mohli bychom dokonce spekulovat o budoucím vývoji této technologie. Doufám, že to nebylo nudné a nezapomněl jsem vás unavit. Na shledanou!
Zdroj: habr.com
