

V dnešní době si nelze představit projekt založený na Kubernetes bez technologie ELK, pomocí které se ukládají logy jak aplikací, tak systémových komponent clustrů. Ve své praxi používáme stack EFK s Fluentd místo Logstash.
Fluentd je moderní univerzální sběrač logů, který získává stále větší popularitu a stal se součástí Cloud Native Computing Foundation, což směřuje jeho vývoj k používání v kombinaci s Kubernetes.
Použití Fluentd místo Logstash nemění celkovou podstatu softwarového komplexu, avšak Fluentd má své vlastní specifické nuance vyplývající z jeho multifunkčnosti.
Například, když jsme začali používat EFK v zatíženém projektu s vysokou intenzitou zápisu logů, setkali jsme se s tím, že se v Kibana některé zprávy zobrazují opakovaně několikrát. V tomto článku vám vysvětlíme, proč k tomuto jevu dochází a jak problém vyřešit.
Problém duplicity dokumentů
V našich projektech je Fluentd nasazen jako DaemonSet (automaticky se spouští v jednom exempláři na každém uzlu clustru Kubernetes) a sleduje stdout logy kontejnerů v /var/log/containers. Po shromáždění a zpracování se logy ve formátu JSON dokumentů dostávají do ElasticSearch, který je spuštěn jak v clusterovém, tak i standalone režimu, v závislosti na rozsahu projektu a požadavcích na výkon a spolehlivost. Jako grafické rozhraní se používá Kibana.
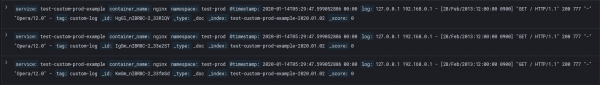
Při použití Fluentd s bufferovacím pluginem na výstupu jsme čelili situaci, kdy některé dokumenty v ElasticSearch mají zcela shodný obsah a liší se pouze identifikátorem. Můžeme potvrdit, že se skutečně jedná o opakování zprávy na příkladu logu Nginx. V logovém souboru existuje toto sdělení v jediném exempláři:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Avšak v ElasticSearch existuje několik dokumentů, které obsahují tuto zprávu:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}
To může být více než dvě opakování.
Při vyšetřování tohoto problému lze v logech Fluentd zaznamenat značné množství varování následujícího typu:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] nedošlo k vyprázdnění vyrovnávací paměti. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="nebylo možné odeslat logy do Elasticsearch clusteru ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): vypršel čas pro čtení"Tato varování se objevují, když ElasticSearch není schopen vrátit odpověď na požadavek během doby stanovené parametrem request_timeout, takže odesílaný fragment vyrovnávací paměti není možné vyprázdnit. Poté se Fluentd pokouší znovu odeslat fragment vyrovnávací paměti do ElasticSearch a po libovolném počtu pokusů je operace úspěšná:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] pokus o opakování byl úspěšný. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] pokus o opakování byl úspěšný. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] pokus o opakování byl úspěšný. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] pokus o opakování byl úspěšný. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] pokus o opakování byl úspěšný. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Avšak ElasticSearch považuje každou z odeslaných fragmentů vyrovnávací paměti za unikátní a při indexaci jim přiřazuje unikátní hodnoty polí _id. Tak se objevují kopie zpráv.
V Kibana to vypadá takto:
Řešení problému
Existuje několik možností, jak tento problém vyřešit. Jednou z nich je mechanismus generování unikátního hashe pro každý dokument, který je zabudován v plug-inu fluent-plugin-elasticsearch. Pokud se tento mechanismus použije, ElasticSearch bude rozpoznávat duplicity během přenosu a zabrání duplicitním dokumentům. Je však třeba si uvědomit, že tato metoda řešení se zaměřuje na následky a neodstraňuje chybu nedostatku časového limitu, proto jsme se rozhodli ji nepoužívat.
Používáme bufferovací plug-in pro Fluentd na výstupu, abychom zabránili ztrátě logů v případě krátkodobých problémů se sítí nebo zvýšené intenzity zápisu logů. Pokud z nějakého důvodu ElasticSearch nemůže okamžitě zapsat dokument do indexu, dokument se dostává do fronty, která je uchovávána na disku. Proto je v našem případě, abychom odstranili zdroj problému, který vede k výše popsané chybě, nezbytné nastavit správné hodnoty pro parametry bufferování, při kterých bude výstupní buffer Fluentd dostatečně velký a zároveň se bude stíhat vyprázdnit v rámci stanoveného času.
Je třeba poznamenat, že hodnoty parametrů, o nichž se bude hovořit níže, jsou individuální v každém konkrétním případě použití bufferování ve výstupních plug-inech, jelikož závisí na mnoha faktorech: intenzitě zápisu logových zpráv službami, výkonu diskového systému, zatížení síťového kanálu a jeho propustnosti. Proto, abyste získali vhodná, ale ne nadměrná nastavení bufferu pro každý jednotlivý případ a vyhnuli se dlouhému procházení za slepo, můžete využít debugovací informace, které Fluentd zapisuje do svého logu během provozu a relativně rychle získat správné hodnoty.
Když byl problém zaznamenán, konfigurace vypadala následovně:
 <buffer>
        @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
      <\/buffer>
Při řešení problému byly ručně vybraný hodnoty následujících parametrů:
chunk_limit_size — velikost chunků, na které se rozdělují zprávy v bufferu.
- flush_interval — interval času, po kterém dochází k vyprázdnění vyrovnávací paměti.
- queue_limit_length — maximální počet chunků v queue.
- request_timeout — doba, po kterou je navázáno spojení mezi Fluentd a ElasticSearch.
Celkovou velikost vyrovnávací paměti lze vypočítat jako součin parametrů queue_limit_length a chunk_limit_size, což lze interpretovat jako „maximální počet chunků v queue, přičemž každý má stanovenou velikost“. Pokud je vyrovnávací paměť nedostatečná, v logu se objeví následující varování:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] failed to write data into buffer by buffer overflow action=:blockTo znamená, že vyrovnávací paměť nestíhá vyprázdnit data v přiděleném čase a data, která přicházejí do zaplněné vyrovnávací paměti, jsou blokována, což povede ke ztrátě části logů.
Vyrovnávací paměť lze zvýšit dvěma způsoby: zvýšením buď velikosti každého chunku v queue, nebo počtu chunků, které mohou v queue být.
Pokud je velikost chunku chunk_limit_size nastavena na více než 32 megabajtů, ElasticSearch jej nepřijme, protože příchozí paket bude příliš velký. Proto je lepší, pokud chcete vyrovnávací paměť ještě více zvýšit, zvyšovat maximální délku queue queue_limit_length.
Když se vyrovnávací paměť přestane přetékati a zůstane pouze zpráva o nedostatku času na timeout, lze začít zvyšovat parametr request_timeout. Nicméně, pokud nastavíte hodnotu vyšší než 20 sekund, v logech Fluentd se začnou objevovat následující varování:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] buffer flush took longer time than slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Tato zpráva nijak neovlivňuje funkci systému a znamená, že doba vyprázdnění vyrovnávací paměti trvala déle, než je nastaveno parametrem slow_flush_log_threshold. Je to diagnostická informace a používáme ji při ladění hodnoty parametru request_timeout.
Obecný algoritmus ladění vypadá následovně:
- Nastavit hodnotu request_timeout zaručeně vyšší, než je potřeba (desítky sekund). Hlavním kritériem správnosti nastavení tohoto parametru bude během ladění zmizení varování o nedostatku času na timeout.
- Čekat na zprávy o překročení prahu slow_flush_log_threshold. V textu varování v poli elapsed_time bude napsána skutečná doba vyprázdnění vyrovnávací paměti.
- Nastavte hodnotu request_timeout vyšší než maximální hodnota elapsed_time získaná za období sledování. Vypočítáváme hodnotu request_timeout jako elapsed_time + 50%.
- Abychom odstranili varování o dlouhém vyprázdnění ze záznamu, můžeme zvýšit hodnotu slow_flush_log_threshold. Tuto hodnotu vypočítáváme jako elapsed_time + 25%.
Konečné hodnoty těchto parametrů, jak bylo zmíněno dříve, jsou individuální pro každý případ. Následováním výše uvedeného algoritmu zaručujeme odstranění chyby, která vede k opakování zpráv.
V tabulce níže je znázorněno, jak se mění počet chyb za den vedoucích k duplikaci zpráv během ladění hodnot výše uvedených parametrů:
node-1
node-2
node-3
node-4
Před/Po
Před/Po
Před/Po
Před/Po
nepodařilo se vyprázdnit buffer
1749/2
694/2
47/0
1121/2
opakovaný pokus byl úspěšný
410/2
205/1
24/0
241/2
Je třeba také poznamenat, že získané nastavení může ztratit svou aktuálnost během růstu projektu a tím pádem i zvýšení počtu logů. Primárním znakem nedostatečného nastaveného časového limitu je návrat zpráv Fluentd o dlouhém vyprázdnění bufferu, což znamená překročení prahu slow_flush_log_threshold. Od této chvíle existuje ještě malý prostor před překročením parametru request_timeout, proto je třeba na tyto zprávy včas reagovat a znovu provést proces ladění optimálních nastavení, jak bylo popsáno výše.
Závěr
Jemné ladění výstupního bufferu Fluentd je jedním z hlavních kroků při nastavování EFK stacku, které určuje stabilitu jeho fungování a správnost ukládání dokumentů do indexů. Podle popsaného algoritmu nastavení si můžete být jisti, že všechny logy budou zapsány do indexu ElasticSearch ve správném pořadí, bez opakování a ztrát.
Také si přečtěte další články na našem blogu:
Zdroj: habr.com
