

Tým nabízí inženýra Rahula Bhatia z firmy Clairvoyant o tom, jaké existují formáty souborů v big datech, jaké jsou nejběžnější funkce formátů Hadoop a který formát je nejlepší použít.
Proč jsou potřeba různé formáty souborů
Závažným úzkým místem v výkonu aplikací podporujících HDFS, jako jsou MapReduce a Spark, je čas potřebný k vyhledávání, čtení a zápisu dat. Tyto problémy se zhoršují obtížemi při správě velkých objemů dat, pokud nemáme statickou, ale vyvíjející se schéma, nebo existují nějaká omezení na ukládání.
Zpracování big dat zvyšuje zátěž na subsystém úložiště — Hadoop ukládá data redundantně pro zajištění odolnosti vůči chybám. Kromě disků jsou zatíženy procesor, síť, systém vstupu a výstupu a další. S rostoucím objemem dat se zvyšují také náklady na jejich zpracování a ukládání.
Různé formáty souborů v byly vymyšleny právě pro řešení těchto problémů. Výběr vhodného formátu souboru může přinést některé významné výhody:
- Rychlejší čas čtení.
- Rychlejší čas zápisu.
- Sdílené soubory.
- Podpora evoluce schémat.
- Rozšířená podpora komprese.
Některé formáty souborů jsou určeny pro všeobecné použití, jiné pro specifičtější varianty a některé byly vyvinuty s ohledem na konkrétní charakteristiky dat. Skutečně existuje široký výběr.
Formát souborů Avro
Pro serializace dat se široce používá Avro — jedná se o řetězcově založený, tedy textový, formát ukládání dat v Hadoopu. Ukládá schéma ve formátu JSON, což usnadňuje jeho čtení a interpretaci jakýmkoli programem. Samotná data jsou uložena v binárním formátu, což je kompaktní a efektivní.
Systém serializace Avro je neutrální vůči jazyku. Soubory lze zpracovávat různými jazyky, v současnosti to jsou C, C++, C#, Java, Python a Ruby.
Klíčovou vlastností Avro je spolehlivá podpora datových schémat, která se v průběhu času mění, tedy evolvují. Avro rozumí změnám schémat — odstranění, přidání nebo změně polí.
Avro podporuje různé struktury dat. Například lze vytvořit záznam, který obsahuje pole, výčtový typ a podzáznam.
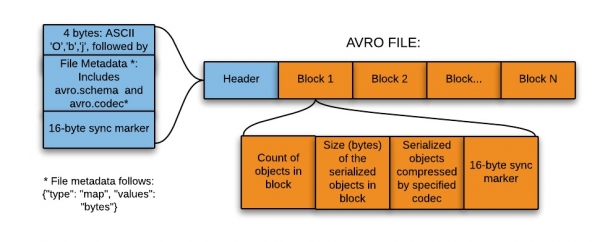
Tento formát je ideální pro zápis do přechodné zóny datového jezera (, nebo data lake - kolekce instancí pro ukládání různých typů dat v doplnění k samotným zdrojům dat).
Takže pro zápis do přechodné zóny datového jezera je tento formát nejlepší z následujících důvodů:
- Data z této zóny se obvykle čtou celá pro další zpracování dolními systémy - a formát založený na řádcích je v tomto případě efektivnější.
- Dolní systémy mohou snadno extrahovat tabulky schémat z souborů - není nutné uchovávat schémata samostatně ve vnějším meta-úložišti.
- Jakákoliv změna počátečního schématu se snadno zpracovává (evoluce schématu).
Formát souborů Parquet
Parquet je open-source formát souborů pro Hadoop, který ukládá vnořené datové struktury v plochém sloupcovém formátu..
Ve srovnání s tradičním řádkovým přístupem je Parquet efektivnější z hlediska úložného prostoru a výkonu.
To je zvlášť užitečné pro dotazy, které čtou určité sloupce z široké (s mnoha sloupci) tabulky. Díky formátu souborů se čtou pouze potřebné sloupce, takže se minimalizuje vstupně-výstupní operace.
Malé odbočení-vysvětlení: abychom lépe pochopili formát souboru Parquet v Hadoopu, podívejme se, co je sloupcový formát - tedy sloupcový formát. V takovém formátu se společně ukládají hodnoty stejného typu pro každý sloupec.
, záznam obsahuje pole ID, Name a Department. V tomto případě budou všechny hodnoty sloupce ID uloženy dohromady, stejně jako hodnoty sloupce Name atd. Tabulka bude mít přibližně takovýto vzhled:
ID
Název
Department
1
emp1
d1
2
emp2
d2
3
emp3
d3
V řádkovém formátu se data uloží následujícím způsobem:
1
emp1
d1
2
emp2
d2
3
emp3
d3
Ve sloupcovém formátu souborů se stejná data uloží takto:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Sloupcový formát je efektivnější, když potřebujete dotazovat z tabulky několik sloupců. Přečte pouze potřebné sloupce, protože jsou blízko sebe. Tím se minimalizují operace vstup/výstup.
Například, potřebujete pouze sloupec NAME. V Každý záznam v datové sadě je třeba načíst, rozložit na pole a poté extrahovat data NAME. Sloupcový formát umožňuje přímo přejít na sloupec Name, protože všechny hodnoty pro tento sloupec jsou uloženy dohromady. Není nutné procházet celý záznam.
Tímto způsobem sloupcový formát zvyšuje výkon dotazů, protože pro přechod k požadovaným sloupcům je potřeba méně času na vyhledávání a snižuje se množství vstupně-výstupních operací, protože se čtou pouze potřebné sloupce.
Jedním z jedinečných rysů je to, že v tomto formátu může uchovávat data s vnořenými strukturami. To znamená, že v souboru Parquet lze dokonce číst vnořená pole odděleně, aniž by bylo nutné číst všechna pole ve vnořené struktuře. Parquet používá algoritmus rozdělování a sestavování k uchovávání vnořených struktur.
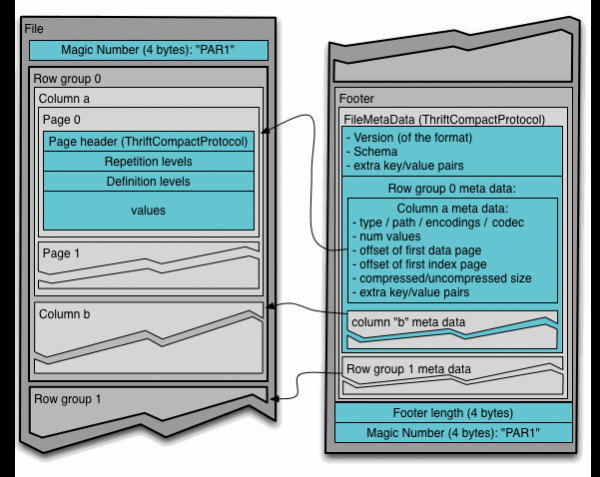
Abychom pochopili formát souboru Parquet v Hadoopu, je třeba znát následující termíny:
- Skupina řádků (row group): logické horizontální rozdělení dat na řádky. Skupina řádků se skládá z fragmentu každého sloupce v sadě dat.
- Fragment sloupce (column chunk): fragment konkrétního sloupce. Tyto fragmenty sloupců se nacházejí v určité skupině řádků a zaručeně budou sousedící v souboru.
- Stránka (page): fragmenty sloupců jsou rozděleny na stránky, které jsou zapisovány za sebou. Stránky mají společnou hlavičku, takže při čtení lze přeskočit nepotřebné.
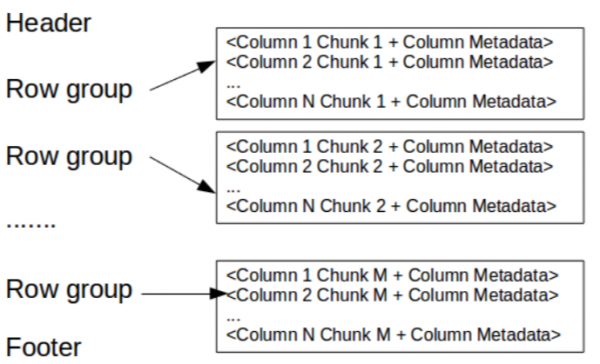
Zde hlavička jednoduše obsahuje magické číslo PAR1 (4 bajty), které identifikuje soubor jako soubor formátu Parquet.
V patičce je uvedeno následující:
- Metadatové soubory, které obsahují počáteční souřadnice metadat každého sloupce. Při čtení je nejprve potřeba přečíst metadata souboru, abychom našli všechny zajímavé fragmenty sloupců. Poté by měly být fragmenty sloupců čteny postupně. Další metadata zahrnují verzi formátu, schéma a jakékoli další páry klíč-hodnota.
- Délka metadat (4 bajty).
- Magické číslo PAR1 (4 bajty).
Formát souborů ORC
Optimalizovaný řádkově-sloupcový formát souborů (Optimized Row Columnar, ) nabízí velmi efektivní způsob ukládání dat a byl navržen tak, aby překonal omezení jiných formátů. Ukládá data v dokonale kompaktní podobě, což umožňuje vynechat nepotřebné detaily — a zároveň nevyžaduje vytváření velkých, složitých nebo ručně spravovaných indexů.
Výhody formátu ORC:
- Jeden soubor na výstupu každého úkolu, což snižuje zátěž na NameNode (uzel názvů).
- Podpora typů dat Hive, včetně DateTime, desetinných a složitých datových typů (struct, list, map a union).
- Současné čtení stejného souboru různými procesy RecordReader.
- Možnost rozdělení souborů bez skenování na přítomnost markerů.
- Odhad maximálního možného přidělení paměti haldy pro procesy čtení/zápisu podle informací v patičce souboru.
- Metadatové informace jsou uloženy v binárním formátu serializace Protocol Buffers, což umožňuje přidávat a odstraňovat pole.
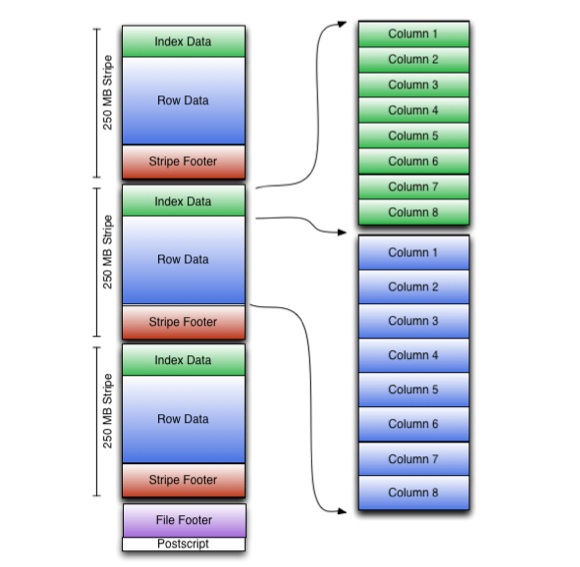
ORC ukládá kolekce řetězců v jednom souboru, přičemž uvnitř kolekce jsou řetězcové údaje uloženy ve sloupcovém formátu.
Soubory ORC ukládají skupiny řetězců, které se nazývají pruhy (stripes), a další informace v patičce souboru. Postscript na konci souboru obsahuje parametry komprese a velikost komprimované patičky.
Výchozí velikost pruhu je 250 MB. Díky tak velkým pruhům se čtení z HDFS provádí efektivněji: ve velkých souvislých blocích.
V patičce souboru je uveden seznam pruhů v souboru, počet řetězců na pruh a typ dat každého sloupce. Tam je také zaznamenána výsledná hodnota count, min, max a sum pro každý sloupec.
Patička pruhu obsahuje adresář umístění proudu.
Řetězcové údaje se používají při skenování tabulek.
Indexové údaje zahrnují minimální a maximální hodnoty pro každý sloupec a pozice řetězců v každém sloupci. Indexy ORC se používají pouze k výběru pruhů a skupin řetězců, nikoli k odpovídání na dotazy.
Porovnání různých formátů souborů
Avro ve srovnání s Parquet
- Avro je formát ukládání po řádcích, zatímco Parquet ukládá data po sloupcích.
- Parquet je lépe přizpůsoben analytickým dotazům, což znamená, že operace čtení a dotazování dat jsou mnohem efektivnější než zápis.
- Operace zápisu v Avro probíhají efektivněji než v Parquet.
- Avro pracuje s evolucí schémat mnohem zraleji. Parquet podporuje pouze přidání schématu, zatímco v Avro je implementována multifunkční evoluce, což znamená přidání nebo změnu sloupců.
- Parquet je ideální pro dotazy na podmnožinu sloupců v tabulce s více sloupci. Avro je vhodný pro ETL operace, kde požadujeme všechny sloupce.
ORC ve srovnání s Parquet
- Parquet lépe ukládá vnořené údaje.
- ORC je lépe přizpůsoben pro predikátové propouštění (predicate pushdown).
- ORC podporuje vlastnosti ACID.
- ORC lépe komprimuje data.
Co dalšího si přečíst na toto téma:
- .
- .
- .
Zdroj: habr.com
