

Téma velkých havárií v moderních datových centrech vyvolává dotazy, na které v prvním článku nebylo odpovědí — rozhodli jsme se ho rozvinout.
Pokud věřit statistikám Uptime Institute, většina incidentů v datových centrech souvisí s poruchami v napájecím systému — na jejich podíl připadá 39 % událostí. Následuje lidský faktor — to je dalších 24 % havárií. Třetí nejvýznamnější příčinou (15 %) byly poruchy klimatizačního systému, a na čtvrtém místě (12 %) se ocitly přírodní katastrofy. Celkový podíl ostatních nepříjemností činí pouze 10 %. Nezpochybňujíc data této respektované organizace, vyzdvihneme v různých haváriích něco společného a pokusíme se pochopit, zda bylo možné je předejít. Spoiler: ve většině případů ano.
Věda o kontaktech
Zjednodušeně řečeno, u elektrického napájení existují pouze dva problémy: buď kontakt není tam, kde by měl být, nebo je tam, kde by být neměl. Lze dlouho debatovat o spolehlivosti moderních systémů nepřerušovaného napájení, ale ne vždy zachraňují situaci. Například si vezměme proslulý případ s centrem zpracování dat společnosti British Airways, patřícím mateřské společnosti International Airlines Group. Nedaleko letiště Heathrow se nacházejí dvě takové budovy — Boadicea House a Comet House. V první z nich došlo 27. května 2017 k náhodnému vypnutí napájení, které vedlo k přetížení a selhání systému UPS. V důsledku toho bylo část IT zařízení fyzicky poškozeno a odstranění poslední havárie trvalo tři dny.
Společnost byla nucena zrušit nebo přesunout více než tisíc letů, přibližně 75 tisíc cestujících nemohlo odletět včas — na vyplacení kompenzací bylo vynaloženo 128 milionů dolarů, nepočítaje náklady na obnovení fungování datových center. Historie příčin blackoutů zůstává nejasná. Pokud věřit výsledkům interního vyšetřování, které oznámil generální ředitel International Airlines Group Willie Walsh, k němu došlo kvůli chybě inženýrů. Nicméně, systém nepřerušovaného napájení by měl takové vypnutí vydržet — právě proto byl nainstalován. Datová centra spravovali odborníci z outsourcingové společnosti CBRE Managed Services, takže British Airways se pokusila uplatnit nárok na náhradu škody prostřednictvím londýnského soudu.
Poruchy dodávky elektrické energie se obvykle vyskytují podle podobných scénářů: nejprve dojde k výpadku ze strany dodavatele, někdy kvůli špatnému počasí nebo interním problémům (včetně chyb personálu), a pak systém nepřerušeného napájení neustojí zátěž nebo krátkodobé přerušení sinusoidy způsobí selhání mnoha služeb, na jejichž obnovení je třeba spoustu času a peněz. Lze takovým poruchám předejít? Bezpochyby. Pokud je systém správně navržen, nicméně ani tvůrci velkých datových center nejsou imunní vůči chybám.
Lidský faktor
Když se bezprostřední příčinou incidentu stávají nesprávné jednání personálu datového centra, problémy většinou (ale ne vždy) zasahují softwarovou část IT infrastruktury. Takové poruchy se vyskytují i v large korporacích. V únoru 2017 byla částečně odpojena část serverů Amazon Web Services kvůli nesprávně zadanému příkazu jedním z členů týmu technického provozu jednoho z datových center. K chybě došlo během ladění procesu fakturace zákazníkům cloudového úložiště Amazon Simple Storage Service (S3). Zaměstnanec se pokoušel odstranit určité množství virtuálních serverů využívaných fakturačním systémem, ale zasáhl větší cluster.
V důsledku inženýrské chyby byly odstraněny servery, na nichž běžely důležité softwarové moduly cloudového úložiště Amazon. Jako první byla postižena subsystém indexace, která obsahovala informace o metadatech a umístění všech objektů S3 v americkém regionu US-EAST-1. Incidentu byla rovněž zasáhnuta subsystém používaná pro ukládání dat a správu dostupného prostoru pro ukládání. Po odstranění virtuálních strojů si obě tyto subsystémy vyžádaly úplné restartování a inženýry Amazonu čekalo překvapení - po dlouhou dobu veřejné cloudové úložiště nebylo schopné obsloužit žádosti zákazníků.
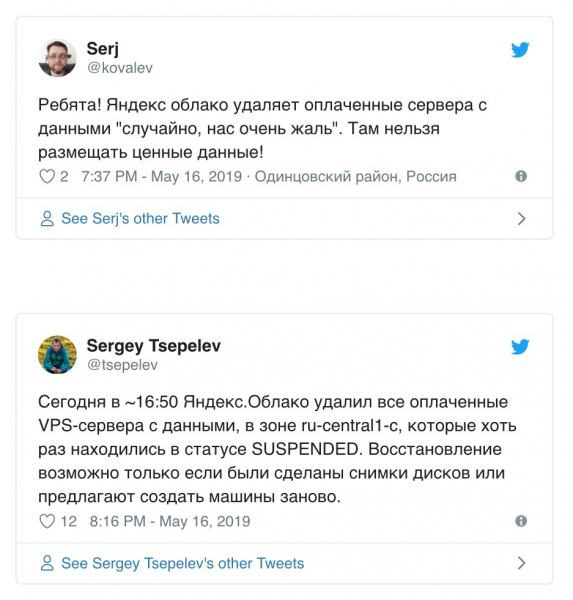
Účinek se ukázal být rozsáhlý, protože mnoho velkých zdrojů používá Amazon S3. Výpadky se dotkly Trello, Coursera, IFTTT a, co je nejhorší, služeb velkých partnerů Amazonu na seznamu S&P 500. Škody v takových případech nelze snadno spočítat, ale jejich výše se pohybovala okolo stovek milionů dolarů. Jak vidíte, k vyřazení služby největší cloudové platformy stačí jeden chybný příkaz. To není ojedinělý případ, 16. května 2019 během preventivních prací služba Yandex.Cloud virtuální stroje uživatelů v zóně ru-central1-c, které někdy byly ve stavu SUSPENDED. Zde už došlo k poškození zákaznických dat, část z nich byla nenávratně ztracena. Samozřejmě, lidé nejsou dokonalí, ale moderní informační bezpečnostní systémy umějí už dávno sledovat činnosti privilegovaných uživatelů před provedením zadaných příkazů. Pokud by do Yandexu nebo Amazonu implementovali taková řešení, podobným incidentům by se dalo předejít.
Zamrzlé chlazení
V lednu 2017 došlo k velké havárii v datovém centru společnosti "MegaFon" v Dmitrově. Tehdy teplota v moskevském regionu klesla na −35 °C, což vedlo k poruše chladicího systému objektu. Tisková služba operátora se o příčinách incidentu příliš nerozšířila - ruské firmy velmi nerady mluví o haváriích ve svých objektech, v oblasti publicity za západem hodně zaostáváme. Na sociálních sítích kolovala verze o zamrzání chladiva v potrubích položených po ulici a úniku ethylenglykolu. Pokud ji věřit, provozní služba nemohla kvůli dlouhým svátkům operativně získat 30 tun chladiva a improvizovala s použitím dostupných prostředků, organizovala improvizované freecooling s porušením pravidel provozu systému. Silné mrazy problém zhoršily - v lednu v Rusku náhle nastala zima, ačkoli nikdo ji nečekal. Nakonec personálu nezbylo než odpojit část serverových stojanů, kvůli čemuž některé služby operátora nebyly k dispozici po dobu dvou dnů.
Možná bychom mohli hovořit i o klimatických anomáliích, ale takové mrazy nejsou pro metropolitní region ničím neobvyklým. Teplota v zimě v Moskevské oblasti může klesat i pod mnohem nižší hodnoty, proto se datová centra staví s ohledem na stabilní provoz při −42°C. Nejčastěji systémy chlazení v mrazu selhávají kvůli nedostatečné koncentraci glykolu a nadbytku vody v roztoku chladicí kapaliny. Objevují se také problémy s montáží trubek nebo s chybami v projektování a testování systému, většinou spojenými s touhou ušetřit. Nakonec na rovině dojde k vážné havárii, kterou by šlo údajně předejít.
Přírodní katastrofy
Nejčastěji bouře a/nebo hurikány narušují činnost inženýrské infrastruktury datového centra, což vede k zastavení služeb a/nebo k fyzickému poškození zařízení. Incidenty vyvolané špatným počasím se vyskytují poměrně často. V roce 2012 se podél západního pobřeží USA prohnal hurikán Sandy s intenzivním deštěm. Datové centrum Peer 1, umístěné v výškové budově na dolním Manhattanu, , poté co slaná mořská voda zaplnila sklepy. Náhradní generátory objektu byly umístěny v 18. patře a zásoba paliva pro ně byla omezená — nová pravidla zavedená v New Yorku po teroristických útocích 11. září zakazují uchovávat velké množství hořlavého materiálu na horních patrech.
Palivové čerpadlo také selhalo, a proto personál několik dní nosil naftu pro generátory manuálně. Hrdinství týmu zachránilo datové centrum před vážnou havárií, ale bylo to skutečně nutné? Žijeme na planetě s dusíkovo-kyslíkovou atmosférou a velkým množstvím vody. Bouře a hurikány jsou zde běžné (zejména v přímořských oblastech). Projektanti by pravděpodobně měli vzít v úvahu rizika s nimi spojená a postavit odpovídající systém nepřetržitého napájení. Nebo alespoň zvolit pro datové centrum vhodnější místo než výškovou budovu na ostrově.
Vše ostatní
Tato kategorie zahrnuje různé incidenty, mezi nimiž je obtížné vybrat typický. Krádeže měděných kabelů, nápady na vniknutí do datových center, podpěry vysokého napětí a transformační stanice automobilů, požáry, které poškozují optiku exkavátorů, hlodavci (potkani, králíci a dokonce vombati, kteří patří mezi vačnatce), stejně jako ti, kdo si rádi zkusí střílení do kabelů — nabídka je rozsáhlá. Poruchy v dodávce elektřiny může způsobit i elektřinu ilegální marihuanová plantáž. Většinou jsou viníky incidentu konkrétní lidé, tj. opět se setkáváme s lidským faktorem, kdy problém má jméno a příjmení. I když se na první pohled může zdát, že nehoda souvisí s technickou závadou nebo s přírodními katastrofami, lze jí předejít, pokud je objekt správně navržen a provozován. Výjimkou jsou snad jen případy kritického poškození infrastruktury datového centra nebo zničení budov a objektů kvůli přírodní katastrofě. To jsou skutečně mimořádné okolnosti, zatímco všechny ostatní problémy vyplývají z vedení mezi počítačem a židlí — to je pravděpodobně nejméně spolehlivá část jakéhokoli složitého systému.
Zdroj: habr.com
