

Opravdové databázové globály — zbraně s hrozivou mocí — jsou již dlouho známé, ale stále je jen málo těch, kteří je dokážou efektivně používat nebo tento superzbraň vůbec ovládají.
Pokud globály použijete k řešení úkolů, v nichž vynikají, můžete dosáhnout vynikajících výsledků. Ať už v oblasti výkonu, nebo při zjednodušení řešení úkolu (, ).
Globály jsou speciální způsob ukládání a zpracování dat, zcela odlišný od tabulek v SQL. Objevily se v roce 1966 v jazyce (evoluční rozvoj — , dále COS) v lékařských databázích a dodnes se tam , a také pronikly do některých dalších oblastí, kde je vyžadována spolehlivost a vysoký výkon: finance, obchodování atd.
Globály v moderních DBMS podporují transakce, protokolování, replikaci, partitioning. Tedy na nich lze budovat moderní, spolehlivé, distribuované a rychlé systémy.
Globály vás neomezuje hranicemi relačního modelu. Poskytují svobodu pro vývoj datových struktur optimalizovaných pro konkrétní úkoly. V mnoha aplikacích může rozumné využití globálů představovat skutečně tajnou zbraň, která zajišťuje výkon, o němž mohou vývojáři relačních aplikací pouze snít.
Globály jako způsob ukládání dat lze použít v mnoha moderních programovacích jazycích, jak vysoce úrovňových, tak nízkoúrovňových. Proto se v tomto článku zaměřím právě na globály, nikoliv na jazyk, ze kterého se kdysi vyvinuly.
2. Jak fungují globály
Pojďme si nejprve objasnit, jak globály fungují, a v čem spočívají jejich silné stránky. Na globály lze pohlížet z různých úhlů pohledu. V této části článku se na ně zaměříme jako na stromy. Nebo jako na hierarchická úložiště dat.
Zjednodušeně řečeno, globál je trvalé pole. Pole, které se automaticky ukládá na disk.
Těžko si představit něco jednoduššího pro ukládání dat. V kódu (v jazycích COS/M) se od běžného asociativního pole liší pouze znakem ^ před názvem.
Pro ukládání dat do globálu není nutné studovat jazyk SQL, příkazy pro práci s nimi jsou velmi jednoduché. Lze je naučit za hodinu.
Začněme tím nejjednodušším příkladem. Jednoduché jednoúrovňové strom s 2 větvemi. Příklady jsou napsány v COS.
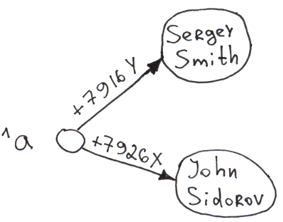
Set ^a("+7926X") = "John Sidorov"
Set ^a("+7916Y") = "Sergey Smith"
Při vložení informací do globál (příkaz Set) se automaticky dějí 3 věci:
- Uložení dat na disk.
- Indexace. To, co je v závorkách, je klíč (v anglické literatuře - "subscript"), a napravo od rovná se je hodnota ("node value").
- Třídění. Data jsou tříděna podle klíče. Při procházení polem se prvním prvkem stane „Sergey Smith“ a druhým „John Sidorov“. Při získávání seznamu uživatelů z globál databáze neztrácí čas tříděním. Navíc je možné požádat o výstup seřazeného seznamu, počínaje jakýmkoli klíčem, dokonce i neexistujícím (výstup začne prvním skutečným klíčem, který následuje po neexistujícím).
Všechny tyto operace probíhají neuvěřitelně rychle. Na domácím počítači jsem dosahoval hodnot až 750 000 vložení/s v jednom procesu. Na vícejádrových procesorech mohou hodnoty dosahovat vloženích/s.
Samozřejmě, samotná rychlost vložení toho příliš neříká. Můžete například velmi rychle zapisovat informace do textových souborů – tak funguje zpracování Visa. Ale v případě globálů dostáváme na výstupu strukturované indexované úložiště, se kterým je možné později jednoduše a rychle pracovat.

- Nejsilnější stránkou globálů je rychlost vkládání nových uzlů.
- Data v globálu jsou vždy indexována. Procházení jak na jedné úrovni, tak do hloubky stromu je vždy rychlé.
Přidáme do globálu ještě několik větví druhé a třetí úrovně.
Set ^a("+7926X", "city") = "Moskva"
Set ^a("+7926X", "city", "street") = "Req Square"
Set ^a("+7926X", "age") = 25
Set ^a("+7916Y", "city") = "Londýn"
Set ^a("+7916Y", "city", "street") = "Baker Street"
Set ^a("+7916Y", "age") = 36 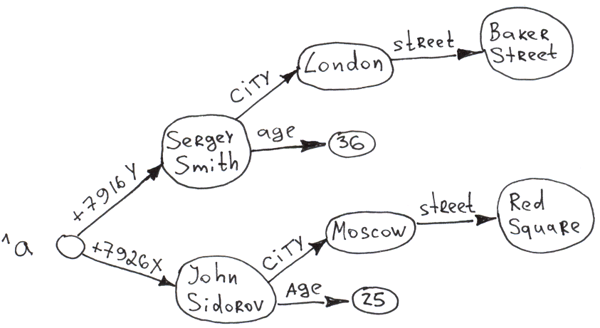
Je zřejmé, že na základě globálů lze budovat víceúrovňové stromy. Přístup k jakémukoli uzlu je prakticky okamžitý díky autoindexování při vkládání. A na jakékoliv úrovni stromu jsou všechny větve seřazeny podle klíče.
Jak je vidět, informace lze uchovávat jak v klíči, tak v hodnotě. Celková délka klíče (součet délek všech indexů) může dosahovat , a hodnoty pro Caché. Počet úrovní ve stromě (počet měření) – 31.
Ještě zajímavý moment. Lze postavit strom, aniž byste zadávali hodnoty uzlů horních úrovní.
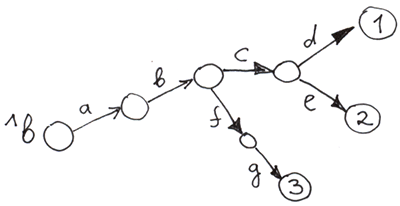
Nastavte ^b("a", "b", "c", "d") = 1
Nastavte ^b("a", "b", "c", "e") = 2
Nastavte ^b("a", "b", "f", "g") = 3
Prázdné uzly jsou uzly, kterým nebyla přiřazena hodnota.
Abychom lépe porozuměli globálům, porovnejme je s jinými stromy: se zahradními a se stromy názvů souborových systémů.
Porovnejme stromy v globálech s nejlépe známými hierarchickými strukturami: s běžnými stromy, které rostou v zahradách a na polích, a také se souborovými systémy.
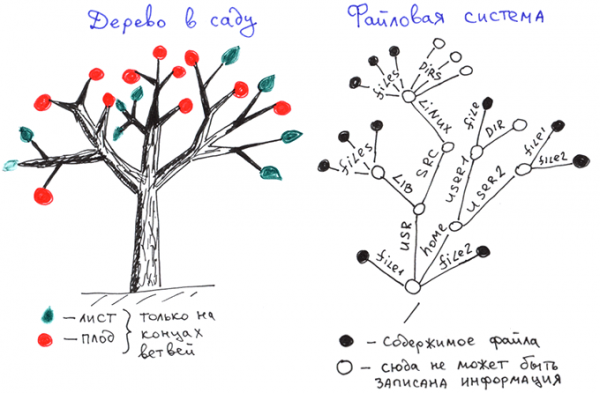
Jak vidíme u zahradních stromů, listy a plody se nacházejí pouze na koncích větví.
U souborových systémů se informace uchovávají pouze na koncích větví, kterými jsou kompletní názvy souborů.
A tady je struktura dat globálu.
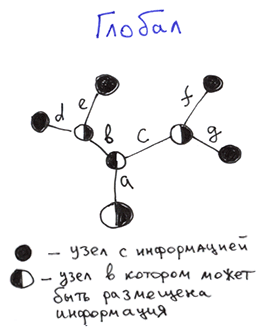 Rozdíly:
- Vnitřní uzly: Informace v globálu může být uchovávána v každém uzlu, nikoli pouze na koncích větví.
- Vnější uzly: Globál musí mít určena hodnoty na koncích větví, u stromů FS a zahradních to není nutné.
Pokud jde o některé vnitřní uzly, lze říci, že struktura globálu je nadmnožinou struktury stromů názvů ve файловых системах a zahradních stromech. Tedy je flexibilnější.
Obecně globál představuje uspořádaný strom s možností uchování dat v každém uzlu.
Abychom lépe pochopili fungování globálů, představme si, co by se stalo, kdyby tvůrci souborových systémů používali k uchovávání informací přístup podobný globálům?
- Při odstranění jediného souboru v adresáři by se automaticky odstranil adresář i všechny nadřazené adresáře, které obsahovaly pouze právě odstraněný adresář.
- Potřeba adresářů by vymizela. Prostě by existovaly soubory s podsoubory a soubory bez podsouborů. Pokud bychom to porovnali s běžným stromem, každá větev by se stala plodem.

- Takové věci jako soubory README.txt by pravděpodobně vymizely. Všechno, co bychom potřebovali říci o obsahu adresáře, bychom mohli zapsat do samotného souboru adresáře. V prostoru cest není název souboru od názvu adresáře k nerozeznání, a proto bychom se mohli obejít pouze soubory.
- Rychlost odstraňování adresářů s vloženými podsložkami a soubory by se prudce zvýšila. Mnohokrát se na Habru objevily články o tom, jak dlouho a obtížně se odstraňují miliony drobných souborů (, ). Pokud vytvoříte pseudo-soubrovou strukturu v globálním měřítku, zabere to sekundy nebo jejich zlomky. Když jsem testoval mazání podstromů na domácím počítači, během jedné sekundy bylo odstraněno 96-341 milionů uzlů ze dvouúrovňového stromu na HDD (ne SSD). Řeč je o mazání části stromu, nikoli o pouhém odstranění celého souboru s globály.
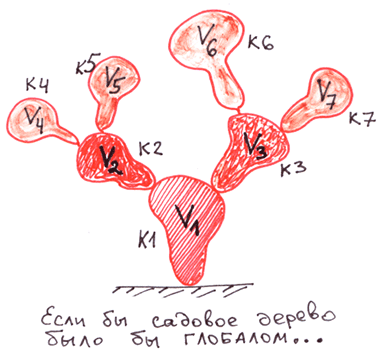

Mazání podstromů je dalším silným bodem globálů. Nepotřebuje k tomu rekurzi. To probíhá neuvěřitelně rychle.
V našem stromě by to bylo možné provést příkazem Kill.
Kill ^a("+7926X") 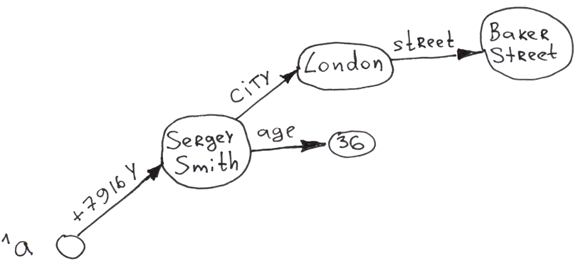
Pro lepší pochopení toho, jaké akce můžeme provádět s globály, uvádím stručnou tabulku.
Hlavní příkazy a funkce pro práci s globály v COS
Nastavení větví až do uzlu (pokud nejsou dosud definovány) a hodnoty uzlu
Kopírování podstromu
Mazání podstromu
Mazání hodnoty konkrétního uzlu. Podstrom vycházející z uzlu se nedotýká
Úplný průchod stromem s vhledem do hloubky
Průchod větvemi konkrétního uzlu
Kontrola zda je uzel definován
Atomové inkrementování hodnoty uzlu. Abychom se vyhnuli čtení a zápisu, pro ACID. V poslední době se doporučuje měnit na
Děkujeme za pozornost, jsme připraveni odpovědět na vaše dotazy.
Poznámka: Tento článek a mé komentáře k němu představují můj názor a nemají nic společného s oficiálním postojem společnosti InterSystems.
Pokračování . Zjistíte, jaké typy dat lze zobrazi na globálech a na jakých úlohách poskytují maximální výhodu.
Zdroj: habr.com
