

3. Varianty struktur při použití globálů
Taková struktura jako uspořádaný strom má různé speciální případy. Zvažme ty, které mají praktickou hodnotu při práci s globály.
3.1 Speciální případ 1. Jeden uzel bez větví
 Globály lze používat nejen jako pole, ale i jako běžné proměnné. Například jako čítač:
Set ^counter = 0  ; nastavení čítače
Set id=$Increment(^counter) ;  atomické inkrementování
Přitom globál, kromě hodnoty, může mít také větve. To se navzájem nevylučuje.
3.2 Speciální případ 2. Jeden vrchol a mnoho větví
Obecně – je to klasická key-value databáze. A pokud jako hodnotu budeme ukládat tuple hodnot, dostaneme obyčejnou tabulku s primárním klíčem.
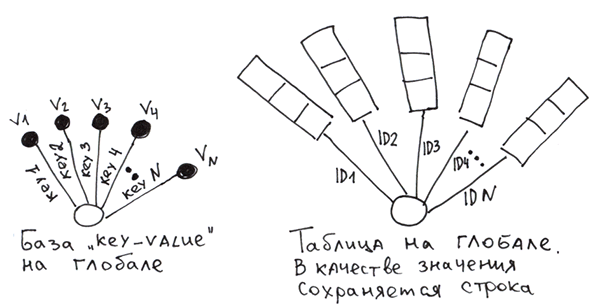
Pro realizaci tabulky na globálech budeme muset samy tvořit řádky z hodnot sloupců a poté je ukládat do globálu podle primárního klíče. Abychom mohli při čtení znovu rozdělit řádek na sloupce, můžeme použít:
- oddělovací znaky.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - pevnou strukturu, podle které každé pole zabírá předem určený počet bajtů. Tak, jak se to dělá v relačních databázích.
- speciální funkci $LB (dostupná v Cache), která vytváří řetězec z hodnot.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Co je zajímavé, není těžké na globálech vytvořit něco podobného sekundárním indexům v relačních databázích. Nazveme takové struktury indexními globály. Indexní globál je pomocný strom pro rychlé vyhledávání podle polí, která nejsou složenými částmi primárního klíče hlavního globálu. Pro jeho naplnění a použití je potřeba napsat další kód.
Vytvořme indexní globál podle prvního sloupce.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Nyní pro rychlé vyhledávání informací podle prvního sloupce musíme zavítat do globálu ^i a najít primární klíče (id) odpovídající požadované hodnotě prvního sloupce.
Při vkládání hodnoty můžeme okamžitě vytvářet jak hodnoty, tak indexní globály podle potřebných polí. A pro spolehlivost to všechno zabalíme do transakce.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Podrobnosti, jak to udělat na M , .
Takové tabulky budou fungovat stejně rychle jako v tradičních DB (nebo dokonce rychleji), pokud budou funkce pro vkládání/aktualizaci/odstraňování řádků napsány v COS/M a zkompilovány.Toto tvrzení jsem ověřoval testy na masivní INSERT a SELECT do jedné dvousloupcové tabulky, včetně použití příkazů TSTART a TCOMMIT (transakcí).
Složitější scénáře s konkurenčním přístupem a paralelními transakcemi jsem netestoval.
Bez použití transakcí byla rychlost insertů při jednom milionu hodnot 778 361 insertů/sec.
Při 300 milionu hodnot — 422 141 insertů/sec.
Při použití transakcí — 572 082 insertů/sec při 50M insertech. Všechny operace byly prováděny ze zkompilovaného M-kódu.
Pevné disky standardní, ne SSD. RAID5 s Write-back. Procesor Phenom II 1100T.
Pro podobné testování SQL databáze je potřeba napsat uloženou proceduru, která v cyklu provádí vkládání. Při testování MySQL 5.5 (úložiště InnoDB) jsem podle této metodiky dostal čísla nepřesahující 11K insertů za sekundu.
Ano, implementace tabulek na globálech se zdá být složitější než v relačních DB. Proto průmyslové DB na globálech mají SQL přístup pro zjednodušení práce s tabulkovými daty.
 Obecně, pokud se schéma dat nebude často měnit, rychlost vkládání není kritická a celou databázi lze snadno představit jako normalizované tabulky, je jednodušší pracovat právě s SQL, protože poskytuje vyšší úroveň abstrakce.
 V tomto konkrétním případě jsem chtěl ukázat, že globály mohou sloužit jako konstruktor pro vytváření dalších DB. Jako assembler, na kterém lze psát jiné jazyky. A zde jsou příklady, jak lze na globálech vytvořit ekvivalenty
Pokud potřebujete vytvořit nějakou nestandardní DB s minimálními náklady, stojí za to podívat se na globály.
3.3 Speciální případ 3. Dvouúrovňový strom, u každého uzlu druhé úrovně fixní počet větví
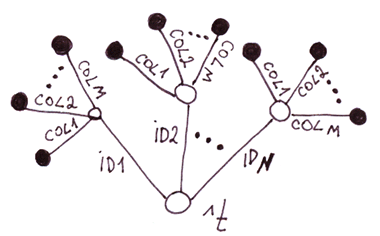 Určitě vás to napadlo: to je alternativní implementace tabulek na globálech. Porovnejme tuto implementaci s předchozí.
Tabulky na dvouúrovňovém stromu vs. na jednouúrovňovém stromu.
Nevýhody
Výhody
- Pomalejší na vkládání, protože je třeba nastavit počet uzlů rovný počtu sloupců.
- Větší spotřeba diskového prostoru. Indexy globálů (pohledem na ně jako na indexy polí) s názvy sloupců zabírají místo na disku a duplicují se pro každý řádek.
- Rychlejší přístup k hodnotám jednotlivých sloupců, protože není potřeba parsovat řádek. Podle mých testů je rychlost vyšší o 11,5 % při 2 sloupcích a více při vyšším počtu sloupců.
- Snadnější změna datového schématu.
- Barevnější kód.
Výstup: je otázka vkusu. Protože rychlost je jednou z nejvýznamnějších výhod globálů, téměř nemá smysl používat tuto implementaci, protože pravděpodobně nebude fungovat rychleji než tabulky v relačních databázích.
3.4 Obecný případ. Stromy a uspořádané stromy.
Jakákoli datová struktura, která může být představena ve formě stromu, se skvěle hodí pro globály.
3.4.1 Objekty s podobjekty.
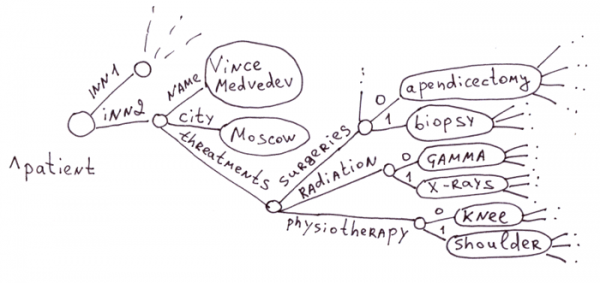
Toto je tradiční oblast aplikace globálů. Ve zdravotnictví existuje obrovské množství nemocí, léků, symptomů a léčebných metod. Vytvářet pro každého pacienta tabulku s milionem polí je nepraktické. Ostatně 99 % polí bude prázdných.
Představte si SQL databázi z tabulek: „pacient“ ~ 100 000 polí, „léčivo“ — 100 000 polí, „terapie“ — 100 000 polí, „komplikace“ — 100 000 polí atd. a podobně. Nebo můžete vytvořit databázi z mnoha tisíc tabulek, každou pro určitý typ pacienta (a ty se mohou překrývat!), léčby, léku a ještě tisíce tabulek pro vazby mezi těmito tabulkami.
Globály jsou ideální pro medicínu, protože umožňují vytvořit pro každého pacienta přesný popis jeho zdravotního záznamu, různých terapií, účinků léků ve formě stromu, aniž by se tím plýtvalo diskovým prostorem na prázdné sloupce, jak by tomu bylo v relačním případě.
 Na globálech se pohodlně vytváří databáze s údaji o lidech., když je důležité shromáždit a systematizovat maximální různé informace o klientovi. To je vyžadováno ve zdravotnictví, bankovnictví, marketingu, archivnictví a dalších oblastech.
.
Samozřejmě, že v SQL lze také emulovat strom několika tabulkami (, ,,,,,,,,,), avšak je to podstatně složitější a bude to fungovat pomaleji. V podstatě by bylo nutné napsat globální systém fungující na tabulkách a skrýt veškerou práci s tabulkami pod vrstvou abstrakce. Není správné emulovat nízkoúrovňovou technologii (globály) pomocí vysoce úrovňové (SQL). Je to nevhodné.
Není tajemstvím, že změna datového schématu na obrovských tabulkách (ALTER TABLE) může zabrat značný čas. MySQL například provádí ALTER TABLE ADD|DROP COLUMN kompletním kopírováním informací ze staré do nové tabulky (testoval jsem motory MyISAM, InnoDB). To může pozastavit pracovní databázi se miliardami záznamů na dny, ne-li týdny.
 Změna struktury dat, pokud používáme globály, nás nic nestojí. Kdykoliv můžeme přidat jakékoli nové vlastnosti k jakémukoli objektu, na jakékoli úrovni hierarchie. Změny související s přejmenováním větví lze spouštět na pozadí na funkční databázi.
Proto, když jde o ukládání objektů s obrovským počtem volitelných vlastností, jsou globály skvělou volbou.
A co víc, připomínám, že přístup k jakékoli vlastnosti je okamžitý, protože ve globálu všechny cesty představují B-tree.
Databáze na globálech jsou obecně řídkou formou dokumentově orientovaných databází, se schopností uchovávat hierarchické informace. V oblasti uchovávání lékařských záznamů mohou globály konkurovat dokumentově orientovaným databázím. Ale přesto to není úplně ono.Vezměme si pro srovnání například MongoDB. V této oblasti prohrává s globály z těchto důvodů:
- Velikost dokumentu. Jednotkou úložiště je text ve formátu JSON (přesněji BSON) maximální velikosti přibližně 16MB. Omezení bylo stanoveno speciálně, aby JSON databáze nezpomalovala při parsování, pokud v ní bude uložen obrovský JSON dokument a poté k němu bude přistupováno podle polí. V tomto dokumentu by měly být soustředěny všechny informace o pacientovi. Všichni víme, jak silné mohou být zdravotní karty pacientů. Maximální velikost karty 16MB okamžitě vylučuje pacienty, jejichž karty obsahují soubory z MRI, skeny rentgenografie a dalších vyšetření. V jedné větvi globálu lze mít informace na gigabajty a terabajty. V zásadě bych zde mohl zakočit, ale budu pokračovat.
- Čas vědomí/změny/odstranění nových vlastností v mapě pacienta. Taková databáze musí načíst celou mapu do paměti (což je velký objem!), rozparsovat BSON, vložit/změnit/odstranit nový uzel, aktualizovat indexy, zabalit do BSON a uložit na disk. Globální proměnné však stačí jen odkazovat na konkrétní vlastnost a provádět s ní manipulace.
- Rychlost přístupu k jednotlivým vlastnostem. Při množství vlastností v dokumentu a jeho vícestupňové struktuře bude přístup k jednotlivým vlastnostem rychlejší díky tomu, že každá cesta v globálních proměnných je B-strom. V BSON však bude třeba dokument lineárně rozparsovat, abychom našli požadovanou vlastnost.
3.3.2 Asociativní pole
Asociativní pole (i s vnořenými poli) se výborně hodí na globální proměnné. Například takové pole z PHP se zobrazuje na prvním obrázku 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Hierarchické dokumenty: XML, JSON
Také se snadno ukládají do globálních proměnných. Pro uložení je možné použít různé způsoby.
XML
Nejjednodušší způsob rozložení XML na globální proměnné je, když v uzlech uchováváme atributy tagů. A pokud bude potřeba rychlý přístup k atributům tagů, můžeme je umístit do samostatných větví.
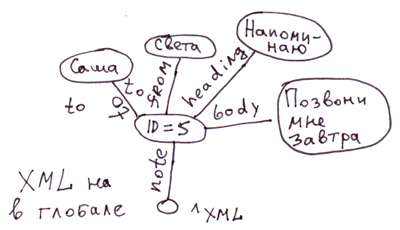
<note id="5">
<to>Václav</to>
<from>Světlo</from>
<heading>Připomenutí</heading>
<body>Zavolej mi zítra!</body>
</note>
Na COS odpovídající kód bude:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Saša"
Set ^xml("note","from")="Světlana"
Set ^xml("note","heading")="Připomenutí"
Set ^xml("note","body")="Zavolej mi zítra!"
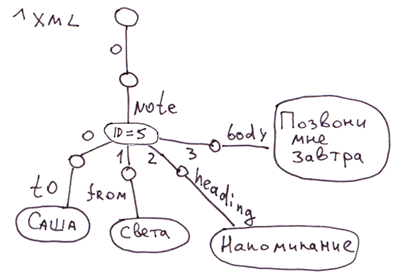
Poznámka: Pro XML, JSON, asociativní pole lze vymyslet mnoho různých způsobů zobrazení na globálních proměnných. V tomto případě jsme neodrazili pořadí vnořených tagů v tagu note. V globální proměnné ^xml vnořené tagy budou zobrazovány v abecedním pořadí. Pro přesné odražení pořadí je možné použit například takové zobrazení:
JSON.
Na prvním obrázku z části 3.3.1 je znázorněno odražení tohoto JSON dokumentu:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "threatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Stejné struktury spojené hierarchickými vztahy
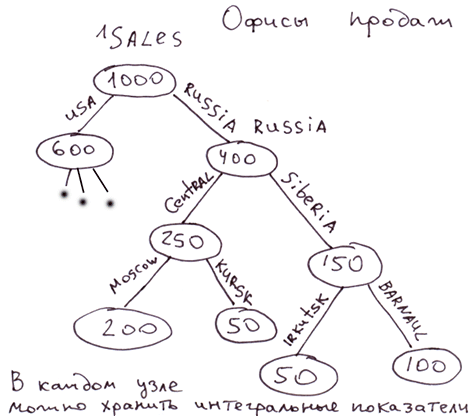
Příklady: struktura prodejen, umístění lidí v MLM struktuře, databáze otevření v šachu.
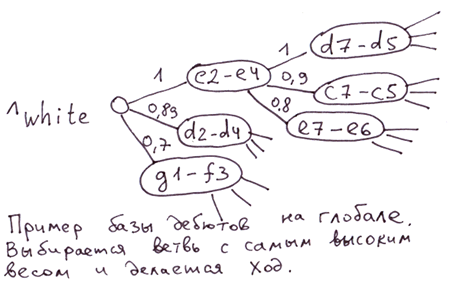
Databáze otevření. Jako hodnotu indexu uzlu globálu lze použít hodnocení síly tahu. Pak stačí vybrat větev s nejvyšší hmotností, abyste zvolili nejmocnější tah. Ve globálu budou všechny větve na každé úrovni seřazeny podle síly tahu.
Struktura prodejen, struktura lidí v MLM. V uzlech lze uchovávat určité cash hodnoty, které odrážejí charakteristiky celého podstromu. Například objem prodeje daného podstromu. Kdykoli můžeme získat číslo, které odráží úspěchy jakékoli větve.
4. V jakých případech je nejvýhodnější používat globály
V první sloupci jsou uvedeny případy, kdy získáte významné zrychlení při použití globálů, a ve druhém, kdy se zjednoduší vývoj nebo model dat.
Rychlost
Pohodlí zpracování/představení dat
- Vkládání [s automatickým řazením na každé úrovni], [indexováním podle hlavního klíče]
- Odstraňování podstromů
- Objekty s množstvím vnořených vlastností, k nimž je potřeba individuální přístup
- Hierarchická struktura s možností procházení dětských větví z jakékoli, i neexistující
- Procházení podstromů do hloubky
- Objekty/entit s obrovským množstvím volitelných [a/nebo vnořených] vlastností/entit
- Bezschémová data (schema-less). Když se často mohou objevovat nové vlastnosti a mizet staré.
- Je třeba vytvořit nestandardní databázi.
- Databáze cest a rozhodovací stromy. Když je vhodné představovat cesty ve formě stromu.
- Odstraňování hierarchických struktur bez použití rekurze
Pokračování .
Poznámka: Tento článek a mé komentáře k němu představují můj názor a nemají nic společného s oficiálním postojem společnosti InterSystems.
Zdroj: habr.com
