

Doporučuji se seznámit se s přepisem zprávy konce roku 2019 od Alexandra Valjaljkina "Optimalizace Go ve VictoriaMetrics"
— rychlá a škálovatelná databáze pro ukládání a zpracování dat v podobě časových řad (záznam představuje čas a sadu hodnot odpovídajících tomuto času, například získaných prostřednictvím periodického dotazování stavu senzorů nebo shromažďování metrik).
Zde je odkaz na video této přednášky —
Trochu se představím. Jsem Alexander Valjaljkin. Tady . Zajímám se o Go a optimalizaci výkonu. Napsal jsem spoustu různých užitečných a méně užitečných knihoven. Začínají buď s fast, nebo s quick prefixem.
V současné době pracuji na VictoriaMetrics. Co to je a co tam dělám? O tom budu hovořit v této prezentaci.
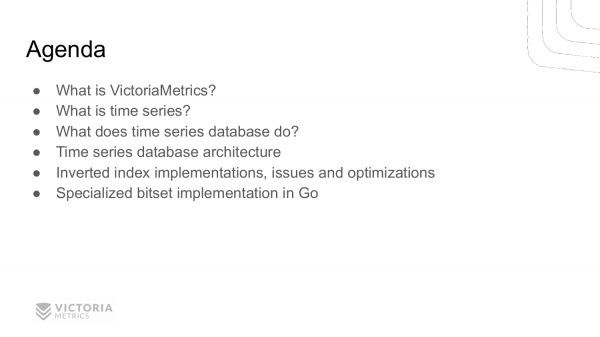
Plán přednášky je následující:
- Nejprve vám vysvětlím, co je VictoriaMetrics.
- Poté vám řeknu, co jsou to časové řady.
- Poté popíšu, jak funguje databáze časových řad.
- Pak se budu věnovat architektuře databáze: z čeho se skládá.
- A nakonec přejdeme k optimalizacím, které jsou ve VictoriaMetrics. To zahrnuje optimalizaci inverzního indexu a optimalizaci pro bitset-implementaci na Go.
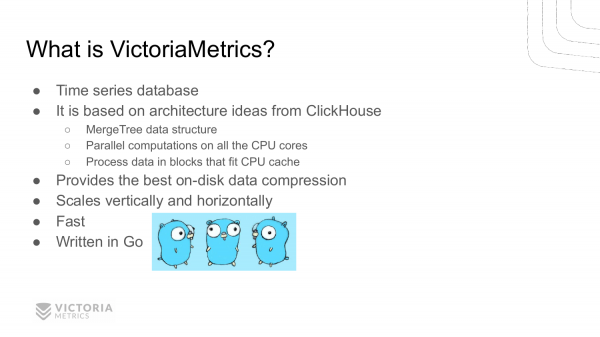
Ví někdo v auditoriu, co je VictoriaMetrics? No vidíte, mnoho lidí už to ví. To je dobrá zpráva. Pro ty, kteří neví – je to databáze pro časové řady. Je založena na architektuře ClickHouse, na některých detailech implementace ClickHouse. Například na takových, jako je: MergeTree, paralelní výpočty na všech dostupných jádrech procesoru a optimalizace výkonu pomocí práce na blocích dat, které se ukládají do mezipaměti procesoru.
VictoriaMetrics poskytuje nejlepší kompresi dat ve srovnání s jinými databázemi pro časové řady.
Škálovatelně vertikálně — tj. můžete přidávat více procesorů, více operační paměti na jednom počítači. VictoriaMetrics bude úspěšně využívat tyto dostupné zdroje a zvyšovat lineární výkon.
VictoriaMetrics také škálovatelně horizontálně — tj. můžete přidávat další uzly do clusteru VictoriaMetrics a její výkon bude růst téměř lineárně.
Jak jste asi uhodli, VictoriaMetrics je rychlá databáze, protože o jiných nemohu psát. A je napsaná v Go, proto o ní mluvím na tomto meetupu.
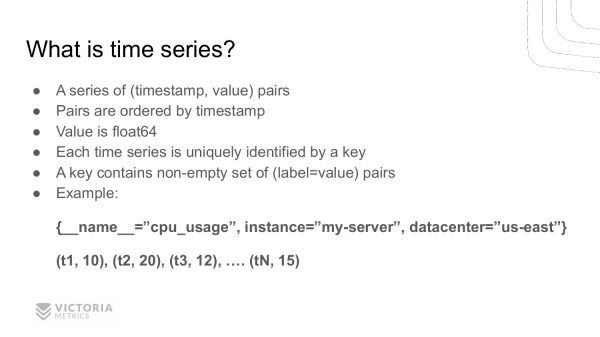
Kdo ví, co je to časová řada? Mnoho lidí to ví. Časová řada je série párů (timestamp, hodnota), kde jsou tyto páry seřazeny podle času. Hodnota je číslo s plovoucí desetinnou čárkou – float64.
Každá časová řada je jedinečně identifikována klíčem. Z čeho se tento klíč skládá? Skládá se z neprázdné množiny párů klíč-hodnota.
Zde je příklad časové řady. Klíčem této řady je seznam párů: __name__="cpu_usage" – to je název metriky, instance="my-server" – to je počítač, na kterém byla tato metrika shromážděna, datacenter="us-east" – to je datové centrum, kde je tento počítač umístěn.
Máme jméno časové řady složené ze tří párů klíč-hodnota. Tomu klíči odpovídá seznam párů (timestamp, value). t1, t3, t3, ..., tN – to jsou časová razítka, 10, 20, 12, ..., 15 – odpovídající hodnoty. To je cpu-usage v daném okamžiku pro danou řadu.
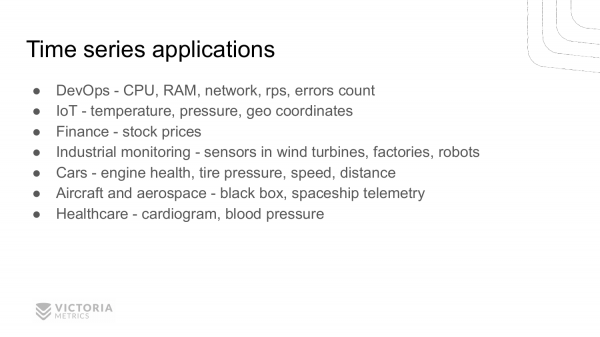
Kde mohou být časové řady použity? Má někdo nějaké nápady?
- V DevOps lze měřit zatížení CPU, RAM, sítě, rps, počet chyb atd.
- IoT – můžeme měřit teplotu, tlak, geokoordináty a další.
- Také finance – můžeme monitorovat ceny akcií a měn.
- Kromě toho mohou být časové řady použity k monitorování výrobních procesů v továrnách. Máme uživatele, kteří používají VictoriaMetrics k monitorování větrných turbín a robotů.
- Také časové řady jsou užitečné pro shromažďování informací ze senzorů různých zařízení. Například pro motor; pro měření tlaku v pneumatikách; pro měření rychlosti, vzdálenosti; pro měření spotřeby benzínu atd.
- Také časové řady mohou být použity k monitorování letadel. V každém letadle je černá skříňka, která shromažďuje časové řady podle různých parametrů zdraví letadla. Časové řady se také používají v leteckém průmyslu.
- Zdravotnictví – to jsou krevní tlak, puls atd.
Možná ještě existují aplikace, na které jsem zapomněl, ale doufám, že jste pochopili, že časové řady jsou v moderním světě aktivně využívány. A objem jejich využití roste každým rokem.
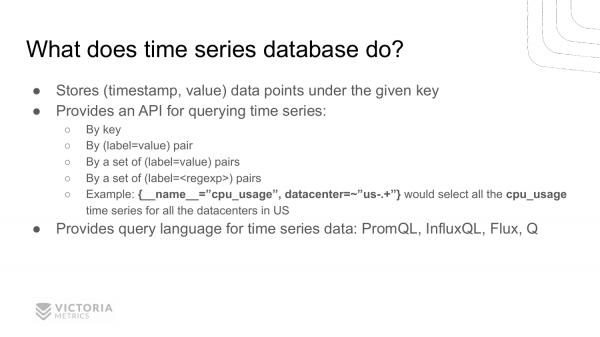
K čemu slouží databáze pro časové řady? Proč nelze použít běžnou relační databázi pro uchovávání časových řad?
Protože v časových řadách obvykle existuje velké množství informací, které je obtížné uchovávat a zpracovávat v běžných databázích. Proto vznikly specializované databáze pro časové řady. Tyto databáze efektivně ukládají body (timestamp, value) s určeným klíčem. Poskytují API pro čtení uložených dat podle klíče, po jedné dvojici klíč-hodnota, nebo po několika takových dvojicích, anebo podle regexp. Například, pokud chcete zjistit zatížení procesoru všech vašich služeb v datovém centru v Americe, potřebujete použít takový pseudo-dotaz.
Obvykle databáze pro časové řady nabízejí specializované dotazovací jazyky, protože SQL pro časové řady není příliš vhodný. I když existují databáze, které podporují SQL, to není příliš dobře fungující možnost. Lépe vyhovují takové dotazovací jazyky jako , , , . Doufám, že alespoň někdo slyšel o jednom z těchto jazyků. O PromQL pravděpodobně slyšelo mnoho lidí. Je to dotazovací jazyk Promethea.
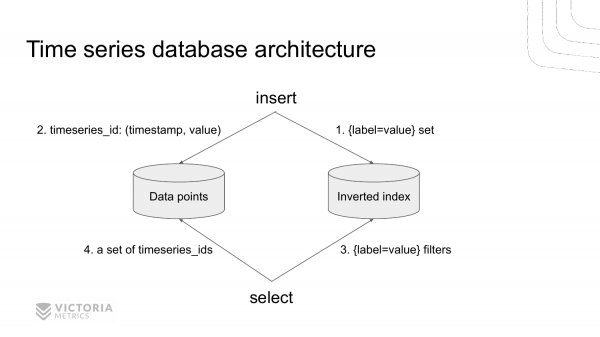
Takto vypadá architektura moderní databáze pro časové řady na příkladu VictoriaMetrics.
Skládá se ze dvou částí. To je úložiště pro invertovaný index a úložiště pro hodnoty časových řad. Tato úložiště jsou oddělena.
Když přijde nový záznam do databáze, nejprve se obracíme na invertovaný index, abychom našli identifikátor časové řady podle zadaného souboru label=value pro tuto metriku. Najdeme tento identifikátor a uložíme hodnotu do úložiště dat.
Když přijde nějaký dotaz na selekci dat z TSDB, nejprve se díváme do invertovaného indexu. Získáme všechny timeseries_ids záznamy, které odpovídají dané množině label=value. A poté vezmeme všechny potřebné údaje z úložiště dat, indexovaného podle timeseries_ids.
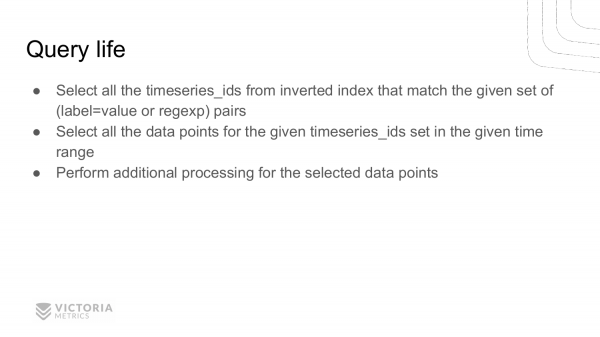
Uvažujme příklad, jak databáze časových řad zpracovává příchozí select dotaz.
- Nejprve získá všechny
timeseries_idsz invertovaného indexu, které obsahují dané dvojicelabel=value, nebo splňují daný regulární výraz. - Poté získá všechny data points z úložiště dat na zadaném časovém intervalu pro nalezené
timeseries_ids. - Po tomto databáze provede nějaké výpočty na těchto datech podle požadavku uživatele. A poté vrátí odpověď.
V této prezentaci vám povím o první části. To je vyhledávání timeseries_ids v inverzním indexu. O druhé a třetí části se můžete podívat později na , nebo si počkat, až připravím další přednášky 🙂
Začněme s inverzním indexem. Mnoha lidem se může zdát, že je to jednoduché. Kdo ví, co je inverzní index a jak funguje? O, už není tolik lidí. Pojďme se pokusit pochopit, co to je.
Ve skutečnosti je to jednoduché. Je to jen slovník, který mapuje klíč na hodnotu. Co je klíč? Tento pár label=value, kde label a value – to jsou řetězce. A hodnoty – to je množina timeseries_ids, která obsahuje daný pár label=value.
Inverzní index umožňuje rychle najít všechny timeseries_ids, které mají zadané label=value.
A také umožňuje rychle najít timeseries_ids časové řady pro více párů label=value, nebo pro páry label=regexp. Jak to probíhá? Pomocí nalezení průniku množiny timeseries_ids pro každý pár label=value.
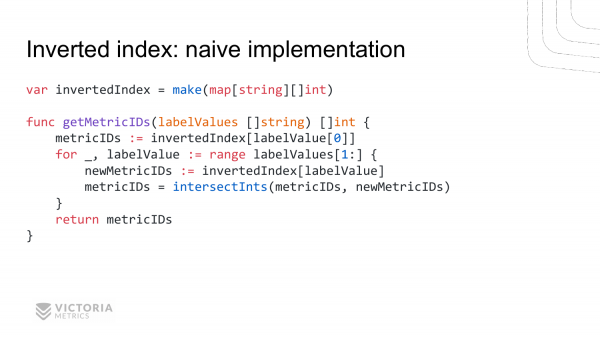
Zvažme různé implementace inverzního indexu. Začněme s nejsnazší naivní implementací. Vypadá to takto.
Funkce getMetricIDs získává seznam řetězců. Každý řetězec obsahuje label=value. Tato funkce vrací seznam metricIDs.
Jak to funguje? Tady máme globální proměnnou, která se nazývá invertedIndex. Je to běžný slovník (mapa), který mapuje řetězec na slice intů. Řetězec obsahuje label=value.
Implementace funkce: vytáhneme metricIDs pro první label=value, poté projdeme všechny ostatní label=value, vytáhneme metricIDs pro ně. A voláme funkci intersectInts, o které bude podrobněji řeč později. A tato funkce vrací průnik těchto seznamů.
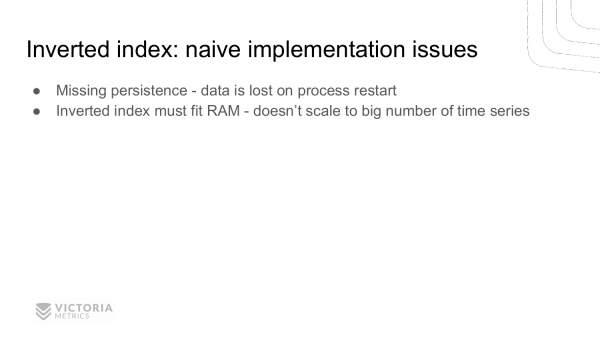
Jak vidíte, implementace inverzního indexu není příliš složitá. Ale je to naivní implementace. Jaké má nevýhody? Hlavní nevýhodou naivní implementace je ta, že takový inverzní index máme uložený v operační paměti. Po restartu aplikace ztrácíme tento index. Není uložení tohoto indexu na disk. Pro databázi asi takový inverzní index nebude vhodný.
Druhý nedostatek souvisí také s pamětí. Inverzní index musí být umístěn v paměti. Pokud překročí velikost operační paměti, dostaneme evidentně – chybu „out of memory“ a program nebude fungovat.
Tento problém lze vyřešit pomocí hotových řešení, jako jsou , nebo .
Pokud to shrneme, potřebujeme databázi, která umožňuje rychlé provedení tří operací.
- První operací je zápis
klíč-hodnotado této databáze. To dělá velmi rychle, kdeklíč-hodnota– jsou libovolné řetězce. - Druhou operací je rychlé vyhledání hodnoty podle zadaného klíče.
- A třetí operací je rychlé vyhledání všech hodnot podle daného prefixu.
LevelDB a RocksDB – tyto databáze byly vyvinuty ve firmách Google a Facebook. Nejprve se objevila LevelDB. Poté si lidé z Facebooku vzali LevelDB a začali ji vylepšovat, čímž vytvořili RocksDB. V současnosti v Facebooku na RocksDB fungují téměř všechny interní databáze, včetně toho, že přenesli MySQL na RocksDB. Nazvali to .
Inverzní index lze implementovat pomocí LevelDB. Jak to udělat? Ukládáme jako klíč label=value. A jako hodnotu – identifikátor časového řady, kde existuje pár label=value.
Pokud máme mnoho časových řad s tímto párem label=value, bude v této databázi mnoho řádků se stejným klíčem a různými timeseries_ids. Abychom získali seznam všech timeseries_ids, které začínají daným label=prefix, provádíme range scan, pro který je tato databáze optimalizována. T. j. vybíráme všechny řádky, které začínají s label=prefix a získáváme potřebné timeseries_ids.
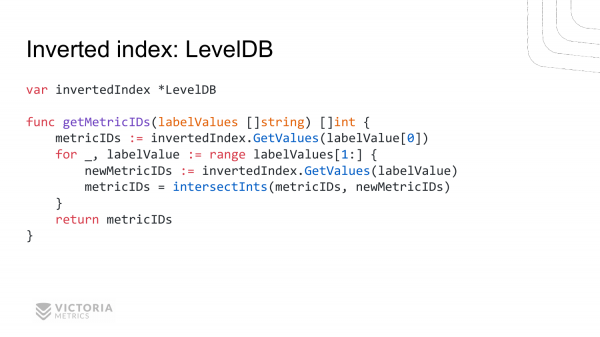
Tady je příkladná implementace, jak by vypadala v Go. Máme inverzní index. Je to LevelDB.
Funkce je stejná jako pro naivní implementaci. Téměř se řádek po řádku opakuje naivní implementaci. Jediný okamžik je, že místo přístupu k mapa se dostáváme k inverznímu indexu. Získáváme všechna hodnoty pro první label=value. Poté procházíme všemi zbývajícími páry label=value a získáváme odpovídající sady metricIDs pro ně. Poté nalézáme průnik.
Vypadá to dobře, ale v tomto řešení jsou nedostatky. VictoriaMetrics zpočátku implementovala inverzní index na základě LevelDB. Ale nakonec od toho musela upustit.
Proč? Protože LevelDB je pomalejší než naivní implementace. V naivní implementaci podle zadaného klíče okamžitě získáváme celý slice. metricIDsTato velmi rychlá operace – celý slice je připraven k použití.
V LevelDB se při každém zavolání funkce GetValues musí projít všemi řádky, které začínají na label=value. A pro každý řádek získat hodnotu timeseries_ids. Z takových timeseries_ids sestavit slice těchto timeseries_ids. Je jasné, že to je mnohem pomalejší než prostý přístup k běžnému mapu podle klíče.
Druhou nevýhodou je, že LevelDB je napsán v C. Přístup k C-funkcím z Go není příliš rychlý. Získává to stovky nanosekund. To není příliš rychlé, protože ve srovnání s běžným voláním funkce napsané v go, která zabere 1-5 nanosekund, je rozdíl v výkonu desetinásobný. Pro VictoriaMetrics to byla fatální nevýhoda 🙂
Proto jsem napsal vlastní implementaci inverzního indexu. A nazval jsem ji .
Mergeset je postaven na datové struktuře MergeTree. Tato datová struktura byla převzata z ClickHouse. Je jasné, že mergeset by měl být optimalizován pro rychlé vyhledávání timeseries_ids podle zadaného klíče. Mergeset je napsán kompletně v Go. Můžete se podívat na . Implementace mergeset leží v adresáři . Můžete se pokusit pochopit, co se tam děje.
API mergeset je velmi podobné LevelDB a RocksDB. To znamená, že umožňuje rychle uložit nové záznamy a rychle vybírat záznamy podle zadaného prefixu.
O nevýhodách mergeset si popovídáme později. Teď se posuňme k problémům, které vznikly s VictoriaMetrics v produkci při implementaci inverzního indexu.
Proč vznikly?
První důvod – to je vysoká míra fluktuace. V překladu do češtiny – to je častá změna časových řad. To je, když časová řada končí a začíná nová řada, nebo začíná mnoho nových časových řad. A to se děje často.
Druhý důvod – to je velké množství časových řad. Na začátku, když monitoring nabíral popularitu, bylo množství časových řad malé. Například na každý počítač je třeba monitorovat zátěž procesoru, paměti, sítě a disku. 4 časové řady na každý počítač. Máte, dejme tomu, 100 počítačů a 400 časových řad. To je velmi málo.
V průběhu času lidé přišli na to, že je možné měřit podrobnější informace. Například měřit zátěž nejen celého procesoru, ale jednotlivě každého procesorového jádra. Pokud máte 40 procesorových jader, máte tedy 40krát více časových řad pro měření zátěže procesoru.
Ale to není všechno. Každé procesorové jádro může mít několik stavů, jako je idle, když nepracuje. Také může pracovat ve space uživatele, v kernel space a další stavy. A každý takový stav lze také měřit jako samostatnou časovou řadu. To navíc zvyšuje počet řad 7-8krát.
Z jedné metriky máme 40 x 8 = 320 metrik pouze pro jeden počítač. Násobíme 100 a dostáváme 32 000 místo 400.
Pak přišel Kubernetes. A všechno se ještě zhoršilo, protože v Kubernetes může běžet mnoho různých služeb. Každá služba v Kubernetes se skládá z mnoha podů. A to vše je potřeba monitorovat. Kromě toho máme neustálé nasazování nových verzí vašich služeb. Pro každou novou verzi je třeba vytvářet nové časové řady. Nakonec se počet časových řad exponenciálně zvyšuje a setkáváme se s problémem velkého počtu časových řad, který se nazývá high-cardinality. VictoriaMetrics si s tímto problémem úspěšně poradí ve srovnání s jinými databázemi pro časové řady.
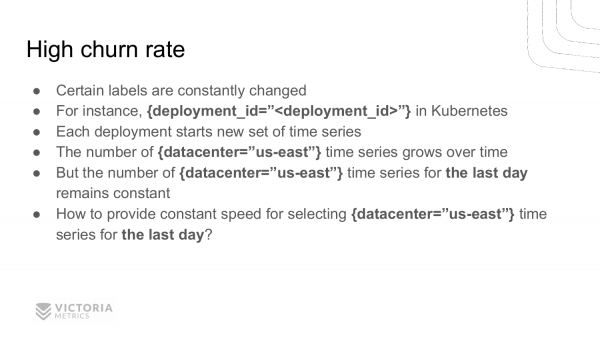
Podívejme se podrobněji na vysokou míru obmůny (high churn rate). Proč se na produkci objevuje vysoká míra obmůny? Protože některé hodnoty štítků a tagů se neustále mění.
Například vezmeme Kubernetes, ve kterém existuje pojem deployment, tedy když se vydává nová verze vaší aplikace. Vývojáři Kubernetes se z nějakého důvodu rozhodli přidat id nasazení do štítku.
Jaké to mělo následky? To, že při každém novém nasazení jsou všechny staré časové řady přerušeny a místo nich začínají nové časové řady s novou hodnotou štítku deployment_id. Takových řad může být stovky tisíc a dokonce i miliony.
Důležitým rysem tohoto všeho je to, že celkové množství časových řad roste, ale počet časových řad, které jsou momentálně aktivní, na které přicházejí data, zůstává konstantní. Tento stav se nazývá – vysoká míra obmůny.
Hlavním problémem vysoké míry odchodu zákazníků je zajistit stálou rychlost vyhledávání všech časových řad podle dané sady štítků za určité časové období. Obvykle se jedná o časový interval za poslední hodinu nebo za poslední den.
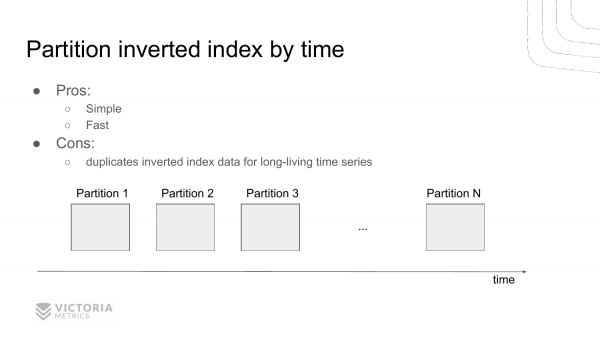
Jak tento problém vyřešit? První možností je rozdělit invertovaný index na nezávislé části podle času. Tedy, uplyne nějaký časový interval, dokončíme práci s aktuálním invertovaným indexem. A vytvoříme nový invertovaný index. Poté uplyne další časový interval, vytvoříme další a další.
A při dotazování na tyto invertované indexy najdeme sadu invertovaných indexů, které spadají do zadaného intervalu. A odpovídajícím způsobem vybereme id časových řad.
To umožňuje šetřit zdroje, protože nemusíme procházet části, které nespadají do zadaného intervalu. Tedy obvykle, pokud vybíráme data za poslední hodinu, dotazy na předchozí časové intervaly přeskočíme.
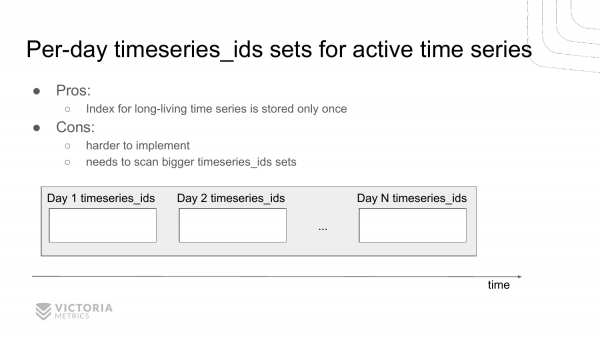
Existuje také další možnost řešení tohoto problému. A to uchovávat pro každý den samostatný seznam id časových řad, které se v daný den vyskytly.
Výhodou tohoto řešení oproti předchozímu řešení je, že neduplikuje informace o časových řadách, které s časem nezmizí. Tyto časové řady stále existují a nemění se.
Nevýhodou je, že takové řešení je složitější na implementaci a debuggování. A VictoriaMetrics si zvolila toto řešení. Ověřilo se historicky. Toto řešení se také jeví jako docela dobré ve srovnání s předchozím. Protože toto řešení nebylo implementováno kvůli nutnosti duplikovat data v každé partition pro časové řady, které se nemění, t.j. které s časem nezmizí. VictoriaMetrics byla primárně optimalizována na spotřebu diskového prostoru a předchozí implementace zhoršovala spotřebu tohoto prostoru. Toto řešení je tedy lépe přizpůsobeno minimalizaci spotřeby diskového prostoru, a proto bylo zvoleno.
Museli jsme se s tím potýkat. Boj spočíval v tom, že v této implementaci je třeba stále vybírat mnohem větší množství timeseries_ids pro data, než když je invertovaný index rozdělen podle času.
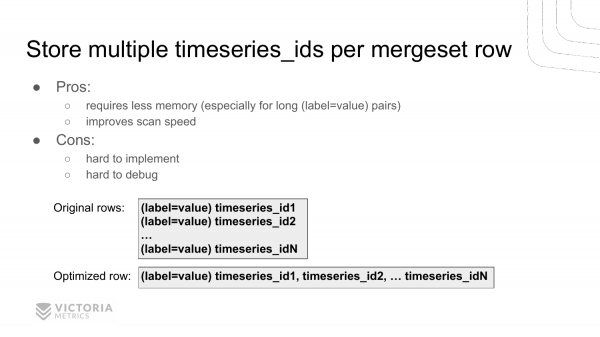
Jak jsme tento problém vyřešili? Vyřešili jsme ho originálním způsobem – uložením několika identifikátorů časových řad v každém záznamu inverzního indexu místo jednoho identifikátoru. T. j. máme klíč label=value, který se vyskytuje v každé časové řadě. A nyní ukládáme několik timeseries_ids v jednom záznamu.
Zde je příklad. Dříve jsme měli N záznamů, a nyní máme jeden záznam, jehož prefix je stejný jako u všech ostatních. Předchozí záznam obsahoval všechny id časových řad.
To umožnilo zvýšit rychlost skenování takového inverzního indexu až 10krát. A snížit spotřebu paměti pro cache, protože nyní ukládáme řetězec label=value pouze jednou v cache místo N krát. A tento řetězec může být velký, pokud jsou v tagích a štítcích uloženy dlouhé řetězce, které tam rád vkládá Kubernetes.
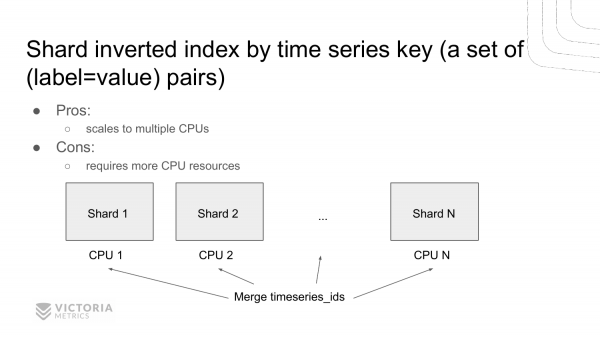
Další možností, jak urychlit vyhledávání v inverzním indexu, je shardování. Vytvoření několika inverzních indexů místo jednoho a shardování dat mezi nimi podle klíče. To je soubor key=value párů. T. j. máme několik nezávislých inverzních indexů, které můžeme dotazovat paralelně na několika procesorech. Předchozí implementace umožňovaly pracovat pouze v jednoprocesorovém režimu, t. j. skenovat data pouze na jednom jádře. Toto řešení umožňuje skenovat data najednou na několika jádrech, jak to rád dělá ClickHouse. To plánujeme realizovat.
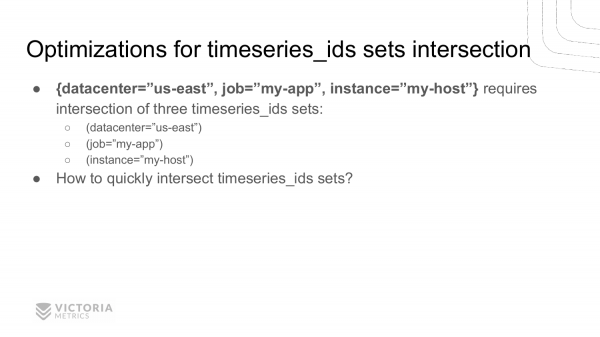
A nyní se vraťme k našim ovcím – k funkci průniku timeseries_ids. Podívejme se, jaké mohou být implementace. Tato funkce umožňuje najít timeseries_ids pro danou sadu label=value.
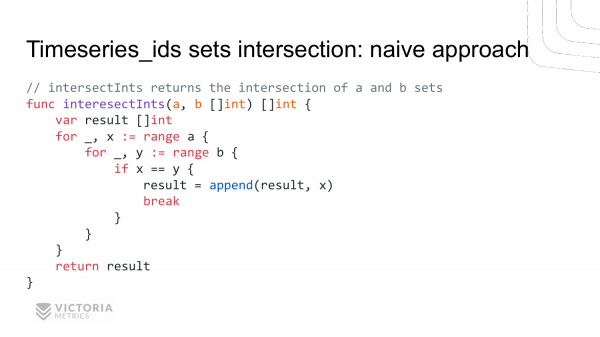
První možnost – to je naivní implementace. Dva vnořené cykly. Takto dostáváme na vstupu funkce intersectInts dvě slices — a a b. Na výstupu by nám měla vrátit průnik těchto slices.
Naivní implementace vypadá takto. Procházíme všechny hodnoty z slice a, uvnitř tohoto cyklu procházíme všechny hodnoty slice b. A porovnáváme je. Pokud se shodují, našli jsme průnik. A ukládáme ho do result.
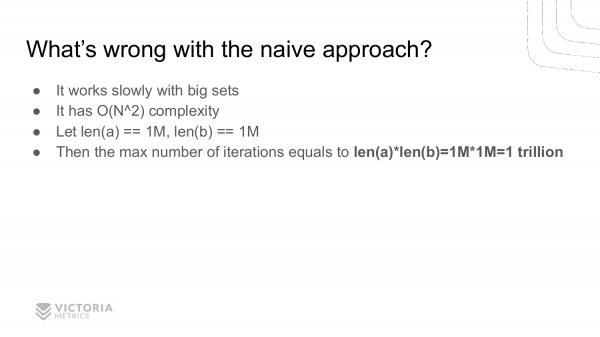
Jaké jsou nevýhody? Kvadratická složitost – to je její hlavní nevýhoda. Například, pokud máte velikosti slice a a b Pokud je to jeden milion, tato funkce vám nikdy nevrátí odpověď. Protože bude muset provést jeden bilion iterací, což je velmi hodně i pro dnešní počítače.
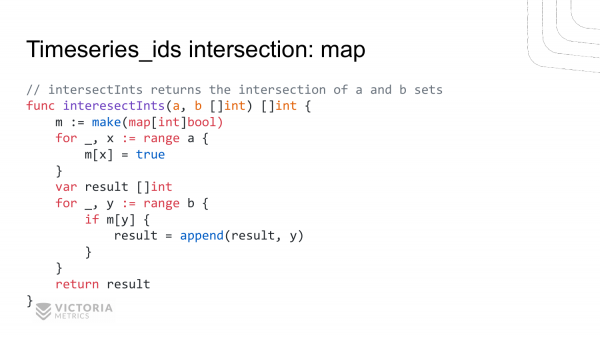
Druhá implementace je založena na mapě. Vytváříme mapu. Do této mapy vkládáme všechny hodnoty z řezů a. Poté procházíme jednotlivým cyklem po řezích b. A kontrolujeme, zda se tato hodnota z řezů b nachází v mapě. Pokud ano, přidáme ji do výsledku.
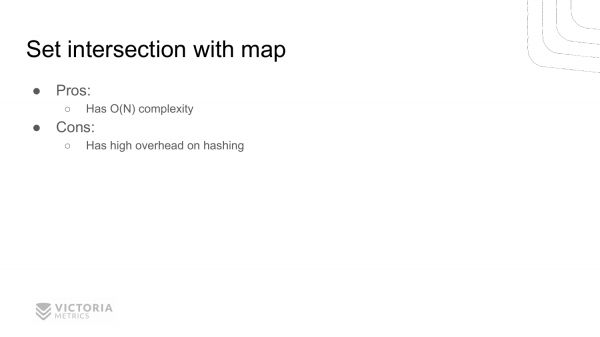
Jaké jsou výhody? Výhodou je, že zde je pouze lineární složitost. Tedy funkce se pro velké velikosti řezů vykoná mnohem rychleji. Pro řez s milionovou velikostí se tato funkce provede za 2 miliony iterací, na rozdíl od bilionu iterací, jako v předchozí funkci.
Nevýhodou je, že tato funkce vyžaduje více paměti k vytvoření této mapy.
Druhá nevýhoda je velký overhead na hashování. Tato nevýhoda není nijak zřejmá. A pro nás to také nebylo příliš zřejmé, proto zpočátku v VictoriaMetrics implementace průsečíku byla přes mapu. Ale poté profilování ukázalo, že většina procesorového času se stráví zapisováním do mapy a kontrolou existence hodnoty v této mapě.
Proč se v těchto místech strácí procesorový čas? Protože v těchto řádcích Go provádí hashovací operaci. Tedy počítá hash klíče, aby se nahlédlo do zadaného indexu v HashMapě. Operace výpočtu hashe se provádí za desítky nanosekund. To je pomalé pro VictoriaMetrics.
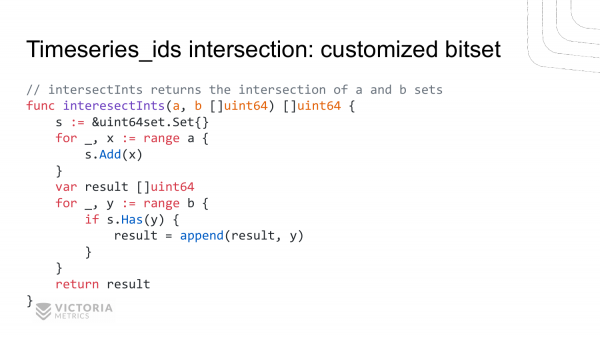
Rozhodl jsem se implementovat bitset, optimalizovaný speciálně pro tento případ. Takto nyní vypadá průsečík dvou řezů. Tady vytváříme bitset. Přidáváme do něj prvky z prvního řezu. Poté kontrolujeme přítomnost těchto prvků ve druhém řezu. A přidáváme je do výsledku. Tedy se to téměř neliší od předchozího příkladu. Jediná věc, kterou jsme zde nahradili, je volání vlastních funkcí místo přístupu k mapě. add a has.
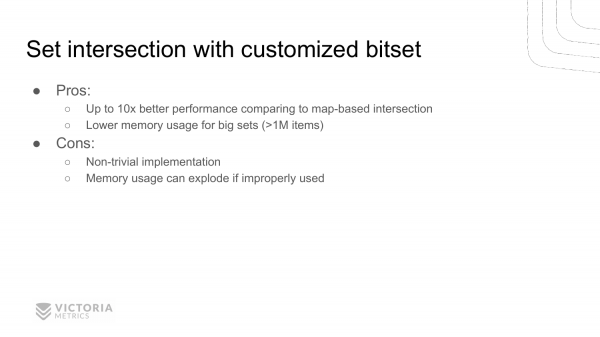
Na první pohled se zdá, že by to mělo fungovat pomaleji, pokud byla dříve použita standardní mapa, a tady se volají nějaké funkce, ale profilování ukazuje, že tato věc funguje desetkrát rychleji než standardní mapa pro případ s VictoriaMetrics.
Kromě toho používá mnohem méně paměti ve srovnání s implementací pomocí mapy. Protože zde uchováváme bity místo osmibitových hodnot.
Nevýhodou této implementace je, že není tak zřejmá a nepůsobí triviálně.
Další nevýhodou, které si mnozí nemusí všimnout, je, že tato implementace může v některých případech pracovat špatně. Tedy je optimalizována pro konkrétní případ, pro tento případ průniku ids časových řad ve VictoriaMetrics. Neznamená to, že bude fungovat ve všech situacích. Pokud ji použijete nesprávně, nedosáhnete nárůstu výkonu, ale dojde k chybě out of memory a zpomalení výkonu.
Podívejme se na implementaci této struktury. Pokud chcete, najdete ji v zdrojových kódech VictoriaMetrics, ve složce . Je optimalizována právě pro případ VictoriaMetrics, kde timeseries_id představuje 64bitovou hodnotu, kde prvních 32 bitů je většinou konstantních a mění se pouze posledních 32 bitů.
Tato datová struktura není ukládána na disku, pracuje pouze v paměti.
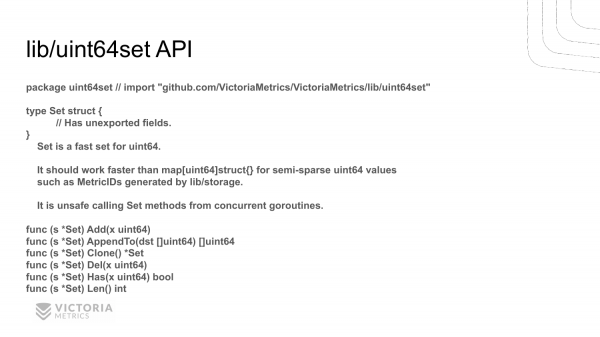
Zde je její API. Není příliš složité. API je upraveno přesně pro konkrétní příklad použití VictoriaMetrics. Tedy zde nejsou žádné zbytečné funkce. Jsou zde funkce, které jsou jasně používány VictoriaMetrics.
Existuje funkce add, která přidává nové hodnoty. Je zde funkce has, která kontroluje nové hodnoty. A je zde funkce del, která odstraňuje hodnoty. Je zde pomocná funkce len, která vrací velikost množiny. Funkce clone klonuje množinu. A funkce appendto převádí tuto množinu na slice. timeseries_ids.
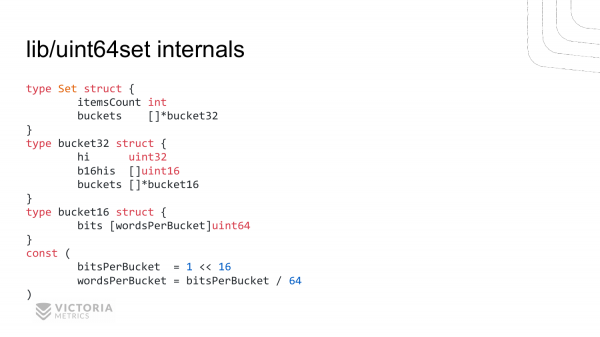
Takto vypadá implementace této datové struktury. Ve setu jsou dva prvky:
ItemsCount– je to pomocné pole, které rychle vrací počet prvků v setu. Bez tohoto pomocného pole bychom se mohli obejít, ale museli jsme ho sem přidat, protože VictoriaMetrics často ve svých algoritmech dotazuje délku bitsetu.Druhé pole je
buckets. Je to slice strukturybucket32. V každé struktuře se ukládáhipole. To jsou horní 32 bity. A dva slice —b16hisabucketszbucket16struktur.
Zde se ukládají horní 16 bity druhé části 64bitové struktury. A zde se ukládají bitsety pro dolní 16 bity každého bytu.
Bucket64 se skládá z pole uint64. Délka se počítá pomocí těchto konstant. V jednom bucket16 může maximálně být uloženo 2^16=65536 bitů. Pokud to vydělíte 8, získáte 8 kilobajtů. Pokud to ještě jednou vydělíte 8, dostanete 1000 uint64 v hodnotách. Tedy, Bucket16 – to je 8kilobajtová struktura.
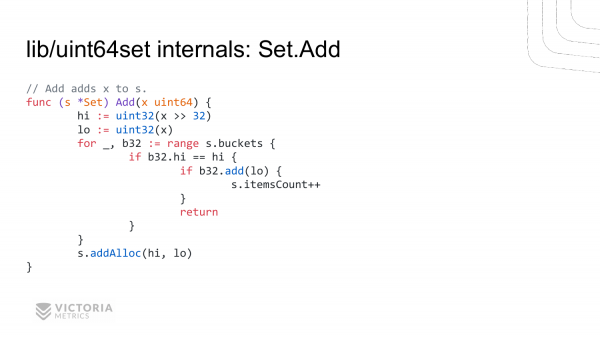
Podíváme se na to, jak je implementována jedna z metod této struktury pro přidání nové hodnoty.
Všechno začíná s uint64 hodnotou. Vypočítáme horních 32 bitů, vypočítáme dolních 32 bitů. Procházíme všechny buckets. Porovnáváme horní 32 bity v každém bucketu s přidávanou hodnotou. A pokud se shodují, zavoláme funkci add ve struktuře b32 buckets. A přidáváme tam dolních 32 bitů. A pokud to vrátilo true, znamená to, že jsme tuto hodnotu přidali a neměli jsme ji. Pokud vrátí false, taková hodnota již existovala. Poté zvýšíme počet prvků ve struktuře.
Pokud jsme nenalezli potřebný bucket s požadovanou hi-hodnotou, zavoláme funkci addAlloc, která přiděluje nový bucket, přidávající ho do bucket-struktury.
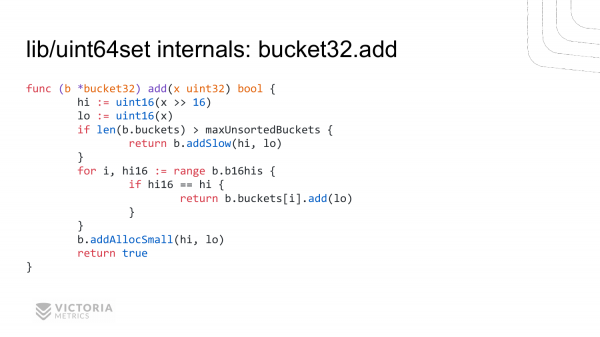
Toto je implementace funkce b32.add. Je podobná předchozí implementaci. Vypočítáme horních 16 bitů, dolních 16 bitů.
Pak procházíme všechny horní 16 bity. Hledáme shody. A při shodě voláme metodu add, kterou probereme na další stránce pro bucket16.
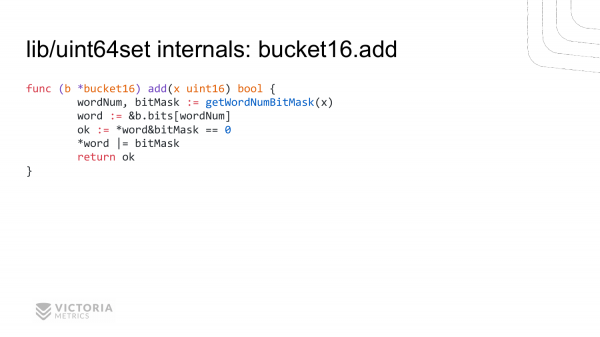
A toto je nejnižší úroveň, která by měla být maximálně optimalizována. Vypočítáme pro uint64 id hodnotu v slice bit, a také bitmask. Toto je maska pro danou 64-bitovou hodnotu, podle které lze zkontrolovat přítomnost tohoto bitu nebo jej nastavit. Kontrolujeme přítomnost tohoto nastaveného bitu a nastavujeme ho a vracíme přítomnost. Tato implementace nám umožnila zrychlit operaci průniku ids časových řad 10krát ve srovnání s běžnými maps.
Ve VictoriaMetrics vedle této optimalizace existuje mnoho dalších optimalizací. Většina z těchto optimalizací byla přidána nejen tak, ale po profilování kódu v produkci.
To je hlavní pravidlo optimalizace – nepřidávat optimalizaci, pokud se domníváte, že zde bude úzké místo, protože se může ukázat, že tam úzké místo nebude. Optimalizace obvykle zhoršuje kvalitu kódu. Proto je dobré optimalizovat pouze po profilování a ideálně v produkci, aby to byly reálná data. Kdo má zájem, může se podívat na zdrojové kódy VictoriaMetrics a prozkoumat další optimalizace, které tam jsou.
Mám dotaz na bitset. Velmi to připomíná implementaci C++ vector bool, optimalizovaný bitset. Odtud jste vzali implementaci?
Ne, to není ono. Při realizaci tohoto bitsetu jsem se řídil znalostí struktury těchto ids time series, které se používají ve VictoriaMetrics. Jejich struktura je taková, že horních 32 bitů je většinou konstantních. Spodních 32 bitů se může měnit. Čím nižší je bit, tím častěji se může měnit. Proto je tato realizace optimalizována přesně pro tuto datovou strukturu. C++ realizace, co vím, je optimalizována pro obecný případ. Pokud děláte optimalizaci pro obecný případ, znamená to, že nebude nejoptimálnější pro konkrétní situaci.
Doporučuji vám také se podívat na přednášku Alexeje Milovida. Před měsícem někde hovořil o optimalizacích v ClickHouse pro konkrétní specializace. Říká právě, že C++ realizace nebo jiná realizace jsou zacílené na dobré fungování v průměru. Může pracovat hůře než specializovaná realizace pro konkrétní znalosti, jako u nás, kdy víme, že horních 32 bitů je většinou konstantních.
Mám druhou otázku. Jaký je zásadní rozdíl od InfluxDB?
Rozdílů je mnoho. Pokud jde o výkon a spotřebu paměti, InfluxDB v testech vykazuje 10krát vyšší spotřebu paměti pro high cardinality časové řady, když jich máte hodně, například miliony. Například VictoriaMetrics spotřebovává 1 GB na milion aktivních řadů, zatímco InfluxDB spotřebovává 10 GB. A to je velký rozdíl.
Druhý zásadní rozdíl spočívá v tom, že v InfluxDB jsou podivné dotazovací jazyky – Flux a InfluxQL. Není to moc pohodlné pro práci s časovými řadami v porovnání s , který je podporován ve VictoriaMetrics. PromQL je dotazovací jazyk z Prometheus.
A ještě jedno rozdíl – InfluxDB má trochu zvláštní model dat, kde každé řádce může být uloženo několik fields s různou sadou tagů. Tyto řádky jsou rozděleny do různých tabulek. Tato dodatečná složitost ztěžuje následnou práci s touto databází. Je obtížné ji udržovat a rozumět jí.
Ve VictoriaMetrics je to mnohem jednodušší. Každá časová řada představuje klíč-hodnota. Hodnota je soubor bodů – (timestamp, value), a klíč je soubor label=value. Není žádné rozdělení na fields a measurements. To vám umožňuje vybírat jakákoliv data a následně je kombinovat, sčítat, odečítat, násobit, dělit, na rozdíl od InfluxDB, kde jsou výpočty mezi různými řádky stále nerealizovány, pokud vím. I pokud by realizovány byly, je to složité, musíte napsat spoustu kódu.
Mám upřesňující otázku. Správně jsem pochopil, že došlo k nějakému problému, o kterém jste mluvili, že tento invertovaný index se nevejde do paměti, proto se tam provádí partitionaling?
Na začátku jsem ukázal naivní implementaci invertovaného indexu na standardní Go mapě. Taková implementace není vhodná pro databáze, protože tento invertovaný index se neukládá na disk, a databáze musí ukládat na disk, aby při restartu byly tyto údaje dostupné. V této implementaci při restartu aplikace váš invertovaný index zmizí. A ztratíte přístup ke všem datům, protože je nebudete moci najít.
Dobrý den! Děkuji za přednášku! Jmenuji se Pavel. Jsem z firmy Wildberries. Mám na vás několik otázek. První otázka. Myslíte si, že kdybyste zvolili jiný princip při stavbě architektury své aplikace a partitionovali data podle času, možná byste mohli provádět průnik dat při hledání, zakládající se pouze na tom, že v jedné partitioně jsou údajena za jedno časové období, tj. za jeden časový interval, a nemuseli byste se starat o to, že máte části různě rozmístěné? Druhá otázka — jelikož implementujete takový algoritmus s bitsetem a vším ostatním, možná jste zkusili používat instrukce procesoru? Možná jste zkusili takové optimalizace?
Na druhou otázku hned odpovím. K tomu jsme se zatím ještě nedostali. Ale pokud bude potřeba, dostaneme se k tomu. A co byla první otázka?
Diskutovali jste dva scénáře. A řekli jste, že jste zvolili druhý se složitější implementací. A nepřednostili jste první, kde jsou data partitionována podle času.
Ano. V prvním případě by byl celkový objem indexu větší, protože v každé partici bychom museli uchovávat duplicitní data pro tyto časové řady, které pokračují napříč všemi těmito partcemi. A pokud máte malou míru odchodu časových řad, tj. stále se používají stejné řady, v prvním případě bychom výrazněji ztratili na objemu zabraného diskového prostoru ve srovnání s druhým případem.
Ano, partitioning podle času je dobrá volba. To používá i Prometheus. Ale v Prometheu je další nevýhoda. Při sloučení těchto kousků dat musí držet v pamětí meta-informace ke všem labelům a časovým řadám. Proto, pokud jsou kousky dat velké, které sloučí, pak spotřeba paměti velmi roste při sloučení, na rozdíl od VictoriaMetrics. Při sloučení VictoriaMetrics vůbec nepoužívá paměť, tam se spotřebují jen nějaké kilobajty, bez ohledu na velikosti sloučených kousků dat.
Algoritmus, který máte použitý, využívá paměť. V ní jsou označeny timeseries štítky, na kterých jsou hodnoty. A tímto způsobem kontrolujete přítomnost v jednom datovém poli a v druhém. A chápete - došlo k průsečíku nebo ne. Obvykle v databázích implementují kurzory, iterátory, které uchovávají svůj aktuální stav a procházejí se podle seřazených dat díky čemuž máte jednoduchou složitost u těchto operací.
Proč nepoužíváme kurzory pro průnik dat?
Ano.
Máme v LevelDB nebo v mergesetu právě seřazené řádky. Můžeme projít kurzorem a najít průnik. A proč to nepoužíváme? Protože - to je pomalé. Protože kurzory předpokládají, že na každý řádek musíte zavolat funkci. Zavolání funkce - to je 5 nanosekund. A pokud máte 100 000 000 řádků, pak strávíme půl sekundy jen na volání funkce.
Takové něco je, ano. A poslední otázka. Otázka, která může znít trochu zvláštně. Proč při příjmu dat nelze spočítat všechny potřebné agregáty a ukládat je v potřebné podobě? Proč ukládat obrovské objemy do nějakých systémů jako VictoriaMetrics, ClickHouse atd., a pak trávit spoustu času na nich?
Dám příklad, aby to bylo jasnější. Představte si, jak funguje malý hračkový rychloměr? Zaznamenává vzdálenost, kterou jste urazili, a neustále ji přidává do jedné hodnoty, do druhé – čas. A dělí. A dostává průměrnou rychlost. Můžete dělat něco podobného. Sčítat „na letu“ všechny potřebné faktory.
Dobře, chápu otázku. Váš příklad má své místo. Pokud víte, jaké agregáty potřebujete, pak je to nejlepší realizace. Ale problém je v tom, že lidé ukládají tyto metriky, nějaká data do ClickHouse a neví ještě, jak je v budoucnu budou agregovat, filtrovat, proto musí ukládat všechny surové údaje. Ale pokud víte, že potřebujete spočítat něco průměrného, proč to nespočítat, místo abyste tam ukládali hromadu surových hodnot? Ale to jen v případě, že přesně víte, co potřebujete.
Mimochodem, databáze pro ukládání časových řad podporují počítání agregátů. Například Prometheus podporuje . T. j. může to být provedeno, pokud víte, jaké agregáty budete potřebovat. V VictoriaMetrics to zatím není, ale před ní se obvykle instaluje Prometheus, ve kterém to lze udělat v pravidlech záznamu.
Například na předchozí práci bylo potřeba počítat počet událostí v klouzavém okně za poslední hodinu. Problém byl v tom, že bylo nutné udělat vlastní realizaci na Go, t. j. službu pro počítání této věci. Tato služba byla nakonec dost složitá, protože to není snadné spočítat. Realizace může být jednoduchá, pokud potřebujete počítat nějaké agregáty na pevných časových intervalech. Pokud však chcete počítat události v klouzavém okně, není to tak snadné, jak se zdá. Myslím, že to zatím není realizováno v ClickHouse nebo v databázích pro časové řady, protože je to složité na realizaci.
A ještě jedna otázka. Teď jsme hovořili o průměrování a vzpomněl jsem si, že kdysi existoval takový nástroj jako Graphite s backendem Carbon. A uměl prořezávat staré údaje, t. j. nechával jednu hodnotu za minutu, jednu hodnotu za hodinu atd. V zásadě je to docela pohodlné, pokud potřebujeme surová data, řekněme, za měsíc, a všechno ostatní se může prořezat. Ale Prometheus a VictoriaMetrics tuto funkčnost nepodporují. Plánuje se její podpora? Pokud ne, proč?
Děkujeme za dotaz. Naši uživatelé se na to pravidelně ptají. Ptají se, kdy přidáme podporu pro zhušťování (downsampling). V tomto ohledu existuje několik problémů. Za prvé, každý uživatel chápe pod tímto pojmem downsampling něco jiného: někdo chce získat libovolný bod v daném intervalu, někdo chce maximální, minimální, průměrné hodnoty. Pokud do vaší databáze zapisují data různé systémy, nelze je rozhodně zhušťovat jednotně. Může se stát, že pro každý systém je potřeba použít jiné zhuštění. A to je obtížné na realizaci.
A druhé - VictoriaMetrics, stejně jako ClickHouse, je optimalizován pro práci s velkým objemem surových dat, takže dokáže zpracovat miliardu řádků za méně než jednu sekundu, pokud máte v systému mnoho jader. Skanning časových bodů v VictoriaMetrics - 50 000 000 bodů za sekundu na jedno jádro. A tato výkonnost se škáluje na stávající jádra. Tedy, pokud máte například 20 jader, získáte skanning miliardy bodů za sekundu. A tato vlastnost VictoriaMetrics a ClickHouse snižuje potřebu downsamplingu.
Další vlastností je, že VictoriaMetrics efektivně komprimuje tato data. Průměrná komprese v produkčním prostředí se pohybuje od 0,4 do 0,8 bajtů na bod. Každý bod – to je timestamp + hodnota. A v průměru se komprimuje na méně než jeden bajt.
Sergěj. Mám otázku. Jaký je minimální časový kvant zapisování?
Jedna milisekunda. Nedávno jsme měli rozhovor s jinými vývojáři databází pro časové řady. U nich je minimální časový kvant jedna sekunda. A v Graphite je to například také jedna sekunda. V OpenTSDB také jedna sekunda. V InfluxDB – nanosekundová přesnost. Ve VictoriaMetrics – jedna milisekunda, protože v Prometheus je to jedna milisekunda. A VictoriaMetrics byla původně vyvinuta jako remote storage pro Prometheus. Ale nyní může uchovávat data i z dalších systémů.
Člověk, se kterým jsem mluvil, říká, že mají sekundovou přesnost — to jim stačí, protože to závisí na typu dat, která jsou uchovávána v databázi časových řad. Pokud se jedná o DevOps data nebo data z infrastruktury, kde je shromažďujete s intervalem 30 sekund až minutu, stačí sekundová přesnost, méně již není potřeba. Pokud však shromažďujete tato data z high frequency trading systems, je třeba nanosekundová přesnost.
Milisekundová přesnost ve VictoriaMetrics je vhodná jak pro DevOps případ, tak i pro většinu případů, které jsem zmínil na začátku prezentace. Jedině pro high frequency trading systémy nemusí být vhodná.
Děkuji! A ještě otázka. Jaká je kompatibilita s PromQL?
Plná zpětná kompatibilita. VictoriaMetrics plně podporuje PromQL. Kromě toho přidává ještě dodatečné rozšířené funkce k PromQL, které se nazývá . O této rozšířené funkčnosti je k dispozici prezentace na YouTube. Mluvil jsem o tom na Monitoring Meetup na jaře v Petrohradě.
Telegram kanál .
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Co vám brání přejít na VictoriaMetrics jako dlouhodobé úložiště pro Prometheus? (Napište to do komentářů, přidám to do ankety))
71,4%Nepoužívám Prometheus5
28,6%Nevěděl jsem o VictoriaMetrics2
Hlasovalo 7 uživatelů. Zdrželo se 12 uživatelů.
Zdroj: habr.com
