

Budeme se zabývat prací Zabbix s databází TimescaleDB jako backendem. Ukážeme, jak ji spustit od nuly a jak migrovat z PostgreSQL. Také přineseme srovnávací testy výkonu dvou konfigurací.
HighLoad++ Sibiř 2019. Sál „Tomsk“. 24. června, 16:00. Témy a . Další konference HighLoad++ se uskuteční 6. a 7. dubna 2020 v Petrohradě. Podrobnosti a vstupenky .
Andrej Guščin (dále – AG): – Jsem inženýr technické podpory ZABBIX (dále – „Zabbix“), školitel. Pracuji více než 6 let v technické podpoře a přímo se zabývám výkonem. Dnes budu hovořit o výkonu, který může poskytnout TimescaleDB v porovnání s běžným PostgreSQL 10. Také budu mít určitou úvodní část – o tom, jak vůbec systém funguje.
Hlavní výzvy výkonu: od sběru po čištění dat
Začněme tím, že existují určité výzvy výkonu, se kterými se setkává každý monitorovací systém. První výzvou výkonu je rychlé shromažďování a zpracování dat.
Dobrý monitorovací systém by měl rychle a včas získávat všechna data, zpracovávat je podle triggerových výrazů, tedy je zpracovávat podle určitých kritérií (v různých systémech to funguje různě), a ukládat je do databáze, aby bylo možné tato data později použít.
Druhou výzvou výkonu je uchovávání historie. Udržovat v databázi často a mít rychlý a pohodlný přístup k těmto metrikám, které byly shromážděny za určité časové období. Nejvíce záleží na tom, aby se tato data pohodlně získala, použila v reportech, grafech, aktivech, v nějakých prahových hodnotách, pro upozornění atd.
Třetí výzvou výkonu je čištění historie, což znamená, když nastane den, kdy není potřeba uchovávat podrobné metriky, které byly shromážděny za 5 let (nebo dokonce měsíc nebo dva). Některé uzly sítě byly odstraněny, nebo některé hosty, metriky již nejsou potřebné, protože se staly zastaralými a přestaly být shromažďovány. To vše je třeba vyčistit, aby se vaše databáze nezvětšila na velkou velikost. A vůbec, čištění historie je často vážnou zkouškou pro úložiště – obvykle to výrazně ovlivňuje výkon.
Jak vyřešit problémy s vyrovnáváním zatížení?
Nyní se budu konkrétně věnovat „Zabbixu“. V „Zabbixu“ jsou první a druhé výzvy řešeny pomocí cache.
Sbíraní a zpracování dat – používáme operační paměť k uchovávání všech těchto dat. O těchto datech se nyní dozvíte více.
Také na straně databáze existuje určité cache pro hlavní dotazy – pro grafy a další věci.
Cache na straně samotného Zabbix serveru: máme ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Co to znamená?
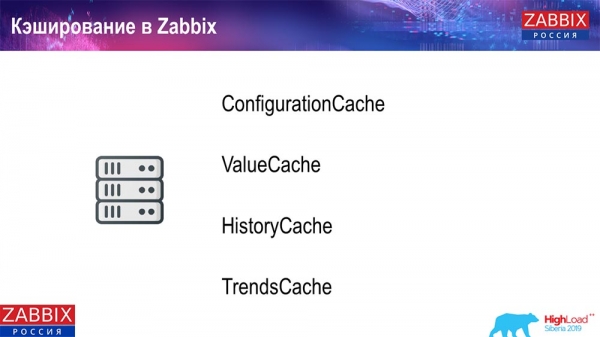
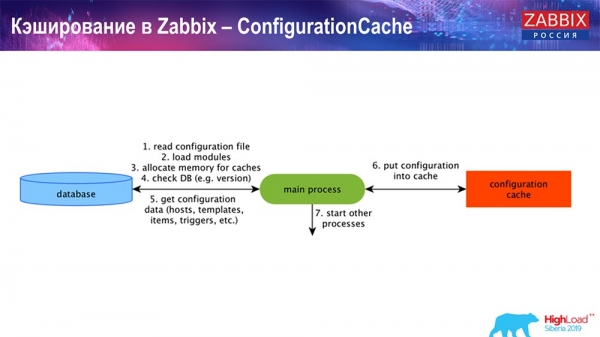
ConfigurationCache – to je hlavní cache, ve které uchováváme metriky, hostitele, datové prvky, spouštěče; vše potřebné pro zpracování předzpracování, sběru dat, z jakých hostitelů sbírat a s jakou frekvencí. To vše je uchováváno v ConfigurationCache, abychom neměli zbytečné dotazy do databáze. Po spuštění serveru tuto cache aktualizujeme (vytváříme) a pravidelně aktualizujeme (podle nastavení konfigurace).
Cache v Zabbixu. Sběr dat
Zde je schéma dost velké:
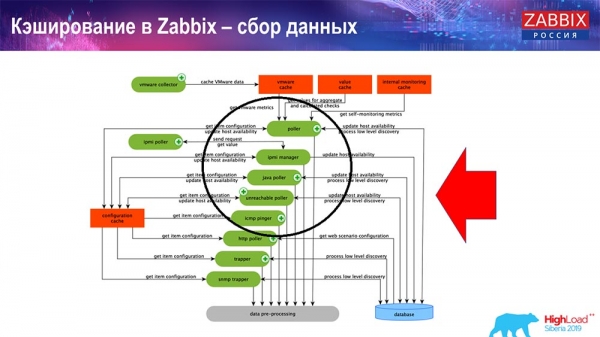
Hlavními prvky v schématu jsou tito sběrači:
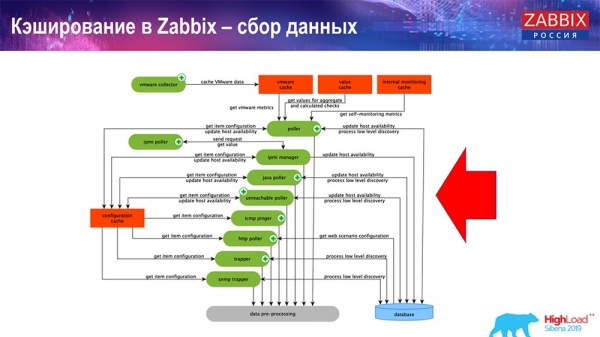
To jsou samotné procesy sběru, různé „polery“, které odpovídají za různé druhy sběrů. Shromažďují data přes icmp, ipmi, různé protokoly a toto vše předávají na předzpracování.
PreProcessing HistoryCache
Pokud máme vypočítané datové prvky (kdo zná „Zabbix“, ví), existují vypočítané a agregační datové prvky – ty bereme přímo z ValueCache. O tom, jak se plní, budu hovořit později. Všichni tito sběrači používají ConfigurationCache k získání svých úkolů a dále je předávají na předzpracování.
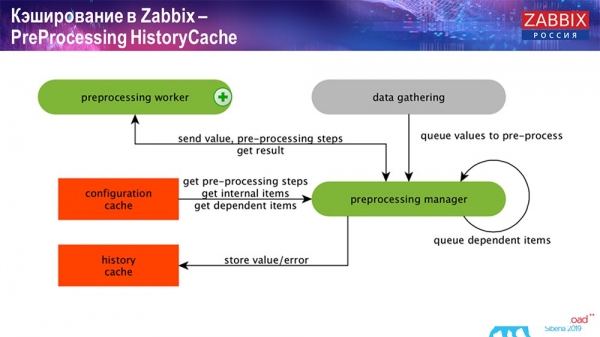
Předzpracování také používá ConfigurationCache k získání kroků předzpracování a zpracovává tato data různými způsoby. Od verze 4.2 je to u nás vyvedeno na proxy. To je velmi pohodlné, protože samotné předzpracování je docela těžká operace. A pokud máte velmi velký „Zabbix“ s velkým počtem datových prvků a vysokou frekvencí sběru, výrazně to usnadňuje práci.
Poté, co jsme zpracovali tato data nějakým způsobem pomocí předzpracování, uchováváme je v HistoryCache pro další zpracování. Tímto končí sběr dat. Přecházíme k hlavnímu procesu.
Práce History syncer
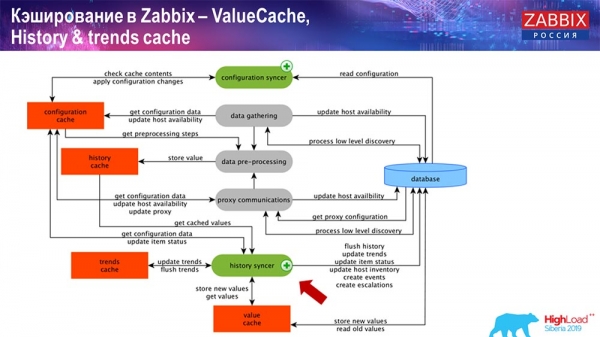
Hlavním procesem v „Zabbixu“ (protože má monolitní architekturu) je History syncer. Tento hlavní proces se zabývá atomárními operacemi každého datového prvku, tedy každou hodnotou:
- přichází hodnota (tu bere z HistoryCache);
- kontroluje v Configuration syncer: zda existují nějaké spouštěče pro výpočty – ty vypočítává;
pokud existují – vytváří události, vytváří eskalaci pro případ, že by bylo třeba podle konfigurace vygenerovat upozornění; - ukládá spouštěče pro pozdější zpracování, agregaci; pokud agregujete za poslední hodinu apod., tuto hodnotu uchovává ValueCache, aby se nemusela dotazovat tabulka historie; tímto způsobem se ValueCache naplňuje potřebnými daty, které jsou nezbytné pro výpočty spouštěčů, vypočítávaných prvků atd.;
- poté History syncer zapisuje všechny údaje do databáze;
- databáze je zapisuje na disk – tím proces zpracování končí.
Databáze. Cacheování
Na straně DB, když chcete vidět grafy nebo nějaké zprávy o událostech, existují různé cache. V rámci této prezentace o nich však nebudu hovořit.
Pro MySQL existuje Innodb_buffer_pool, a také spousta různých cache, které lze také nastavit.
Ale tohle jsou hlavní:
- shared_buffers;
- effective_cache_size;
- shared_pool.
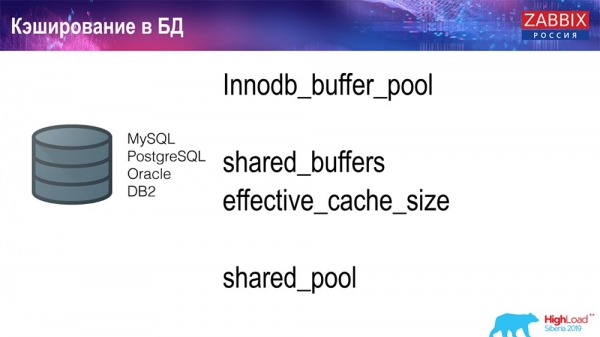
Pro všechny databáze jsem uvedl, že existují určité cache, které umožňují uchovávat v operační paměti ta data, která jsou často potřebná pro dotazy. Tam mají své technologie pro toto.
O výkonnosti databáze
Existuje konkurenční prostředí, tedy server „Zabbix“ shromažďuje data a zapisuje je. Při restartu také čte z historie pro naplnění ValueCache atd. Také zde můžete mít skripty a zprávy, které používají „Zabbix“-API, což je vybudováno na základě webového rozhraní. „Zabbix“-API vstupuje do DB a získává potřebná data pro generování grafů, zpráv nebo nějakého seznamu událostí, posledních problémů.
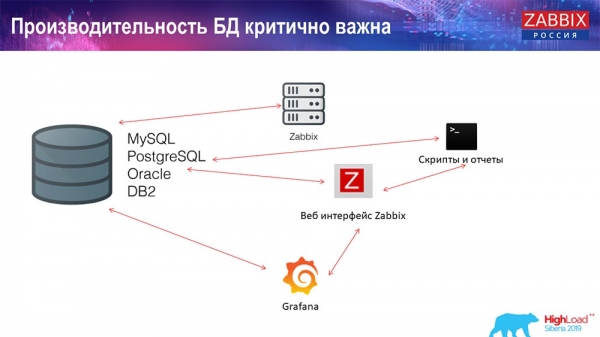
Také velmi populárním řešením pro vizualizaci je Grafana, kterou naši uživatelé používají. Umí se připojit přímo jak přes „Zabbix“-API, tak i přes DB. Také vytváří určitou konkurenci pro získání dat: potřebné je jemnější, dobré nastavení DB, aby odpovídalo rychlému vydávání výsledků a testování.
Údržba historie. V Zabbixu je Housekeeper.
Třetí funkce, která se používá v Zabbixu, je údržba historie pomocí Housekeeperu. "Housekeeper" dodržuje všechna nastavení, to znamená, že máme v datových prvcích uvedeno, jak dlouho uchovávat (ve dnech), jak dlouho uchovávat trendy, dynamiku změn.
Neřekl jsem o TrendCache, který počítáme na místě: data přicházejí, agregujeme je za jednu hodinu (většinou to jsou čísla za poslední hodinu), průměr, minimum a zapisujeme to jednou za hodinu do tabulky dynamiky změn ("Trendy"). "Housekeeper" se spouští a odstraňuje běžnými selecty údaje z databáze, což není vždy efektivní.
Jak zjistit, že to není efektivní? Na grafech výkonu interních procesů můžete vidět takový obrázek:
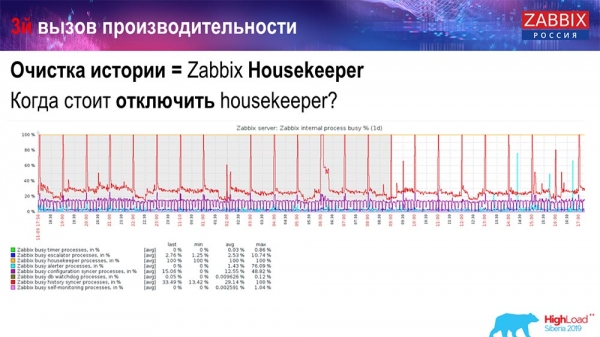
Máte History syncer stále zaměstnaný (červený graf). A "oranžový" graf, který jde nahoře. To je "Housekeeper", který se spouští a čeká od databáze, až odstraní všechny řádky, které nařídil.
Vezměme nějaké Item ID: je potřeba odstranit posledních 5 tisíc; samozřejmě podle indexů. Ale obvykle je datový soubor dostatečně velký – databáze to stejně čte z disku a zvedá to do cache, což je pro databázi velmi nákladná operace. V závislosti na jejích rozměrech to může způsobovat určité problémy s výkonem.
Deaktivaci "Housekeeper" lze provést jednoduchým způsobem – máme zde všem známé webové rozhraní. Nastavení v Administraci obecně (nastavení pro "Housekeeper") vypínáme interní housekeeping pro interní historii a trendy. Odpovídajícím způsobem "Housekeeper" již tímto neřídí:
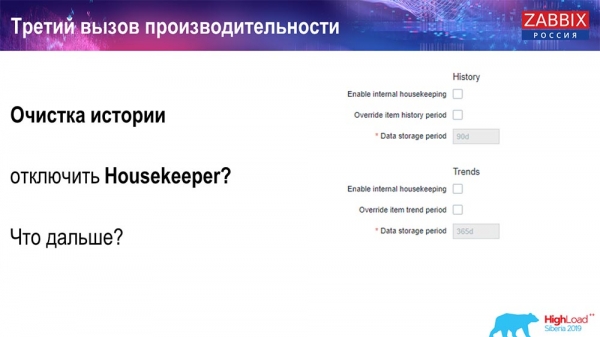
Co se dá dělat dál? Vypnuli jste to, vaše grafy se srovnaly… Jaké mohou být v tomto případě další problémy? Co může pomoci?
Partitioning (sekcionování)
Obvykle se to nastavuje na každé relační databázi, kterou jsem vyjmenoval, různými způsoby. Na MySQL existuje své vlastní technologie. Ale obecně jsou si velmi podobné, pokud hovoříme o PostgreSQL 10 a MySQL. Samozřejmě, existuje tam spousta vnitřních rozdílů v tom, jak je to celé realizováno a jak to vše ovlivňuje výkon. Ale obecně vytváření nové partition často také vede k určitým problémům.
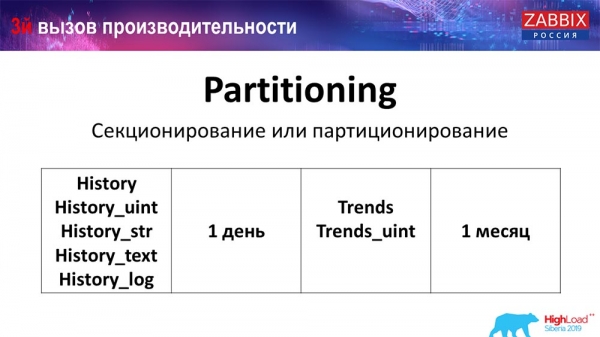
V závislosti na vaší konfiguraci (jak mnoho dat se vytvoří za jeden den) se obvykle nastavuje nejmenší možné – 1 den/partice, a pro „trendy“, dynamiku změn – 1 měsíc/nová partice. To se může měnit, pokud máte opravdu velkou konfiguraci.
Hned na začátku vás upozorním na velikosti konfigurace: do 5 tisíc nových hodnot za sekundu (nvps) – to bude považováno za malou „konfiguraci“. Střední – od 5 do 25 tisíc hodnot za sekundu. Všechno, co je nad tím, jsou již velké a velmi velké instalace, které vyžadují velmi pečlivé nastavení databáze.
U velmi velkých instalací 1 den – to může být neoptimální. Osobně jsem viděl na MySQL particie o velikosti 40 gigabajtů za den (a mohou být i větší). To je velmi velký objem dat, který může způsobovat nějaké problémy. Je nutné ho zmenšovat.
Proč je potřeba partišionování?
Co přináší partitioning, myslím, že všichni víme – to je sekcionování tabulek. Často to jsou jednotlivé soubory na disku a span-dotazy. Lepší optimálně vybírá jednu partici, pokud to spadá do běžného partišionování.
Pro „Zabbix“, zejména, se používá podle rozsahu, tedy používáme timestamp (obyčejné číslo, čas od začátku epochy). Zadáte začátek dne/konec dne, a to je partice. Tím pádem, pokud se ptáte na data dvou dnů stará, to vše se vybírá z databáze rychleji, protože potřebujete pouze jeden soubor načíst do cache a vydat (a ne velkou tabulku).
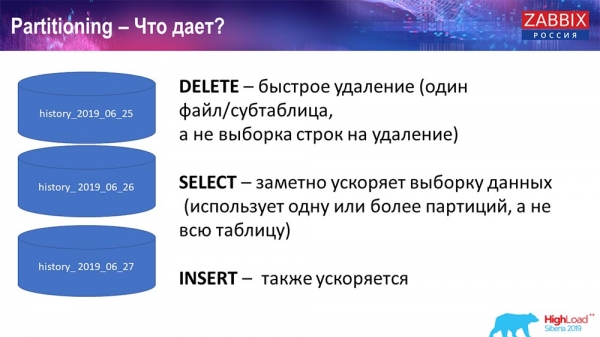
Mnoho databází také zrychluje insert (vkládání do jedné child-tabule). Zatím mluvím abstraktně, ale to je také možné. Partitoning často pomáhá.
Elasticsearch pro NoSQL
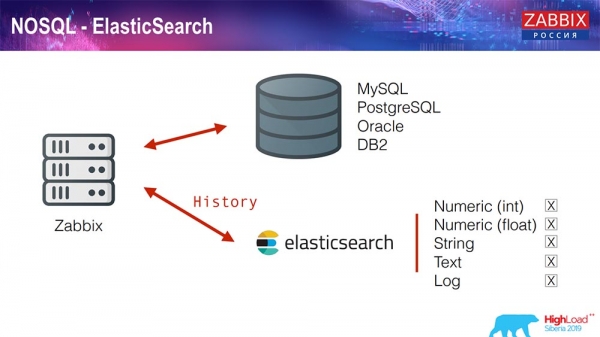
Nedávno, ve verzi 3.4, jsme implementovali řešení pro NoSQL. Přidali jsme možnost zapisovat do Elasticsearch. Můžete zapisovat jednotlivé typy: vybíráte – buď zapisujete čísla, nebo nějaké znaky; máme string-text, logy můžete psát do Elasticsearch… Tím pádem, webové rozhraní už také bude přistupovat k Elasticsearch. To skvěle funguje v určitých případech, ale v tuto chvíli to lze využívat.
TimescaleDB. Hypertabulky
Pro verzi 4.4.2 jsme si všimli jedné věci – TimescaleDB. Co to vlastně je? Je to rozšíření pro PostgreSQL, což znamená, že má nativní rozhraní PostgreSQL. Navíc toto rozšíření umožňuje mnohem efektivněji pracovat s časovými řadami a má automatické dělení. Jak to vypadá:
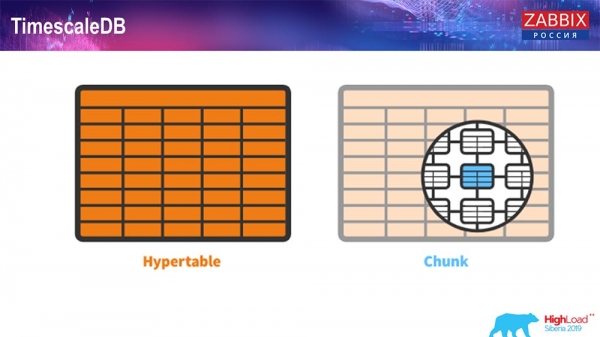
Toto je hypertable – koncept v Timescale. Je to hypertabulka, kterou vytváříte, a v ní se nacházejí chunks (chunk). Chunks jsou partition, což jsou child tabulky, pokud se nepletu. Opravdu je to efektivní.
TimescaleDB a PostgreSQL
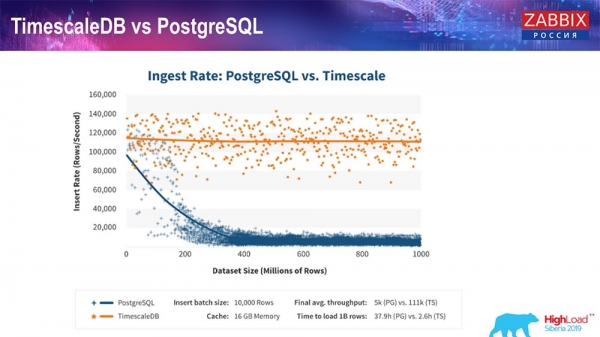
Jak výrobci TimescaleDB ujišťují, používají správnější algoritmus zpracování dotazů, konkrétně insertů, který umožňuje přibližně konstantní výkon při rostoucí velikosti vkládaného datasetu. Jinými slovy, po 200 milionech řádků běžný PostgreSQL začne velmi silně klesat a ztrácí výkon doslova na nulu, zatímco Timescale umožňuje vkládání insertů co nejefektivněji při jakémkoliv množství dat.
Jak nainstalovat TimescaleDB? Je to jednoduché!
V dokumentaci to máte popsané – můžete to nainstalovat z balíčků pro jakékoliv… Závisí to na oficiálních balících PostgreSQL. Můžete to také zkompilovat ručně. Tak se stalo, že jsem musel kompilovat pro DB.
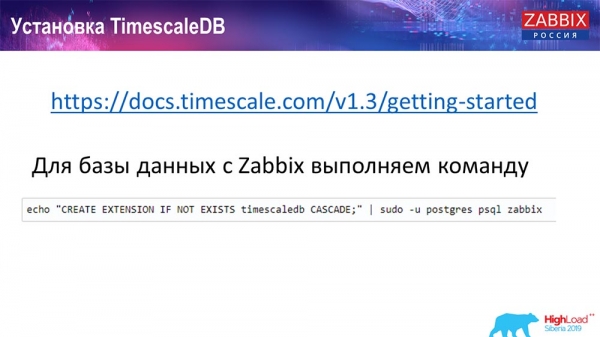
Na Zabbixu jednoduše aktivujeme rozšíření. Myslím, že ti, kdo používali v PostgreSQL rozšíření… Prostě aktivujete rozšíření, vytvoříte ho pro DB Zabbix, kterou používáte.
A poslední krok…
TimescaleDB. Migrace historických tabulek
Musíte vytvořit hypertable. K tomu je speciální funkce – Create hypertable. V ní jako první parametr uvedete tabulku, která je v této DB potřebná (pro kterou potřebujete vytvořit hypertable).
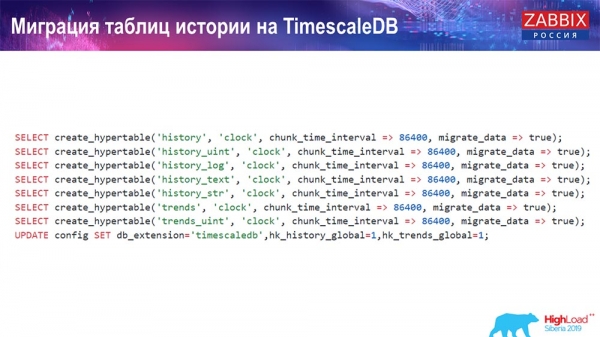
Pole, podle kterého bude vytvářeno, a chunk_time_interval (to je interval chunks (partitions, které mají být použity). 86 400 – to je jeden den.
Parametr migrate_data: pokud zadáte true, převede všechny aktuální data do předem vytvořených chuck.
Sám jsem použil migrate_data – trvalo to slušnou dobu, v závislosti na velikosti vaší DB. Měl jsem více než terabajt – vytvoření trvalo více než hodinu. V některých případech při testování jsem odstraňoval historická data pro text (history_text) a string (history_str), abych je nepřenášel – pro mě ve skutečnosti nebyly zajímavé.
A poslední aktualizaci provádíme v našem db_extention: instalujeme timescaledb, aby databáze a konkrétně náš „Zabbix“ rozuměl, že existuje db_extention. Ten jej aktivuje a správně používá syntaxi a dotazy na databázi, využívajíc již ty „funkce“, které jsou potřebné pro TimescaleDB.
Konfigurace serveru
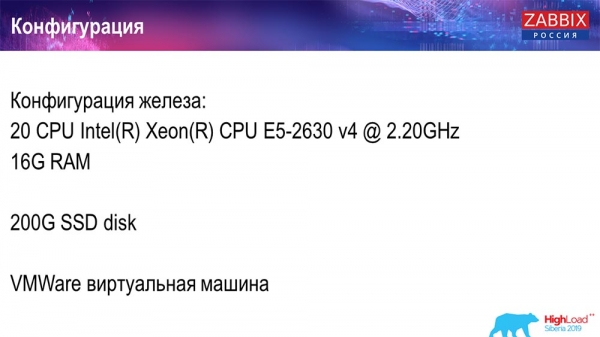
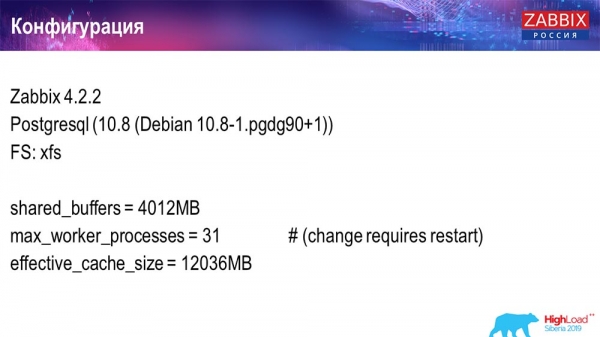
Použil jsem dva servery. První server – je virtuální stroj, který je dost malý, 20 procesorů, 16 gigabajtů operační paměti. Nastavil jsem na něm „Postgres“ 10.8:
Operační systém byl Debian, souborový systém – xfs. Udělal jsem minimální nastavení, abych používal tuto databázi, kromě toho, že bude využívat i samotný „Zabbix“. Na tomto stroji běžel server „Zabbix“, PostgreSQL a zatěžovací agenty.
Použil jsem 50 aktivních agentů, kteří používají LoadableModule, aby rychle generovali různé výsledky. Ti generovali řádky, čísla a tak dále. Naplnil jsem databázi velkým množstvím dat. Původní konfigurace obsahovala 5 tisíc datových prvků na každý host, a přibližně každý datový prvek obsahoval spouštěč – aby šlo o skutečné nastavení. Někdy je dokonce zapotřebí více než jednoho spouštěče.
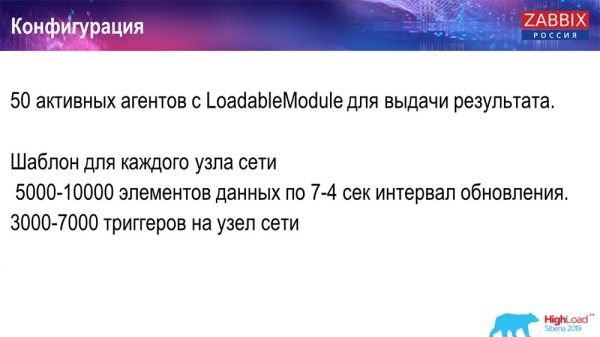
Interval aktualizace, samotné zatížení jsem reguloval tím, že jsem nepoužíval pouze 50 agentů (přidával jsem další), ale také pomocí dynamických datových prvků a snižoval jsem interval aktualizace na 4 sekundy.
Test výkonu. PostgreSQL: 36 tisíc NVPs
První spuštění, první nastavení jsem měl na čistém PostgreSQL 10 na tomto hardwaru (35 tisíc hodnot za sekundu). Celkově, jak je vidět na obrazovce, vložení dat trvá zlomky sekundy – vše je v pořádku a rychlé, SSD disky (200 gigabajtů). Jediné, co 20 GB se docela rychle zaplní.
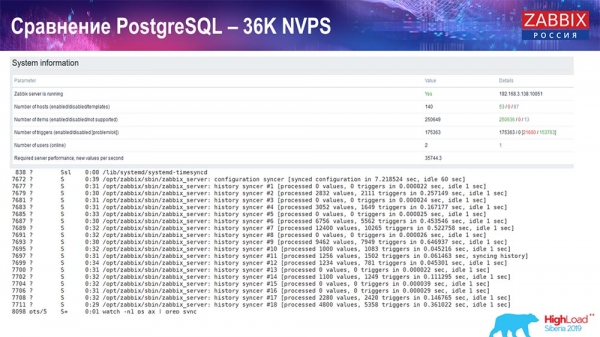
Bude dále dostatek takových grafů. To je standardní dashboard výkonu serveru „Zabbix“.
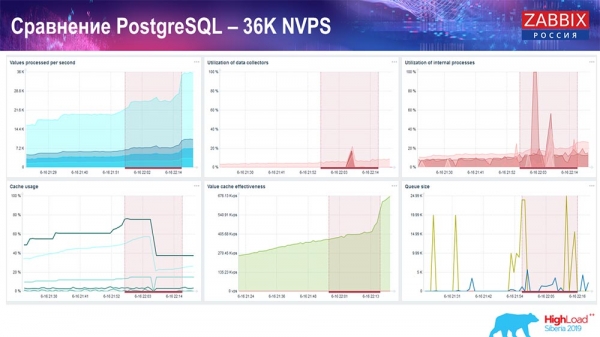
První graf – počet hodnot za sekundu (modrý, nahoře vlevo), 35 tisíc hodnot v tomto případě. To (nahoře uprostřed) je zatížení procesů sběru, a to (nahoře vpravo) je zatížení právě vnitřních procesů: history syncers a housekeeper, který tady (dole uprostřed) probíhal dost dlouho.
Tento graf (níže uprostřed) ukazuje využití ValueCache – kolik hitů ValueCache je pro spouštěče (několik tisíc hodnot za sekundu). Další důležitý graf je čtvrtý (níže vlevo), který zobrazuje využití HistoryCache, o kterém jsem mluvil, a který slouží jako vyrovnávací paměť před vložením do databáze.
Test výkonu. PostgreSQL: 50 tisíc NVPs
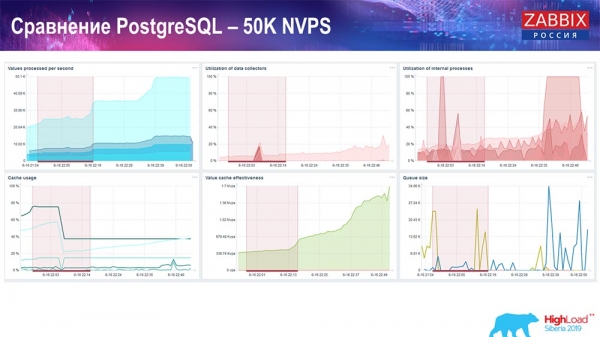
Dále jsem zvýšil zátěž na 50 tisíc hodnot za sekundu na téže sestavě. Při zatížení „Housekeeperem“ 10 tisíc hodnot již bylo zapisováno za 2-3 sekundy s výpočtem. Což je v podstatě ukázáno na následujícím snímku obrazovky:
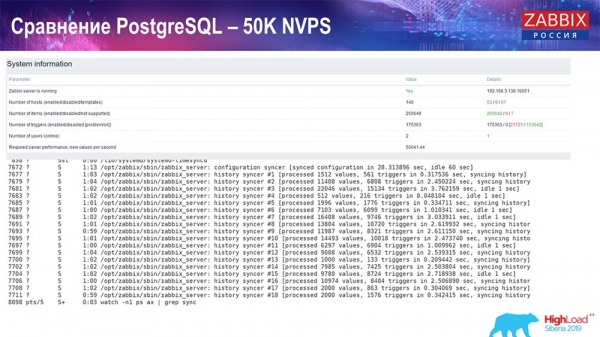
„Housekeeper“ už začíná zasahovat do práce, ale celkově zatížení history-synkronizátorů je zatím stále na úrovni 60 % (třetí graf, nahoře vpravo). HistoryCache se již během práce „Housekeepera“ začíná aktivně plnit (níže vlevo). Měl přibližně půl gigabajtu, plnil se na 20 %.
Test výkonu. PostgreSQL: 80 tisíc NVPs
Dále jsem zvýšil na 80 tisíc hodnot za sekundu:
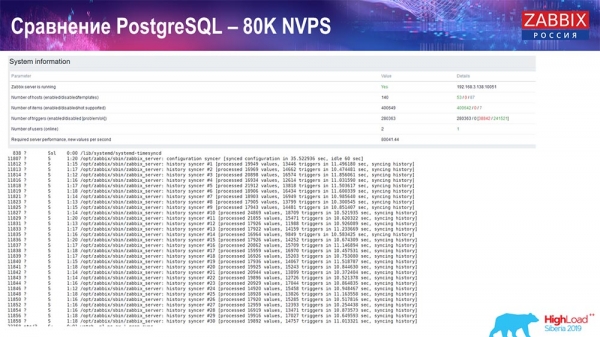
Bylo to přibližně 400 tisíc datových prvků, 280 tisíc spouštěčů. Vložení, jak vidíte, podle zatížení history-synkronizátorů (bylo jich 30) bylo již dost vysoké. Poté jsem zvyšoval různé parametry: history-synkronizátory, cache… Na této sestavě zatížení history-synkronizátorů začalo stoupat k maximu, prakticky „na polici“ – odpovídajícím způsobem, HistoryCache začalo vykazovat velmi vysoké zatížení:
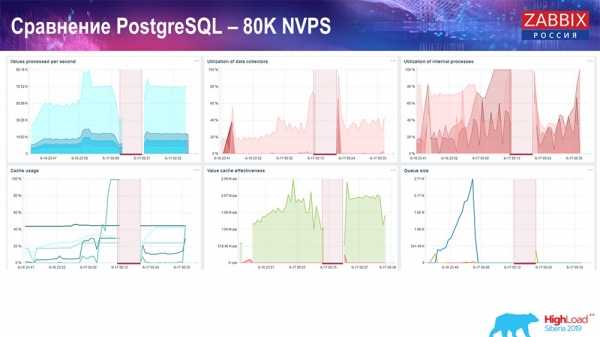
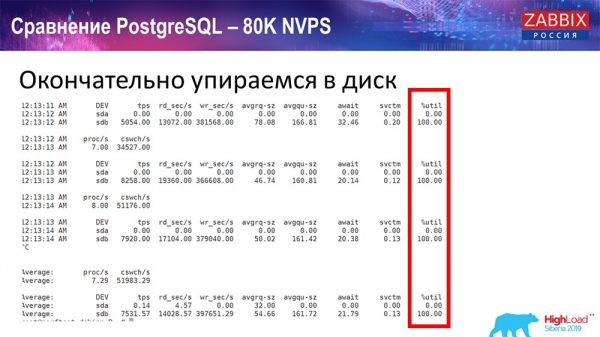
Celou dobu jsem sledoval všechny parametry systému (jak je využíván procesor, operační paměť) a zjistil jsem, že vytížení disků bylo maximální – dosáhl jsem maximální kapacity tohoto disku na této sestavě, na této virtuální mašině. „Postgres“ začal při takové intenzitě dost aktivně vyhazovat data, a disk již nestačil zapisovat a číst…
Vzala jsem jiný server, který měl již 48 procesorů a 128 gigabytů operační paměti:
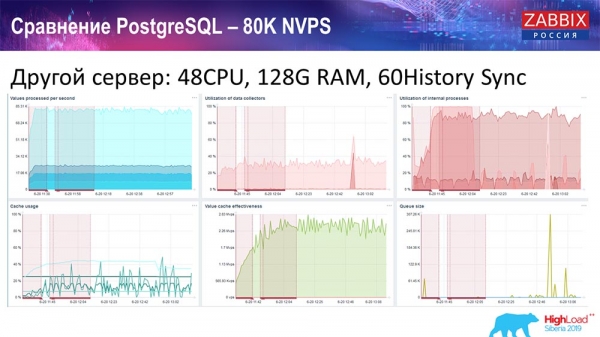
Také jsem ho „vylepšil“ – nainstaloval jsem History syncer (60 kusů) a dosáhl jsem přijatelných výkonnostních parametrů. V podstatě nejsme „na polici“, ale už je to pravděpodobně limit výkonu, kde už je potřeba něco podniknout.
Test výkonu. TimescaleDB: 80 tisíc NVPs
Měl jsem hlavní úkol – použít TimescaleDB. Na každém grafu je vidět propad:
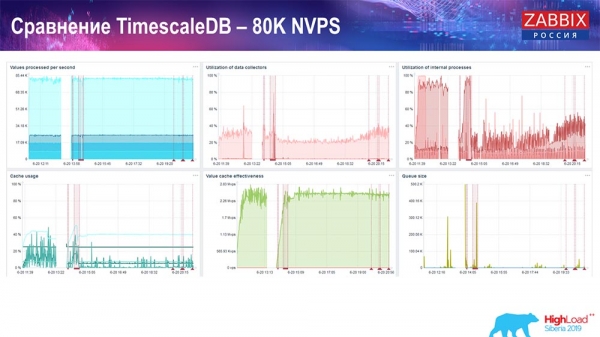
Tyto propady jsou právě migrací dat. Po tomto se v serveru Zabbix, jak vidíte, profil načítání history-sinkers výrazně změnil. Prakticky třikrát rychleji umožňuje vkládat data a využívá méně HistoryCache – odpovídající tomu, že data budou dodávána včas. Opět, 80 tisíc hodnot za sekundu – to je poměrně vysoká rychlost (samozřejmě ne pro Yandex). Celkově jde o poměrně velké nastavení s jedním serverem.
Test výkonu PostgreSQL: 120 tisíc NVPs
Dále jsem zvýšil hodnotu počtu datových prvků na půl milionu a získal odhadovanou hodnotu 125 tisíc za sekundu:
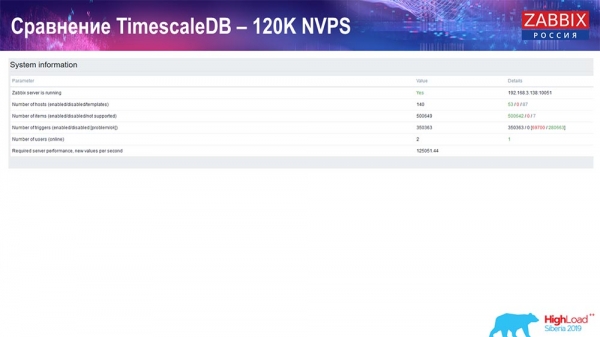
A dostal jsem takové grafy:
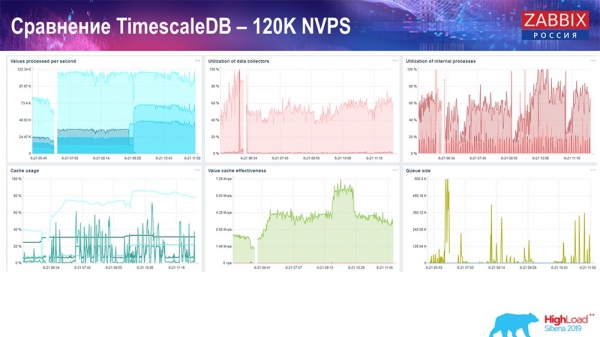
V podstatě to je funkční nastavení, může fungovat poměrně dlouhou dobu. Ale protože jsem měl disk pouze na 1,5 terabyte, využil jsem ho za pár dní. Nejdůležitější je, že současně byly vytvářeny nové partition na TimescaleDB, což pro výkon probíhalo zcela nenápadně, což se nedá říci o MySQL.
Obvykle se partition vytvářejí v noci, protože to zablokovává vkládání a práci s tabulkami, což může vést k degradaci služby. V tomto případě tomu tak není! Hlavním úkolem bylo ověřit možnosti TimescaleDB. Výsledná cifra: 120 tisíc hodnot za sekundu.
Také existují v komunitě příklady:
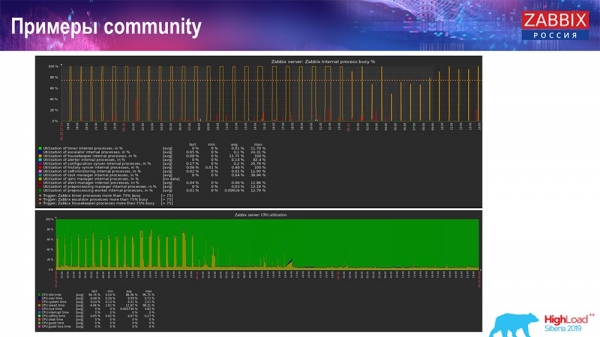
Člověk také zapnul TimescaleDB a zatížení při používání io.weight kleslo na procesoru; a použití prvků interních procesů se také snížilo díky aktivaci TimescaleDB. Přičemž to jsou běžné rotační disky, tedy běžná virtuálka na běžných discích (ne SSD)!
Pro nějaké menší nastavení, které naráží na výkon disku, se mi zdá, že TimescaleDB je velmi dobré řešení. Dobře umožní pokračovat v práci, než přejít na rychlejší hardware pro databázi.
Zveme vás na naše akce: Konference – v Moskvě, Summit – v Rize. Využívejte naše kanály – Telegram, fórum, IRC. Pokud máte nějaké otázky – přijďte k nám na stánek, můžeme si o všem promluvit.
Dotazy publika
Otázka z publika (dále – O): – Pokud je TimescaleDB tak snadný na nastavení a poskytuje takový nárůst výkonu, možná bych to měl použít jako nejlepší praxi pro nastavení Zabbixu s Postgresem? Existují nějaké skryté problémy a nevýhody tohoto řešení, nebo když jsem se rozhodl pracovat se Zabbixem, mohu bez obav vzít PostgreSQL, ihned nastavit Timescale a používat ho bez obav o nějaké problémy?
AG: – Ano, řekl bych, že to je dobré doporučení: použít PostgreSQL přímo s rozšířením TimescaleDB. Jak už jsem zmínil, máme mnoho pozitivních ohlasů, i když tato funkce je experimentální. Ale ve skutečnosti testy ukazují, že to je skvělé řešení (s TimescaleDB) a myslím, že se bude nadále rozvíjet! Sledujeme, jak se toto rozšíření vyvíjí, a budeme upravovat to, co je potřeba.
I během vývoje jsme se opírali o jednu jejich známou funkci: tam bylo možné pracovat s chunkingem trochu jinak. Ale pak to v následující verzi odstranili, a museli jsme už neodkazovat na tento kód. Doporučil bych použít toto řešení na mnoha nastaveních. Pokud používáte MySQL… pro střední nastavení jakékoli řešení funguje dobře.
A: – Na posledních grafech, které byly od komunity, byl graf s Housekeeperem:
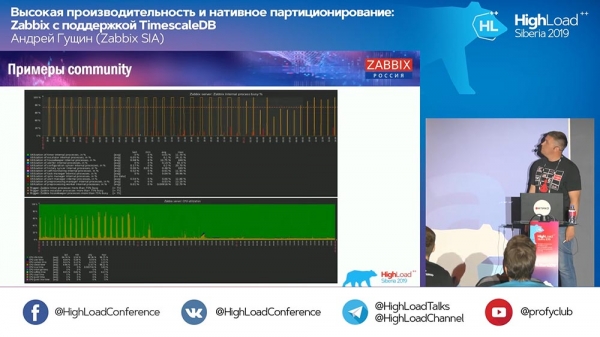
Pokračoval v práci. Co Housekeeper dělá v případě TimescaleDB?
AG: – Teď to nemohu přesně říct – podívám se na kód a poskytnu více podrobností. Používá dotazy právě TimescaleDB, ne pro odstranění chunků, ale agreguje. Zatím nejsem připraven odpovědět na tuto technickou otázku. Na stánku to dnes nebo zítra upřesníme.
A: – Mám podobnou otázku – o výkonu operace odstranění v Timescale.
O (odpověď z publika): – Když odstraňujete data z tabulky, pokud to děláte prostřednictvím příkazu delete, musíte projít tabulkou – odstranit, vyčistit, označit vše pro budoucí vakuum. V Timescale, protože máte chunkování, můžete dropovat. Jednoduše řečeno, jen říkáte souboru, který leží v big data: „Odstranit!“
TimeScale prostě chápe, že takový chunk už neexistuje. A protože se integruje do plánovače dotazu, zachytává vaše podmínky ve selectu nebo v jiných operacích a okamžitě ví, že tohoto chunku už není – "Tam už nepůjdu!" (data chybí). A to je vše! To znamená, že skenování tabulky je nahrazeno odstraněním binárního souboru, takže je to rychlé.
A: – Už jsme se dotkli tématu non-SQL. Jak rozumím, Zabbix příliš nepotřebuje modifikovat data, všechno to je spíše jako log. Lze použít specializované databáze, které nemohou měnit svá data, ale přitom mnohem rychleji ukládají, shromažďují a poskytují – například Clickhouse, něco kafkovského?.. Kafka je také log! Může se to nějak integrovat?
AG: – Export lze provést. Máme určitou "funkci" od verze 3.4: můžete zapisovat do souborů všechny historické soubory, události a další; a pak je nějakým zpracovatelem odeslat do jakékoli jiné databáze. Opravdu hodně lidí to přepracovává a píše přímo do databáze. Historické synchronizéry to všechno zapisují do souborů za běhu, rotují tyto soubory a tak dále, a to můžete posílat do Clickhouse. Nevěděl bych o plánech, ale možná bude pokračovat další podpora NoSQL řešení (jako je Clickhouse).
A: – Takže je možné úplně se zbavit PostgreSQL?
AG: – Samozřejmě, nejtěžší část v Zabbixu jsou historické tabulky, které vytvářejí nejvíce problémů, a události. V takovém případě, pokud nebudete dlouho uchovávat události a budete uchovávat historii s trendy v nějakém jiném rychlém úložišti, tak v zásadě nebudou žádné problémy, myslím, že to nebude.
A: – Můžete odhadnout, jak rychleji všechno bude fungovat, pokud přejdeme na Clickhouse, například?
AG: – Netestoval jsem. Myslím, že alespoň stejných čísel lze dosáhnout poměrně jednoduše, vzhledem k tomu, že Clickhouse má svůj rozhraní, ale nemohu říci jednoznačně. Lépe testovat. Všechno závisí na konfiguraci: kolik máte hostů a tak dále. Vložení je jedno, ale musíte také tyto data získávat – Grafana nebo něco jiného.
A: – Takže se jedná o vyrovnaný boj, a ne o velkou výhodu těchto rychlých databází?
AG: – Myslím, že když integrujeme, budou přesnější testy.
A: – Kam se podělal starý dobrý RRD? Co přimělo přejít na SQL databáze? Původně se všechny metriky shromažďovaly na RRD.
AG: – V "Zabbix" možná existoval RRD v nějaké velmi staré verzi. Vždy tu byly SQL databáze – klasický přístup. Klasický přístup zahrnuje MySQL, PostgreSQL (už existují velmi dlouho). Naše společné rozhraní pro SQL databáze a RRD jsme prakticky nikdy nepoužívali.

Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
