

Další konference HighLoad++ se uskuteční 6. a 7. dubna 2020 ve svatém Petrohradě. Podrobnosti a vstupenky . HighLoad++ Moskva 2018. Sál „Moskva“. 9. listopadu, 15:00. Abstrakta a .
* Monitoring — online a analytika.
* Hlavní omezení platformy ZABBIX.
* Řešení pro škálování analytické úložiště.
* Optimalizace serveru ZABBIX.
* Optimalizace UI.
* Zkušenosti s provozem systému při zátěžích přes 40k NVPS.
* Krátce závěry.
Mikhail Makurov (dále – MM): – Ahoj všichni!
Maxim Černěcov (dále – MЧ): – Dobrý den!
MM: – Dovolte mi představit Maxima. Max je talentovaný inženýr, nejlepší síťař, kterého znám. Maxim se zabývá sítěmi a službami, jejich rozvojem a provozem.
MЧ: – A já bych chtěl říct něco o Michaelovi. Michail je vývojář v C. Napsal několik vysoce zátěžových řešení pro zpracování provozu pro naši společnost. Žijeme a pracujeme na Uralu, ve městě tvrdých mužů Čeljabinsk, ve společnosti „Interzviaz“. Naše společnost je poskytovatel internetových a kabelových televizních služeb pro milion lidí v 16 městech.
MM: – A stojí za zmínku, že „Interzviaz“ je mnohem víc než jen poskytovatel, je to IT společnost. Většina našich řešení byla vyvinuta naším IT oddělením.
A: od serverů zpracovávajících provoz, po call centrum a mobilní aplikaci. V IT oddělení je nyní asi 80 lidí s velmi rozmanitými kompetencemi.
O Zabbix a jeho architektuře
MЧ: – A teď se pokusím stanovit osobní rekord a za jednu minutu říct, co vlastně Zabbix (dále – „Zabbix“) je.
„Zabbix“ se prezentuje jako systém monitorování „out of the box“ na úrovni podniku. Obsahuje mnoho funkcí usnadňujících život: pokročilá pravidla eskalace, API pro integraci, skupinování a automatické objevování hostitelů a metrik. V „Zabbixu“ jsou takzvané nástroje pro škálování – proxy. „Zabbix“ je systém s otevřeným zdrojovým kódem.
Krátce o architektuře. Můžeme říci, že se skládá ze tří komponentů:
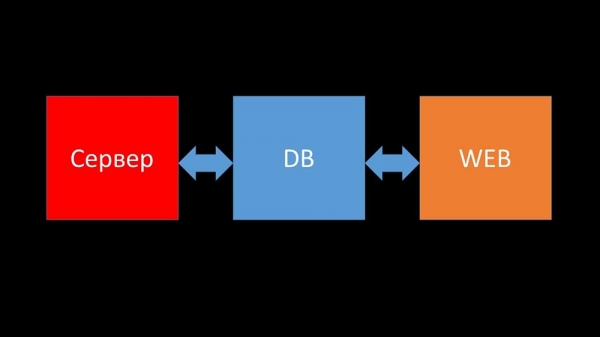
- Server. Napsán v C. S dostatečně složitým zpracováním a přenosem informací mezi vlákny. Veškeré zpracování probíhá v něm: od přijímání po ukládání do databáze.
- Všechna data jsou ukládána v databázi. „Zabbix“ podporuje MySQL, PostgreSQL a Oracle.
- Webové rozhraní je napsáno v PHP. Většina systémů bývá dodávána se serverem Apache, ale efektivněji funguje v kombinaci nginx + php.
Dnes bychom chtěli sdílet příběh z života naší společnosti, který se týká 'Zabbixu'…
Příběh ze života společnosti 'Intersvyaz'. Co máme a co potřebujeme?
Před 5 nebo 6 měsíci. Jednoho dne po práci…
MЧ: – Míšo, ahoj! Jsem rád, že jsem tě stihl – potřebuju si s tebou promluvit. Znovu máme problémy s monitorováním. Během velké havárie všechno zpomalovalo a nebyly žádné informace o stavu sítě. Bohužel se to už opakuje. Potřebuji tvoji pomoc. Udělejme to tak, aby naše monitorování fungovalo za jakýchkoliv okolností!
MM: – Ale nejdřív se synchronizujme. Nepodíval jsem se tam už pár let. Pokud si pamatuji, před 8 lety jsme přešli z Nagiosu na 'Zabbix'. A teď máme, myslím, 6 výkonných serverů a asi deset proxy. Nepletu se?
MЧ: – Téměř. 15 serverů, z toho část jsou virtuální stroje. Nejpodstatnější je, že nás to nezachrání ve chvíli, kdy to nejvíce potřebujeme. Když dojde k havárii – servery zpomalují a nic nevidíme. Zkoušeli jsme optimalizovat konfiguraci, ale to nepřináší optimální nárůst výkonu.
MM: – Rozumím. Dali jsme se na něco podívat, něco už bylo diagnostikováno?
MЧ: – První problém, se kterým se musíme vypořádat, je právě DB. MySQL je už tak neustále zatíženo ukládáním nových metrik, a když 'Zabbix' začne generovat hromadu událostí – databáze se úplně zablokuje na několik hodin. O optimalizaci konfigurace jsem ti už říkal, ale letos jsme právě modernizovali hardware: na serverech je víc než sto gigabajtů paměti a diskové pole na SSD RAID – nemá smysl ho dál lineárně zvyšovat. Co budeme dělat?
MM: – Rozumím. Vlastně, MySQL je LTP databáze. Zjevně už není vhodná pro ukládání archivu metrik naší velikosti. Pojďme to vyřešit.
MЧ: – Pojďme!
Integrace Zabbixu a Clickhouse jako výsledek hackathonu
Po nějaké době jsme získali zajímavá data:
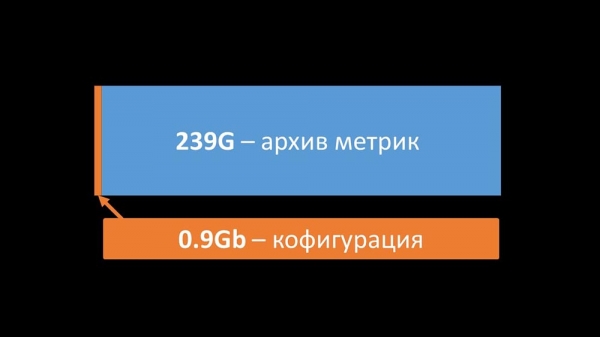
Velká část místa v naší databázi byla obsazena archivem metrik a méně než 1 % bylo využito pro konfiguraci, šablony a nastavení. Do té doby jsme už více než rok provozovali řešení Big Data založené na Clickhouse. Směr, kterým se vydat, byl pro nás jasný. Na naší jarní "Hackathoně" jsem napsal integraci "Zabbixu" s "Clickhousem" pro server a frontend. V té době měl "Zabbix" už podporu pro ElasticSearch, takže jsme se rozhodli je porovnat.
Porovnání Clickhouse a Elasticsearch
MM: – Pro porovnání jsme generovali zátěž stejnou, jakou zajišťuje server "Zabbix", a sledovali, jak se systémy chovají. Zaznamenávali jsme data po dávkách po 1000 řádcích, použili jsme CURL. Předpokládali jsme, že "Clickhouse" bude efektivnější pro profil zátěže, který vytváří "Zabbix". Výsledky dokonce překonaly naše očekávání:
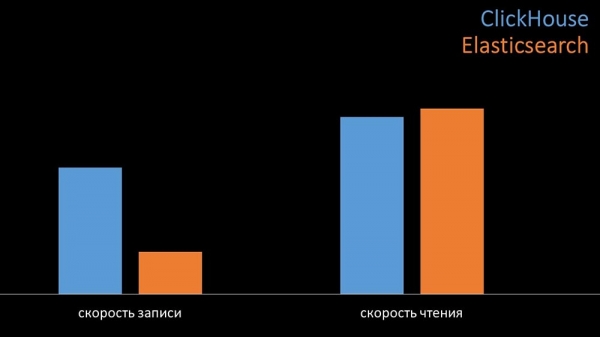
Za stejných podmínek v testech "Clickhouse" zapsal třikrát více dat. Oba systémy však velmi efektivně využívaly (malé množství zdrojů) při čtení dat. Ale "ElasticSearch" vyžadoval při zápisu velké množství procesorového výkonu:
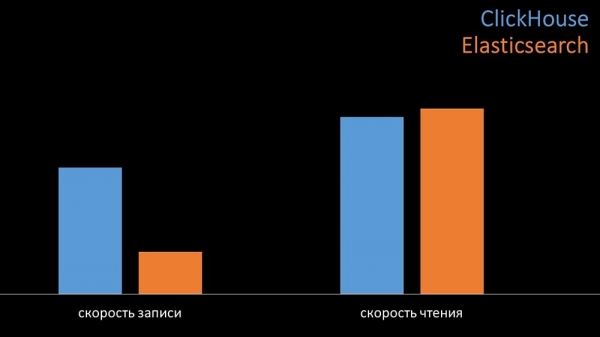
Celkově "Clickhouse" výrazně převyšil "ElasticSearch" v použití procesoru a rychlosti. Díky kompresi dat používá "Clickhouse" 11x méně na pevném disku a provádí přibližně 30x méně diskových operací:
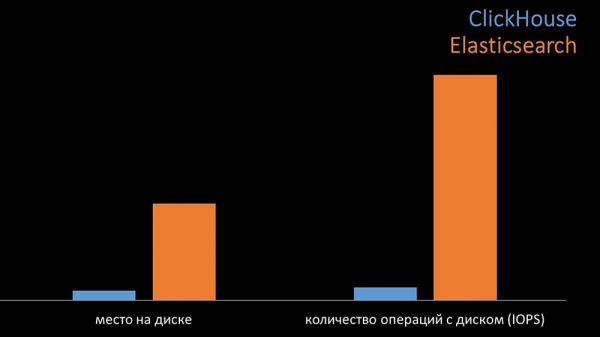
MЧ: – Ano, práce s diskovým subsystémem v "Clickhouse" je realizována velmi efektivně. Pro databáze lze používat obrovské SATA disky a dosahovat rychlosti zápisu stovek tisíc řádků za sekundu. Systém "out of the box" podporuje shardování, replikaci a je velmi snadno konfigurovatelný. Jsme více než spokojeni s jeho provozem po dobu jednoho roku.
Pro optimalizaci zdrojů lze nainstalovat "Clickhouse" vedle existující primární databáze a tím ušetřit spoustu procesorového času a diskových operací. Archiv metrik jsme přesunuli na již existující "Clickhouse" klastry:
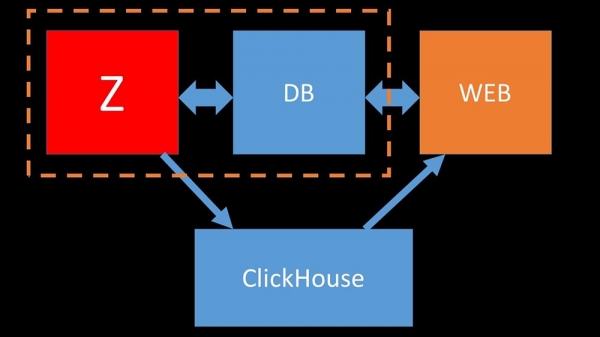
Tak jsme tak významně odlehčili hlavní MySQL databázi, že jsme ji mohli sloučit na jednom stroji se serverem "Zabbix" a vzdát se dedikovaného serveru pro MySQL.
Jak funguje polling v Zabbixu?
před 4 měsíci
MM: – No, můžeme zapomenout na problémy s databází?
MЧ: – To je pravda! Další úkol, který musíme vyřešit, je pomalý sběr dat. Nyní jsou všechny naše 15 proxy servery přeplněny procesy SNMP a pollingem. A není žádné jiné řešení, než pořizovat nové a nové servery.
MM: – Skvělé. Ale nejdříve mi řekni, jak je nastaven polling v „Zabbixu“?
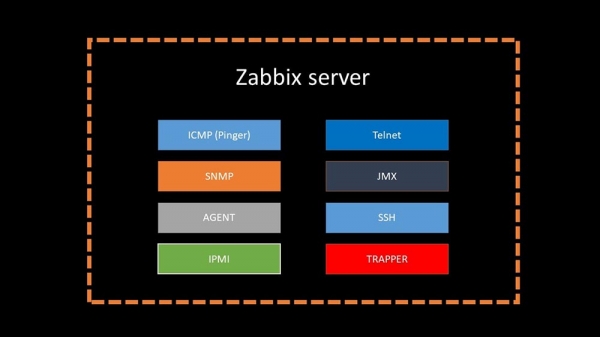
MЧ: – Pokud to shrnu, existuje 20 typů metrik a několik způsobů jejich získání. „Zabbix“ může sbírat data buď v režimu „dotaz – odpověď“, nebo čekat na nové údaje přes „Trapper Interface“.
Je třeba poznamenat, že v originálním „Zabbixu“ je tento způsob (Trapper) nejrychlejší.
Existují proxy servery pro rozložení zátěže:
Proxy mohou vykonávat stejné funkce sběru jako „Zabbix“ server, přičemž dostávají úkoly od něj a odesílají shromážděné metriky právě přes Trapper rozhraní. Toto je oficiálně doporučený způsob rozložení zátěže. Také jsou proxy užitečné pro monitorování vzdálené infrastruktury, která funguje přes NAT nebo pomalý kanál:
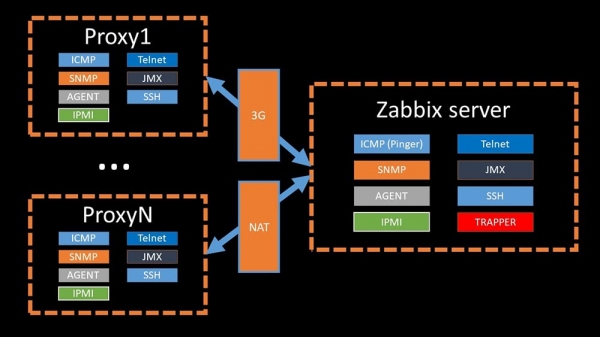
MM: – S architekturou je vše jasné. Musíme se podívat na zdrojové kódy...
O pár dní později
Pohádka o tom, jak nmap fping zvítězil
MM: – Vypadá to, že jsem něco našel.
MЧ: – Vyprávěj!
MM: – Zjistil jsem, že při kontrolách dostupnosti „Zabbix“ provádí kontrolu maximálně 128 hostitelů současně. Zkusil jsem tuto hodnotu zvýšit na 500 a odstranil mezipaketovou prodlevu v jejich pingu – to zvýšilo výkon dvakrát. Ale chtěl bych ještě vyšší čísla.
MЧ: – Ve své praxi občas musím kontrolovat dostupnost tisíců hostitelů, a nic rychlejšího než nmap jsem pro to nenašel. Jsem si jistý, že toto je nejrychlejší způsob. Zkusme to! Musíme výrazně zvýšit počet hostitelů v jedné iteraci.
MM: – Kontrolovat více než pět set? 600?
MЧ: – Minimálně pár tisíc.
MM: – OK. To nejdůležitější, co jsem chtěl říct: zjistil jsem, že většina pollingu v „Zabbixu“ je provedena synchronně. Určitě bychom měli přejít na asynchronní režim. Pak budeme moci radikálně zvýšit počet metrik, které jsou shromažďovány pollery, zejména pokud zvýšíme počet metrik v jedné iteraci.
MЧ: – Skvěle! A kdy?
MM: – Jak obvykle, včera.
MЧ: – Porovnali jsme obě verze fping a nmap:
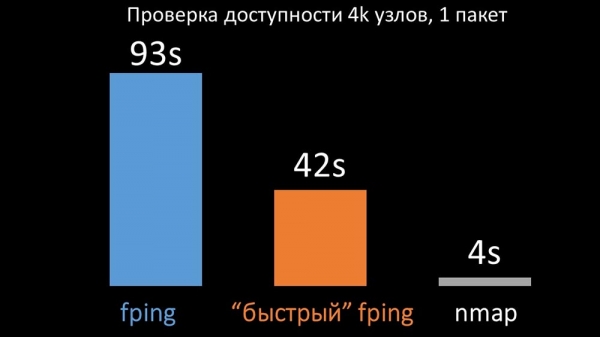
Na velkém množství hostitelů byl nmap očekávaně až pětkrát efektivnější. Protože nmap kontroluje pouze dostupnost a dobu odezvy, jsme přenesli počítání ztrát do spouštěčů a výrazně zkrátili intervaly kontroly dostupnosti. Optimální počet hostitelů pro nmap jsme našli kolem 4 tisíc na jednu iteraci. Nmap nám umožnil třikrát snížit náklady na CPU při kontrole dostupnosti a zkrátit interval z 120 sekund na 10.
Optimalizace pollingu
MM: – Poté jsme se zabývali pollery. Hlavně nás zajímal snímek SNMP a agenty. V 'Zabbixu' je polling prováděn synchronně a byla přijata speciální opatření pro zvyšování efektivity systému. V synchronním režimu nedostupnost hostitelů způsobuje výraznou degradaci pollingu. Existuje celá řada stavů, jsou zde speciální procesy – takzvaní unreachable-pollery, kteří pracují pouze s nedostupnými hostiteli:

To je komentář, který ukazuje matici stavů a celou složitost systémů přechodů, které jsou požadovány pro udržení efektivity systému. Kromě toho je samotný synchronní polling poměrně pomalý:
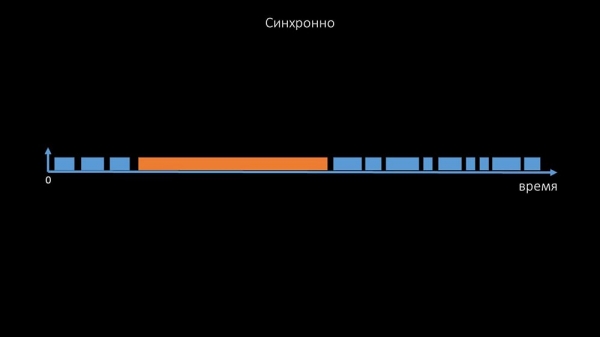
Právě proto tisíce vláken pollerů na desítce proxy nemohly shromáždit potřebné množství dat. Asynchronní implementace vyřešila nejen problémy s počtem vláken, ale také významně zjednodušila systém stavů nedostupných hostitelů, protože při jakémkoliv počtu kontrolovaných v jedné iteraci pollingu maximální čekací doba činila 1 timeout:
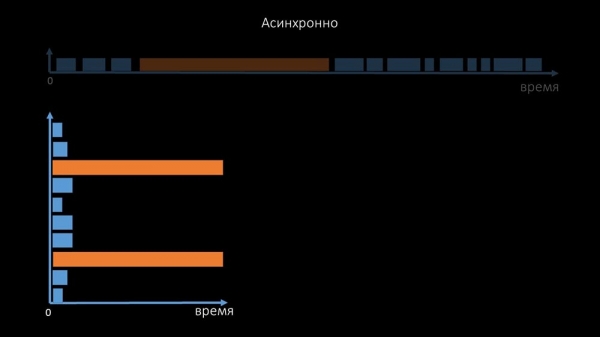
Dodatečně jsme upravili a vylepšili systém pollingu pro SNMP dotazy. Věc se má tak, že většina nemůže odpovídat na několik SNMP dotazů současně. Proto jsme vytvořili hybridní režim, kdy SNMP polling stejného hostitele probíhá asynchronně:
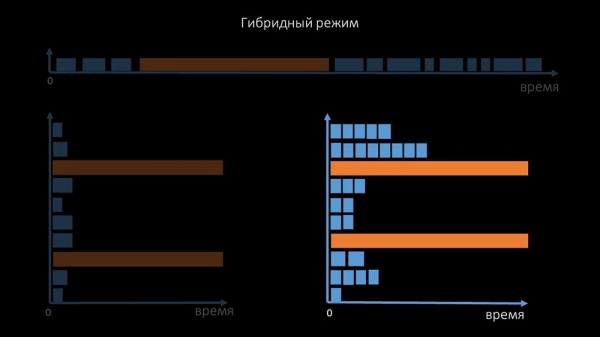
To se dělá pro celou sadu hostitelů. Tento režim nakonec není pomalejší než zcela asynchronní, protože dotazování na 150 SNMP hodnot je stále mnohem rychlejší než 1 timeout.
Naše experimenty ukázaly, že optimální počet dotazů v jedné iteraci je přibližně 8 tisíc při SNMP pollingu. Celkově přechod na asynchronní režim umožnil urychlit výkon pollingu 200krát, v několika stovkách případů.
MЧ: Optimalizace polling ukázaly, že ne pouze, že se dokážeme zbavit všech proxy, ale také zkrátit intervaly pro mnoho kontrol, a proxy už nebudou potřebné jako způsob rozdělení zátěže.
Před asi třemi měsíci
Změňte architekturu – zvyšte zátěž!
MM: – Tak co, Maxe, je čas na produkt? Potřebuji výkonný server a dobrého inženýra.
MЧ: – Dobře, naplánujeme to. Už bylo na čase se pohnout z mrtvého bodu s 5 tisíci metrikami za sekundu.
Ráno po upgradu
MЧ: – Míšo, my jsme se aktualizovali, ale ráno jsme se vrátili zpět… Uhodni, jaké rychlosti se nám podařilo dosáhnout?
MM: – Maximálně 20 tisíc.
MЧ: – Aha, 25! Bohužel jsme tam, kde jsme začali.
MM: – Proč to tak je? Udělali jste nějakou diagnostiku?
MЧ: – Ano, samozřejmě! Tady je zajímavé top:
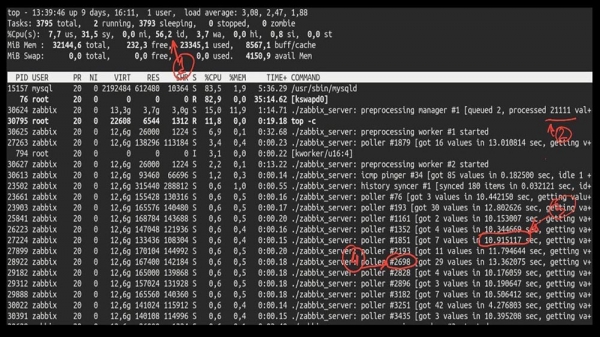
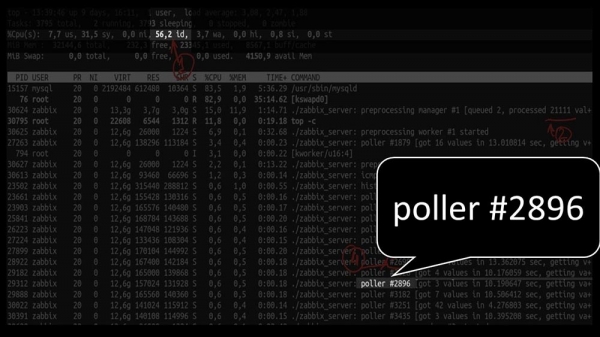
MM: – Podívejme se. Vidím, že jsme zkoušeli obrovské množství pollingových vláken:
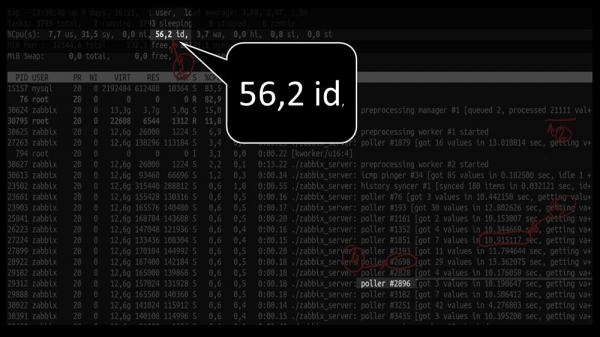
Ale přitom jsme nebyli schopni využít systém ani z poloviny:
A celkový výkon je dost malý, asi 4 tisíce metrik za sekundu:
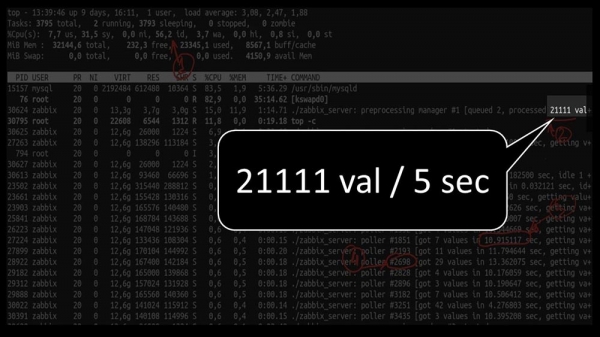
Je tu něco ještě?
MЧ: – Ano, strace jednoho z pollerů:
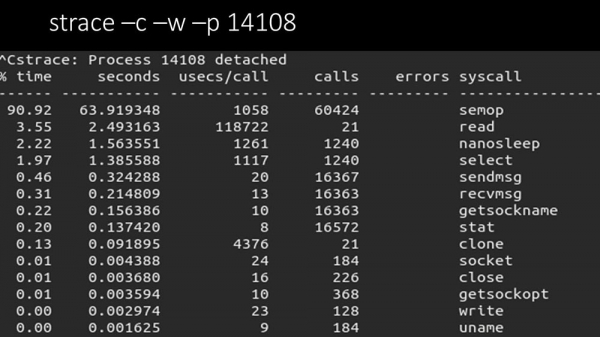
MM: – Tady je jasně vidět, že pollingový proces čeká na 'semafory'. To jsou blokace:
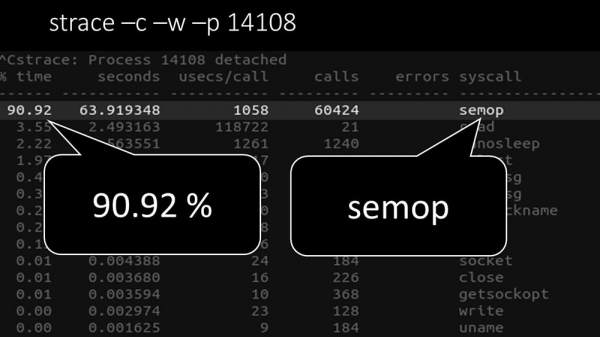
MЧ: – Nerozumím.
MM: – Podívej, to vypadá jako situace, kdy se spousta vláken snaží pracovat se zdrojem, se kterým může pracovat jen jeden najednou. Potom vše, co mohou udělat – je rozdělit tento zdroj po čase:
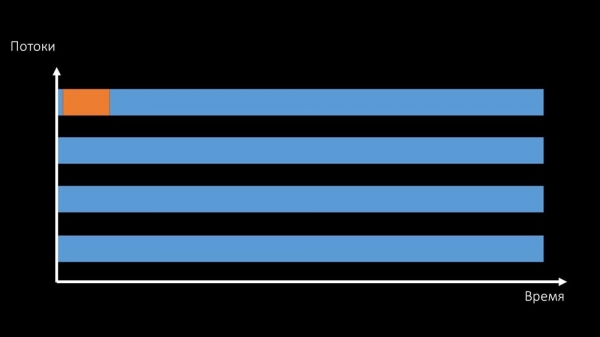
A celkový výkon práce s takovým zdrojem je omezen rychlostí jednoho jádra:
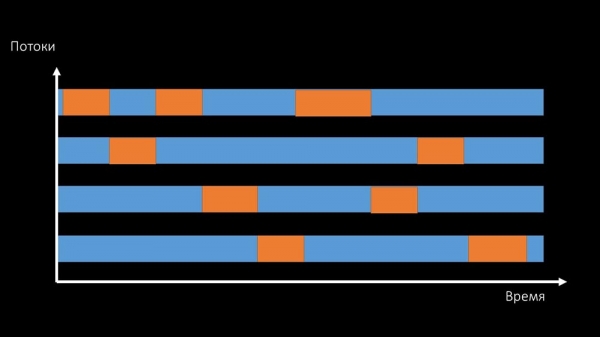
Tuto chybu lze vyřešit dvěma způsoby.
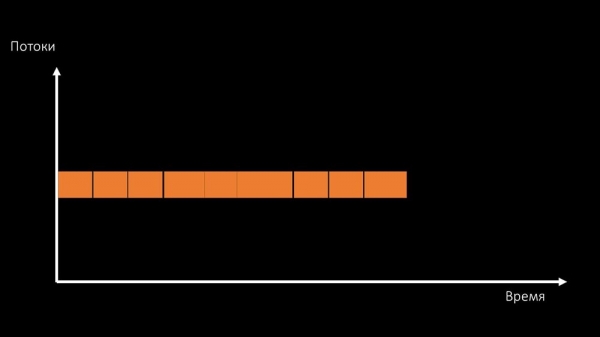
Upgrade hardwaru stroje, přejít na rychlejší jádra:
Nebo změnit architekturu a zároveň – zátěž:
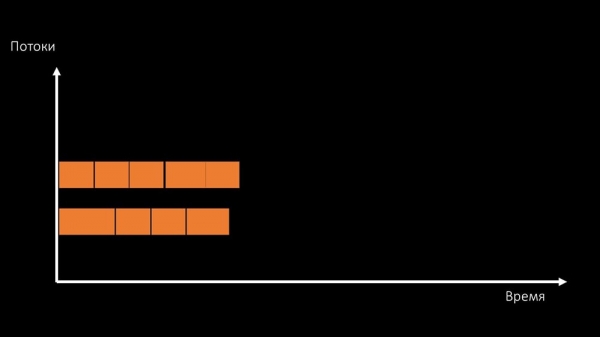
MЧ: – Mimochodem, na testovacím stroji použijeme menší počet jader než na produkčním, ale jsou zhruba 1,5krát rychlejší co do frekvence na jádro!
MM: – Rozumíš? Musíme se podívat na kód serveru.
Cesta dat v serveru Zabbix
MЧ: – Abychom se dostali k jádru, začali jsme analyzovat, jak se data předávají uvnitř serveru 'Zabbix':
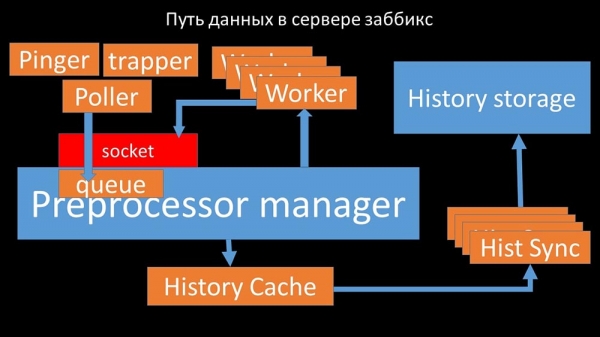
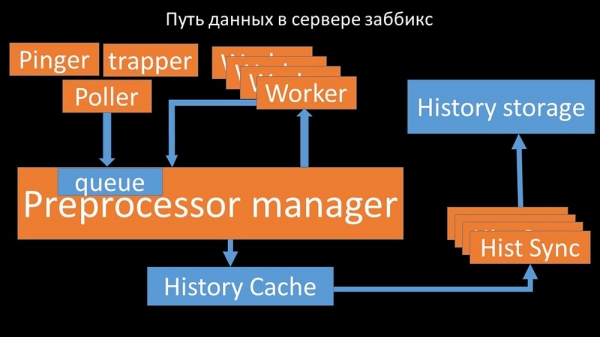
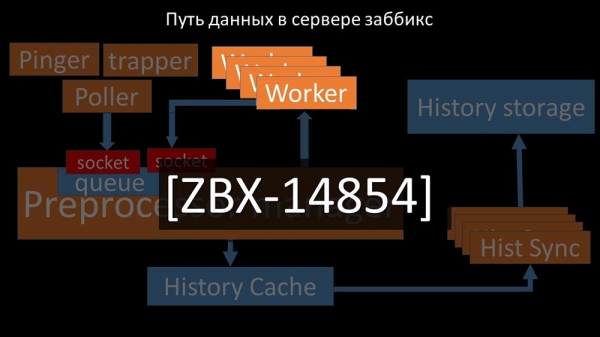
Skvělý obrázek, co říkáte? Pojďme se po něm projít krok za krokem, abychom si to vcelku vyjasnili. Jsou tu vlákna a služby zodpovědné za sběr dat:
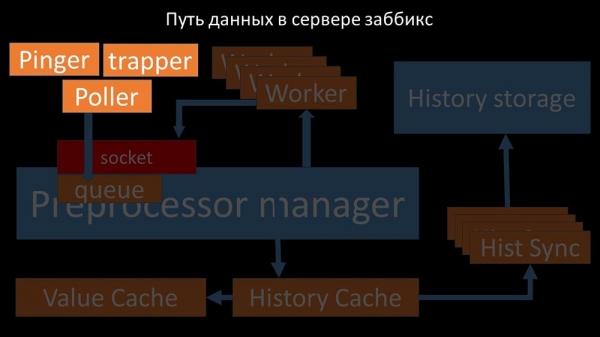
Sesbírané metriky předávají skrze socket do Preprocessor managera, kde se ukládají do fronty:
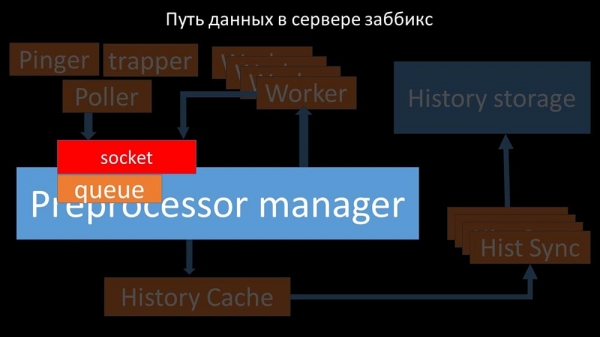
Preprocessor manager předává data svým pracovníkům, kteří realizují instrukce předzpracování a vrací je zpět stejným socketem:
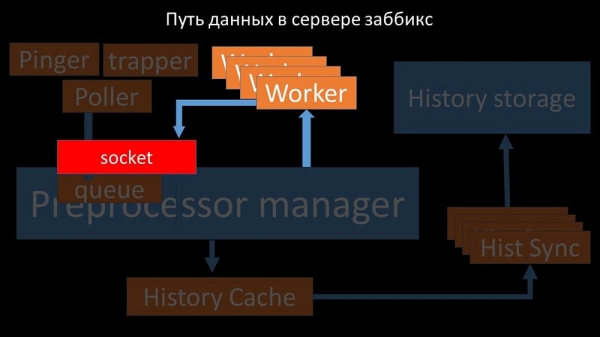
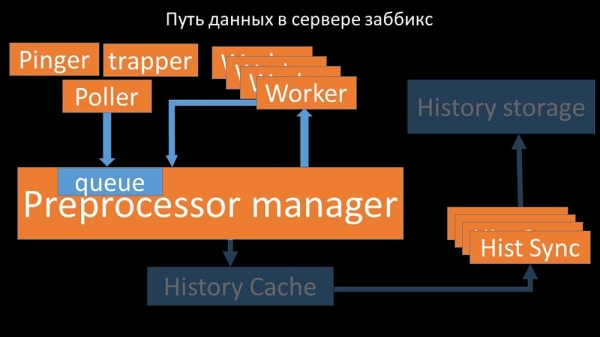
Po tomto předešle zpracování manažer uchovává je v historii mezipaměti:
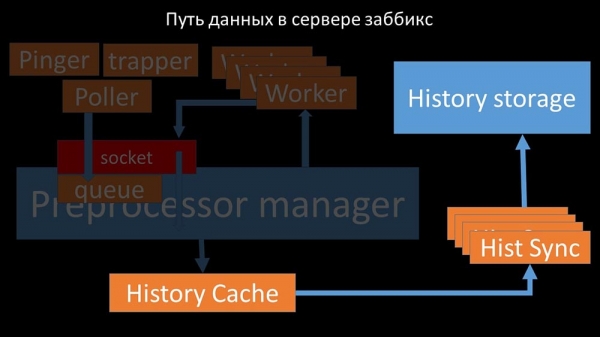
Odtud je odebírají synchronizátory historie, které vykonávají poměrně mnoho funkcí: například výpočty spouštěčů, naplňování mezipaměti hodnot a, co je nejdůležitější, ukládání metrik do úložiště historie. Celkově je proces složitý a velmi zmatený.
MM: – První, co jsme viděli, bylo, že většina vláken soutěží o tzv. „konfigurační mezipaměť“ (oblast paměti, kde jsou uloženy všechny konfigurace serveru). Zejména velký počet blokací vytvářejí vlákna zodpovědná za získávání dat:
…protože v konfiguraci jsou uloženy nejen metriky s jejich parametry, ale i fronty, z nichž pollery získávají informace o tom, co mají dělat dál. Když je mnoho pollerů a jedno blokuje konfiguraci, ostatní čekají na požadavky:
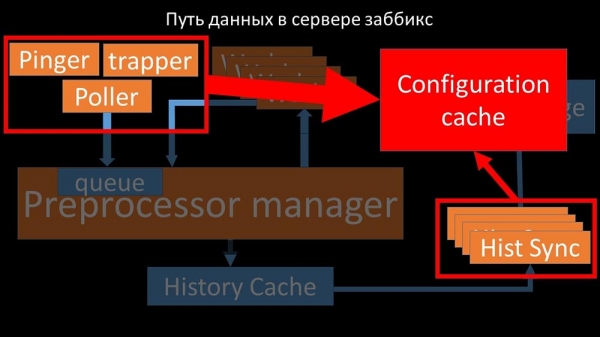
Pollery by neměly konfliktovat
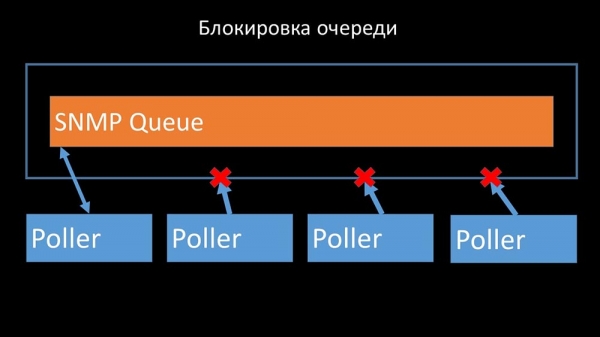
Proto jsme jako první rozděli frontu na 4 části a povolili pollerům v bezpečných podmínkách blokovat tyto fronty, tyto části současně:
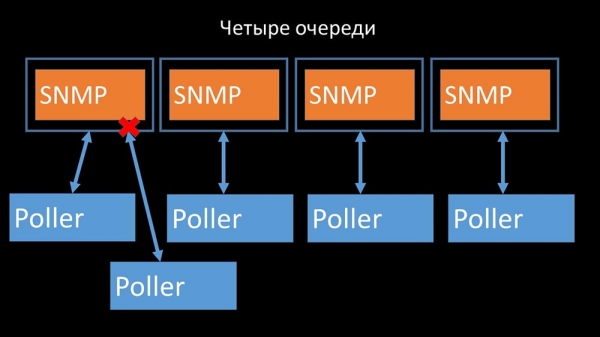
To odstranilo soutěž o konfigurační mezipaměť a rychlost práce pollerů se výrazně zvýšila. Ale pak jsme čelili tomu, že manažer předzpracování začal hromadit frontu úkolů:
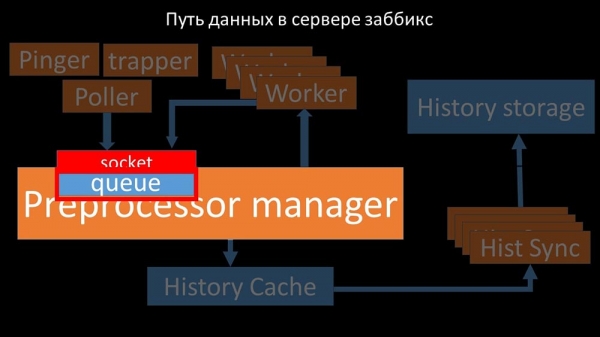
Manažer předzpracování by měl umět stanovit priority
To se dělo v případech, kdy mu chyběla výkonnost. Tehdy jediné, co mohl, bylo hromadit požadavky od procesů sběru dat a ukládat je do vyrovnávací paměti, dokud mu nezaplnily veškerou paměť a nespadl:
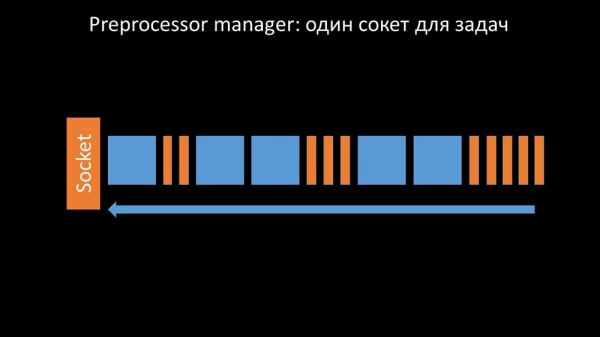
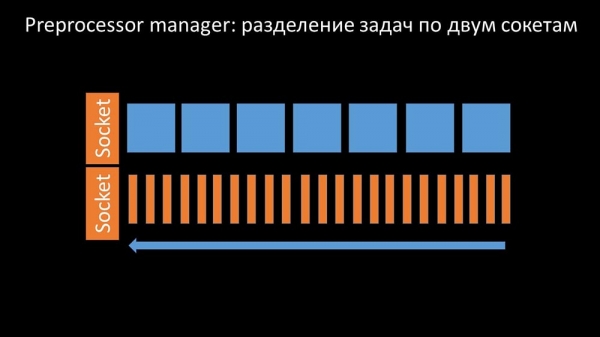
Abychom tento problém vyřešili, přidali jsme druhý socket, který byl vyhrazen speciálně pro pracovníky:
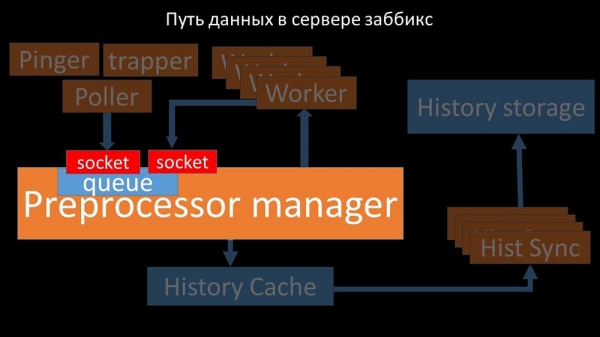
Tímto způsobem získal manažer předzpracování možnost priorizovat svou práci a v případě zvětšování vyrovnávací paměti zastavit získávání, což dává pracovníkům možnost tuto vyrovnávací paměť vyzvednout:
Poté jsme zjistili, že jednou z příčin zpomalení byli samotní pracovníci, protože soutěžili o naprosto nedůležitý zdroj pro svou práci. Tento problém jsme vyřešili opravou chyb a v nových verzích „Zabbixu“ je již vyřešen:
Zvětšujeme počet socketů - máme výsledek
Další sám manažer předzpracování se stal úzkým místem, protože to je jedno vlákno. Narazil na rychlost jádra, což dává maximální rychlost přibližně 70 tisíc metrik za sekundu:
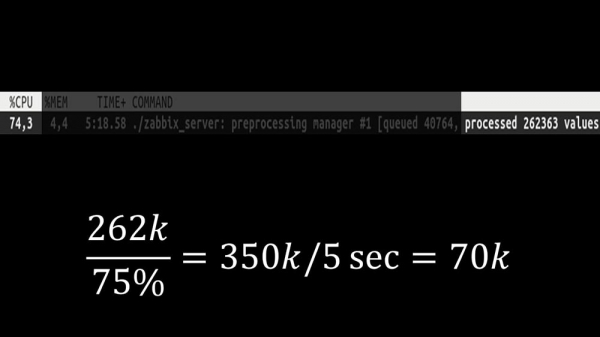
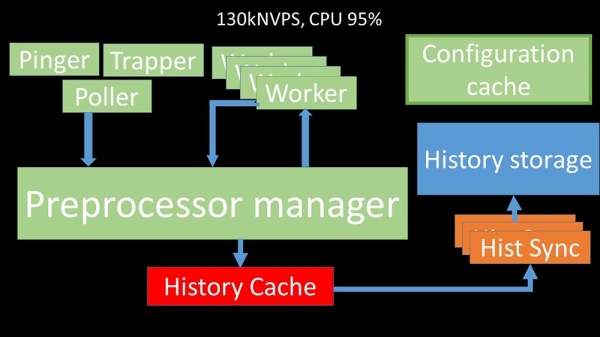
Proto jsme vytvořili čtyři, se čtyřmi sadami soketů, pracovníků:
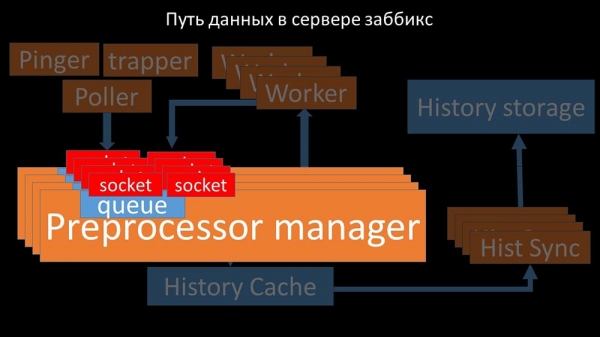
A to umožnilo zvýšit rychlost na přibližně 130 tisíc metrik:
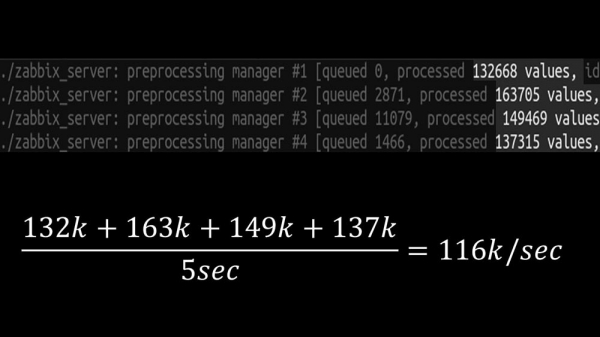
Nelineární růst je vysvětlen tím, že se objevila konkurence o cache historie. O tu soutěžilo 4 preprocesorové manažery a history-synkronizátory. V té době jsme na testovacím stroji získali přibližně 130 tisíc metrik za sekundu, využívajíc procesor přibližně na 95 %:
Před asi 2,5 měsíci
Zrušení snmp-community zvýšilo NVPs na 1,5 násobek
MM: – Maxe, potřebuji nový testovací stroj! Do současného se už nevejdeme.
MЧ: – A co teď máme?
MM: – Teď máme 130k NVPs a procesor "v klidu".
MЧ: – Páni! Super! Počkej, mám dvě otázky. Podle mého výpočtu je naše potřeba okolo 15-20 tisíc metrik za sekundu. Proč potřebujeme víc?
MM: – Chci to dotáhnout do konce. Chci zjistit, kolik toho můžeme ze systému vytáhnout.
MЧ: – Ale…
MM: – Ale pro byznys je to k ničemu.
MЧ: – Rozumím. A druhá otázka: to, co máme teď, budeme schopni udržovat sami, bez pomoci vývojáře?
MM: – Nemyslím si. Změna práce s konfiguračním cachem je problém. Týká se změn v většině toků a je dost složitá na údržbu. Pravděpodobně to bude velmi těžké udržovat.
MЧ: – Pak potřebujeme nějakou alternativu.
MM: – Existuje taková možnost. Můžeme přejít na rychlá jádra, přičemž se vzdáme nové systému zámku. Přesto získáme výkon 60-80 tisíc metrik. A zároveň si můžeme ponechat celý ostatní kód. "Clickhouse" a asynchronní polling budou fungovat. A to bude snadné udržovat.
MЧ: – Skvělé! Navrhuji se na tom zastavit.
Po optimalizaci serverové části jsme konečně byli schopni spustit nový kód v produkci. Vzdali jsme se části změn ve prospěch přechodu na stroj s rychlými jádry a minimalizace počtu změn v kódu. Také jsme zjednodušili konfiguraci a pokud to bylo možné, vzdali jsme se makr v datových prvcích, protože jsou zdrojem dodatečných zámků.
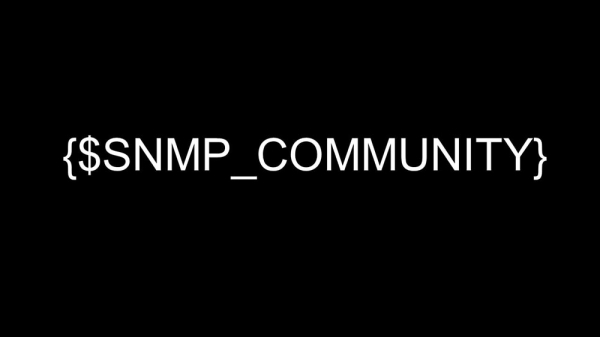
Například zrušení často se vyskytujícího v dokumentaci a příkladech makra snmp-community v našem případě umožnilo navíc urychlit NVPs přibližně 1,5 násobně.
Po dvou dnech v produkci
Odstraňujeme vyskakovací okna historie incidentů
MЧ: – Míšo, už dva dny používáme systém a všechno funguje. Ale jen když všechno funguje! Měli jsme plánované práce s přenosem docela velkého segmentu sítě a znovu jsme ručně kontrolovali, co se zvedlo, co – ne.
MM: – To není možné! Kontrolovali jsme to 10krát. Server reaguje na úplnou nedostupnost sítě okamžitě.
MЧ: – Všechno chápu: server, databáze, top, austat, logy – všechno rychle… Ale my se díváme na webové rozhraní a tam – procesor „v klidu“ na serveru a tohle:
MM: – Jasně. Pojďme se podívat na web. Zjistili jsme, že v situaci, kdy bylo velké množství aktivních incidentů, většina operačních widgetů začala fungovat velmi pomalu:
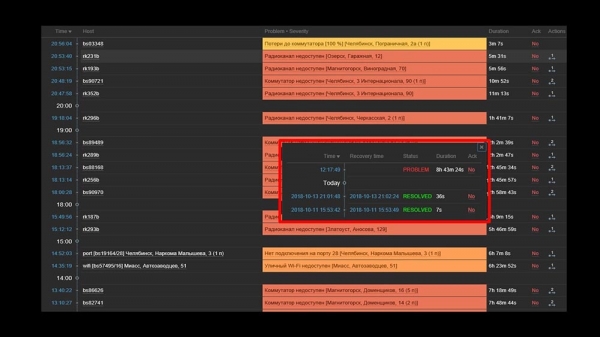
Příčinou byla generace vyskakovacích oken s historií incidentů, která se generují pro každý prvek v seznamu. Proto jsme se vzdali generace těchto oken (zakomentovali jsme 5 řádků v kódu) a to vyřešilo naše problémy.
Čas načítání widgetů i při úplné nedostupnosti se zkrátil z několika minut na pro nás přijatelných 10-15 sekund, a historii stále lze sledovat kliknutím na čas:
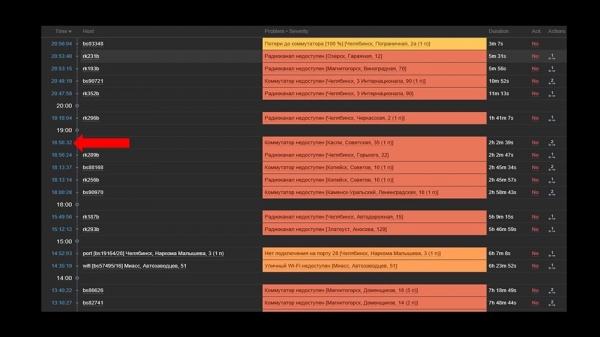
Po práci. Před 2 měsíci
MЧ: – Míšo, odcházíš? Mám něco na srdci.
MM: – Neplánoval jsem. Zase něco s „Zabbixem“?
MЧ: – Ne, klid! Jen jsem chtěl říct: všechno funguje, díky! Dám ti pivo.
Zabbix je efektivní
„Zabbix“ je dost univerzální a bohatý systém a funkce. Může být bez problémů používán pro malé instalace „z krabice“, ale s rostoucími potřebami je třeba ho optimalizovat. Pro uchovávání velkého archivu metrik použijte vhodné úložiště:
- můžete využít integrované prostředky v podobě integrace s „ElasticSearch“ nebo exportu historie do textových souborů (dostupné od čtvrté verze);
- můžete využít naše zkušenosti a integraci s „ClickHouse“.
Pro zásadní zvýšení rychlosti sběru metrik sbírejte je asynchronními metodami a přenášejte je přes trapper interface na „Zabbix“ server; nebo můžete využít patch pro asynchronní políry samotného „Zabbixu“.
Zabbix je napsán v C a je dostatečně efektivní. Řešení několika úzkých architektonických míst umožňuje dodatečně zvýšit jeho výkon a podle našich zkušeností získávat více než 100 tisíc metrik na jednovrstvé mašině.
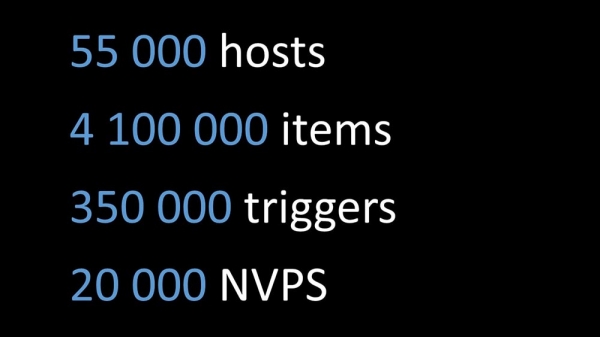
Ten prapůvodní patch Zabbix
MM: - Chci přidat pár bodů. Celá současná zpráva, všechny testy, čísla jsou uvedena pro tu konfiguraci, která je u nás používána. Z ní aktuálně sbíráme přibližně 20 tisíc metrik za sekundu. Pokud se snažíte pochopit, zda to bude fungovat u vás – můžete srovnat. To, co bylo dnes řečeno, je zveřejněno na GitHubu jako patch:
Patch zahrnuje:
- úplnou integraci s ClickHouse (jak serverem Zabbix, tak frontendem);
- řešení problémů s preprocesorovým správcem;
- asynchronní polling.
Patch je kompatibilní se všechny verze 4, včetně lts. Pravděpodobně s minimálními změnami bude fungovat na verzi 3.4.
Děkuji za pozornost.
Otázky
Otázka z publika (dále A): - Dobrý den! Můžete mi prosím říci, máte plány na intenzivní spolupráci s týmem Zabbix nebo oni s vámi, aby to nebyl patch, ale normální chování Zabbix?
MM: - Ano, část změn určitě commitneme. Něco bude, ale něco zůstane v patchi.
A: - Děkuji moc za skvělou prezentaci! Můžete mi prosím říci, po aplikaci patchu, zůstane podpora od Zabbix a jak se dál aktualizovat na vyšší verze? Bude možnost aktualizovat Zabbix po vašem patchi na 4.2, 5.0?
MM: - O podpoře nemohu říci. Kdybych byl technickou podporou Zabbix, asi bych řekl ne, protože to je cizí kód. Co se týče kódové základny 4.2, naše pozice je následující: 'Půjdeme s dobou a sami se budeme aktualizovat na další verzi'. Takže nějakou dobu budeme vydávat patch pro aktualizované verze. Už jsem zmínil ve zprávě: počet změn s verzemi je zatím poměrně malý. Myslím, že přechod z 3.4 na 4 nám zabral asi 15 minut. Něco se změnilo, ale není to tak důležité.
A: - Takže plánujete udržovat svůj patch a jeho nasazení na produkční prostředí je bezpečné, i s možností budoucích aktualizací?
MM: - To rozhodně doporučujeme. Řeší to pro nás spoustu problémů.
MЧ: – Ještě jednou bych rád zdůraznil, že změny, které se netýkají architektury a neřeší blokace a fronty, jsou modulární, nacházejí se v oddělených modulech. I při drobných změnách je lze poměrně snadno udržovat.
MM: – Pokud vás zajímají podrobnosti, pak "ClickHouse" používá tzv. knihovnu historie. Je to oddělená část – je to kopie podpory "Elastix", to znamená, že se dá konfigurovat. Polling mění pouze pollery. Věříme, že to bude fungovat dlouho.
A: – Děkuji mnohokrát. A můžete mi říct, zda existuje nějaká dokumentace ke provedeným změnám?
MM: – Dokumentace je patch. Očividně, s zavedením "ClickHouse" a nových typů pollerů se objevují nové konfigurační možnosti. Na odkaze z posledního slidu je krátký popis, jak to používat.
O nahrazení fping nástrojem nmap
A: – Jak jste to nakonec realizovali? Můžete uvést konkrétní příklady: máte stupně a externí skript? Co nakonec tak rychle kontroluje ohromné množství hostitelů? Jak tyto hostitele získáváte? Musíte nmapu nějak dostat data, získat je odkudsi, uložit, spustit něco?
MM: – Skvělé. Velmi správná otázka! Podstata je taková. Modifikovali jsme knihovnu (ICMP ping, součást "Zabbixu") pro ICMP kontroly, kde je stanoveno množství paketů – jednotka (1), a kód se snaží používat nmap. To znamená, že to je interní práce "Zabbixu", stalo se to interní prací pingeru. Tím pádem není potřeba žádná synchronizace nebo využívání tráppera. Bylo to provedeno záměrně, aby zůstala systém kompletní a nebylo potřeba se věnovat synchronizaci dvou databází: co kontrolovat, jak to vložit přes poller, a jestli nám nepadla funkčnost... To je mnohem jednodušší.
A: – Funguje to i pro proxy?
MM: – Ano, ale nezkoušeli jsme to. Kód pollingu je jak v "Zabbixu", tak na serveru jednotný. Mělo by to fungovat. Ještě jednou zdůrazňuji: výkon systému je takový, že proxy nepotřebujeme.
MЧ: – Správná odpověď na otázku je: "Proč potřebujete proxy při takovém systému?" Jen kvůli NATu nebo pro sledování přes nějaký pomalý kanál...
A: – Používáte "Zabbix" jako alergator, pokud jsem to správně pochopil. Nebo jste grafy (kde je archivační vrstva) přesunuli do jiného systému, jako je Grafana? Nebo tento funkční prvek nepoužíváte?
MM: – Ještě jednou zdůrazním: provedli jsme kompletní integraci. Přenášíme historii do 'Clickhouse', ale zároveň jsme změnili php frontend. Php frontend načítá data z 'Clickhouse' a všechny grafy jsou generovány odtud. Přitom, abych byl upřímný, máme část, která vytváří z 'Clickhouse' na základě stejných dat 'Zabbixu' data do jiných systémů grafického zobrazení.
MЧ: – V 'Grafaně', mimo jiné.
Jak bylo přijato rozhodnutí o přidělení zdrojů?
A: – Podělte se trochu o vnitřní fungování. Jak bylo přijato rozhodnutí, že je potřeba přidělit zdroje na vážné přepracování produktu? To přináší určité rizika. A prosím, řekněte nám, v kontextu toho, že plánujete podporovat nové verze: jak se toto rozhodnutí ospravedlňuje z pohledu řízení?
MM: – Zdá se, že jsme příběh nevyprávěli moc dobře. Ocitli jsme se v situaci, kdy bylo potřeba něco udělat, a šli jsme vlastně po dvojí paralelní linii:
- Jedna se zabývala spuštěním monitorovacího systému s novými metodami: monitorování jako služba, standardní sada open-source řešení, která kombinujeme a následně se snažíme změnit obchodní proces, abychom mohli pracovat s novým monitorovacím systémem.
- Současně jsme měli nadšeného programátora, který se tím zabýval (o sobě). Stalo se, že zvítězil.
A: – Jaká je velikost týmu?
MЧ: – Ten je před vámi.
A: – To znamená, že jako vždy potřebujeme vášnivého člověka?
MM: – Nevím, co to znamená, vášnivý člověk.
A: – V tomto případě, zdá se, vy. Děkuji moc, jste skvělí.
MM: – Děkuji.
O pacích pro Zabbix
A: – Pro systém, který používá proxy (například v nějakých distribuovaných systémech), je možné vaše řešení přizpůsobit a patchnout, řekněme pollery, proxy a částečně preprocesor samotného 'Zabbixu'; a jejich interakci? Je možné existující výstupy optimalizovat pro systém s několika proxy?
MM: – Vím, že 'Zabbix' server se konstruuje pomocí proxy (kompilací a vzniká kód). To jsme neověřovali v produkci. Nejsem si tím jistý, ale myslím, že preprocesor manažer se v proxy nepoužívá. Úkolem proxy je vzít sadu metrik z 'Zabbixu', stáhnout je (také zaznamenává konfiguraci, místní databázi) a vrátit zpět 'Zabbix' serveru. Preprocessing již provede samotný server, až je obdrží.
Zájem o proxy je jasný. Otestujeme to. Je to zajímavé téma.
A: – Myšlenka byla taková: pokud je možné patchovat pollery, mohou být patchovány na proxy a upravit interakci se serverem, a preprocesor pro tyto účely adaptovat pouze na serveru.
MM: – Myslím, že je to dokonce jednodušší. Vezmete kód, aplikujete patch, pak ho konfiguruješ tak, jak potřebujete – sestavíte proxy servery (například s ODBC) a patchovaný kód rozdistribuujete mezi systémy. Kde je potřeba – sestavíte proxy, kde je potřeba – server.
A: – Nebude třeba navíc patchovat přenos proxy k serveru, pravděpodobně?
MЧ: – Ne, je standardní.
MM: – Ve skutečnosti jsme jednu z myšlenek nezmínili. Vždy jsme se snažili udržet rovnováhu mezi explozí nápadů a množstvím změn, snadností údržby.
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
