

Další konference HighLoad++ se uskuteční 6. a 7. dubna 2020 v Petrohradě.
Podrobnosti a vstupenky . HighLoad++ Sibiř 2019. Sál „Krasnojarsk“. 25. června, 12:00. Teze a .
Někdy se praktické požadavky dostávají do konfliktu s teorií, kde nejsou zohledněny důležité aspekty obchodního produktu. V této přednášce je představen proces výběru a kombinování různých přístupů k vytváření komponent Causal consistency na základě akademického výzkumu s ohledem na požadavky obchodního produktu. Posluchači se dozvědí o existujících teoretických přístupech k logickým hodinám, sledování závislostí, bezpečnosti systémů, synchronizaci hodin a proč se MongoDB rozhodly pro ta či ona řešení.
Mikhail Tyulenev (dále – MT): – Budu hovořit o Causal consistency – funkci, na které jsme pracovali v MongoDB. Pracuji ve skupině distribuovaných systémů, vytvořili jsme ji asi před dvěma lety.
Během procesu jsem se musel seznámit s velkým množstvím akademického výzkumu, protože tato funkce je dost dobře prozkoumána. Ukázalo se, že žádný článek se nevejde do toho, co je potřeba v produkci, databázích, s ohledem na velmi specifické požadavky, které asi existují v jakýchkoli produkčních aplikacích.
Budu hovořit o tom, jak my, jakožto spotřebitelé akademického výzkumu, připravujeme něco takového, co poté můžeme předložit našim uživatelům jako hotové jídlo, které je pohodlné a bezpečné používat.
Příčinná konzistence (Causal consistency). Definujeme pojmy
Nejprve chci v obecnosti říci, co vlastně Causal consistency je. Existují dvě postavy – Leonard a Penny (seriál „Teorie velkého třesku“):
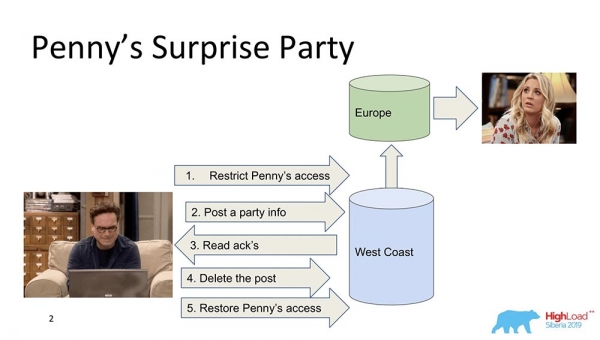
Představme si, že je Penny v Evropě a Leonard jí chce udělat nějaké překvapení, párty. A on nic lepšího nevymyslí, než ji vymazat ze seznamu přátel, poslat všem přátelům aktualizaci na feed: „Pojďme potěšit Penny!“ (ona je v Evropě, zatímco spí, nevidí to a nemůže to vidět, protože tam není). Nakonec ten příspěvek odstraní, smaže z „Fidu“ a obnoví přístup, aby si ničeho nevšimla a nedošlo k nějakému skandálu.
To je všechno skvělé, ale předpokládejme, že systém je distribuovaný a události se vyvinuly trochu jinak. Může se například stát, že omezení přístupu Penny nastalo po zveřejnění tohoto příspěvku, pokud nejsou události vzájemně příčinně spojeny. V podstatě jde o příklad situace, kdy je vyžadována kauzální konzistence pro splnění podnikové funkce (v tomto případě).
Ve skutečnosti jsou to poměrně netriviální vlastnosti databáze – jen velmi málo z nich je podporováno. Přejděme k modelům.
Modely konzistence (Consistency Models)
Co je vlastně model konzistence v databázích? Jsou to určité záruky, které distribuovaný systém poskytuje ohledně toho, jaká data a v jakém pořadí může klient obdržet.
V zásadě všechny modely konzistence se zjednodušují na to, jak moc se distribuovaný systém podobá systému, který pracuje například na jednom uzlu na notebooku. A jak moc se systém, který funguje na tisících geo-distribuovaných 'uzlech', podobá notebooku, ve kterém jsou všechny tyto vlastnosti plně automaticky splněny.
Proto se modely konzistence uplatňují pouze na distribuované systémy. Všechny systémy, které existovaly dříve a pracovaly na jednom vertikálním škálování, takové problémy neměly. Měli tam jeden Buffer Cache, ze kterého se vše vždy načítalo.
Model Strong
První model – to je Strong (nebo často nazývaný rise ability). Je to model konzistence, který zaručuje, že každá změna, jakmile dojde k potvrzení, že se uskutečnila, je viditelná všem uživatelům systému.
Tím se vytváří globální pořadí všech událostí v databázi. Je to velmi silné vlastnost konzistence a je také velmi nákladné. Přesto je velmi dobře podporováno. Je to prostě velmi drahé a pomalé – používá se jen zřídka. Nazývá se rise ability.
Existuje ještě jedna silnější vlastnost, která je podporována ve 'Spanneru' – nazývá se externí konzistence. O tom si povíme později.
Causal
Následující je Causal, přesně to, o čem jsem mluvil. Mezi Strong a Causal existuje ještě několik podúrovní, o kterých nebudu mluvit, ale všechny se týkají Causal. To je důležitý model, protože je nejsilnější ze všech modelů, s největší konzistencí při existenci sítě nebo oddělení.
Causals je situace, kdy jsou události spojeny příčinnou souvislostí. Velmi často je lidé vnímají jako Read your on rights z pohledu klienta. Pokud klient sledoval nějaké hodnoty, nemůže vidět hodnoty, které byly v minulosti. Už začíná vidět prefixní čtení. To vše se týká jednoho a toho samého.
Causals jako model konzistence - částečné uspořádání událostí na serveru, kdy jsou události ze všech klientů pozorovány ve stejném pořadí. V tomto případě - Leonard a Penny.
Eventual
Třetí model je Eventual Consistency. To je to, co podporují naprosto všechny distribuované systémy, nejmenší model, který má vůbec smysl. Znamená to následující: když dojde k nějakým změnám v datech, v určitém okamžiku se stanou konzistentními.
V takovém okamžiku nic neříká, jinak by se to proměnilo na External Consistency - byla by to úplně jiná historie. Nicméně, to je velmi populární model, nejrozšířenější. Ve výchozím nastavení všechny uživatelské distribuované systémy používají právě Eventual Consistency.
Chci přinést několik srovnávacích příkladů:
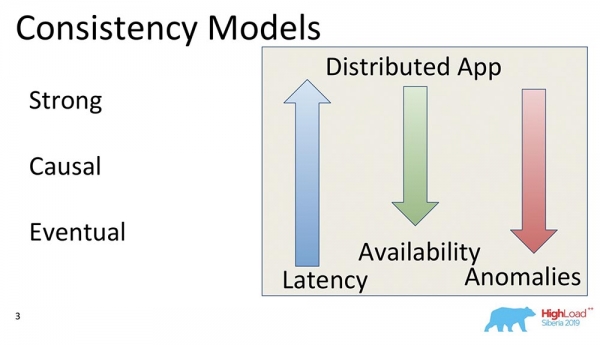
Co tyto šipky znamenají?
- Latence. Se zvyšující se silou konzistence se zvyšuje zřejmým způsobem: je potřeba provést více zápisů, získat potvrzení od všech hostitelů a uzlů, které se účastní v clusteru, že data tam již jsou. Odpověď v případě Eventual Consistency je nejrychlejší, protože tam se obvykle dá commitnout i do paměti a to bude v zásadě dostačující.
- Dostupnost. Pokud to chápeme jako schopnost systému odpovědět při výpadcích sítě, odděleních nebo nějakých selháních - odolnost proti chybám narůstá s poklesem modelu konzistence, protože stačí, aby jeden hostitel žil a vydával nějaká data. Eventual Consistency vůbec nic nezaručuje ohledně dat - může to být cokoliv.
- Anomalie. Samozřejmě se zvyšuje počet anomálií. Při Strong Consistency by vůbec neměly existovat, zatímco u Eventual Consistency mohou být jakékoli. Vzniká otázka: proč lidé volí Eventual Consistency, i když obsahuje anomálie? Odpověď je, že modely Eventual Consistency jsou použitelné a anomálie se vyskytují například jen na krátkou dobu; existuje možnost používat master pro čtení a více méně číst konzistentní data; často je možnost používat silné modely konzistence. Prakticky to funguje a často je počet anomálií časově omezen.
CAP teorema
Když vidíte slova konzistence, dostupnost – co vám přijde na mysl? Správně – CAP teorema! Chci teď rozptýlit mýtus… To nejsem já – to je Martin Kleppmann, který napsal skvělý článek, skvělou knihu.
CAP teorema je princip, který byl formulován v 2000. letech, že Consistency, Availability, Partitions: vezměte jakékoli dva, a nelze zvolit tři. To byl určitý princip. Byl prokázán jako teorema o několik let později, udělali to Gilbert a Lynch. Poté se to začalo používat jako mantra – systémy se začaly dělit na CA, CP, AP a tak dále.
Tato teorema byla prokázána ve skutečnosti pro tyto případy… Za prvé, dostupnost byla považována nikoli jako kontinuální hodnota od nuly do sta (0 – systém "mrtvý", 100 – odpovídá rychle; tomu jsme si navykli říkat), ale jako vlastnost algoritmu, která zaručuje, že při všech jeho exekucích vrací data.
O čase odpovědi tam není ani slovo! Existuje algoritmus, který vrací data za 100 let – naprosto skvělý dostupný algoritmus, který je součástí teoremy CAP.
Za druhé: teorema byla prokazována pro změny hodnot jednoho a téhož klíče, přičemž tyto změny jsou resizable linie. To znamená, že se ve skutečnosti prakticky nepoužívají, protože modely jsou jiné, Eventual Consistency, Strong Consistency (možná).
O co jde? O to, že CAP teorema v tom tvaru, v jakém byla prokázána, je prakticky nepoužitelná, málo se používá. V teoretické formě nějakým způsobem vše omezuje. Vzniká určitý princip, který je intuitivně pravdivý, ale vlastně není nijak prokázán.
Causal consistency – nejsilnější model
Co se teď děje – je možné získat všechny tři věci: Konzistenci, Dostupnost pomocí Rozdělení. Zvlášť Kauzální konzistence – nejvíce silný model konzistence, který i při existenci Rozdělení (výpadků v síti) stále funguje. Proto má tak velký zájem, proto se jí také věnujeme.
Za prvé, zjednodušuje práci vývojářů aplikací. Zvlášť, když existuje velká podpora ze serveru: když všechna data, která přicházejí od jednoho klienta, přicházejí na druhého klienta zaručeně v tomto pořadí. Za druhé, odolává rozdělením.
Interní kuchyně MongoDB
Pamětní na to, že máme oběd, přesouváme se do kuchyně. Povědí vám o modelu systému, konkrétně – co to MongoDB je pro ty, kdo o této databázi slyší poprvé.
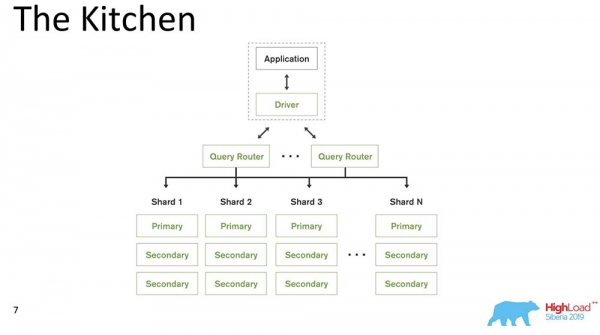
MongoDB (dále „MongoDB“) je distribuovaný systém, který podporuje horizontální škálování, tedy shardování; a uvnitř každého shardu také podporuje redundanci dat, tedy replikaci.
Shardování v „MongoDB“ (nerelační DB) provádí automatické vyvážení, tedy každá kolekce dokumentů (nebo „tabulka“ v terminologii relačních dat) se rozdělí na kusy, a server je automaticky přemisťuje mezi shardy.
Dotazovací router, který distribuuje dotazy, je pro klienta jakýmsi klientem, přes který pracuje. Už ví, kde a jaká data se nacházejí, a směruje všechny dotazy na správný shard.
Další důležitý bod: MongoDB je jediný master. Existuje jeden primární – může přijímat záznamy, které podporují klíče, které sám obsahuje. Není možné provádět Multi-master zápis.
Uvedli jsme verzi 4.2 – objevily se nové zajímavé funkce. Zvlášť jsme integrovali Lucene – vyhledávání – konkrétně spustitelnou java přímo v „Mongo“, a nyní je možné provádět vyhledávání přes Lucene, stejně jako v „Elastiku“.
A také jsme vytvořili nový produkt – Charts, je také dostupný na „Atlase“ (vlastní Cloud „Mongo“). Mají Free Tier – můžete si s tím vyhrát. Charts se mi velmi líbil – vizualizace dat, velmi intuitivní.
Ingredience Kauzální konzistence
Spočítal jsem přibližně 230 článků, které byly na toto téma publikovány – od Leslie Lamperta. Teď vám z paměti přednesu některé části těchto materiálů.
Všechno začalo s článkem Lesley Lampertové, který byl napsán v 70. letech. Jak vidíte, výzkum v této oblasti pokračuje i dnes. Nyní má kauzální konzistence zájem kvůli rozvoji distribuovaných systémů.
Omezení
Jaká jsou omezení? To je skutečně jeden z hlavních bodů, protože omezení, která kladou produkční systémy, se zásadně liší od omezení uvedených v akademických článcích. Často jsou dost umělá.
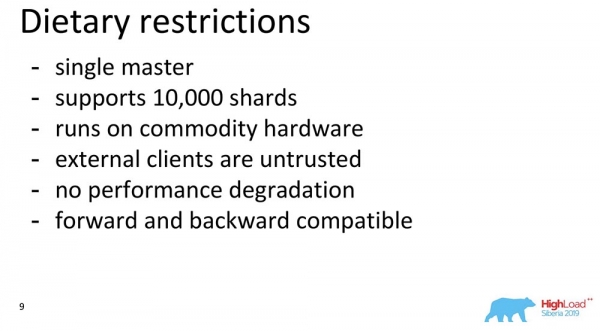
- Za prvé, "MongoDB" je single master, jak jsem již řekl (to to značně zjednodušuje).
- Domníváme se, že systém by měl podporovat přibližně 10 tisíc shardů. Nemůžeme přijímat žádná architektonická rozhodnutí, která by toto číslo zjevně omezovala.
- Máme cloud, ale předpokládáme, že uživatel by měl mít možnost stáhnout si binární soubor, spustit jej na svém notebooku a všechno by mělo fungovat skvěle.
- Předpokládáme, že v oblasti výzkumu se zřídka používá: externí klienti mohou dělat, co chtějí. "MongoDB" je open source. Odpovídajícím způsobem, klienti mohou být chytří, zlí - mohou chtít všechno zničit. Předpokládáme, že mohou nastat byzantské chyby.
- Pro externí klienty, kteří jsou mimo perimetr – důležité omezení: pokud je tato funkce vypnuta, nemělo by docházet k žádnému zhoršení výkonu.
- Další bod – vůbec antikademický: kompatibilita předchozích verzí a budoucích. Staré ovladače by měly podporovat nové aktualizace a databáze by měla podporovat staré ovladače.
Celkově to vše klade omezení.
Komponenty kauzální konzistence
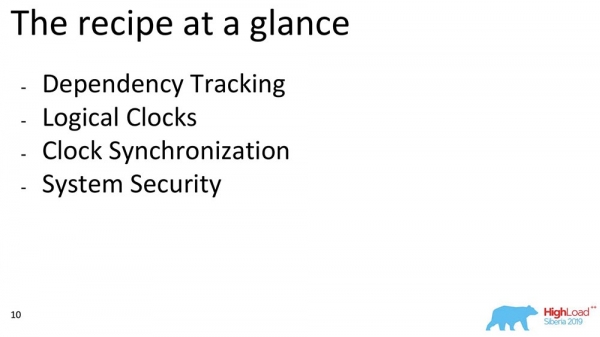
Nyní vám povím o některých komponentách. Pokud zvažujeme kauzální konzistenci jako celek, můžeme vyčlenit bloky. Vybrali jsme z prací, které patří k nějakému bloku: Sledování závislostí, výběr hodin, jak tyto hodiny synchronizovat a jak zajišťujeme bezpečnost – to je přibližný plán toho, o čem budu mluvit:
Úplné sledování závislostí (Full Dependency Tracking)
Proč je to potřeba? Aby byla při replikaci dat každá záznam a každá změna dat doplněna informací o tom, na jaké změny se odkazuje. Nejprimitivnější a nejjednodušší změna je, když každá zpráva obsahující záznam, nese informace o předchozích zprávách:
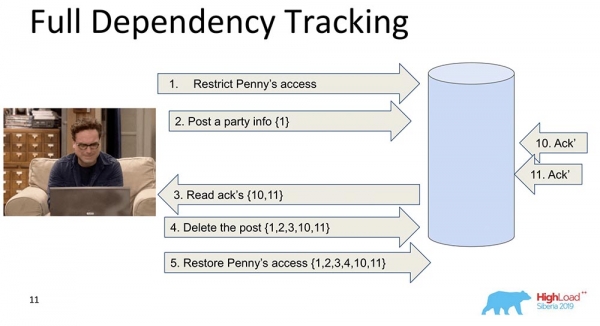
V tomto příkladu je číslo v závorkách čísly záznamů. Někdy jsou tyto záznamy se hodnotami předávány úplně, někdy se předávají určité verze. Podstatou je, že každá změna obsahuje informace o předchozím (to vše výslovně nese).
Proč jsme se rozhodli takový přístup (kompletní sledování) nepoužívat? Je zřejmé, že tento přístup je nepraktický: jakákoliv změna v sociální síti závisí na všech předchozích změnách v této sociální síti, například předává „Facebook“ nebo „Vkontakte“ v každé aktualizaci. Nicméně existuje mnoho výzkumů o Full Dependency Tracking – to jsou pre-sociální sítě, pro určité situace to opravdu funguje.
Jasné sledování závislostí (Explicit Dependency Tracking)
Následující – omezenější. Zde se také zkoumá přenos informací, ale pouze těch, které jsou výslovně závislé. To, co na čem závisí, obvykle určuje již aplikace. Když se data replikují, při dotazu se vydávají pouze odpovědi, když byly splněny předchozí závislosti, tedy zobrazeny. V tom spočívá způsob, jakým funguje kauzální konzistence.
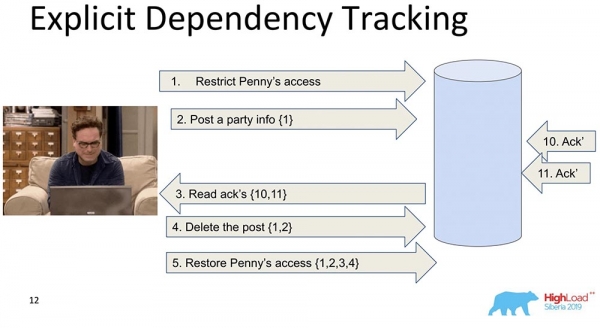
Vidí, že záznam 5 závisí na záznamech 1, 2, 3, 4 – odpovídajícím způsobem čeká, než klient získá přístup ke změnám, které byly provedeny rozhodnutím přístupu Penny, když už všechna předchozí změna byla zpracována v databázi.
To nám také nevyhovuje, protože stále je příliš mnoho informací, a to by zpomalovalo. Existuje jiný přístup...
Lamportovy hodiny (Lamport Clock)
Jsou velmi staré. Lamport Clock znamená, že tyto závislosti se skládají do skalární funkce, která se nazývá Lamport Clock.
Skalární funkce je abstraktní číslo. Často se mu říká logický čas. Při každé události se tento counter zvyšuje. Counter, který je momentálně znám procesu, posílá každou zprávu. Je jasné, že procesy mohou být rozhozené, mohou mít úplně odlišný čas. Přesto touto výměnou zpráv systém nějakým způsobem synchronizuje hodiny. Co se v tomto případě děje?
Rozdělil jsem ten velký shard na polovinu, aby to bylo jasné: Friends mohou žít v jedné nodě, která obsahuje část kolekce, zatímco Feed – v jiném nodě, která obsahuje také část této kolekce. Je jasné, jak se mohou dostat mimo frontu? Nejprve Feed řekne: „Byl replikován“, a poté – Friends. Pokud systém nezajišťuje nějaké záruky, že Feed nebude zobrazen, dokud závislosti Friends v kolekci Friends také nebudou doručeny, pak se dostáváme do situace, o které jsem mluvil.
Vidíte, jak se logický čas counteru na Feedu zvyšuje:
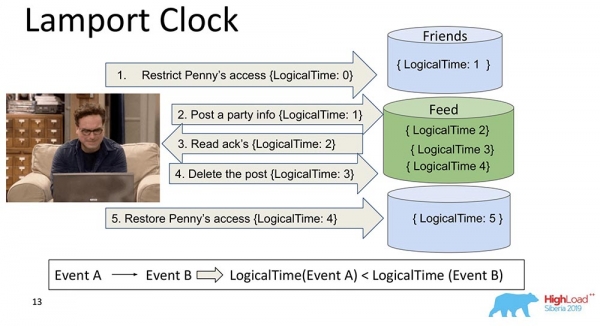
Hlavní vlastnost tohoto Lamport Clock a Causal consistency (vysvětlené pomocí Lamport Clock) spočívá v tom, že pokud máme události A a B, a událost B závisí na události A *, pak z toho plyne, že LogicalTime události A je menší než LogicalTime události B.
* Někdy se také říká, že A se stalo před B, tedy A nastalo dříve než B – je to vztah, který částečně uspořádává celé množství událostí, které se vůbec staly.
Opačně to neplatí. To je vlastně jeden z hlavních nedostatků Lamport Clock – částečný pořádek. Existuje pojem souběžných událostí, což jsou události, kde ani (A se stalo před B), ani (A se stalo po B) neplatí. Příkladem může být paralelní přidání Leonardem do přátel někoho jiného (dokonce ne Leonardem, ale Sheldonem, například).
To je vlastnost, kterou se často zabývají při práci s Lamportovými hodinami: sledují se přesně funkce a z toho se usuzuje – možná, že tyto události jsou závislé. Protože jedním směrem to platí: pokud LogicalTime A je menší než LogicalTime B, pak B nemůže nastat před A; a pokud je větší, tak to možná může.
Vektorové hodiny (Vector Clock)
Logický vývoj hodin Lámporta – jsou to Vektorové hodiny. Ty se liší tím, že každý nod, který zde existuje, obsahuje své vlastní, oddělené hodiny, které se předávají jako vektor.
V tomto případě vidíte, že nulový index vektoru odpovídá Feed, zatímco první index vektoru představuje Friends (každý z těchto uzlů). A teď se budou zvyšovat: nulový index 'Feed' se zvyšuje při zápisu – 1, 2, 3:
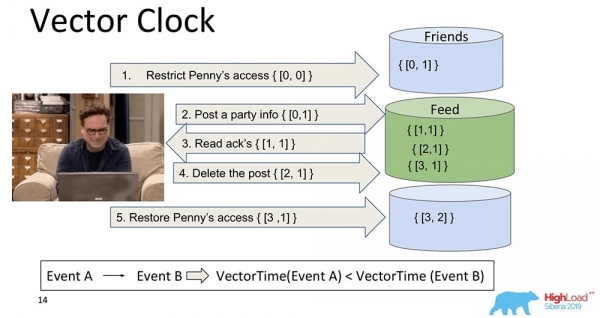
Proč jsou vektorové hodiny lepší? Umožňují pochopit, které události probíhají současně a kdy se odehrávají na různých uzlech. To je velmi důležité pro systém shardování, jako je 'MongoDB'. Ale my jsme to nevybrali, ačkoliv je to skvělá věc, úžasně funguje a pravděpodobně by se nám hodila…
Pokud máme 10 tisíc shardů, nemůžeme přenášet 10 tisíc komponent, aniž bychom je zkomprimovali, nebo vymysleli něco jiného – stejně bude užitečná nosnost mnohem menší než objem celého tohoto vektoru. Proto jsme se se skřípajícími zuby a srdcem rozhodli od tohoto přístupu odstoupit a přešli k jinému.
Spanner TrueTime. Atomové hodiny.
Říkal jsem, že bude řeč o 'Spanneru'. To je úžasná věc, přímo XXI. století: atomové hodiny, GPS synchronizace.
Jaký je koncept? 'Spanner' je systém od Google, který se nedávno stal dostupným i pro lidi (přidali k němu SQL). Každá transakce má svůj časový údaj. Jelikož je čas synchronizován*, každé události lze přidělit určitý čas – atomové hodiny mají dobu čekání, po které už garantovaně 'nastává' jiný čas.
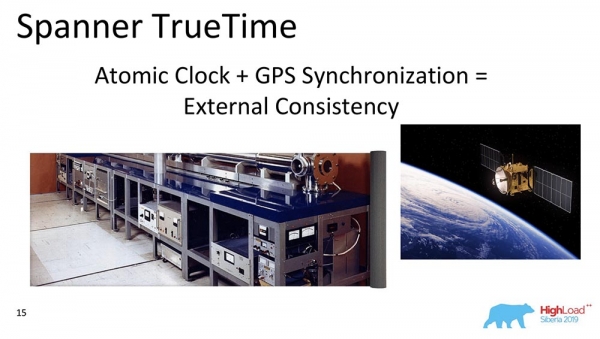
Tímto způsobem, když prostě zapisujete do DB a čekáte určité časové období, se automaticky zaručuje serializovatelnost události. Mají nejstrongerší model konzistence, který si vůbec lze představit – je to externí konzistence.
* To je hlavní problém Lamportových hodin – nikdy nejsou synchronizovány v distribuovaných systémech. Mohou se rozcházet, i když je NTP, stejně nefungují příliš dobře. 'Spanner' má atomové hodiny a synchronizaci, zdá se, na mikrosekundy.
Proč jsme nevybrali? Nepředpokládáme, že naši uživatelé mají integrované atomové hodiny. Když se objeví, přičemž budou integrované do každého laptopu, bude nějaká super skvělá GPS synchronizace – pak ano… A zatím nejlepší, co je možné, je 'Amazon', základnové stanice – pro fanatiky… Proto jsme použili jiné hodiny.
Hybridní hodiny (Hybrid Clock)
To je vlastně to, co tiká v „MongoDB“ při zajištění kauzální konzistence. V čem jsou hybridní? Hybrid je skalární hodnota, ale skládá se ze dvou komponentů:
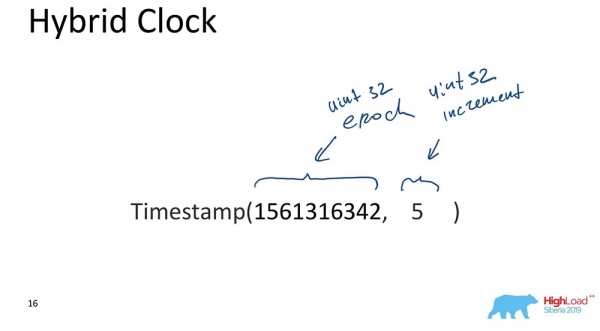
- První – je to unixová epocha (kolik sekund uplynulo od „začátku počítačového světa“).
- Druhé – nějaký inkrement, také 32bitový unsigned int.
To je vlastně vše. Existuje takový přístup: část, která odpovídá za čas, se neustále synchronizuje s hodinami; pokaždé, když dojde k aktualizaci, tato část se synchronizuje s hodinami, takže čas je vždy více či méně správný, a inkrement umožňuje rozlišovat mezi událostmi, které se staly ve stejném okamžiku.
Proč je to důležité pro „MongoDB“? Protože to umožňuje provádět nějaké zálohování a obnovení k určitému okamžiku, tedy událost se indexuje časem. To je důležité, když jsou potřeba některé události; pro DB jsou události změny v DB, které se staly v určitých časových intervalech.
Nejdůležitější důvod vám řeknu jen vám (prosím, nikomu to neříkejte)! Udělali jsme to tak, protože takto vypadají uspořádaná, indexovaná data v MongoDB OpLog. OpLog je datová struktura, která obsahuje všechny změny v databázi: nejprve se dostanou do OpLog a poté se již aplikují na Storage, když se jedná o replikovaná data nebo shard.
To byl hlavní důvod. Existují také praktické požadavky na vývoj databáze, a to znamená, že to musí být jednoduché – co nejméně kódu a co nejméně rozbitých věcí, které je třeba přepisovat a testovat. To, že máme op-logy indexovány hybridními hodinami, nám hodně pomohlo a umožnilo nám udělat správnou volbu. Opravu se to osvědčilo a nějak kouzelně to fungovalo na prvním prototypu. Bylo to opravdu úžasné!
Synchronizace hodin
Existuje několik způsobů synchronizace, které jsou popsány v vědecké literatuře. Mluvím o synchronizaci, když máme dva různé shard. Pokud máme replikační set – tam žádná synchronizace není potřeba: je to „single-master“; máme OpLog, do kterého všechna změna putuje – v tomto případě je vše už sekvenčně seřazeno v samotném „OpLogu“. Ale pokud máme dva různé shardy, tady je synchronizace času důležitá. Tady nám více pomohly vektorové hodiny! Ale ty nemáme.
Druhý vhodný způsob je „Heartbeats“. Můžeme si mezi sebou vyměňovat určité signály, které probíhají každou jednotku času. Ale „Heartbeats“ jsou příliš pomalé, nemůžeme zaručit latenci našim klientům.
Pravý čas – samozřejmě, skvělá věc. Ale opět, to je pravděpodobně budoucnost… Ačkoli v „Atlasu“ to už lze udělat, existují už rychlé „amazonické“ synchronizátory času. Ale to nebude dostupné pro všechny.
Gossiping – je to když všechny zprávy zahrnují čas. To je zhruba to, co používáme. Každá zpráva mezi uzly, driverem, routerem datových uzlů, naprosto vše pro „MongoDB“ – to jsou nějaké prvky, komponenty databáze, které obsahují hodiny, které běží. Všude mají hodnotu hybridního času, ta se předává. 64 bitů? To umožňuje, to je možné.
Jak to všechno funguje dohromady?
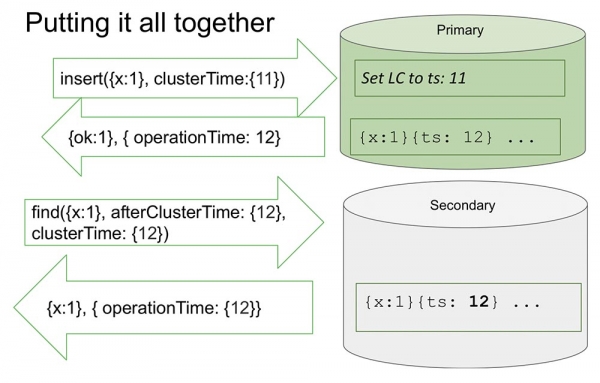
Tady zvažuju jeden replikační set, aby to bylo o něco jednodušší. Je zde Primary a Secondary. Secondary provádí replikaci a není vždy zcela synchronizován s Primary.
Dochází k vložení (insert) do „Primary“ s určitým časovým údajem. Tento insert zvyšuje vnitřní čítač o 11, pokud je to maximální. Nebo zkontroluje hodnoty hodin a synchronizuje se podle hodin, pokud jsou hodnoty hodin větší. To umožňuje seřadit podle času.
Po tom, co provede zápis, nastává důležitý moment. Hodiny v „MongoDB“ se inkrementují pouze v případě zápisu do „OpLog“. To je událost, která mění stav systému. Ve všech klasických článcích je událostí považován příjem zprávy do uzlu: zpráva přišla – znamená to, že systém změnil svůj stav.
To je dáno tím, že při zkoumání není zcela jasné, jak bude tato zpráva interpretována. Přesně víme, že pokud není odražena v „Oplogu“, nebude nijak interpretována, a změna stavu systému je pouze záznam v „Oplogu“. To všechno nám usnadňuje: model je zjednodušený, což umožňuje uspořádání v rámci jednoho replikového souboru, a mnoho dalších užitečných věcí.
Vrací se hodnota, která již byla zaznamenána v „Oplogu“ – víme, že v „Oplogu“ tato hodnota již existuje a její čas je 12. Nyní, řekněme, že čtení začíná z jiného uzlu (Secondary) a on předává již afterClusterTime ve zprávě. Říká: „Potřebuji všechno, co se stalo alespoň po 12 nebo v době dvanácti“ (viz obrázek výše).
To, čemu se říká Causal a consistent (CAT). Existuje takový pojem v teorii, že to je jakási průřez času, který je konzistentní sám o sobě. V tomto případě lze říci, že se jedná o stav systému, který byl pozorován v okamžiku času 12.
Teď zde zatím nic není, protože to jakoby imituje situaci, kdy je třeba, aby Secondary replikoval data z Primary. Čeká… A teď data přišla – vrací zpět tyto hodnoty.
Takto zhruba vše funguje. Téměř.
Co znamená „téměř“? Představme si, že je nějaký člověk, který přečetl a pochopil, jak to vše funguje. Pochopil, že se při každém záznamu aktualizuje ClusterTime, interní logické hodiny a pak další záznam zvyšuje o jedno. Tato funkce zabírá 20 řádků. Předpokládejme, že tento člověk předává maximální 64-bitové číslo, minus jedna.
Proč „minus jedna“? Protože interní hodiny se vloží do této hodnoty (zjevně se jedná o největší možné a větší než aktuální čas), pak dojde k záznamu v „Oplogu“ a hodiny se inkrementují ještě o jedno – a bude již maximální hodnota (tam jsou prostě všechny jedničky, dál není kam, unsaint int’y).
Je jasné, že po tom se systém stává absolutně nedostupným pro cokoliv. Může být pouze vyexportován, vyčištěn – hodně ruční práce. Celková dostupnost:
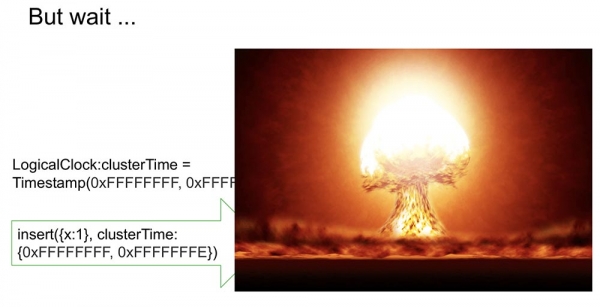
A pokud se to replikovalo i někam jinam, celý cluster se prostě zhroutí. Naprosto nepřijatelná situace, kterou může kdokoliv velmi rychle a snadno zorganizovat! Proto jsme tento aspekt považovali za jeden z nejdůležitějších. Jak tomu předejít?
Naší cestou je podepisovat clusterTime
Tak se to předává v zprávě (do modrého textu). Ale začali jsme také generovat podpis (modrý text):
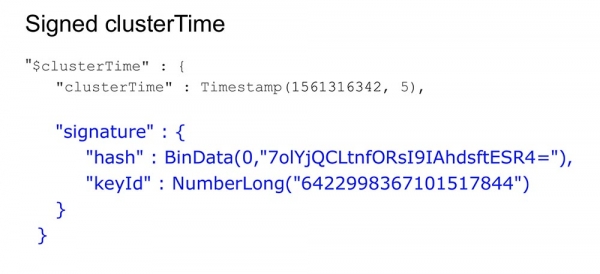
Podpis se generuje klíčem, který je uložen v databázi, uvnitř chráněného perimetru; generuje se sám, aktualizuje (uživatelé to nevidí). Generuje se hash a každá zpráva při vytvoření se podepisuje a při přijetí se validuje.
Možná se lidem objevuje otázka: "Jak moc to všechno zpomaluje?" Říkal jsem, že to musí fungovat rychle, zvláště při absenci této funkce.
Co to znamená používat Causal consistency v tomto případě? Znamená to ukazovat parametr afterClusterTime. Bez toho by to prostě předávalo hodnoty za jakýchkoliv okolností. Gossiping, počínaje verzí 3.6, funguje vždy.
Pokud bychom nechali neustálé generování podpisů, zpomalilo by to systém i při absenci funkce, což neodpovídá našim přístupům a požadavkům. A co jsme udělali?
Dělej to rychle!
Docela jednoduchá věc, ale zajímavý trik – podělím se, třeba to někoho zaujme.
Máme hash, ve kterém jsou uložena podepsaná data. Všechna data procházejí přes cache. Cache nepodepisuje konkrétně čas, ale Range. Když přijde určitá hodnota, generujeme Range, maskujeme posledních 16 bitů, a tuto hodnotu podpisujeme:
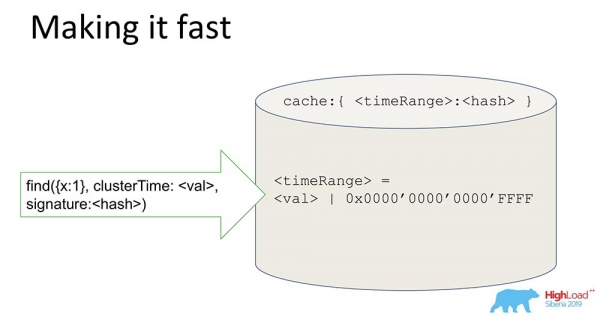
Získáním takového podpisu urychlujeme systém (podmíněně) 65 000krát. Skvěle to funguje: když jsme provedli experimenty – doba se skutečně zkrátila 10 000krát, když máme sekvenční aktualizaci. Je jasné, že když je to chaotické, nefunguje to. Ale ve většině praktických případů to funguje. Kombinace podpisu Range spolu s podpisem umožnila vyřešit problém bezpečnosti.
Co jsme se naučili?
Lekce, které jsme si z toho odnesli:
- Je potřeba číst materiály, příběhy, články, protože toho máme hodně zajímavého. Když pracujeme na nějaké funkci (zvlášť nyní, když jsme dělali transakce atd.), musíme číst a rozumět. Zabere to čas, ale je to skutečně velmi užitečné, protože tím získáme přehled o tom, kde se nacházíme. Nic nového jsme vlastně nevymysleli – jen jsme vzali ingredience.
Obecně se pozoruje určitý rozdíl v myšlení, když se koná akademická konference (například „Sigmon“) – tam se všichni soustředí na nové myšlenky. V čem je novost našeho algoritmu? Zde není žádná zásadní novost. Novost spíše spočívá v tom, jak jsme zkombinovali různé existující přístupy. Proto je nejprve potřeba číst klasiky, počínaje Lampartem.
- V produkci jsou zcela jiné požadavky. Jsem si jistý, že mnozí z vás se nesetkávají s „sférickými“ databázemi v abstraktním vakuu, ale s normálními, reálnými věcmi, které mají problémy s dostupností, latencí a odolností vůči výpadkům.
- Nakonec jsme museli zvážit různé myšlenky a zkombinovat několik zcela různých článků do jednoho přístupu dohromady. Myšlenka o podepisování například pochází z článku, který zkoumal Paxos protokol, který byl určen pro nevyzývavé selhání uvnitř autorizačního protokolu, pro byzantské – za hranicí autorizačního protokolu... Obecně to je přesně to, co jsme nakonec udělali.
Nic nového zde rozhodně není! Ale jakmile jsme to všechno smíchali... Je také jako říci, že recept na salát Olivier je nesmysl, protože vejce, majonéza a okurky již byly vymyšleny... To je zhruba podobný příběh.
Tímto končím. Děkuji!
Otázky
Otázka z publika (dále – O): – Děkuji, Michale, za prezentaci! Téma o čase je zajímavé. Používáte Gossiping. Říkali jste, že každý má svůj čas, všichni znají svůj lokální čas. Pochopil jsem to tak, že máme driver – může jich být hodně, query plánovačů také, shardů také mnoho… A kam se systém dostane, pokud nám náhle vznikne rozpor: někdo se rozhodne, že je o minutu napřed, někdo – o minutu pozadu? Kde se ocitneme?
MT: – To je skutečně skvělá otázka! Chtěl jsem právě mluvit o shardech. Pokud správně chápu otázku, máme takovou situaci: existuje shard 1 a shard 2, čtení probíhá z těchto dvou shardů – mají nesrovnalosti, protože spolu nekomunikují, protože čas, který znají, je odlišný, zejména čas, který mají ve oplogech.
Představme si, že shard 1 vytvořil milion zápisů, shard 2 – vůbec nic, a dotaz přišel na dva shardy. A první má afterClusterTime vyšší než milion. V takové situaci, jak jsem vysvětlil, shard 2 nikdy neodpoví.
Otázka: – Chtěl jsem se zeptat, jak se synchronizují a vyberou jedno logické časové razítko?
MT: – Synchronizují se velmi jednoduše. Shard, když k němu přijde afterClusterTime a on nenajde čas v ‚Oplogu‘ – iniciuje no approved. To znamená, že ručně zvedne svůj čas na tuto hodnotu. To znamená, že nemá události, které by odpovídaly této žádosti. Uměle vytváří tuto událost a tím se stává Causal Consistent.
Otázka: – A pokud k němu po tom ještě přijdou nějaké události, které se někde v síti ztratily?
MT: – Shard je navržen tak, že už nepřijdou, protože je to single master. Pokud už zapsal, nepřijdou už, ale budou později. Nemůže se stát, že něco někde uvízlo, pak udělá no write, a tyto události přišly – a narušila se tak Causal consistency. Když udělá no write, všechny by měly přijet dál (počkají na ně).
Otázka: – Mám několik otázek ohledně front. Causal consistency předpokládá, že existuje určitá fronta akcí, které se mají provést. Co se stane, když nám jeden paket zmizí? Přišel 10., 11... 12. zmizel, a všechny ostatní čekají, až se vykoná. A najednou stroj umřel, nemůžeme nic dělat. Existuje maximální délka fronty, která se hromadí, než se vykoná? Jaké fatální selhání nastane při ztrátě jakéhokoli jednoho stavu? Zvlášť, pokud zapisujeme, že existuje nějaký předchozí stav, od kterého se musíme odrazit? A od něj jsme se neodrazili!
MT: – Také skvělá otázka! Co děláme? V MongoDB existuje pojem kvórumových zápisů, kvórumového čtení. V jakých případech může zpráva zmizet? Když je zápis nekvórumový nebo když je čtení nekvórumové (také může přistát nějaký garbage).
Co se týče kauzální konzistence, provedli jsme rozsáhlé experimentální testování, jehož výsledkem bylo, že v případě, kdy jsou záznamy a čtení - nekvorumové, dochází k porušení kauzální konzistence. Přesně to, co říkáte!
Naše rada: používejte alespoň kvorumové čtení při použití kauzální konzistence. V takovém případě nic nezmizí, i když kvorumový zápis zmizí... To je ortogonální situace: pokud si uživatel nepřeje, aby data zmizela, měl by použít kvorumový zápis. Kauzální konzistence negarantuje trvanlivost. Záruku trvanlivosti poskytuje replikace a strojírenství spojené s replikací.
Otázka: – Když vytváříme instanci, která provádí shardování (ne master, ale slave), spolehá se na unixový čas vlastní mašiny nebo na čas "mastera"; synchronizuje se poprvé nebo pravidelně?
MT: – Teď to objasním. Shard (tj. horizontální partition) – tam je vždy Primary. A ve shardu může být "master" a mohou být repliky. Ale shard vždy podporuje zápis, protože musí podporovat určitou doménu (v shardu je Primary).
Otázka: – Takže všechno závisí čistě na "masteru"? Vždy se používá čas "mastera"?
MT: – Ano. Můžeme obrazně říct: hodiny tikají, když dochází k zápisu do "mastera", do "Oplogu".
Otázka: – Máme klienta, který se připojuje, a nemusí vědět o čase nic?
MT: – Opravdu nemusí vědět nic! Pokud jde o to, jak to funguje na klientovi: klient, když chce používat kauzální konzistenci, musí otevřít relaci. Teď tam je všechno: transakce v relaci a retrieve a rights... Relace je uspořádání logických událostí, které se dějí s klientem.
Pokud tuto relaci otevře a řekne, že chce kauzální konzistenci (pokud relace podle defaultu podporuje kauzální konzistenci), všechno automaticky funguje. Ovladač si pamatuje tento čas a zvyšuje ho, když dostává novou zprávu. Pamatuje si, jakou odpověď vrátilo předchozí volání ze serveru, které vrátilo data. Další žádost bude obsahovat afterCluster ("čas větší než toto").
Zákazník nemusí vědět naprosto nic! Je to pro něj zcela neprůhledné. Co lidé používají tyto funkce, co to umožňuje? Za prvé, je možné bezpečně číst ze sekundárních serverů: je možné zapisovat na primární a číst z geograficky replikovaných sekundárních a mít jistotu, že to funguje. Přitom sezení, která byla zapsaná na primární, lze přenést dokonce i na sekundární, tj. lze používat nejen jedno sezení, ale několik.
Otázka: – Téma Eventual consistency je silně spjaté s novou oblastí výpočetní vědy – typy dat CRDT (Conflict-free Replicated Data Types). Zvažovali jste integraci těchto typů dat do databáze a co o tom můžete říci?
MT: – Dobrý dotaz! CRDT dává smysl pro konflikty při zápisu: v MongoDB – jediný master.
Otázka: – Mám otázku od devops. V reálném světě se objevují takové jezuitské situace, kdy dochází k byzantskému selhání, a zlí lidé uvnitř chráněného perimetru začínají zasahovat do protokolu, posílat speciálně crafted pakety?
MT: – Zlí lidé uvnitř perimetru – to je jako Trojan! Zlí lidé uvnitř perimetru mohou udělat spoustu špatných věcí.
Otázka: – Je jasné, že nechávat v serveru, zjednodušeně řečeno, otvor, skrze který se může protáhnout zoo slonů a navždy zruinovat celý klastr… Obnovování bude vyžadovat čas… To je, mírně řečeno, špatně. Na druhou stranu je zajímavé: v reálném životě, v praxi, se setkáváte s takovými situacemi, kdy dochází k podobným interním útokům?
MT: – Protože se s bezpečnostními porušeními v reálném životě příliš často nesetkávám, nemohu říci – možná se i vyskytují. Ale pokud mluvíme o developerské filosofii, tak to vidíme takto: máme perimetr, který zajišťuje lidi, kteří se zabývají bezpečností – to je zámek, zeď; a uvnitř perimetru lze dělat cokoliv. Je jasné, že jsou uživatelé, kteří mohou jenom sledovat, a jsou uživatelé s možností smazat adresář.
V závislosti na právech může být škoda, kterou uživatelé mohou způsobit, myší, ale také slonem. Je jasné, že uživatel s plnými právy může udělat cokoliv. Uživatel s omezenými právy může způsobit mnohem menší škodu. Zejména nemůže systém rozbít.
Otázka: – V chráněném perimetru se někdo snaží vytvořit nečekané protokoly pro server, aby ho vyřadil z provozu, a pokud bude mít štěstí, tak i celý klastr… Může být tohle až tak „dobré“?
MT: – Nikdy jsem o takových věcech neslyšel. To, že se takhle dá server zhavarovat – to není tajemství. Zkonit ho zevnitř, když jsem z protokolu, jako autorizovaný uživatel, který může do zprávy napsat něco takového… Ve skutečnosti to není možné, protože se to stejně ověřuje. Existuje možnost vypnout tuto autentifikaci pro uživatele, kteří nechtějí – to už je pak jejich problém; v podstatě si sami zbořili zdi a můžou tam strčit slona, který to rozmačká… A vlastně se můžu obléknout jako opravář, přijít a vytáhnout to!
Otázka: – Děkuji za prezentaci. Sergej ("Yandex"). V MongoDB existuje konstanta, která omezuje počet hlasujících členů v Replica Setu, a ta konstanta je rovna 7 (sedmi). Proč je to konstanta? Proč to není nějaký parametr?
MT: – Replica Set může mít i 40 uzlů. Tam je vždy většina. Nevím, která verze ...
Otázka: – V Replica Setu můžete spouštět nehlasující členy, ale hlasujících je maximálně 7. Jak se v tomto případě vyrovnat s výpadkem, pokud máme Replica Set rozložený na 3 datová centra? Jedno datové centrum se může snadno vypnout a další stroj může vypadnout.
MT: – To už je trochu za hranicemi prezentace. To je obecná otázka. Možná ji můžu později vysvětlit.
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
