

V tomto článku vám představuji své úvahy o historii a perspektivách rozvoje internetu, centralizovaných a decentralizovaných sítí a jako výsledek — možné architektury decentralizované sítě další generace.
S internetem je něco v nepořádku
Poprvé jsem se seznámil s Internetem v roce 2000. Samozřejmě, to není úplný začátek — Síť už existovala předtím, ale tuto dobu lze nazvat prvním rozkvětem Internetu. World Wide Web — geniální vynález Tima Berners-Lee, web1.0 v jeho klasické kanonické podobě. Množství webových stránek a stránek, které se navzájem odkazují hypertextovými odkazy. Na první pohled — jednoduchá, jako všechno geniální, architektura: decentralizovaná a svobodná. Chci — cestuji po stránkách jiných lidí, přecházím po hypertextových odkazech; chci — vytvářím svou stránku, na které publikuji to, co mě zajímá — například své články, fotografie, programy, hypertextové odkazy na zajímavé stránky. A ostatní umisťují odkazy na mě.
Zdálo by se — idylický obraz? Ale už víte, jak to všechno skončilo.
Stránek bylo příliš mnoho a hledání informací se stalo velmi netriviálním úkolem. Odkazy, které definovali autoři, jednoduše nemohly strukturovat tento obrovský objem informací. Nejprve se objevily katalogy, které byly ručně naplňovány, a pak obrovské vyhledávače, které začaly používat důmyslné heuristické algoritmy pro hodnocení. Webové stránky byly vytvářeny a opouštěny, informace se duplikovaly a zkreslovaly. Internet se rychle komercionalizoval a vzdálil se od ideální akademické sítě. Jazyk značkování se rychle proměnil v jazyk formátování. Objevila se reklama, nepříjemné otravné bannery a technologie manipulace a klamání vyhledávačů — SEO. Síť se rychle zaplňovala informačním odpadem. Hypertextové odkazy přestaly být nástrojem logického spojení a proměnily se v nástroj propagace. Webové stránky se uzamykaly, stávaly se uzavřenými „aplikacemi“, stávaly se pouze prostředky k dosažení příjmů.
Už tehdy jsem měl pocit, že "něco tady není v pořádku". Spousta různých webů, od primitivních domácích stránek s nevkusným vzhledem po "megaportály", přeplněné blikajícími bannery. I když byly weby na stejné téma, vůbec nebyly propojené, každé mělo svůj vlastní design, svou strukturu, otravné bannery, špatně fungující vyhledávání, potíže s stahováním (ano, chtěl jsem mít informace offline). Už tehdy se internet začínal proměňovat na něco jako televize, kde bylo k užitečnému obsahu přidáno množství kýče.
Decentralizace se proměnila v noční můru.
Co vlastně chci?
Paradoxně, už tehdy, aniž bych znal web 2.0 nebo p2p, jsem jako uživatel decentralizaci nepotřeboval! Vzpomínající na své nezkažené myšlenky té doby, docházím k závěru, že jsem potřeboval... jednotnou databázi! Takovou, která by při dotazu zobrazila všechny výsledky, a ne ty, které nejlépe vyhovují hodnoticím algoritmům. Takovou, kde by všechny tyto výsledky byly uniformně zpracované a stylizované mým vlastním jednotným designem, a ne nevkusnými domácími designy mnoha Vašek Poupků. Takovou, kterou bych mohl ukládat offline a nebát se, že zítra zmizí web a informace navždy zmizí. Takovou, do které bych mohl přidávat své informace — například komentáře a tagy. Takovou, ve které bych mohl provádět vyhledávání, třídění a filtrování svými vlastními algoritmy.
Web 2.0 a sociální sítě
Mezitím se na scénu dostala koncepce Web 2.0. Formulovaná v roce 2005 Timem O’Reillym, jako "metodika navrhování systémů, které se díky zohlednění síťových interakcí stávají tím lepšími, čím více lidí je používá" — a zahrnující aktivní zapojení uživatelů do kolektivního vytváření a editace obsahu sítě. Bez přehánění, vrcholem a triumfem této koncepce se staly sociální sítě. Obrovské platformy, které spojují miliardy uživatelů a uchovávají stovky petabajtů dat.
Co jsme tedy získali v sociálních sítích?
- unifikace rozhraní; ukázalo se, že uživatelé nepotřebují všechny možnosti pro vytváření různorodého designu; všechny stránky všech uživatelů mají stejný design a to všem vyhovuje a je to vlastně pohodlné; liší se pouze obsah.
- unifikace funkcionality; veškerá rozmanitost skriptů se také ukázala jako zbytečná. "Feed", přátelé, alba... během existence sociálních sítí se jejich funkcionalita více či méně stabilizovala a pravděpodobně se nezmění: funkcionalita je určována formami aktivity lidí, a ti se prakticky nemění.
- jednotná DB; práce s takovou DB se ukázala jako mnohem pohodlnější než s množstvím rozptýlených stránek; vyhledávání se stalo mnohem snazším. Místo nekonečného skenování rozmanitých slabě spojených stránek, ukládání všeho tohoto, hodnocení podle složitých heuristických algoritmů — relativně jednoduchý unifikovaný dotaz na jednotnou databázi s známou strukturou.
- rozhraní zpětné vazby — lajky a sdílení; ve standardním webu si Google nemohl nijak zajistit zpětnou vazbu od uživatelů po kliknutí na odkaz ve vyhledávání. Na sociálních sítích se tato vazba ukázala jako jednoduchá a přirozená.
Co jsme ztratili? Ztratili jsme decentralizaci, a tedy — svobodu. Předpokládá se, že nyní nám naše data nepatří. Pokud jsme si dříve mohli vytvořit domácí stránku i na vlastním počítači, nyní předáváme všechna naše data internetovým gigantům.
Kromě toho, jak internet vyvíjel, začaly se jím zajímat vlády a korporace, což vedlo k problémům politické cenzury a autorských omezení. Naše stránky na sociálních sítích mohou být zablokovány a odstraněny, pokud obsah nevyhovuje nějakým pravidlům sítě; za neopatrný příspěvek — můžeme být vystaveni správnímu a dokonce trestnímu stíhání.
A tak se znovu zamýšlíme: neměli bychom si znovu přivést decentralizaci? Ale v jiné formě, zbavené nedostatků první pokus?
P2P sítě
První p2p sítě se objevily dávno před webem 2.0 a vyvíjely se paralelně s vývojem webu. Hlavní klasické využití p2p – sdílení souborů; první sítě byly vyvinuty pro výměnu hudby. První sítě (například Napster) byly v podstatě centralizované, a proto byly poměrně rychle uzavřeny držiteli práv. Následovníci šli cestou decentralizace. V roce 2000 vznikly protokoly ED2K (první klient eDokney) a Gnutella, v roce 2001 – protokol FastTrack (klient KaZaA). Postupně se zvyšovala míra decentralizace, technologie se zdokonalovaly. Na místo systémů s „čekacími frontami“ přišly torrenty, objevila se koncepce distribuovaných hash tabulek DHT. S rostoucím tlakem ze strany států se stala anonymita účastníků více žádoucí. Od roku 2000 se vyvíjí síť Freenet, od roku 2003 – I2P, v roce 2006 byl zahájen projekt RetroShare. Můžeme zmínit nespočet p2p sítí, jak těch, které existovaly dříve a již zmizely, tak i těmi, které fungují nyní: WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler a mnoho dalších. Je jich spousta. Jsou různé. Velmi různé – jak co do účelu, tak co do struktury… Pravděpodobně ani mnozí z vás tyto názvy neznají. A to rozhodně není všechno.
Nicméně p2p sítě mají spoustu nevýhod. Kromě technických nedostatků, které jsou vlastní každé konkrétní realizaci protokolu a klienta, můžeme například zmínit dost obecnou nevýhodu – složitost vyhledávání (tj. to vše, s čím se potýkal Web 1.0, ale v ještě složitější variantě). Neexistuje zde Google s jeho všudypřítomným a okamžitým vyhledáváním. A pokud pro souborové sdílecí sítě ještě můžete využít vyhledávání podle názvu souboru nebo podle metainformací, pak najít něco například v overlay sítích onion nebo i2p je docela obtížné, pokud vůbec možné.
Obecně platí, že pokud bychom prováděli analogie s klasickým internetem, většina decentralizovaných sítí se zasekla někde na úrovni FTP. Představte si internet, který nemá nic, kromě FTP: žádné moderní weby, žádný web2.0, žádný Youtube… Přibližně v takovém stavu se nacházejí decentralizované sítě. A i když existují jednotlivé pokusy něco změnit, zatím je těchto změn málo.
Obsah
Podívejme se ještě na jeden důležitý kousek této skládačky – obsah. Obsah je hlavním problémem každého internetového zdroje, a to zejména decentralizovaného. Odkud ho vzít? Samozřejmě lze spoléhat na skupinku nadšenců (jak se to děje u současných p2p sítí), ale pak bude rozvoj sítě docela pomalý a obsahu tam bude málo.
Práce s běžným internetem znamená vyhledávání a studium obsahu. Někdy – ukládání (pokud je obsah zajímavý a užitečný, mnozí, zejména ti, kteří přišli na síť v dobách dial-upu – včetně mě – rozumně ukládají offline, aby to neztratili; neboť internet je něco, co nemáme pod kontrolou, dnes je stránka, zítra není, dnes je video na YouTube – zítra ho odstranili atd.
A pro torrenty (které vnímáme spíše jako pouhý prostředek dodávky, než jako p2p síť) je ukládání dokonce předpokládáno. A to je ostatně jeden z problémů torrentů: stažený soubor se obtížně přesouvá na místo, kde by se s ním dalo pohodlněji zacházet (obvykle je potřeba ručně regenerovat sdílení) a rozhodně ho nelze přejmenovat (lze vytvořit hardlink, ale o tom velmi málo lidí ví).
Obecně mnoho lidí různými způsoby ukládá obsah. Jaký je jeho další osud? Obvykle uložené soubory končí někde na disku, v složce typu Stažené, v celkovém chaotickém hromadě, a leží tam spolu s mnoha tisíci dalších souborů. To je špatně – a to špatně primárně pro samotného uživatele. Pokud internet disponuje vyhledávacími stroji, lokální počítač uživatele nic podobného nemá. Dobře, pokud je uživatel pečlivý a zvyklý třídit „příchozí“ stažené soubory. Ale rozhodně ne všichni takoví jsou...
Vlastně existuje mnoho těch, kteří nic neukládají a zcela se spoléhají na online. Ale v p2p sítích se předpokládá, že obsah je uložen místně na zařízení uživatele a sdílen s ostatními účastníky. Lze najít takové řešení, které by umožnilo zapojit obě kategorie uživatelů do decentralizované sítě, aniž by se měnily jejich zvyky, a navíc – ulehčilo by jim život?
Myšlenka je celkem jednoduchá: co kdybychom vytvořili nástroj pro pohodlné a transparentní ukládání obsahu z běžného internetu, a to inteligentně — se sémantickými metainformacemi, a ne do jedné hromady, ale do určité struktury s možností dalšího strukturování, a zároveň distribuovali uložený obsah do decentralizované sítě?
Začněme s ukládáním
Nebudeme se zabývat utilitárním využitím internetu pro prohlížení předpovědí počasí nebo letových řádů. Více nás zajímají soběstačné a více méně neměnné objekty — články (počínaje tweetem/příspěvky na sociálních sítích a konče obsáhlými články, jaké najdete zde na Habr), knihy, obrázky, programy, audio a video záznamy. Odkud se většinou informace berou? Obvykle to jsou
- sociální sítě (různé novinky, krátké poznámky — „tweety“, obrázky, audio a video)
- články na tematických serverech (jako je Habr); dobrých zdrojů není příliš mnoho, většinou jsou tyto zdroje také postaveny na principu sociálních sítí
- zpravodajské weby
Obvykle tam najdeme standardní funkce: „líbí se mi“, „sdílet“, „sdílet na sociální síti“ atd.
Představme si nějaký prohlížečový plugin, který bude speciálně ukládat vše, co jsme označili jako „líbí se mi“, udělali repost, uložili do „oblíbených“ (nebo stiskli speciální tlačítko pluginu, které se zobrazí v menu prohlížeče — pro případ, že web nemá funkci „líbí se mi“/repostu/úložení do záložek). Hlavní myšlenka spočívá v tom, že jednoduše dáte „like“ — jako jste milionkrát udělali předtím, a systém ukládá článek, obrázek nebo video do speciálního offline úložiště a tento článek nebo obrázek se stává dostupným — jak pro offline prohlížení prostřednictvím rozhraní decentralizovaného klienta, tak v samotné decentralizované síti! Podle mého názoru velmi pohodlné. Žádné zbytečné kroky a hned řešíme vícero úkolů:
- ukládání cenného obsahu, který může zmizet nebo být odstraněn
- rychlé naplnění decentralizované sítě
- agregace obsahu z různých zdrojů (můžete být registrováni na desítkách internetových serverů a všechny „like“/reposty budou proudit do jediné místní databáze)
- structurace zajímavého vám obsahu podle vašich pravidla
Je zřejmé, že rozšíření pro prohlížeč musí být přizpůsobeno struktuře každého webu (to je zcela reálné — už v současnosti existují rozšíření pro ukládání obsahu z YouTube, Twitteru, VK atd.). Webů, kvůli nimž má smysl vytvářet osobní rozšíření, není zase tolik. Obvykle se jedná o populární sociální sítě (těch není více než deset) a ještě několik kvalitních tematických stránek, jako je Habra (takových je také málo). Při otevřeném kódu a specifikaci by vývoj nového rozšíření na základě šablonové přípravy neměl zabrat moc času. Pro ostatní stránky lze použít univerzální tlačítko pro uložení, které by uložilo celou stránku do mhtml — možná předtím by mělo stránku vyčistit od reklamy.
Teď o strukturování
Pod „chytrým“ ukládáním chápu minimálně ukládání s metainformacemi: zdroj obsahu (URL), sadu dříve udělených lajků, štítků, komentářů, jejich identifikátory atd. Při obyčejném ukládání se tyto informace ztrácejí… Pod zdrojem může rozumět nejen přímé URL, ale také sémantická složka: například skupina na sociální síti nebo uživatel, který provedl repost. Rozšíření může být dostatečně inteligentní, aby tuto informaci využilo pro automatické strukturování a tagování. Také je třeba chápat, že uživatel může vždy přidat k ukládanému obsahu nějaké metainformace, pro což je třeba poskytnout maximálně pohodlné rozhraní (mám mnoho nápadů, jak to udělat).
Tímto způsobem se řeší otázka strukturování a organizace lokálních souborů uživatele. To už je hotový užitek, který lze využít i bez jakéhokoli p2p. Prostě nějaká offline databáze, která ví, co, odkud a v jakém kontextu jsme uložili a která umožňuje provádět malé výzkumy. Například najít uživatele externí sociální sítě, kteří dávali nejvíce lajků pod stejnými příspěvky jako vy. Umožňuje to vůbec mnoho sociálních sítí v tomto ohledu?
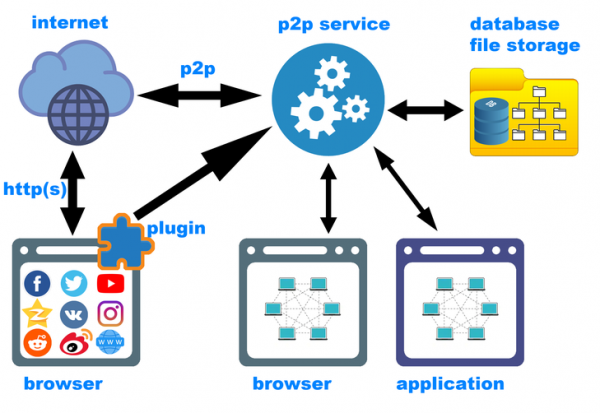
Je třeba zmínit, že samotný prohlížečový plugin rozhodně nestačí. Druhou nejdůležitější součástí systému je služba decentralizované sítě, která běží na pozadí a obsluhuje jak samotnou p2p síť (požadavky ze sítě a požadavky ze strany klienta), tak i ukládání nového obsahu prostřednictvím pluginu. Služba, pracující společně s pluginem, umístí obsah na potřebné místo, vypočítá hash (a možná určí, že takový obsah byl již dříve uložen), přidá do místní databáze potřebné meta informace.
Co je zajímavé — systém by byl užitečný i v této podobě, bez jakýchkoli p2p. Mnozí používají webové klipy, které přidávají zajímavý obsah z webu například do Evernote. Navrhovaná architektura je rozšířenou variantou takového klipru.
A nakonec, p2p výměna
Nejlepší na tom je, že informace a meta informace (jak ty zachycené z webu, tak i ty vlastní) lze sdílet. Koncept sociální sítě se skvěle přenáší na p2p architekturu. Můžeme říci, že sociální síť a p2p jako by byly stvořeny pro sebe navzájem. Jakákoli decentralizovaná síť by měla být ideálně postavena jako sociální, jen tak to bude fungovat efektivně. „Přátelé“, „Skupiny“ — to jsou přece ty samé uzly, se kterými by měly být stabilní vazby, a ty vycházejí z přirozeného zdroje — společných zájmů uživatelů.
Principy uchovávání a sdílení obsahu v decentralizované síti jsou zcela totožné s principy uchovávání (zachycování) obsahu z běžného internetu. Pokud používáte nějaký obsah ze sítě (a tedy jste jej uložili), kdokoli může používat vaše zdroje (disk a kanál), potřebné pro získání tohoto konkrétního obsahu.
To se mi líbí — nejjednodušší nástroj pro ukládání a sdílení. Pokud jsem dal „to se mi líbí“ — nezáleží na tom, zda venkovním internetu či uvnitř decentralizované sítě — znamená to, že se mi obsah líbí, a pokud to tak je, jsem ochoten si jej uchovat lokálně a sdílet ho s ostatními účastníky decentralizované sítě.
- Obsah se „není ztracen“; nyní je uložen u mě lokálně, budu se k němu moci vrátit později, kdykoli, aniž bych se obával, že jej někdo odstraní nebo zablokuje.
- Mohu (hned nebo později) kategorizovat, tagovat, komentovat, asociovat s dalším obsahem, celkově s ním udělat něco smysluplného — nazvěme to „tvorba meta informací“
- Mohu sdílet tyto meta informace s ostatními účastníky sítě
- Mohu synchronizovat své meta informace s meta informacemi ostatních účastníků
Možná je logické se vzdát dislikeů: pokud se mi obsah nelíbí — je logické, že nechci ztrácet místo na disku ani internet na distribuci tohoto obsahu. Proto dislike velmi organicky nezapadají do decentralizace (i když někdy to může být užitečné) ).
Někdy je třeba uchovat i to, co se "nelíbí". Existuje takové slovo "musím" :)
«Záložky» (nebo „Oblíbené“) — nevyjadřuji názor na obsah, ale uchovávám ho ve své místní databázi záložek. Slovo „oblíbené“ (favorites) příliš neodpovídá smyslu (na to jsou tu lajky a jejich následná kategorizace), zatímco „záložky“ (bookmarks) jsou zcela v pořádku. Obsah v „záložkách“ se také distribuuje — pokud je pro vás „potřebný“ (tj. ho nějak využíváte), je logické, že může být „potřebný“ i někomu jinému. Proč nevyužít své zdroje k tomu?
Funkce „přátelé« je zcela jasná. Jsou to skupiny lidí se podobnými zájmy, což znamená, že u nich pravděpodobně vznikne zajímavý obsah. V decentralizované síti to především znamená odběr novinek od přátel a přístup k jejich katalogům (alba) s uloženým obsahem.
Podobně funkce „skupiny» — nějaké kolektivní feedy, nebo fóra, nebo něco takového, na co se také dá přihlásit — a tedy přijímat všechny materiály skupiny a distribuovat je. Možná by „skupiny“, podobně jako velká fóra, měly být hierarchické — to by umožnilo lépe strukturovat obsah skupin, a také omezit tok informací a ne přijímat/nerozdělovat to, co pro vás není příliš zajímavé.
Všechno ostatní
Je třeba poznamenat, že decentralizovaná architektura je vždy složitější než centralizovaná. V centralizovaných zdrojích panuje rigidní diktát serverového kódu. V decentralizovaných je potřeba se dohodnout mezi mnoha rovnými účastníky. Samozřejmě se zde neobejdeme bez kryptografie, blockchainů a dalších technologických pokroků, které byly především vyvinuty pro kryptoměny.
Předpokládám, že budou potřeba určité kryptografické vzájemné hodnocení důvěry, vytvářené účastníky sítě navzájem. Architektura by měla efektivně bojovat s botnety, které, existující v nějakém cloudu, mohou například navzájem manipulovat své hodnocení. Velmi bych si přál, aby korporace a farmy botnetů, navzdory svému technologickému převahu, nezískaly kontrolu nad takovou decentralizovanou sítí; aby jejím hlavním zdrojem byli živí lidé, schopní vyrábět a strukturovat obsah zajímavý a užitečný pro ostatní živé lidi.
Také bych chtěl, aby taková síť posouvala civilizaci k pokroku. Na to mám celou řadu nápadů, které se ovšem nevejdou do rámce tohoto článku. Řeknu jen, že určitým způsobem by měl mít vědecký, technický, lékařský a podobný obsah přednost před zábavným, což si vyžádá určitou míru moderace. Sama moderace decentralizované sítě je netriviální úkol, ale řešitelný (i když slovo „moderace“ zde není vůbec správné a úplně nenaplňuje podstatu procesu - ani z vnějšího, ani z vnitřního pohledu... a já bych ani nevymyslel, jak by se dalo tento proces nazvat).
Snad bude zbytečné zmiňovat potřebu zajištění anonymity - jak integrovanými prostředky (jako v i2p nebo Retroshare), tak procházením veškerého provozu přes TOR nebo VPN.
A nakonec architektura softwaru (schématicky nakreslená na obrázku k článku). Jak již bylo řečeno, prvním komponentem systému je prohlížečový plugin, který zachycuje obsah s metainformacemi. Druhým klíčovým komponentem je p2p služba, která běží na pozadí („backend“). Činnost sítě by očividně neměla záviset na tom, zda je prohlížeč spuštěn. Třetím komponentem je klientský software — frontend. Může to být jak místní webová služba (v tomto případě bude mít uživatel možnost pracovat s decentralizovanou sítí přímo ve svém oblíbeném prohlížeči), tak samostatná GUI aplikace pro konkrétní OS (Windows, Linux, MacOS, Android, iOS atd.). Líbí se mi myšlenka současného existence všech variant frontendu. Zároveň to přinutí k přísnější architektuře backendu.
Existuje také spousta aspektů, které se do tohoto článku nedostaly. Připojení k rozdělování existujících úložišť (tj. když už máte pár terabajtů staženého obsahu a umožníte klientovi skenovat toto, získat hash a porovnat je s tím, co je uvnitř sítě a připojit se k rozdělování, a také získat z sítě metainformace o svých vlastních souborech — normální názvy, popisy, hodnocení, recenze atd.), připojení externích zdrojů metainformací (jako například databáze Libgen), volitelné využívání diskového prostoru pro ukládání cizího šifrovaného obsahu (jako ve Freenet), architektura integrace s existujícími decentralizovanými sítěmi (tady je to úplně temný les), myšlenka mediálního hashování (využívání speciálních percepčních hashů pro mediální obsah — obrázky, zvuk a video, což umožní porovnávat stejné smyslově příbuzné mediální soubory, které se liší velikostí, rozlišením atd.) a mnohem více.
Krátké shrnutí článku
1. V decentralizovaných sítích neexistuje Google se svým vyhledáváním a hodnocením — ale zato zde existuje Společenství skutečných lidí. Sociální síť se svými mechanismy zpětné vazby (lajky, reposty…) a sociálním grafem (přáteli, komunitami…) je ideálním aplikačním modelem pro decentralizovanou síť.
2. Hlavní myšlenka, kterou touto článkem předkládám, je automatické ukládání zajímavého obsahu z běžného internetu při likování/repostu; to může být užitečné i bez p2p, jen vedení osobního archivu zajímavých informací.
3. Tento obsah může zároveň automaticky naplňovat decentralizovanou síť.
4. Princip automatického ukládání zajímavého obsahu funguje i při likování/repostech v samotné decentralizované síti.
Zdroj: habr.com
