

26. února jsme pořádali meetup Apache Ignite GreenSource, na kterém vystupovali přispěvatelé projektu open source. Důležitým milníkem v životě tohoto společenství byla přestavba komponentu , který umožňuje nasazení uživatelských mikroslužeb přímo v clusteru Ignite. O tomto složitém procesu na meetupu hovořil , softwarový inženýr a již více než dva roky přispěvatel Apache Ignite.
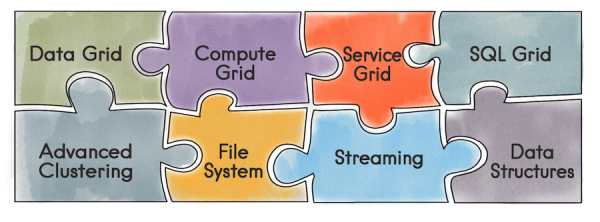
Začněme tím, co vlastně Apache Ignite je. Je to databáze, která představuje distribuované úložiště Key/Value s podporou SQL, transakčnosti a cachování. Navíc Ignite umožňuje nasazení uživatelských služeb přímo v clusteru Ignite. Vývojáři mají k dispozici všechny nástroje, které Ignite nabízí — distribuované datové struktury, Messaging, Streaming, Compute a Data Grid. Například při použití Data Grid odpadá problém s administrací samostatné infrastruktury pro úložiště dat, a tím i s tím spojené provozní náklady.
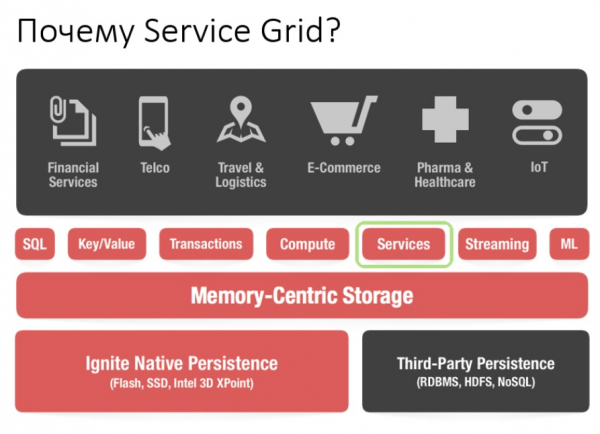
Použitím API Service Grid lze nasadit službu jednoduše tím, že v konfiguraci uvedete schéma nasazení a příslušnou službu.
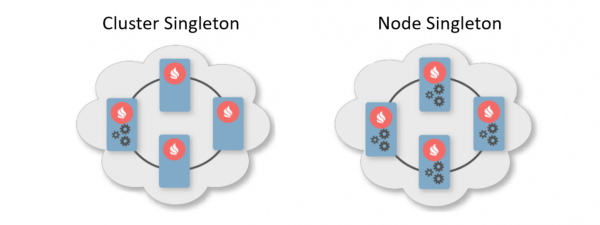
Obvykle je schéma nasazení specifikací počtu instancí, které by měly být nasazeny na uzlech clusteru. Existují dvě typické schémata nasazení. První je Cluster Singleton: v jakémkoli okamžiku bude v clusteru zaručeno, že je dostupná jedna instance uživatelské služby. Druhé je Node Singleton: na každém uzlu clusteru je nasazena jedna instance služby.
Uživatel také může specifikovat počet instancí služby v celém clusteru a definovat predikát pro filtrování vhodných uzlů. V takovém scénáři si Service Grid sám vypočítá optimální rozložení pro nasazení služeb.
Kromě toho existuje taková funkce jako Affinity Service. Affinity je funkce, která určuje vztah klíčů k partiím a vztah partií k uzlům v topologii. Pomocí klíče lze určit primární uzel, na kterém jsou data uložena. Tímto způsobem můžete asociovat vaši vlastní službu s klíčem a cache affinity funkce. V případě změny affinity funkce dojde k automatickému redeploy. Tak bude služba vždy umístěna blízko dat, se kterými musí manipulovat, a tím se sníží náklady na přístup k informacím. Takovou schéma lze nazvat jakýmsi kolokovanými výpočty.
Nyní, když jsme si objasnili, v čem spočívá kouzlo Service Grid, povíme si o jeho vývoji.
Co bylo předtím
Předchozí realizace Service Grid byla založena na transakčním replikovaném systémovém cache Ignite. Pod slovem "cache" v Ignite se rozumí úložiště. Tedy to není něco dočasného, jak by se mohlo zdát. I když je cache replikovaná a každý uzel obsahuje celý soubor dat, uvnitř má cache partitionované zobrazení. To souvisí s optimalizací úložišť.
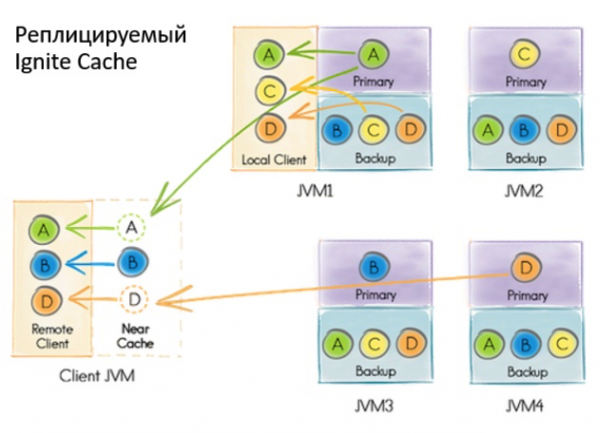
Co se dělo, když uživatel chtěl nasadit službu?
- Všechny uzly v clusteru se přihlašovaly k aktualizaci dat v úložišti pomocí vestavěného mechanismu Continuous Query.
- Uzel iniciátor v transakci read-committed provedl zápis do databáze, který obsahoval konfiguraci služby, včetně serializovaného instance.
- Při obdržení oznámení o nové položce koordinátor vypočítal rozložení na základě konfigurace. Získaný objekt byl zapsán zpět do databáze.
- Pokud byl uzel zahrnut do rozložení, koordinátor ho měl nasadit.
Co nám nevyhovovalo
V určitém okamžiku jsme dospěli k závěru: takto nelze pracovat se službami. Příčin bylo několik.
Pokud během nasazení došlo k nějaké chybě, bylo možné o ní zjistit pouze ze záznamů toho uzlu, kde k tomu došlo. Existoval pouze asynchronní deploy, takže po vrácení uživatelského řízení od metody nasazení bylo potřeba nějaké dodatečné času na spuštění služby – a v tuto dobu uživatel nemohl nic řídit. Abychom mohli Service Grid dále rozvíjet, vytvářet nové funkce, přitahovat nové uživatele a usnadnit všem život, bylo potřeba něco změnit.
Při návrhu nové Service Grid jsme chtěli především zajistit synchronní nasazení: jakmile uživatel znovu převezme kontrolu od API, může ihned využívat služby. Také jsme chtěli poskytnout iniciátorovi možnost zpracovávat chyby nasazení.
Kromě toho jsme chtěli usnadnit implementaci, konkrétně se vyhnout transakcím a rebalance. I když je cache replikovaná a vyvážení není, během velkých nasazení s mnoha uzly se objevovaly problémy. Při změně topologie je třeba, aby si uzly vyměňovaly informace, a během velkého nasazení mohou tyto údaje zabírat velmi mnoho místa.
Když byla topologie nestabilní, koordinátor musel přepočítávat rozložení služeb. A obecně, když je třeba pracovat s transakcemi na nestabilní topologii, může to vést k obtížně předvídatelným chybám.
Problémy
Jaké globální změny se však obejdou bez doprovodných problémů? První z nich byla změna topologie. Je třeba si uvědomit, že v každém okamžiku, dokonce i při nasazení služby, může uzel vstoupit do clusteru nebo z něj vystoupit. Navíc, pokud uzel vstoupí do clusteru během nasazení, je nutné konzistentně předat všechny informace o službách novému uzlu. A to se netýká pouze toho, co již bylo nasazeno, ale také aktuálních a budoucích nasazení.
To je jen jeden z problémů, které lze sestavit do samostatného seznamu:
- Jak nasadit staticky konfigurované služby při spuštění uzlu?
- Co dělat, když uzel vystoupí z clusteru – co pokud uzel hostil služby?
- Co dělat, pokud se změnil koordinátor?
- Co dělat, pokud se klient znovu připojil k clusteru?
- Je třeba zpracovat požadavky na aktivaci / deaktivaci a jak?
- A co když bylo vyvoláno zničení cache, a máme na něj vázané affinity služby?
A to rozhodně není vše.
Řešení
Jako cílový přístup jsme zvolili Event Driven s realizací komunikace procesů pomocí zpráv. V Ignite jsou již implementovány dva komponenty, které umožňují uzlům zasílat si zprávy navzájem – communication-spi a discovery-spi.
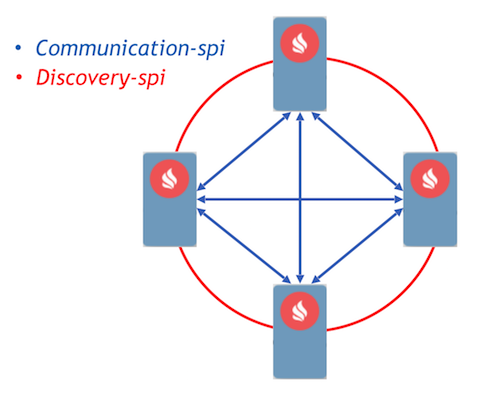
Communication-spi umožňuje uzlům přímo komunikovat a posílat zprávy. Je dobře přizpůsoben pro přenos velkého objemu dat. Discovery-spi umožňuje zaslat zprávu všem uzlům v klastru. Ve standardní implementaci se to provádí pomocí topologie "ring". Existuje také integrace se Zookeeperem, v tomto případě se používá topologie "star". Je také třeba poznamenat důležitý bod: discovery-spi poskytuje záruky, že zpráva bude doručena ve správném pořadí všem uzlům.
Podívejme se na protokol nasazení. Všechny uživatelské požadavky na nasazení a odnasazení jsou zasílány pomocí discovery-spi. To přináší následující záruky:
- Požadavek bude přijat všemi uzly v klastru. To umožní pokračovat v zpracování požadavku při změně koordinátora. Také to znamená, že každému uzlu budou k dispozici všechny potřebné metadata pro jedno zprávu, jako je konfigurace služby a její serializovaný instance.
- Přísný pořádek doručování zpráv umožňuje řešit konflikty konfigurací a konkurenčních požadavků.
- Jelikož vstup uzlu do topologie se také zpracovává přes discovery-spi, nový uzel dostane všechny potřebné údaje pro práci se službami.
Při obdržení požadavku uzly v klastru validují požadavek a vytvářejí úkoly k zpracování. Tyto úkoly se shromažďují do fronty a poté jsou zpracovány v jiném vlákně samostatným workerem. To je realizováno tímto způsobem, protože nasazení může trvat značný čas a zdržení drahého discovery-vlákna je nepřijatelné.
Všechny požadavky z fronty zpracovává deployment-manager. Má speciální worker, který vytáhne úkol z této fronty a inicializuje ho, aby zahájil nasazení. Poté následují následující akce:
- Každý uzel samostatně vypočítává rozdělení díky nové deterministické funkcionalitě assignment.
- Uzly vytvářejí zprávu s výsledky nasazení a posílají ji koordinátorovi.
- Koordinátor agreguje všechny zprávy a vytváří výsledek celého procesu nasazení, který je zaslán prostřednictvím discovery-spi všem uzlům v klastru.
- Po obdržení výsledku proces nasazení končí, po čemž je úkol odstraněn z fronty.
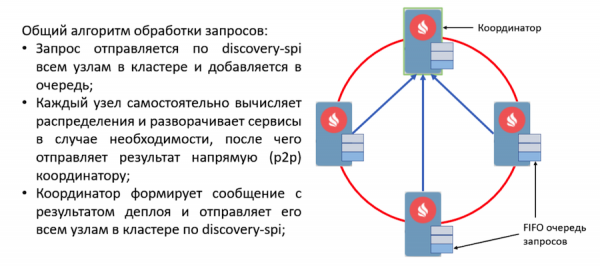
Nový event-driven design: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Pokud při nasazení dojde k chybě, uzel okamžitě zahrne tuto chybu do zprávy, kterou odešle koordinátorovi. Po agregaci zpráv bude mít koordinátor informace o všech chybách během nasazení a tuto zprávu odešle prostřednictvím discovery-spi. Informace o chybách budou dostupné na jakémkoliv uzlu v clusteru.
Tento algoritmus zpracovává všechna důležitá události v Service Grid. Například změna topologie je také zprávou prostřednictvím discovery-spi. Celkově, pokud to porovnáme s tím, co bylo dříve, protokol se ukázal jako dost lehký a spolehlivý. Tak, aby bylo možné řešit jakoukoliv situaci během nasazení.
Co se bude dít dál
Nyní k plánům. Jakékoliv větší přepracování v projektu Ignite je prováděno jako iniciativa na zlepšení Ignite, nazývaná IEP. I redesign Service Grid má také IEP — s vtipným názvem „Výměna oleje v Služební Mřížce“. Ale ve skutečnosti jsme nevyměnili olej v motoru, ale celý motor.
Úkoly v IEP jsme rozdělili do 2 fází. První je velká fáze, která se zaměřuje na přepracování protokolu nasazení. Ta už byla sloučena do masteru, můžete vyzkoušet nový Service Grid, který se objeví ve verzi 2.8. Druhá fáze zahrnuje mnoho dalších úkolů:
- Horký redeploy
- Versionování služeb
- Zvyšování odolnosti proti výpadkům
- Tenký klient
- Nástroje pro monitorování a počítání různých metrik
Nakonec vám můžeme doporučit Service Grid pro vytváření systémů s vysokou dostupností a odolností vůči výpadkům. A také vás zveme k nám na a sdílet své zkušenosti. Vaše zkušenosti jsou opravdu důležité pro komunitu, pomohou pochopit, kam se dál ubírat, jak v budoucnu vyvíjet komponent.
Zdroj: habr.com
