

In-Memory — soubor konceptů pro ukládání dat, kdy jsou data uchovávána v operační paměti aplikace, zatímco disk slouží pro zálohu. V tradičních přístupech jsou data ukládána na disku a paměť slouží jako cache. Například webová aplikace s backendem pro zpracování dat požaduje tato data ze skladu: přijímá, transformuje a přes síť přenáší velké objemy dat. V In-Memory se výpočty posílají k datům — do skladu, kde se zpracovávají, a zatížení sítě je menší.

Jaké další možnosti jsou k dispozici s In-Memory a co to za přístup, poví Vladimir Pligin — inženýr společnosti GridGain. Tento přehledový materiál bude užitečný pro vývojáře backendu webových aplikací, kteří dosud nepracovali s In-Memory a chtějí to vyzkoušet, nebo se zajímají o moderní trendy vývoje softwarových řešení a návrhu architektury.
Poznámka. Článek je založen na přepisu přednesení Vladimira na konferenci #GetIT Conf. Před zavedením izolace jsme pravidelně pořádali meetupy a konference pro vývojáře v Moskvě a Petrohradu: diskutovali jsme o trendech, aktuálních otázkách vývoje, problémech a jejich řešeních. Nyní není možné konference pořádat, ale je skvělý čas podělit se o užitečné materiály z minulosti.
Kdo a jak používá In-Memory
In-Memory se nejčastěji používá tam, kde je vyžadována rychlá interakce s uživateli nebo zpracování velkých objemů dat.
- Banky používají In-Memory například k minimalizaci latence při používání aplikací klienty nebo k analýze klientů před poskytováním úvěrů.
- FinTech používá In-Memory k zlepšení výkonu služeb a aplikací pro banky, které delegují zpracování a analýzu dat na outsourcing.
- Pojišťovací společnosti: pro hodnocení rizik, například analýzou dat zákazníka za několik let.
- Logistické společnosti. Zpracovávají velké množství dat, například pro výpočet optimálních tras nákladní a osobní dopravy s tisíci parametry, sledování stavu zásilek.
- Maloobchod. In-Memory řešení pomáhají rychleji obsluhovat zákazníky a zpracovávat velké objemy informací: expedice, faktury, transakce, dostupnost tisíců produktů na skladech, příprava analytických zpráv.
- V IoT In-Memory nahrazuje tradiční databáze.
- Farmaceutické společnosti používají In-Memory, například pro zkoumání kombinací složení léčiv.
Uvedu několik příkladů, jak naši zákazníci využívají In-Memory řešení a jak je můžete implementovat u sebe.
In-Memory jako hlavní úložiště
Jedním z našich klientů je velký dodavatel lékařského vědeckého vybavení z USA. Používají In-Memory řešení jako hlavní úložiště dat. Všechna data jsou uložena na disku, a podmnožina dat, která jsou aktivně používána, je uchovávána v operační paměti. Metody přístupu k úložišti jsou standardní — GDBC (Generic Database Connector) a dotazovací jazyk SQL.
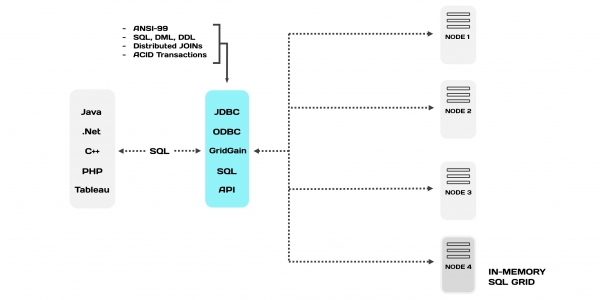
Vše dohromady se nazývá In-Memory Database (IMDB) nebo Memory-Centric Storage. Tato třída řešení má mnoho názvů, to nejsou jediné.
Vlastnosti IMDB:
- Data, která jsou uložena v In-Memory a dostupná přes SQL, jsou stejná jako v jiných přístupech. Jsou synchronizována, liší se pouze způsobem prezentace, způsobem, jak se k nim dostat. Mezi daty funguje transakčnost.
- IMDB je rychlejší než relační databáze, protože získat informace z operační paměti je rychlejší než z disku.
- Vnitřní optimalizační algoritmy mají méně instrukcí.
- IMDB jsou vhodná pro správu dat, událostí a transakcí v aplikacích.
IMDB částečně podporují ACID: atomaritu, konzistenci a izolaci. Ale nepodporují „trvalost“ — při výpadku napájení data ztrácí. Pro vyřešení problému lze používat snapshoty — „snímek“ databáze, analogie zálohy databáze na pevný disk, nebo zapisovat transakce (logy), aby bylo možné po restartu obnovit data.
Pro vytváření odolných aplikací
Představme si klasickou architekturu odolného webového aplikace. Funguje to takto: veškeré požadavky rozděluje webový vyvažovač mezi servery. Tento systém je odolný, protože servery se navzájem duplikují a zajišťují se v případě incidentů.
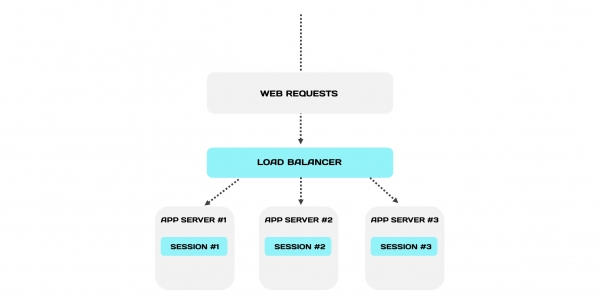
Vyvažovač směřuje všechny požadavky z jedné relace striktně na jeden server. To je mechanismus sticky sessions: každá relace je přiřazena k serveru, kde je místně uložena a zpracovávána.
Co se stane, když selže jeden z servery?
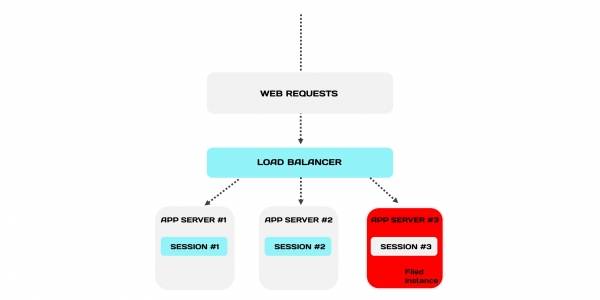
Služba nebude postižena, protože architektura je duplikována. Ale ztratíme podmnožinu relací zemřelého serveru. A současně i uživatele, kteří jsou vázáni na tyto relace. Například klient provádí objednávku a náhle je vyhozen z účtu. Bude nespokojen, když se znovu přihlásí a zjistí, že vše musí provádět ještě jednou.
Od webové aplikace se vyžaduje, aby podporovala velké množství uživatelů a nezpomalovala, aby bylo pro ně pohodlné pracovat. Ale v případě selhání, s každým dalším požadavkem se doba komunikace s úložištěm relací bude stále zvyšovat. To zvyšuje průměrnou latenci pro ostatní uživatele. Ale nechtějí čekat déle, než jsou zvyklí.
Tento problém lze vyřešit, jako to udělal náš další klient — velký poskytovatel PASS ze Spojených států. Používá In-Memory, aby zklasteroval webové relace. K tomu je neukládá místně, ale centralizovaně — v In-Memory klastru. V tomto případě jsou relace dostupné mnohem rychleji, protože jsou uloženy v operační paměti.
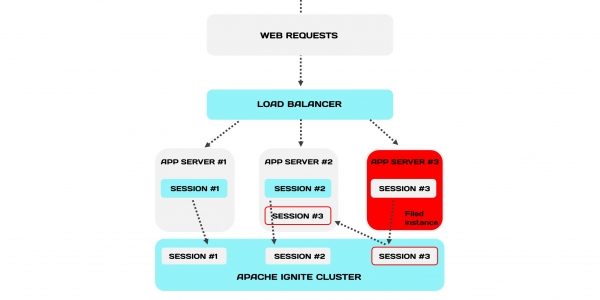
Když server selže, vyvažovač posílá požadavky z padajícího serveru na jiné servery, stejně jako v klasické architektuře. Ale je zde důležité rozlišení: relace jsou uchovávány v In-Memory cloudu a servery mají přístup k relacím selhávajícího serveru.
Taková architektura zvyšuje odolnost celého systému. Navíc je možné úplně se vzdát mechanismu sticky sessions.
Hybridní transakčně-analytické zpracování (HTAP)
Obvykle jsou transakční a analytické systémy drženy odděleně. Když jsou odděleny, hlavní databáze dostává zátěž. Pro analytické zpracování se data kopírují do repliky, aby analytické zpracování nenarušovalo transakční procesy. Ale kopírování probíhá se zpožděním — bez zpoždění není replikace možná. Pokud bychom to dělali synchronně, zpomalilo by to také hlavní databázi, a žádný zisk bychom nezískali.
V HTAP to funguje jinak — stejné datové úložiště se používá pro transakční zátěž z aplikací a pro analytické dotazy, které mohou trvat delší dobu. Když jsou data uložena v operační paměti, analytické dotazy se provádějí rychleji a server s databází je méně zatěžován (v průměru).
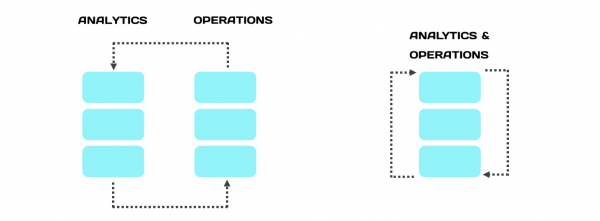
Hybridní přístup "drtí zeď" mezi zpracováním transakcí a analytikou. Pokud provádíme analytiku na stejném úložišti, analytické dotazy jsou spuštěny na datech z operační paměti. Jsou mnohem přesnější, lépe interpretovatelné a adekvátní.
Integrace In-Memory řešení
Jednoduchý (relativně) způsob — vyvinout vše od nuly. Držíme data na disku a horké uchováváme v paměti. To pomáhá zvládat restartování serverů nebo výpadky.
Zde fungují dva hlavní scénáře, kdy jsou data uložena na disku. V prvním scénáři chceme přežít pády nebo běžné restarty clusteru nebo jeho částí — chceme použít jako jednoduchou databázi. Ve druhém scénáři, kdy je dat příliš mnoho, nějaká část z nich je v paměti.
Pokud není možnost vše postavit od nuly, je možné integrovat In-Memory do již existující architektury. Ale ne všechna In-Memory řešení jsou k tomu vhodná. Existují tři nezbytné podmínky. In-Memory řešení musí podporovat:
- standardní způsob připojení k databázi, která bude pod ním (například MySQL);
- standardní jazyk dotazů, aby nebylo nutné přepisovat a měnit logiku interakce s úložištěm;
- transakčnost — zachovávat význam interakce.
Pokud jsou splněny všechny tři podmínky, je integrace možná. Umístíme In-Memory Data Grid mezi aplikaci a databázi. Nyní budou dotazy na zápis delegovány do podřízené databáze, a dotazy na čtení — do databáze, pokud data nejsou v cache.
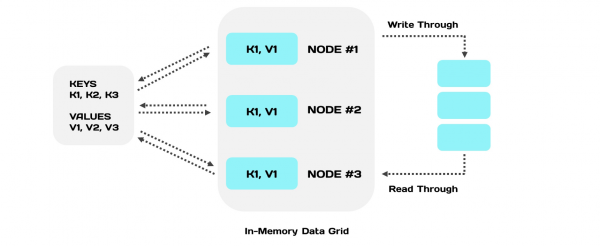
Pokud je pro vás důležitý rychlý přístup k datům a jejich zpracování, například pro obchodní analýzu, měli byste uvažovat o implementaci In-Memory. A k realizaci můžete při navrhování nové architektury použít oba způsoby.
Zdroj: habr.com
