

Narazil jsem na úkol následujícího typu. Je třeba implementovat kontejner pro ukládání dat, který zajistí následující funkčnost:
- vložit nový prvek
- odstranit prvek podle pořadového čísla
- získat prvek podle pořadového čísla
- data jsou uchovávána ve seřazeném stavu
Data se neustále přidávají a odstraňují, struktura by měla zajišťovat rychlou reakční dobu. Zpočátku jsem se pokusil implementovat takovou věc pomocí standardních kontejnerů z std. Tato cesta se neukázala jako úspěšná a došel jsem k závěru, že je potřeba něco realizovat sám. Jako první mě napadlo využít binární vyhledávací strom. Protože splňuje požadavek na rychlé vkládání, odstraňování a uchovávání dat v seřazeném stavu. Zbývalo jen vymyslet, jak indexovat všechny prvky a přepočítávat indexy, když se strom mění.
struct node_s {
    data_t data;

    uint64_t weight; // váha uzlu

    node_t *left;
    node_t *right;

    node_t *parent;
};
V článku bude více obrázků a teorie než kódu. Kód si bude možné prohlédnout na odkazu níže.
Hmotnost
Abychom toho dosáhli, strom prošel drobnou modifikací, přidala se dodatečná informace o váze uzlu. Váha uzlu je počet potomků daného uzlu + 1 (váha jednotkového prvku).
Funkce pro získání váhy uzlu:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
U listu je tedy váha rovna 0.
Dále se přesuneme k názornému zobrazení příkladu takového stromu. Černou barvou bude v něm zobrazen klíč uzlu (hodnota zobrazená nebude, protože v tom není potřeba), červenou — váha uzlu, zelenou — index uzlu.
Když je strom prázdný, jeho váha je 0. Přidáme do něj kořenový prvek:
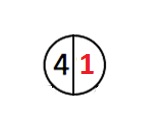
Váha stromu se stává 1, váha kořenového prvku 1. Váha kořenového prvku je váhou stromu.
Přidáme ještě několik prvků:
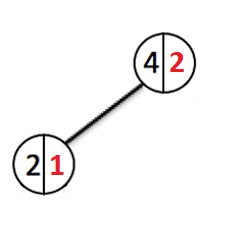
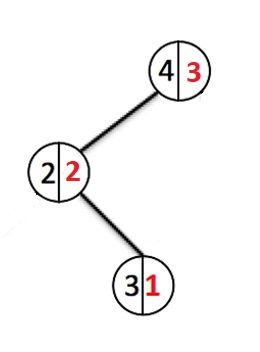
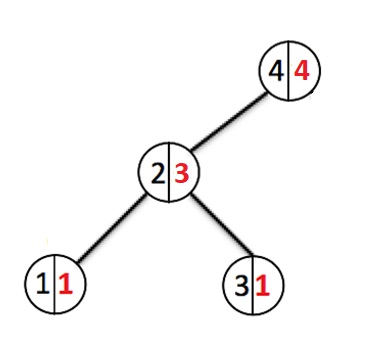
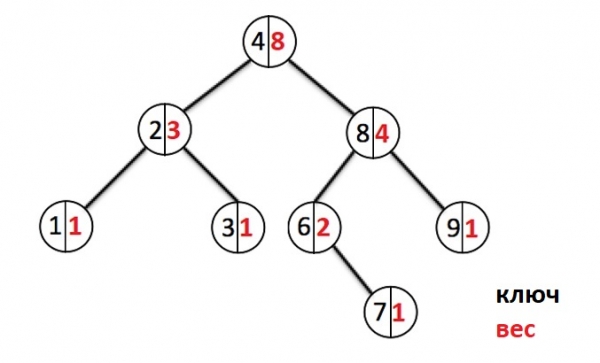
Pokaždé, když se přidává nový prvek, sestupujeme skrz uzly dolů a zvyšujeme počítadlo váhy každého prošlého uzlu. Při vytvoření nového uzlu mu je přiřazena váha 1. Pokud uzel s takovým klíčem již existuje, přepíšeme hodnotu a půjdeme zpět k kořenu směrem nahoru, abychom zrušili změny váhy u všech uzlů, které jsme prošli.
Pokud dochází k odstranění uzlu, sestupujeme dolů a dekrementujeme váhy prošlých uzlů.
Indexy
Přejdeme k tomu, jak indexovat uzly. Uzly neukládají svůj vlastní index, ten se vypočítává na základě hmotnosti uzlů. Kdyby si uchovávaly svůj index, bylo by potřeba O(n) hodně času na aktualizaci indexů všech uzlů po každé změně stromu.
Přejdeme k názornému znázornění. Naše stromová struktura je prázdná, přidáme do ní první uzel:
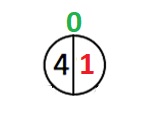
První uzel má index 0, a nyní nastávají dva případy. V prvním se změní index kořenového prvku, ve druhém se nezmění.
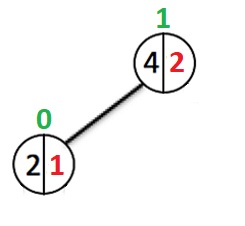
Levé podstrom kořene váží 1.
Druhý případ:
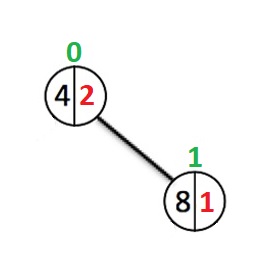
Index kořene se nezměnil, protože hmotnost jeho levého podstromu zůstala 0.
Jak se počítá index uzlu, je to hmotnost jeho levého podstromu plus číslo předané od rodiče. Co to je za číslo?, To je čítač indexů, ze začátku je roven 0, protože kořen nemá rodiče. Dále vše závisí na tom, zda sestupujeme k levému dítěti nebo pravému. Pokud k levému, pak se k čítači nic nepřidává. Pokud k pravému, přidáváme index aktuálního uzlu.
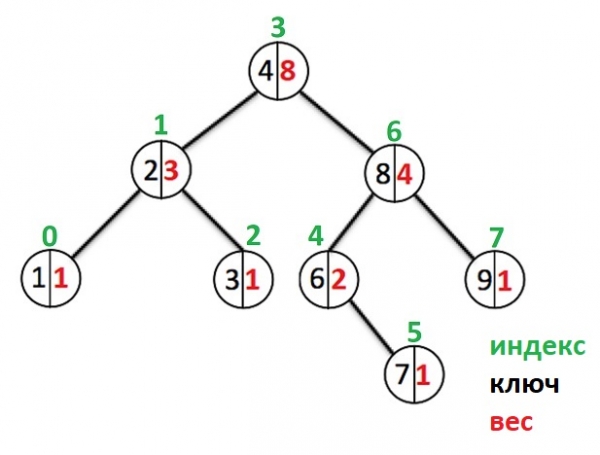
Například jak se počítá index prvku s klíčem 8 (pravé dítě kořene). To je "Index kořene" + "hmotnost levého podstromu uzlu s klíčem 8" + "1" == 3 + 2 + 1 == 6
Index prvku s klíčem 6 bude "Index kořene" + 1 == 3 + 1 == 4
Tím pádem, pro získání a odstranění prvku podle indexu je potřeba čas O(log n), protože abychom získali požadovaný prvek, musíme nejprve najít (sestoupit od kořene k tomuto prvku).
Hloubka
Na základě hmotnosti lze také vypočítat hloubku stromu. Ta je nezbytná pro vyvážení.
K tomu je třeba hmotnost aktuálního uzlu zaokrouhlit na první číslo ve stejné mocnině 2, které je větší nebo rovno dané hmotnosti, a vzít od něj binární logaritmus. Tak získáme hloubku stromu za předpokladu, že je vyvážené. Strom se vyvažuje po vložení nového prvku. Teorii o tom, jak vyvažovat stromy, popisovat nebudu. V zdrojových kódech je uvedena funkce vyvažování.
Kód pro převod hmotnosti na hloubku.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Závěry
- Vložení nového prvku probíhá za O(log n)
- Odstranění prvku podle pořadového čísla probíhá za O(log n)
- Získání prvku podle pořadového čísla probíhá za O(log n)
Rychlostí O(log n) platíme za to, že všechna data jsou uchovávána ve seřazené podobě.
Kde může taková struktura být užitečná — nevím. Jen úkol, abych se ještě jednou podíval, jak stromy fungují. Děkuji za pozornost.
Odkazy
V projektu se nacházejí testovací údaje pro kontrolu rychlosti práce. Strom se zaplňuje 1000000 prvky. A dochází k sekvenčnímu odstraňování, vkládání a získávání prvků 1000000 krát. To znamená 3000000 operací. Výsledek se ukázal jako docela dobrý ~ 8 sekund.
Zdroj: habr.com
